Hologres utiliza una arquitectura de desacoplamiento de almacenamiento. Esta página describe el diseño de la arquitectura y la función de cada componente.
Modelos de arquitectura de almacenamiento y cómputo
En los sistemas distribuidos se utilizan comúnmente tres arquitecturas de almacenamiento y cómputo.
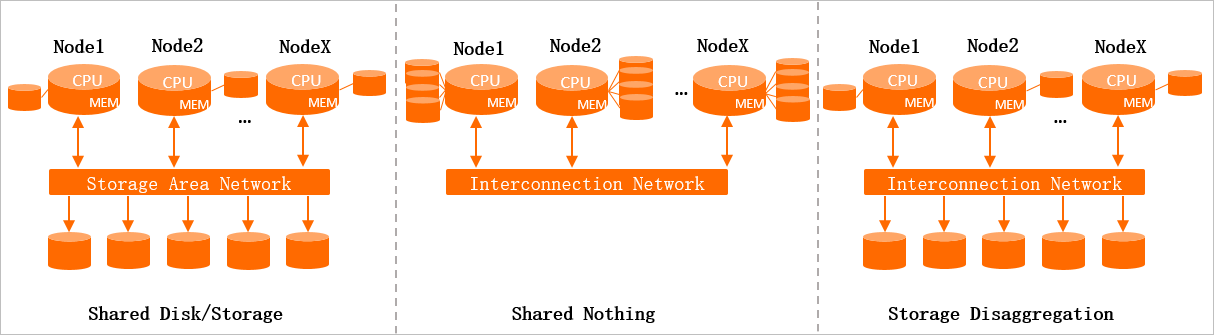
Disco compartido / Almacenamiento compartido
Un clúster de almacenamiento distribuido se comparte entre todos los nodos de trabajo. Cada nodo de trabajo accede a los datos como si fueran locales. El clúster de almacenamiento escala fácilmente, pero los nodos de trabajo requieren coordinación distribuida para mantener la consistencia, lo cual limita el número máximo de nodos de trabajo.
Shared Nothing
Cada nodo de trabajo monta su propio almacenamiento local y procesa datos de un solo shard. Los nodos de trabajo se comunican entre sí, y un nodo de resumen dedicado agrega los resultados. Esta arquitectura escala horizontalmente, pero con ciertas desventajas: después de un failover, el nodo en recuperación debe recargar los datos antes de atender solicitudes, y cualquier escalado horizontal desencadena un reequilibrio de datos entre nodos, un proceso que consume mucho tiempo.
Desacoplamiento de almacenamiento
Se comparte un clúster de almacenamiento distribuido, pero cada nodo de cómputo procesa datos de un shard dedicado —similar a Shared Nothing— y mantiene una caché local. Esta arquitectura ofrece:
Consistencia de datos sin esfuerzo: Solo un nodo de trabajo escribe en un shard a la vez, lo que elimina la coordinación compleja.
Escalado flexible: Los recursos de cómputo y almacenamiento escalan de forma independiente. Durante los picos de tráfico, escale horizontalmente solo la capa de cómputo sin desencadenar un reequilibrio de datos.
Recuperación rápida tras failover: Después de un fallo, un nuevo nodo obtiene datos del almacenamiento distribuido de manera asíncrona y reanuda el servicio rápidamente.
Hologres utiliza la arquitectura de desacoplamiento de almacenamiento, que combina la simplicidad de gestión del almacenamiento compartido con el rendimiento y la escalabilidad del cómputo basado en shards. El almacenamiento subyacente es Pangu, el sistema de archivos distribuido de Alibaba, que proporciona una función similar a la de Hadoop Distributed File System (HDFS).
Componentes de la arquitectura de Hologres
La figura a continuación muestra la arquitectura de Hologres.
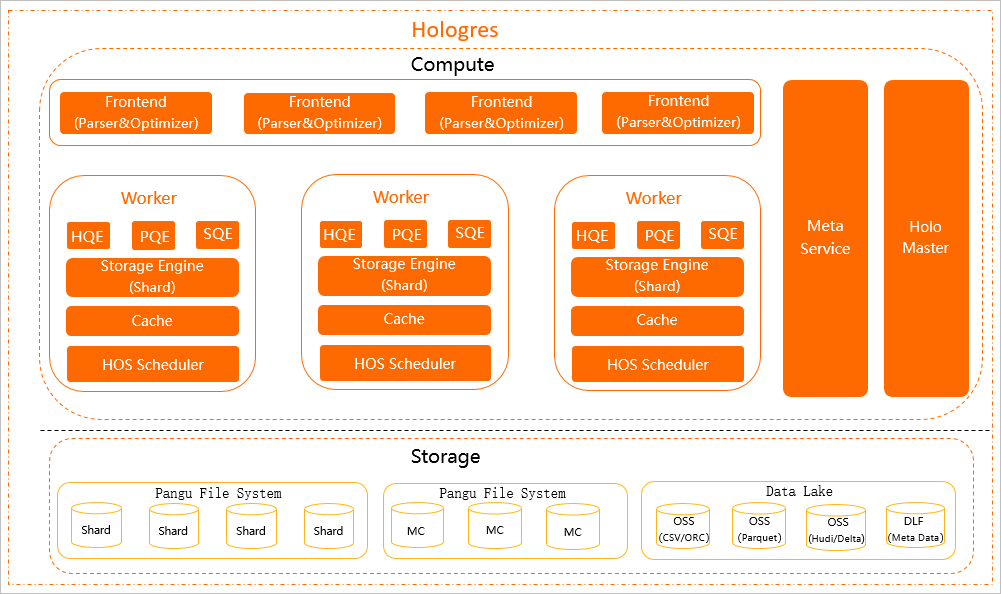
Capa de cómputo
Frontend (FE)
El FE autentica, analiza y optimiza las sentencias SQL. Una instancia de Hologres ejecuta varios FEs. Hologres es compatible con PostgreSQL 11, por lo que puede usar la sintaxis estándar de PostgreSQL y conectarse con herramientas de desarrollo y de Business Intelligence (BI) compatibles con PostgreSQL sin configuración adicional.
HoloWorker
Los HoloWorkers programan y ejecutan las consultas de los usuarios. Cada HoloWorker contiene un Query Engine (QE), un Storage Engine (SE), una caché y un HOS Scheduler.
Query Engine (QE)
HoloWorker admite tres motores de consulta, cada uno diseñado para una carga de trabajo diferente:
| Motor | Propósito | Características principales |
|---|---|---|
| Hologres Query Engine (HQE) | Motor principal para consultas analíticas | Arquitectura MPP escalable con operadores de vectorización; maximiza la utilización de la CPU para lograr un alto rendimiento en las consultas |
| PostgreSQL Query Engine (PQE) | Capa de compatibilidad con PostgreSQL | Admite PostGIS y UDF escritas en PL/Java, PL/SQL o PL/Python; gestiona operaciones que HQE aún no admite |
| Seahawks Query Engine (SQE) | Integración con MaxCompute | Se conecta a MaxCompute sin migración de datos; admite tablas hash, tablas agrupadas por rangos y análisis interactivo de datos por lotes a nivel de PB |
El objetivo a largo plazo es integrar toda la funcionalidad de PQE en HQE.
Storage Engine (SE)
El SE gestiona los datos y maneja todas las operaciones de creación, lectura, actualización y eliminación (CRUD).
Caché
El componente de caché almacena temporalmente los resultados de las consultas para mejorar el rendimiento.
HOS Scheduler
HOS Scheduler proporciona capacidades de programación ligeras.
Meta Service
Meta Service gestiona los metadatos —incluidas las estructuras de tablas y la distribución de datos en el SE— y los proporciona a los FEs.
Holo Master
Hologres se ejecuta de forma nativa en Kubernetes. Si un nodo de trabajo falla, Kubernetes aprovisiona un reemplazo en poco tiempo para mantener la disponibilidad a nivel de nodo. Holo Master supervisa el estado de los componentes dentro de cada nodo de trabajo y reinicia cualquier componente que entre en un estado anómalo, lo que reduce la interrupción del servicio.
Capa de almacenamiento
Los datos de Hologres se almacenan en Pangu, el sistema de archivos distribuido de Alibaba. La capa de almacenamiento también se integra con fuentes de datos externas:
MaxCompute: Hologres lee los datos de MaxCompute almacenados en Pangu. Pangu permite un acceso mutuo eficiente entre Hologres y MaxCompute sin movimiento de datos.
Object Storage Service (OSS) y Data Lake Formation (DLF): Hologres consulta datos en OSS y DLF para acelerar el análisis en data lakes. Los formatos compatibles incluyen CSV, ORC, Parquet, Hudi, Delta y Meta Data. Hologres también puede escribir datos en OSS para reducir los costos de almacenamiento.