La integración de lagos y flujos es una nueva arquitectura de datos que fusiona los lagos de datos con los flujos en tiempo real.
Integración de lagos y flujos
Problemas comunes de los lakehouses tradicionales y el procesamiento de flujos
Silos de almacenamiento: Una sola capa de almacenamiento no satisface simultáneamente los requisitos de rendimiento en tiempo real y bajo costo.
Arquitectura compleja: La arquitectura Lambda obliga a los desarrolladores a mantener dos sistemas completamente separados.
Redundancia de almacenamiento: Los datos se almacenan de forma redundante en distintos sistemas, lo que consume recursos tanto de almacenamiento como de cómputo.
Consultas fragmentadas: Sin una vista unificada de los datos, la diversidad de motores de cómputo y lógicas de procesamiento genera fácilmente ambigüedades en la semántica de los datos.
Conceptos clave y valor de la integración de lagos y flujos
La integración de lagos y flujos es una nueva arquitectura de datos que fusiona los lagos de datos con los flujos en tiempo real. Su objetivo es eliminar las barreras entre el procesamiento por lotes tradicional y el procesamiento de flujos. Esta integración permite unificar el procesamiento de datos en tiempo real y por lotes mediante una única fuente de almacenamiento, metadatos y acceso. Dicha arquitectura se utiliza frecuentemente para resolver problemas de actualidad de los datos en los lagos de datos; por ejemplo, reduce la latencia de minutos a milisegundos. También proporciona capacidades de procesamiento analítico en línea (OLAP) para los flujos de datos.
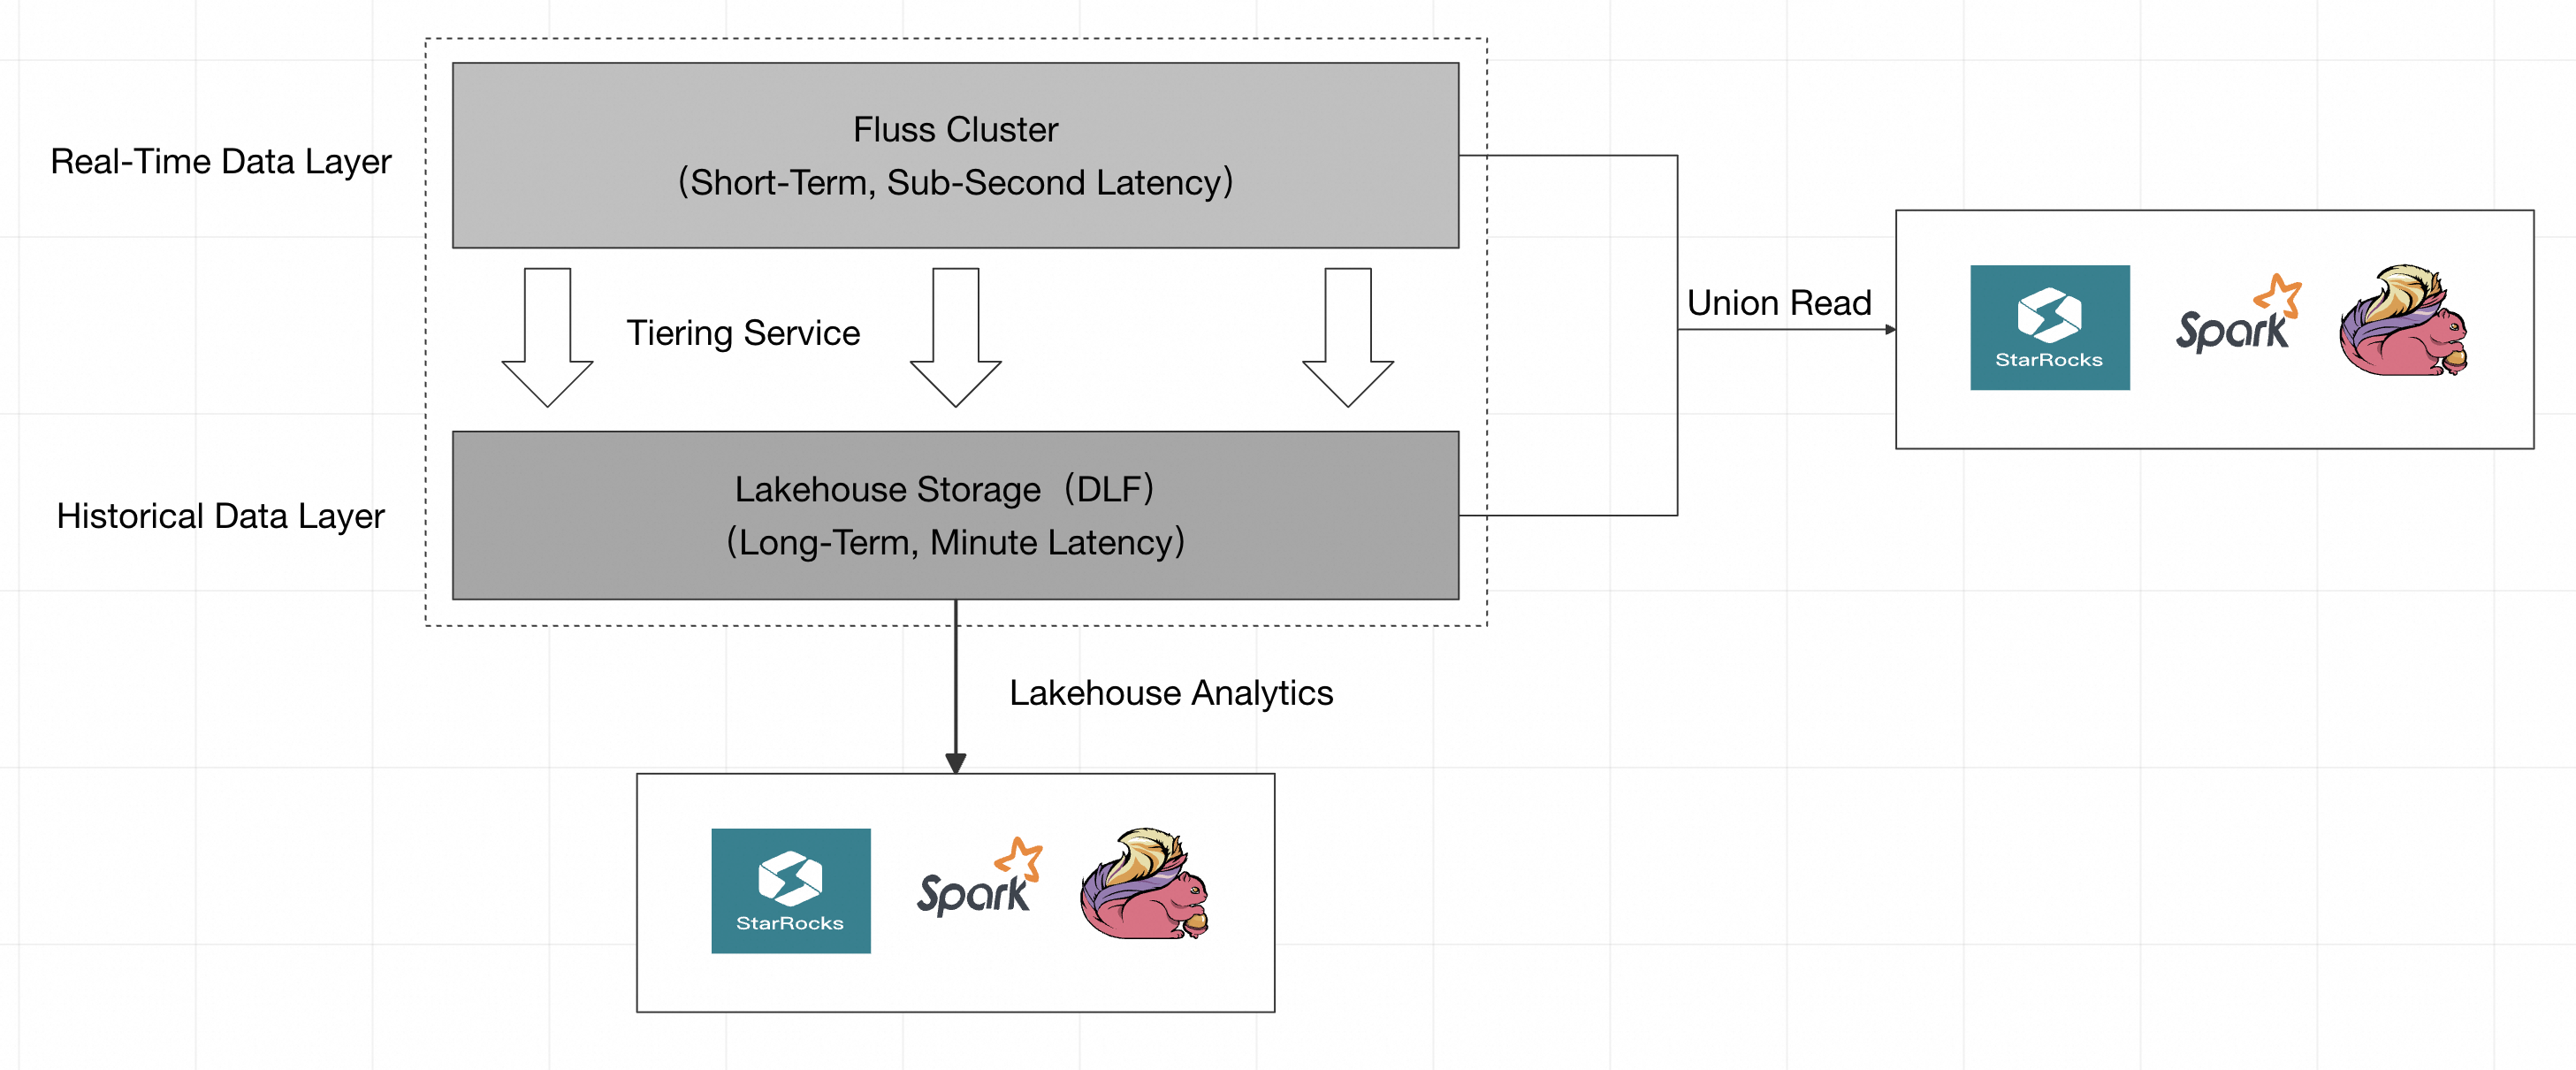
Esta arquitectura integra profundamente el almacenamiento de flujos en tiempo real (Fluss) con un lago de datos basado en Paimon, cuyos metadatos gestiona DLF. Esta integración genera «una copia de datos, dos vistas». Una sola tabla lógica ofrece acceso de baja latencia a los datos en tiempo real y análisis de alto throughput para los datos históricos.
Principios fundamentales
Sincronización automática: Al habilitar esta función en un clúster de Fluss, el sistema crea automáticamente un trabajo de sincronización de Flink. Este trabajo escribe continuamente el flujo de eventos en tiempo real desde Fluss hacia una tabla de Paimon.
Lectura unificada: Al ejecutar una consulta sobre una tabla, el motor de consultas de Flink combina automáticamente los datos en tiempo real de Fluss con los datos históricos de Paimon. Después, deduplica los datos por clave primaria y presenta una tabla única, coherente y actualizada.
Metadatos unificados: DLF funciona como un servicio de metadatos unificado. Gestiona la información de las tablas de Paimon, como esquemas, particiones y permisos. Esto garantiza que varios motores de cómputo, como Flink, Spark y Presto, accedan a los datos sin inconvenientes.
Uso compartido de datos: Fluss y Paimon trabajan en conjunto para crear una arquitectura integrada de almacenamiento de flujos y lotes. Fluss actúa como la capa de datos en tiempo real y proporciona escrituras y acceso con latencia de milisegundos para los datos activos. Paimon funciona como la capa de datos históricos y se encarga del almacenamiento a largo plazo y rentable de dicha información. Ambas capas comparten los datos para evitar la redundancia en el almacenamiento.
Funciones principales
Menor complejidad arquitectónica: Elimina las rutas duales de desarrollo, el almacenamiento duplicado y los costos redundantes de operación y mantenimiento (O&M) propios de los sistemas tradicionales separados de flujos y lotes.
Consistencia garantizada de los datos: Asegura resultados coherentes tanto en los análisis en tiempo real como en los análisis por lotes mediante un modelo de datos y un motor de cómputo unificados.
Operación y mantenimiento simplificados: Ofrece un panel de monitoreo integral que muestra métricas como la latencia de sincronización, el estado de los trabajos y las puntuaciones de salud. También integra funciones de O&M, como inicio y detención con un solo clic, así como configuración de alertas.
Mayor agilidad: Los desarrolladores pueden concentrarse en la lógica de negocio sin preocuparse por la ubicación física de los datos subyacentes. Esto les permite crear rápidamente aplicaciones para escenarios como almacenes de datos en tiempo real, reportes en tiempo real e ingeniería de funciones de IA.