Los trabajos por lotes en Realtime Compute for Apache Flink tienen una mecánica de ejecución distinta a la de los trabajos de streaming, con diferencias en la asignación de recursos, la transmisión de datos y la recuperación ante errores. Esta guía explica dichas diferencias y muestra cómo configurar los recursos y el paralelismo para obtener el mejor rendimiento en sus trabajos por lotes.
Realtime Compute for Apache Flink admite el procesamiento por lotes en el desarrollo de borradores, la operación y mantenimiento de trabajos, los flujos de trabajo, la gestión de colas y el perfilado de datos. Para consultar un recorrido integral, consulte Quick start with batch processing .
Diferencias entre trabajos por lotes y de streaming
Comprender estas diferencias le ayudará a configurar correctamente los trabajos por lotes y a evitar errores comunes.
Modo de ejecución
Los trabajos de streaming procesan flujos de datos continuos e ilimitados con baja latencia. Los datos circulan entre operadores en modo pipeline, por lo que todas las subtareas de todos los operadores se despliegan y ejecutan simultáneamente.
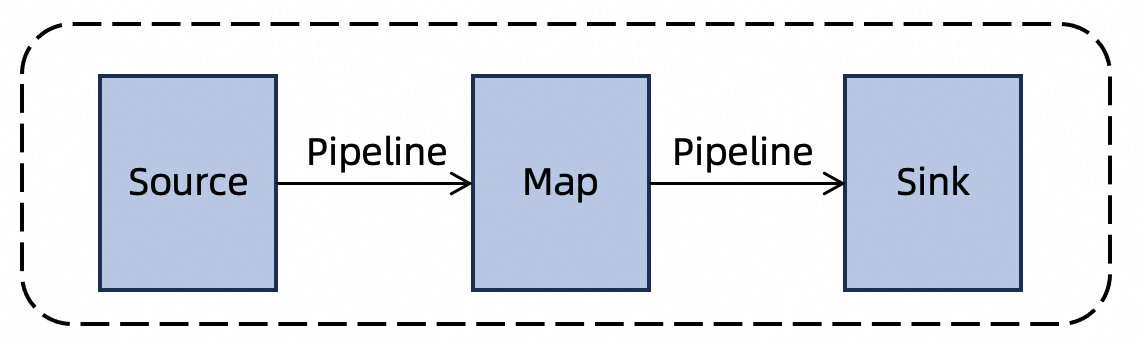
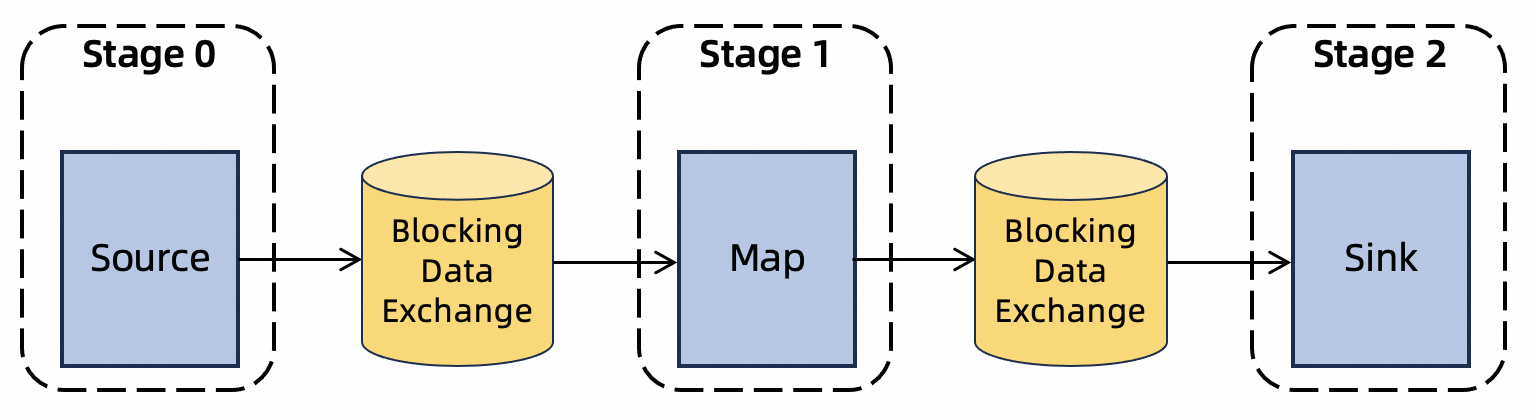
Los trabajos por lotes procesan conjuntos de datos acotados con alto throughput. Un trabajo se ejecuta en varias fases:
Las fases independientes se ejecutan en paralelo para maximizar la utilización de recursos.
Las fases dependientes esperan: las subtareas posteriores solo inician cuando finalizan las subtareas anteriores.
Transmisión de datos
Los trabajos de streaming mantienen los datos intermedios en memoria y los pasan directamente entre operadores. Dado que los datos no se conservan en almacenamiento persistente, la lentitud en operadores posteriores genera contrapresión en los operadores anteriores.
Los trabajos por lotes escriben los resultados intermedios en un almacenamiento externo antes de que los operadores posteriores los consuman. De forma predeterminada, los resultados se almacenan en el disco local de cada TaskManager. Si el servicio remote shuffle está habilitado, los resultados se envían a dicho servicio.
Requisitos de recursos
Los trabajos de streaming deben tener todos los recursos asignados antes del inicio, ya que cada subtarea se ejecuta al mismo tiempo.
Los trabajos por lotes no preasignan recursos. Realtime Compute for Apache Flink programa las subtareas en lotes conforme sus datos de entrada están listos, lo que permite ejecutar un trabajo por lotes con tan solo un slot.
Recuperación ante errores
Los trabajos de streaming se reanudan desde el último checkpoint o savepoint. Como los datos intermedios no se conservan en almacenamiento persistente, todas las subtareas se reinician.
Los trabajos por lotes almacenan los resultados intermedios en disco, por lo que solo es necesario reiniciar la subtarea con errores y sus subtareas posteriores; no se requiere un retroceso completo. Los trabajos por lotes no cuentan con un mecanismo de checkpoint, así que las subtareas reiniciadas comienzan desde el inicio de su fase.
Configurar recursos
CPU y memoria
Establezca la CPU y la memoria para el JobManager y los TaskManagers en Resources, dentro de la pestaña Configuration.
|
Componente |
Recomendado |
Mínimo |
|
JobManager |
1 núcleo de CPU, 4 GiB de memoria |
0.5 núcleos de CPU, 2 GiB de memoria |
|
TaskManager (por slot) |
1 núcleo de CPU, 4 GiB de memoria |
0.5 núcleos de CPU, 2 GiB de memoria |
Para un TaskManager con n slots, asigne n núcleos de CPU y 4n GiB de memoria.
El espacio en disco es proporcional a los núcleos de CPU: cada núcleo proporciona 20 GiB, con un mínimo de 20 GiB y un máximo de 200 GiB por TaskManager.
De forma predeterminada, cada TaskManager en un trabajo por lotes tiene un slot. Para reducir la sobrecarga de programación de TaskManagers, establezca los slots por TaskManager en 2 o 4. Tenga en cuenta que más slots en un solo TaskManager implican que más subtareas comparten su disco local; si se agota el espacio en disco, el trabajo falla y se reinicia. Consulte No space left on device para ver posibles soluciones.
En trabajos con una topología a gran escala o un enrutamiento de red complejo, aumente los recursos más allá de los valores predeterminados según su carga de trabajo.
Si encuentra problemas relacionados con recursos, consulte Flink memory troubleshooting.
Número máximo de slots
Configure un límite máximo de slots para restringir los recursos que puede consumir un trabajo por lotes y evitar que afecte a otros trabajos. Para obtener detalles sobre la configuración, consulte How do I limit the number of TaskManagers?
Configurar el paralelismo
Establezca el paralelismo en Resources, dentro de la pestaña Configuration.
Paralelismo global
El paralelismo global establece el límite superior de subtareas que un operador puede ejecutar en paralelo. Introduzca un valor en el campo Parallelism.
Inferencia automática de paralelismo
En Realtime Compute for Apache Flink con Ververica Runtime (VVR) 8.0 o posterior, la inferencia automática de paralelismo está habilitada de forma predeterminada para trabajos por lotes. Esta función analiza el volumen total de datos consumido por cada operador y el volumen promedio de datos configurado por subtarea, y luego infiere automáticamente un nivel de paralelismo adecuado.
El paralelismo global que establezca actúa como el upper limit para el paralelismo inferido.
Configure los siguientes parámetros en Parameters, dentro de la pestaña Configuration:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Habilita la inferencia automática de paralelismo. |
|
|
|
Paralelismo mínimo inferido. |
|
|
|
Paralelismo máximo inferido. Si no se establece, se utiliza el paralelismo global. |
|
|
|
Volumen promedio de datos que se espera procese cada subtarea. El paralelismo inferido se escala dividiendo el volumen total de datos del operador entre este valor. |
|
|
|
Paralelismo para operadores de origen. Dado que el volumen de datos de origen no se puede medir antes de la lectura, establezca este valor explícitamente. Si no se establece, se utiliza el paralelismo global. |
|
Preguntas frecuentes
¿Cómo limito el número de TaskManagers?
Los TaskManagers (TMs) se crean y liberan dinámicamente en los trabajos por lotes. Con un paralelismo de 16 y un slot por TaskManager, el trabajo inicia 16 TMs. A medida que las subtareas finalizan y sus TMs se liberan, se crean nuevos TMs para los operadores subsiguientes, por lo que el recuento total puede superar brevemente los 16 (por ejemplo, 17, 18 o 19). Este es un comportamiento normal de programación elástica.
Para aplicar un límite estricto, configure el número máximo de slots para el trabajo. Esto restringe cuántos TMs pueden ejecutarse al mismo tiempo.
¿Cuál es la diferencia entre paralelismo y slots?
El paralelismo define el número máximo de instancias de subtareas que un operador puede ejecutar simultáneamente.
El slot es la unidad de asignación de recursos. El total de slots disponibles determina cuántas subtareas pueden ejecutarse simultáneamente en todo el trabajo.
Los trabajos de streaming utilizan slot sharing de forma predeterminada y solicitan slots equivalentes al paralelismo global al iniciarse, por lo que todas las subtareas comienzan inmediatamente.
Los trabajos por lotes no preasignan slots. La concurrencia real está limitada por los slots disponibles, incluso si el paralelismo global se establece en un valor mayor.
Por ejemplo: un trabajo de streaming con paralelismo 4 requiere 4 slots desde el inicio. Un trabajo por lotes con paralelismo 4 ejecuta como máximo 4 subtareas si hay 4 slots disponibles; las subtareas restantes esperan a que se liberen slots.
¿Qué hago si un trabajo por lotes se atora?
Supervise el uso de memoria, la utilización de CPU y la actividad de hilos de sus TaskManagers. Consulte Monitor job performance.
|
Síntoma |
Dónde revisar |
Acción |
|
Alto uso de memoria o pausas frecuentes de GC |
Métricas de memoria |
Aumente la memoria del TaskManager |
|
Un hilo consume mucha CPU |
Métricas de CPU e hilos |
Identifique el hilo saturado mediante los seguimientos de pila de hilos |
|
El trabajo no avanza |
Seguimientos de pila de hilos |
Analice los cuellos de botella de ejecución por operador |
No space left on device
Cuando un trabajo por lotes falla con el error No space left on device, significa que los TaskManagers han agotado su espacio en disco local al almacenar archivos de resultados intermedios. El espacio en disco es proporcional a los núcleos de CPU: cada núcleo proporciona 20 GiB, hasta un máximo de 200 GiB por TaskManager.
Resuelva el problema con uno de los siguientes enfoques:
Reduzca los slots por TaskManager. Menos slots implican menos subtareas concurrentes en un solo nodo, lo que reduce los datos intermedios escritos en el disco local.
Aumente los núcleos de CPU por TaskManager. Más núcleos amplían proporcionalmente el espacio en disco disponible.
Pasos siguientes
Quick start with batch processing — recorrido integral de las funciones clave de procesamiento por lotes
Configure custom parameters for job running — referencia completa de parámetros de trabajo