Este tema describe cómo utilizar el servicio integrado de modelos de lenguaje grande en trabajos de Flink SQL para realizar análisis de sentimiento y vectorización en streaming, sin necesidad de solicitar su propia clave de API.
Contexto
El servicio Flink AI proporciona modelos de lenguaje grande (LLM) integrados y administrados. No es necesario solicitar una clave de API. Puede hacer referencia directamente a los modelos integrados en los trabajos de Flink SQL para habilitar la inference de IA y la vectorización en streaming. Las siguientes secciones describen dos casos de uso principales de los modelos:
-
Modelo chat/completions: Un modelo chat/completions es un LLM basado en la generación de diálogos y la comprensión de texto. Se utiliza ampliamente en escenarios como análisis de sentimiento, reconocimiento de intenciones y sistemas de preguntas y respuestas.
Análisis de sentimiento: Realiza una clasificación de sentimiento en tiempo real sobre los comentarios de redes sociales de su negocio para identificar si la opinión del usuario es positiva, negativa o neutra.
Servicio al cliente inteligente: Proporciona interacciones en lenguaje natural para sistemas de servicio al cliente inteligente, impulsadas por capacidades de generación de diálogos.
Moderación de contenido: Detecta automáticamente contenido sensible o violaciones de políticas en el texto para lograr auditorías de seguridad de contenido más eficientes.
-
Modelo de embedding: Un modelo de embedding convierte texto en representaciones vectoriales de alta dimensión. Las aplicaciones comunes incluyen búsqueda semántica, sistemas de recomendación y construcción de grafos de conocimiento.
Búsqueda semántica: Permite realizar búsquedas semánticas basadas en relevancia mediante la vectorización de descripciones de productos o consultas de usuarios.
Sistemas de recomendación: Utiliza la vectorización de texto para descubrir asociaciones entre los intereses de los usuarios y las características de los productos, lo que mejora la precisión de las recomendaciones.
Grafo de conocimiento: Convierte texto no estructurado en un formato vectorial para simplificar la extracción posterior de conocimiento y el modelado de relaciones.
Requisitos previos
Ha activado un espacio de trabajo de Flink. Para obtener más información, consulte Activate Realtime Compute for Apache Flink.
Ha activado el servicio Flink AI. Para obtener más información, consulte Flink AI service (built-in models).
Límites
Requiere Ververica Runtime (VVR) 11.7 o posterior.
El rendimiento del operador ML_PREDICT está limitado por la política de limitación de tasa de la plataforma de servicio de modelos. Cuando se alcanza el límite de tráfico, el trabajo de Flink puede experimentar contrapresión o reiniciarse debido a tiempos de espera agotados.
Paso 1: Registrar un modelo integrado
Para obtener más información, consulte Model settings.
Modelo Chat/completions
El siguiente código SQL de ejemplo muestra cómo registrar un modelo de texto integrado de Flink:
CREATE MODEL ai_analyze_sentiment
INPUT (`input` STRING)
OUTPUT (`content` STRING)
WITH (
    'provider' = 'dashscope',
    'task' = 'chat/completions',
    'model' = 'qwen3.5-flash',
    'system-prompt' = 'Classify the text below into one of the following labels: [positive, negative, neutral, mixed]. Output only the label.'
);
Modelo de embedding
El siguiente código SQL de ejemplo muestra cómo registrar un modelo de embedding integrado de Flink:
CREATE MODEL embedding_model
INPUT (`input` STRING)
OUTPUT (`embeddings` ARRAY<FLOAT>)
WITH (
    'provider' = 'dashscope',
    'task' = 'embeddings',
    'model' = 'text-embedding-v4'
);
Paso 2: Crear un trabajo
Cree un borrador para un trabajo de streaming SQL. Para obtener más información, consulte Flink SQL jobs.
Paso 3: Escribir un trabajo SQL para análisis con LLM
Modelo Chat/completions
Utilice la función de IA ML_PREDICT para invocar el modelo ai_analyze_sentiment registrado y realizar un análisis de sentimiento de reseñas de películas.
Copie el siguiente SQL de ejemplo en el editor SQL.
-- Create a temporary sink table.
CREATE TEMPORARY TABLE print_sink(
  id BIGINT,
  movie_name VARCHAR,
  predict_label VARCHAR,
  actual_label VARCHAR
) WITH (
  'connector' = 'print',   -- Use the print connector.
  'logger' = 'true'        -- Display the results in the console.
);

-- Create a temporary data view to construct test data.
-- | id | movie_name | comment   | actual_label |
-- | 1  | Her Story     | My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving. | POSITIVE |
-- | 2  | The Dumpling Queen   | Unremarkable.  | NEGATIVE |
CREATE TEMPORARY VIEW movie_comment(id, movie_name, user_comment, actual_label)
AS VALUES (1, 'Her Story', 'My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.', 'positive'), (2, 'The Dumpling Queen', 'Unremarkable.', 'negative');

INSERT INTO print_sink
SELECT id, movie_name, content as predict_label, actual_label
FROM ML_PREDICT(
  TABLE movie_comment,
  MODEL ai_analyze_sentiment,  -- The registered Flink built-in text model.
  DESCRIPTOR(user_comment));
Modelo de embedding
Utilice la función de IA ML_PREDICT para invocar el embedding_model registrado, generar embeddings para las reseñas de películas y luego escribir los resultados en Milvus (public preview).
Copie el siguiente SQL de ejemplo en el editor SQL.
-- Create a temporary sink table named milvus_sink.
CREATE TEMPORARY TABLE milvus_sink
(
    id STRING,
    movie_name STRING,
    user_comment STRING,
    embeddings ARRAY<FLOAT>,
    PRIMARY KEY (id) NOT ENFORCED
)
WITH (
    'connector' = 'milvus',
    'endpoint' = '<YOUR-ENDPOINT>',
    'port' = '<YOUR-PORT>',
    'userName' = '<YOUR-USERNAME>',
    'password' = '<YOUR-PASSWORD>',
    'databaseName' = 'default',
    'collectionName' = 'movie-comment-embeddings'
);

-- Create a temporary data view to construct test data.
-- | id | movie_name | comment |
-- | 1 | Her Story |My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.|
-- | 2 | The Dumpling Queen | Unremarkable. |
CREATE TEMPORARY VIEW movie_comment(id, movie_name,  user_comment)
AS VALUES ('1', 'Her Story', 'My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.'), ('2', 'The Dumpling Queen', 'Unremarkable.');

INSERT INTO
    milvus_sink
SELECT
    id,
    movie_name,
    user_comment,
    embeddings
FROM
    ML_PREDICT (
        TABLE movie_comment,
        MODEL embedding_model,  -- The registered Flink built-in embedding model.
        DESCRIPTOR (user_comment)
    );
Paso 4: Desplegar e iniciar el trabajo
Despliegue e inicie el trabajo. Para obtener más información, consulte Flink SQL jobs.
Paso 5: Consultar los resultados del análisis
Modelo Chat/completions
-
Compruebe que el estado del trabajo sea FINISHED.
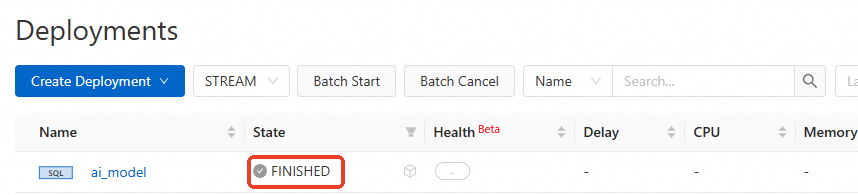
En la consola , vaya a la página Deployments y haga clic en el nombre del trabajo objetivo.
En la pestaña Logs, haga clic en la subpestaña Task Managers y seleccione el current TaskManager.
-
Haga clic en Logs y busque registros relacionados con PrintSinkOutputWriter.
La etiqueta predicha por el modelo
predict_labelcoincide con la etiqueta realactual_label.En la pestaña Task Managers, seleccione Running Logs a la izquierda. Los registros muestran la salida de PrintSinkOutputWriter, como
+I[1, Her Story, positive, positive]y+I[2, The Dumpling Queen, negative, negative]. Esto indica que predict_label coincide con actual_label.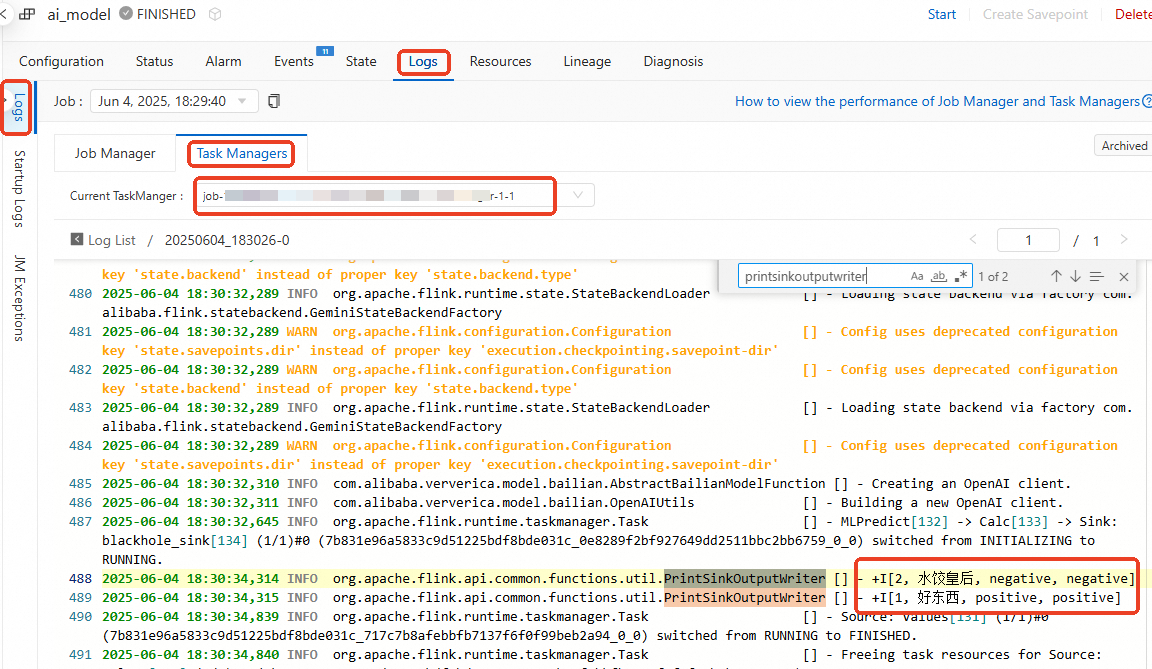
Documentos relacionados
Sentencias de lenguaje de definición de datos (DDL) para modelos de IA: Configure a model
Funciones de IA: ML_PREDICT
Servicio de búsqueda vectorial: Milvus (public preview)