Una sesión es una instancia de Spark dentro de un espacio de trabajo de EMR Serverless Spark. Cree una sesión SQL para ejecutar consultas SQL y analizar datos científicos.
Creación de una sesión SQL
Después de crear la sesión SQL, podrá seleccionarla cuando cree un trabajo SQL.
-
Acceda a la página Sessions.
Inicie sesión en la consola de EMR.
En el panel de navegación izquierdo, elija EMR Serverless > Spark.
En la página Spark, haga clic en el nombre del espacio de trabajo correspondiente.
En la página EMR Serverless Spark, haga clic en Sessions en el panel de navegación izquierdo.
En la página SQL Session, haga clic en Connect to SQL Session.
-
En la página Create SQL Session, configure los parámetros que se muestran a continuación y haga clic en create.
ImportanteSe recomienda establecer la concurrencia máxima de la cola de recursos seleccionada como mínimo en la cantidad de recursos que requiere la sesión de notebook. Este valor se muestra en la consola.
Parámetro
Descripción
Name
El nombre de la sesión SQL.
El nombre debe tener entre 1 y 64 caracteres. Puede contener letras, dígitos, guiones (-), guiones bajos (_) y espacios.
Resource Queue
La cola de recursos asignada a la sesión SQL. Seleccione una cola designada para desarrollo o una compartida entre desarrollo y producción.
Para obtener más información sobre las colas, consulte Manage resource queues.
Engine Version
La versión del motor para la sesión SQL. Para obtener más información, consulte Engine versions.
Use Fusion Acceleration
Fusion acelera las cargas de trabajo de Spark y reduce el costo total de los trabajos. Para consultar la información de facturación, vea Product Billing. Si necesita más detalles sobre el motor Fusion, revise Fusion engine.
Automatic Stop
Habilitada de forma predeterminada. Especifique un tiempo de espera de inactividad personalizado. El sistema detiene automáticamente la sesión SQL después de permanecer inactiva durante el periodo indicado.
Normal Network Connection
Una conexión de red existente para acceder a fuentes de datos en una VPC o a servicios externos. Para obtener más información, consulte Network connectivity between EMR Serverless Spark and other VPCs.
spark.driver.cores
La cantidad de núcleos de CPU para el proceso del controlador. Valor predeterminado: 1.
spark.driver.memory
La cantidad de memoria para el proceso del controlador. Valor predeterminado: 3.5 GB.
spark.executor.cores
La cantidad de núcleos de CPU para cada proceso ejecutor. Valor predeterminado: 1.
spark.executor.memory
La cantidad de memoria para cada proceso ejecutor. Valor predeterminado: 3.5 GB.
spark.executor.instances
La cantidad de executors. Valor predeterminado: 2.
Dynamic Resource Allocation
Deshabilitada de forma predeterminada. Cuando se habilita, configure los siguientes parámetros:
-
Minimum Number of Executors: el valor predeterminado es 2.
-
Maximum Number of Executors: si no se establece spark.executor.instances, el valor predeterminado es 10.
More Memory Configurations
-
spark.driver.memoryOverhead: la memoria fuera del heap disponible para el controlador. Si no se configura este parámetro, Spark asigna automáticamente un valor basado en el valor predeterminado, que es
max(384 MB, 10% * spark.driver.memory). -
spark.executor.memoryOverhead: la memoria fuera del heap disponible para cada executor. Si no se configura este parámetro, Spark asigna automáticamente un valor basado en el valor predeterminado, que es
max(384 MB, 10% * spark.executor.memory). -
spark.memory.offHeap.size: la cantidad de memoria fuera del heap disponible para Spark. El valor predeterminado es 1 GB.
Este parámetro solo surte efecto cuando
spark.memory.offHeap.enabledse establece entrue. Al usar el motor Fusion, esta función se habilita de forma predeterminada con 1 GB de memoria fuera del heap.
Spark Configuration
Propiedades de configuración personalizadas de Spark. Use espacios para separar los pares clave-valor. Ejemplo:
spark.sql.catalog.paimon.metastore dlf.Después de crear una sesión SQL, su estado inicial es Starting. La sesión queda lista cuando el estado cambia a Running. En la página SQL Session, puede detener, editar o eliminar sesiones.
-
Consulta de registros de ejecución
Cuando un trabajo finaliza, puede consultar su historial de ejecución.
En la página SQL Sessions, haga clic en el nombre de la sesión deseada.
-
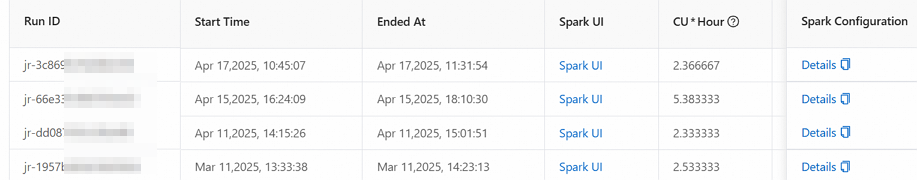
Haga clic en la pestaña Execution Records.
En esta pestaña, consulte los detalles de cada ejecución, como el identificador de ejecución, la hora de inicio y el enlace a Spark UI.
Temas relacionados
Para conocer las operaciones relacionadas con las colas, consulte Manage resource queues.
Si necesita información sobre los roles y permisos de las sesiones, revise Manage users and roles.
Para ver un ejemplo completo del flujo de trabajo de desarrollo de trabajos SQL, consulte Spark SQL quick start.