Cuando varios equipos comparten un clúster de Hadoop, la contención de recursos provoca un rendimiento impredecible en los trabajos y dificulta la asignación de costos. Los programadores de YARN resuelven este problema al aplicar garantías de recursos por inquilino, implementar directivas de equidad multiinquilino y optimizar la utilización de los nodos para evitar puntos críticos.
Se recomienda Capacity Scheduler para YARN en E-MapReduce (EMR). Este documento explica el funcionamiento de Capacity Scheduler y cómo configurarlo. Para otros tipos de programadores, consulte la documentación de Apache Hadoop YARN.
Elegir un programador
|
Programador |
Predeterminado en |
Compatibilidad multiinquilino |
Etiquetas de nodo / atributos / restricciones de ubicación |
Cuándo utilizarlo |
|
FIFO Scheduler |
— |
No |
No |
Escenarios sencillos con un solo inquilino. Rara vez se usa en producción. |
|
Fair Scheduler |
CDH (Cloudera Distributed Hadoop) |
Sí |
No |
Clústeres heredados de CDH. No se recomienda para despliegues nuevos. |
|
Capacity Scheduler |
Apache Hadoop, HDP, CDP |
Sí |
Sí |
Clústeres de producción multiinquilino que requieren aislamiento de rendimiento y recursos. Recomendado para YARN en EMR. |
Capacity Scheduler ofrece el conjunto completo de funciones de gestión multiinquilino y programación de recursos, incluidas la programación global, las etiquetas de nodo, los atributos de nodo y las restricciones de ubicación. El resto de este documento describe Capacity Scheduler en detalle.
Funcionamiento de Capacity Scheduler
Modos de programación
El MainScheduler de Capacity Scheduler admite tres modos de activación:
|
Modo |
Funcionamiento |
Recomendado para |
|
Basado en latidos de nodo |
El MainScheduler se activa cuando un nodo envía un latido. La programación es local al nodo y depende de los intervalos de latido, lo que puede reducir la eficiencia si muchos nodos carecen de recursos suficientes. |
Clústeres con requisitos bajos de rendimiento y funciones de programación. |
|
Programación asíncrona |
Un hilo asíncrono selecciona aleatoriamente un nodo de la lista para programar tareas. Esto mejora el throughput sin necesidad de mantener un estado global. |
Clústeres con altos requisitos de rendimiento pero pocos requisitos de funciones. |
|
Programación global |
Un hilo global selecciona aplicaciones según la equidad multiinquilino y la prioridad; luego elige nodos según el tamaño de los recursos, las restricciones de ubicación y la distribución de recursos en el clúster. Esto genera decisiones de programación óptimas. |
Clústeres con altos requisitos tanto de rendimiento como de funciones de programación. |
La programación global requiere todas las configuraciones de programación asíncrona además de sus propios ajustes. Consulte Programación global para obtener más detalles.
Arquitectura (programación global)
La siguiente figura muestra la arquitectura de la programación global basada en YARN 3.2 o versiones posteriores.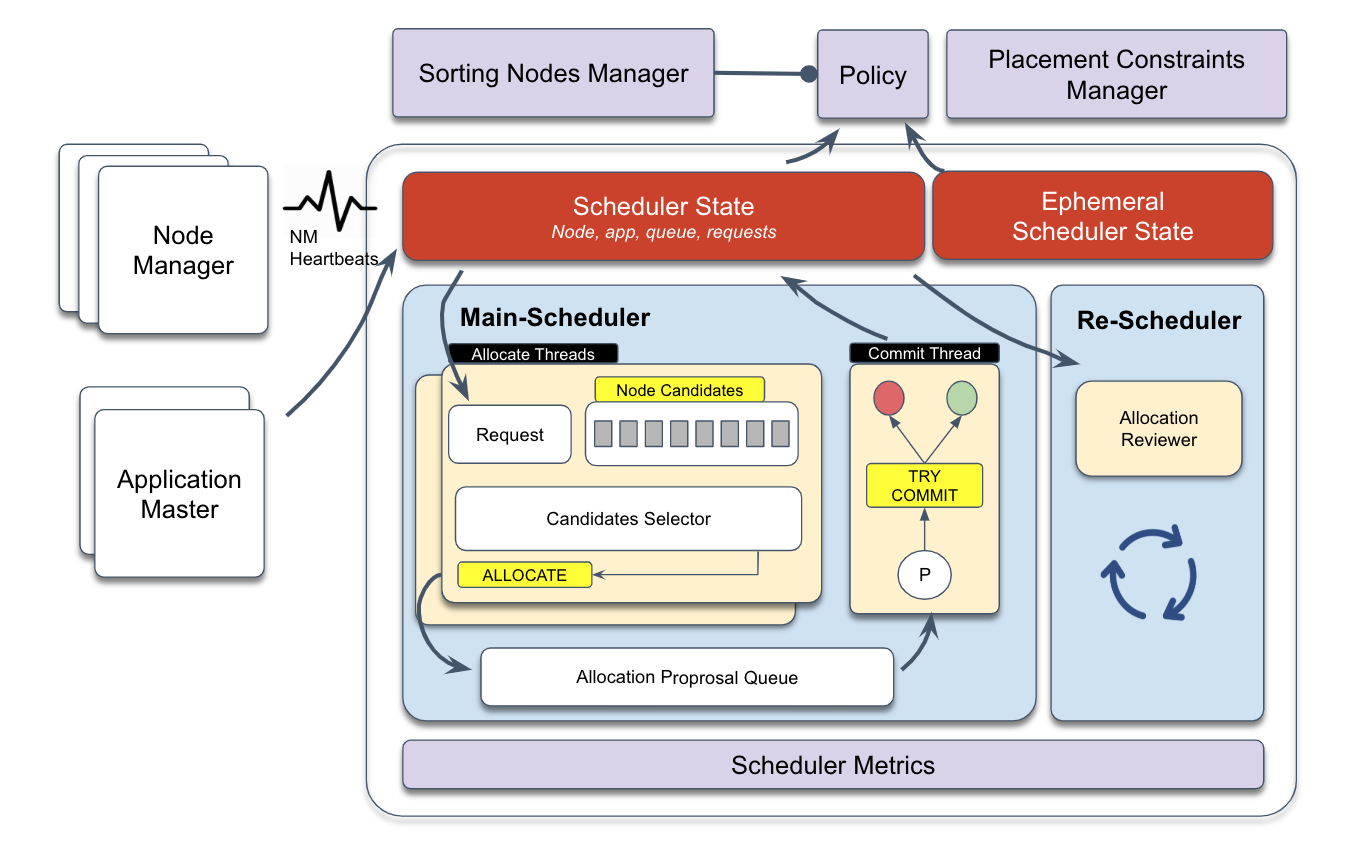
MainScheduler se ejecuta como un framework multihilo asíncrono:
Hilos de asignación: identifican la solicitud de recursos de mayor prioridad, seleccionan nodos candidatos según el tamaño de los recursos y las restricciones de ubicación, generan propuestas de asignación y las colocan en una cola intermedia.
Hilo de envío: consume las propuestas de asignación, vuelve a comprobar las restricciones de ubicación y los requisitos de la aplicación y del nodo, y luego confirma o descarta cada propuesta y actualiza el estado del programador.
ReScheduler se ejecuta periódicamente como un framework de monitoreo dinámico de recursos. Implementa directivas para la apropiación entre colas, la apropiación dentro de una misma cola y la apropiación de recursos reservados.
Node Sorting Manager y Placement Constraint Manager son complementos de programación global para MainScheduler. Se encargan del balanceo de carga y de la gestión compleja de restricciones de ubicación.
Proceso de asignación de contenedores
La siguiente figura ilustra el proceso de programación global de Capacity Scheduler.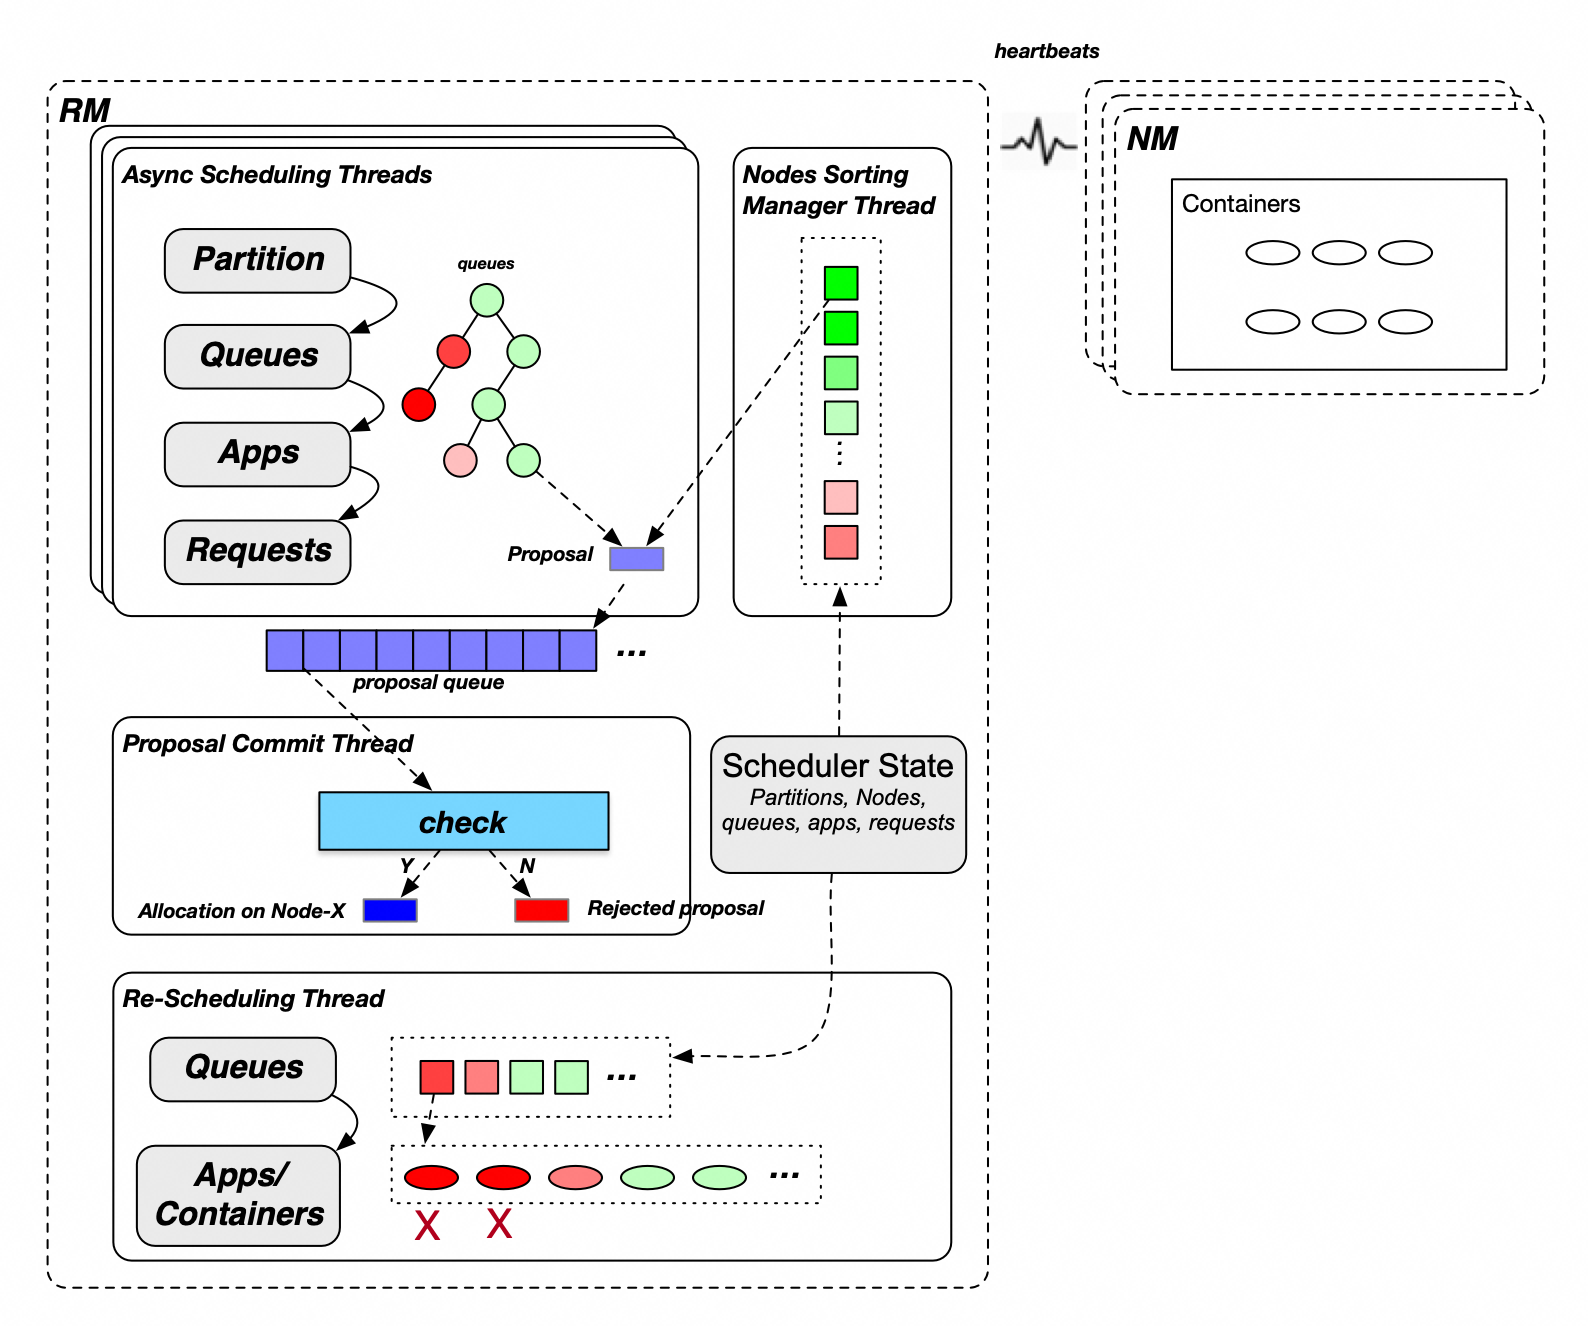
MainScheduler asigna contenedores en seis pasos:
Seleccionar particiones (etiquetas de nodo). Un clúster puede tener una o más particiones. MainScheduler asigna contenedores a las particiones de forma rotativa.
Seleccionar colas hoja. Al recorrer la jerarquía desde la cola raíz hacia abajo, las colas secundarias de cada nivel se visitan en orden ascendente según su porcentaje de recursos garantizados. Las colas con menor utilización (en verde en la figura anterior) reciben recursos antes que aquellas con mayor utilización (en rojo).
-
Seleccionar aplicaciones. Dentro de una cola, MainScheduler selecciona las aplicaciones según la directiva de ordenamiento de la cola:
Directiva Fair: orden ascendente de recursos de memoria asignados.
Directiva FIFO: orden descendente de prioridad y, después, orden ascendente de ID de aplicación.
Seleccionar solicitudes. MainScheduler elige las solicitudes dentro de la aplicación seleccionada según su prioridad.
Seleccionar nodos candidatos ordenados. MainScheduler busca en todos los nodos ordenados aquellos candidatos que cumplen con los requisitos de recursos y las restricciones de ubicación de la solicitud.
Asignar un contenedor. Para cada nodo candidato, MainScheduler verifica los recursos asignados, en uso y sin confirmar de la cola y del nodo. Si la verificación es correcta, genera una propuesta de asignación y la coloca en la cola de propuestas.
Después de la asignación, el hilo de envío valida cada propuesta frente a los requisitos de la aplicación, del nodo y de las restricciones de ubicación. Las propuestas que no superan la validación se descartan; las aprobadas entran en vigor y actualizan el conteo de recursos de la aplicación y del nodo.
Apropiación de recursos
ReScheduler monitorea los recursos del clúster y desencadena la apropiación cuando los recursos disponibles totales caen por debajo de un umbral y ciertas aplicaciones carecen de recursos suficientes.
|
Tipo de apropiación |
Condición de activación |
|
Apropiación entre colas |
Una cola utiliza por completo sus recursos garantizados, pero otra cola con derecho a esos recursos no puede obtenerlos porque el clúster no tiene capacidad libre. Los recursos dentro de la capacidad de la cola están garantizados; los recursos por encima de la capacidad pero por debajo de la capacidad máxima se comparten. |
|
Apropiación dentro de la cola |
Una aplicación de alta prioridad en una cola necesita recursos, pero la asignación total de la cola está agotada. ReScheduler reequilibra los recursos según la directiva FIFO o fair. |
|
Apropiación de recursos reservados |
Una tarea que reservó recursos cumple una condición de liberación, como un tiempo de espera agotado. La tarea y sus recursos reservados se liberan. |
Funciones clave
Gestión de colas multinivel: La cuota de recursos de una cola principal limita el uso total de todas sus colas secundarias. Ninguna cola secundaria puede superar la cuota de la principal. Esto permite un aislamiento multiinquilino controlable para estructuras organizacionales complejas.
Cuota de recursos: Establezca la capacidad garantizada y la capacidad máxima por cola, limite el número de aplicaciones simultáneas, restrinja la proporción de recursos del ApplicationMaster (AM) y controle las proporciones de recursos por usuario.
Uso compartido elástico de recursos: Cuando el clúster y la cola principal tienen recursos libres, las colas secundarias pueden tomar prestados recursos garantizados no utilizados de colas hermanas. Capacidad elástica = capacidad máxima de la cola − capacidad de la cola.
Control de acceso basado en listas de control de acceso (ACL): Asigne permisos de envío y gestión por cola a usuarios o grupos específicos. Un solo usuario puede gestionar varias colas, o varios usuarios pueden compartir el acceso de envío a la misma cola.
Programación de colas entre inquilinos: En el mismo nivel de colas, estas se programan en orden ascendente según su porcentaje de recursos garantizados, de modo que las colas con menores asignaciones se atienden primero. Cuando se configuran prioridades, las colas se dividen en dos grupos: las que están en o por debajo de su capacidad y las que la superan; dentro de cada grupo, se atienden primero las colas en o por debajo de su capacidad.
Programación de aplicaciones dentro del inquilino: Dentro de una cola, las aplicaciones se programan según la directiva de ordenamiento de la cola. Con la directiva FIFO: prioridad descendente y luego hora de envío ascendente. Con la directiva fair: porcentaje ascendente de recursos utilizados y luego hora de envío ascendente.
Apropiación de recursos: Mantiene equilibrado el uso de recursos de colas y aplicaciones conforme cambian los recursos del clúster. Consulte Apropiación de recursos para conocer los tres tipos de apropiación.
Configurar Capacity Scheduler
Configuraciones globales
Configure los siguientes parámetros en yarn-site.xml y capacity-scheduler.xml.
| Archivo de configuración | Parámetro de configuración | Valor recomendado | Descripción |
|---|---|---|---|
yarn-site.xml | yarn.resourcemanager.scheduler.class | Dejar en blanco | Clase del programador. Valor predeterminado: org.apache.hadoop.yarn.server.resourcemanager.scheduler.capacity.CapacityScheduler. |
capacity-scheduler.xml | yarn.scheduler.capacity.maximum-applications | Dejar en blanco | Número máximo de aplicaciones simultáneas en el clúster. Valor predeterminado: 10000. |
yarn.scheduler.capacity.global-queue-max-application | Dejar en blanco | Número máximo de aplicaciones simultáneas por cola. Si no se establece, el límite por cola se calcula como: Capacidad de la cola / Recursos del clúster × maximum-applications. Configure este valor solo para colas con requisitos especiales, como una cola de baja capacidad que necesita ejecutar muchas aplicaciones. | |
yarn.scheduler.capacity.maximum-am-resource-percent | 0.25 | Porcentaje máximo de recursos de la cola que pueden usar los contenedores del ApplicationMaster (AM), con un tope de: este valor × capacidad máxima de la cola. Valor predeterminado: 0.1. Aumente este valor si una cola ejecuta muchas aplicaciones pequeñas con una alta proporción de contenedores AM. | |
yarn.scheduler.capacity.resource-calculator | org.apache.hadoop.yarn.util.resource.DominantResourceCalculator | Calculadora de recursos para colas, nodos y aplicaciones. La opción predeterminada (DefaultResourceCalculator) solo considera la memoria. DominantResourceCalculator considera todos los tipos de recursos configurados (memoria, CPU y otros) y usa el recurso más consumido como recurso principal. Nota Los cambios en este parámetro requieren reiniciar ResourceManager (o realizar un cambio primario/secundario si la alta disponibilidad (HA) está habilitada). Una operación de actualización no es suficiente. | |
yarn.scheduler.capacity.node-locality-delay | -1 | Número de ciclos de programación que se omiten antes de relajar la localidad del nodo. Valor predeterminado: 40. Establézcalo en -1 para deshabilitar el retraso de localidad y mejorar el rendimiento de la programación. Con redes y almacenamiento modernos, la programación local rara vez es el cuello de botella. |
Configuraciones de latidos de nodo
|
Archivo de configuración |
Parámetro de configuración |
Valor recomendado |
Descripción |
|
|
|
|
Indica si se asignan varios contenedores por latido. Valor predeterminado: |
|
|
Dejar en blanco |
Número máximo de contenedores asignables por latido. Valor predeterminado: 100. Solo aplica cuando |
|
|
|
Dejar en blanco |
Número máximo de contenedores fuera del switch asignables por latido. Solo aplica cuando |
Programación asíncrona
|
Archivo de configuración |
Parámetro de configuración |
Valor recomendado |
Descripción |
|
|
|
|
Indica si se habilita la programación asíncrona. Valor predeterminado: |
|
|
|
Número máximo de hilos para la programación asíncrona. Valor predeterminado: 1. Varios hilos pueden generar propuestas duplicadas; un solo hilo es suficiente en la mayoría de los casos. |
|
|
|
Dejar en blanco |
Número máximo de propuestas de asignación pendientes en la cola. Valor predeterminado: 100. Aumente este valor para clústeres grandes. |
Programación global
La programación global requiere todas las configuraciones de programación asíncrona listadas en la tabla anterior.
| Archivo de configuración | Parámetro de configuración | Valor recomendado | Descripción |
|---|---|---|---|
capacity-scheduler.xml | yarn.scheduler.capacity.multi-node-placement-enabled | true | Indica si se habilita la programación global. Valor predeterminado: false. Habilítela en clústeres con altos requisitos tanto de rendimiento como de funciones de programación. |
yarn.scheduler.capacity.multi-node-sorting.policy | default | Nombre de la directiva de programación global activa. | |
yarn.scheduler.capacity.multi-node-sorting.policy.names | default | Lista separada por comas de nombres de directivas de programación global. | |
yarn.scheduler.capacity.multi-node-sorting.policy.default.class | org.apache.hadoop.yarn.server.resourcemanager.scheduler.placement.ResourceUsageMultiNodeLookupPolicy | Clase de implementación de la directiva predeterminada. Ordena los nodos en orden ascendente según los recursos absolutos asignados. | |
yarn.scheduler.capacity.multi-node-sorting.policy.default.sorting-interval.ms | 0 (clústeres pequeños) / 1000 (clústeres con más de 1,000 nodos) | Intervalo de actualización de caché para el ordenamiento de nodos. Valor predeterminado: 1000 ms. Establézcalo en 0 para ordenamiento síncrono (sin caché). Para clústeres grandes, establézcalo en 1000 para habilitar la caché de nodos y mejorar el rendimiento. Nota Con la caché de nodos habilitada, los contenedores pueden concentrarse en los nodos mejor clasificados. Pruebe el impacto antes de habilitar esta opción en producción. |
Configuraciones de particiones de nodo
Para las configuraciones de particiones de nodo (etiquetas de nodo), consulte Node labels.
Configuraciones de colas
Configuraciones básicas de colas
Las configuraciones básicas de colas definen la jerarquía de colas, la capacidad garantizada y la capacidad máxima. El siguiente ejemplo muestra una cola raíz con cuatro colas secundarias compartidas entre los departamentos de una organización.

Ejemplo de estructura de colas:
|
Cola |
Recursos garantizados |
Recursos máximos |
Colas secundarias |
|
|
100% |
100% |
dev, test, support, default |
|
|
50% |
100% |
training, services |
|
|
40% de dev |
100% de dev |
— |
|
|
60% de dev |
100% de dev |
— |
|
|
30% |
50% |
— |
|
|
10% |
30% |
— |
|
|
10% |
100% |
— |
El siguiente ejemplo de capacity-scheduler.xml configura esta estructura. Cópielo y ajústelo para que coincida con la disposición de colas de su organización.
<configuration>
  <!-- Root-level child queues -->
  <property>
    <name>yarn.scheduler.capacity.root.queues</name>
    <value>dev,test,support,default</value>
  </property>

  <!-- dev queue: 50% guaranteed, 100% max -->
  <property>
    <name>yarn.scheduler.capacity.root.dev.capacity</name>
    <value>50</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.maximum-capacity</name>
    <value>100</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.queues</name>
    <value>training,services</value>
  </property>

  <!-- dev.training: 40% of dev guaranteed, 100% of dev max -->
  <property>
    <name>yarn.scheduler.capacity.root.dev.training.capacity</name>
    <value>40</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.training.maximum-capacity</name>
    <value>100</value>
  </property>

  <!-- dev.services: 60% of dev guaranteed, 100% of dev max -->
  <property>
    <name>yarn.scheduler.capacity.root.dev.services.capacity</name>
    <value>60</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.services.maximum-capacity</name>
    <value>100</value>
  </property>

  <!-- test queue: 30% guaranteed, 50% max -->
  <property>
    <name>yarn.scheduler.capacity.root.test.capacity</name>
    <value>30</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.test.maximum-capacity</name>
    <value>50</value>
  </property>

  <!-- support queue: 10% guaranteed, 30% max -->
  <property>
    <name>yarn.scheduler.capacity.root.support.capacity</name>
    <value>10</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.support.maximum-capacity</name>
    <value>30</value>
  </property>

  <!-- default queue: 10% guaranteed, 100% max -->
  <property>
    <name>yarn.scheduler.capacity.root.default.capacity</name>
    <value>10</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.default.maximum-capacity</name>
    <value>100</value>
  </property>
</configuration>
En la página Application Queues de YARN ResourceManager, puede verificar que la configuración de colas haya surtido efecto. El árbol de jerarquía de colas muestra las siguientes colas bajo root: default, test, support, dev, y bajo dev las subcolas training y services. Expanda la cola dev.services para ver los detalles de su estado de ejecución:
Queue State: RUNNING
Effective Capacity:
memory:7864, vCores:4(60.0%)Effective Max Capacity:
memory:26214, vCores:16(100.0%)Absolute Configured Capacity: 30.0%
Max Applications: 3000
Ordering Policy: FifoOrderingPolicy
Preemption: disabled
La siguiente tabla describe los parámetros de capacity-scheduler.xml para esta estructura.
|
Archivo de configuración |
Parámetro de configuración |
Valor de ejemplo |
Descripción |
|
|
|
|
Colas secundarias de la cola raíz. Separe varias colas con comas. |
|
|
|
Porcentaje de recursos garantizados para la cola |
|
|
|
|
Porcentaje máximo de recursos para la cola |
|
|
|
|
Colas secundarias de la cola |
|
|
|
|
Porcentaje de recursos garantizados para |
|
|
|
|
Porcentaje máximo de recursos para |
|
|
|
|
Porcentaje de recursos garantizados para |
|
|
|
|
Porcentaje máximo de recursos para |
|
|
|
|
Porcentaje de recursos garantizados para |
|
|
|
|
Porcentaje máximo de recursos para |
|
|
|
|
Porcentaje de recursos garantizados para |
|
|
|
|
Porcentaje máximo de recursos para |
|
|
|
|
Porcentaje de recursos garantizados para |
|
|
|
|
Porcentaje máximo de recursos para |
Configuraciones avanzadas de colas
|
Archivo de configuración |
Parámetro de configuración |
Valor recomendado |
Descripción |
|
|
|
|
Directiva de ordenamiento de aplicaciones dentro de una cola. |
|
|
Dejar en blanco |
Indica si se usa programación fair ponderada. Valor predeterminado: |
|
|
|
Dejar en blanco |
Estado de la cola. Valor predeterminado: |
|
|
|
Dejar en blanco |
Límite de recursos AM por cola. Valor predeterminado: hereda de |
|
|
|
Dejar en blanco |
Factor de límite superior para un solo usuario. Recursos máximos que puede usar un usuario: min(recursos máximos de la cola, recursos garantizados de la cola × userLimitFactor). Valor predeterminado: 1.0. |
|
|
|
Dejar en blanco |
Porcentaje mínimo de recursos garantizados que puede usar un solo usuario. Se calcula como: max(recursos garantizados / número de usuarios, recursos garantizados × min(userLimitFactor) / 100). Valor predeterminado: 100. |
|
|
|
Dejar en blanco |
Número máximo de aplicaciones simultáneas en esta cola. Valor predeterminado: porcentaje de recursos garantizados × |
|
|
|
Dejar en blanco |
ACL de envío para esta cola. Hereda de la cola principal si no se establece. |
|
|
|
Dejar en blanco |
ACL de gestión para esta cola. Hereda de la cola principal si no se establece. |
Configuraciones de ACL
La ACL está deshabilitada de forma predeterminada. Habilítela solo cuando su organización requiera control de acceso en el envío y la gestión de colas.
|
Archivo de configuración |
Parámetro de configuración |
Valor recomendado |
Descripción |
|
|
|
Dejar en blanco |
Indica si se habilita la ACL. Valor predeterminado: |
|
|
|
Dejar en blanco |
ACL de envío. Hereda de la cola principal si no se establece. De forma predeterminada, la cola raíz permite a todos los usuarios enviar aplicaciones. |
|
|
Dejar en blanco |
ACL de gestión. Hereda de la cola principal si no se establece. De forma predeterminada, la cola raíz permite a todos los usuarios gestionar colas. |
La ACL de una cola principal se aplica a todas sus colas secundarias. Si la cola raíz permite a todos los usuarios (valor predeterminado), las restricciones de ACL de las colas secundarias no surten efecto. Para aplicar la ACL de las colas secundarias, primero restrinja la cola raíz con la siguiente configuración:
yarn.scheduler.capacity.root.acl_submit_applications=<space>yarn.scheduler.capacity.root.acl_administer_queue=<space>
Para otorgar a un usuario o grupo permisos de envío y gestión en una cola, configure tanto acl_submit_applications como acl_administer_queue para esa cola.
Configuraciones de apropiación
La apropiación garantiza una distribución justa de recursos entre inquilinos y respeta las prioridades de las aplicaciones. Habilítela en clústeres con requisitos estrictos de programación. La apropiación requiere YARN V2.8.0 o posterior.
|
Archivo de configuración |
Parámetro de configuración |
Valor recomendado |
Descripción |
|
|
|
|
Habilita la apropiación. |
|
|
|
|
Habilita la apropiación dentro de la cola. La apropiación entre colas está habilitada de forma predeterminada y no se puede deshabilitar. |
|
|
|
Directiva de orden de apropiación dentro de la cola. Valor predeterminado: |
|
|
|
|
Indica si se protege esta cola contra la apropiación. Hereda de la cola principal si no se establece. Establecer esto en |
|
|
|
|
Indica si se deshabilita la apropiación dentro de la cola para esta cola. Hereda de la cola principal si no se establece. |
Gestionar configuraciones de colas con la API RESTful
A partir de YARN V3.2.0, puede usar la API RESTful para aplicar actualizaciones incrementales de configuración y ver todos los ajustes activos actualmente en capacity-scheduler.xml. Las versiones anteriores solo admiten actualizaciones completas mediante la operación RefreshQueues, sin posibilidad de inspeccionar las configuraciones activas.
Para habilitar la gestión de colas mediante la API RESTful, agregue los siguientes parámetros a yarn-site.xml:
|
Parámetro de configuración |
Valor recomendado |
Descripción |
|
|
|
Tipo de almacenamiento para las configuraciones del programador. |
|
|
|
Número máximo de versiones de configuración almacenadas en el sistema de archivos. Las versiones anteriores se eliminan automáticamente. |
|
|
|
Ruta donde se almacena |
Ver configuraciones activas:
API RESTful:
http://<rm-address>/ws/v1/cluster/scheduler-confHDFS:
${yarn.scheduler.configuration.fs.path}/capacity-scheduler.xml.<timestamp>— el archivo con la marca de tiempo mayor es la versión más reciente.
Actualizar configuraciones de forma incremental:
El siguiente ejemplo cambia yarn.scheduler.capacity.maximum-am-resource-percent a 0.2 y elimina el parámetro yarn.scheduler.capacity.xxx. Para eliminar un parámetro, omita el campo value.
curl -X PUT -H "Content-type: application/json" 'http://<rm-address>/ws/v1/cluster/scheduler-conf' -d '
{
  "global-updates": [
    {
      "entry": [{
        "key": "yarn.scheduler.capacity.maximum-am-resource-percent",
        "value": "0.2"
      },{
        "key": "yarn.scheduler.capacity.xxx"
      }]
    }
  ]
}'
Límites de recursos por contenedor
Los recursos máximos para un solo contenedor se determinan mediante los siguientes parámetros. Si una solicitud de contenedor supera el límite, el programador registra un error InvalidResourceRequestException: Invalid resource request....
|
Archivo de configuración |
Parámetro de configuración |
Descripción |
Valor predeterminado |
|
|
|
Memoria máxima por contenedor a nivel de clúster. Unidad: MiB. |
El valor de |
|
|
CPU máxima por contenedor a nivel de clúster. Unidad: vCore. |
|
|
|
|
|
Memoria máxima por contenedor a nivel de cola. Anula la configuración a nivel de clúster solo para esta cola. |
Dejar en blanco (hereda la configuración a nivel de clúster) |
|
|
CPU máxima por contenedor a nivel de cola. Anula la configuración a nivel de clúster solo para esta cola. |
Dejar en blanco (hereda la configuración a nivel de clúster) |