Configure y utilice JindoFS para lograr un almacenamiento nativo de la nube eficiente en clústeres de E-MapReduce 3.20.0 a 3.22.0.
Descripción general
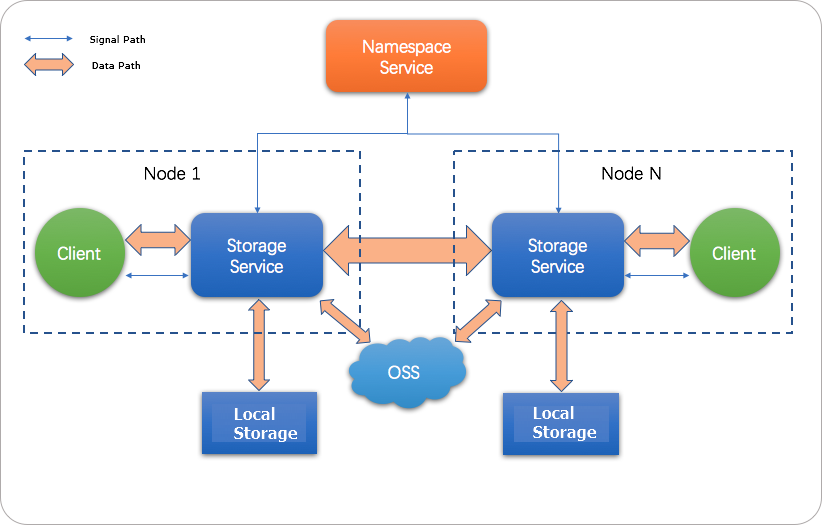
JindoFS es un sistema de archivos nativo de la nube que combina OSS y almacenamiento local. Como sistema de almacenamiento de próxima generación para E-MapReduce, ofrece un almacenamiento eficiente y confiable para los motores de cómputo.
JindoFS proporciona dos modos de almacenamiento: modo block storage y modo caché.
JindoFS utiliza un mecanismo heterogéneo de copias múltiples que aprovecha tanto el almacenamiento local como OSS. El servicio de almacenamiento usa OSS como su backend principal para garantizar una alta confiabilidad de los datos, y emplea el almacenamiento local para copias redundantes con el fin de acelerar las lecturas. Los metadatos se gestionan mediante el servicio Namespace local, lo que ofrece un rendimiento en operaciones de metadatos comparable al de HDFS.
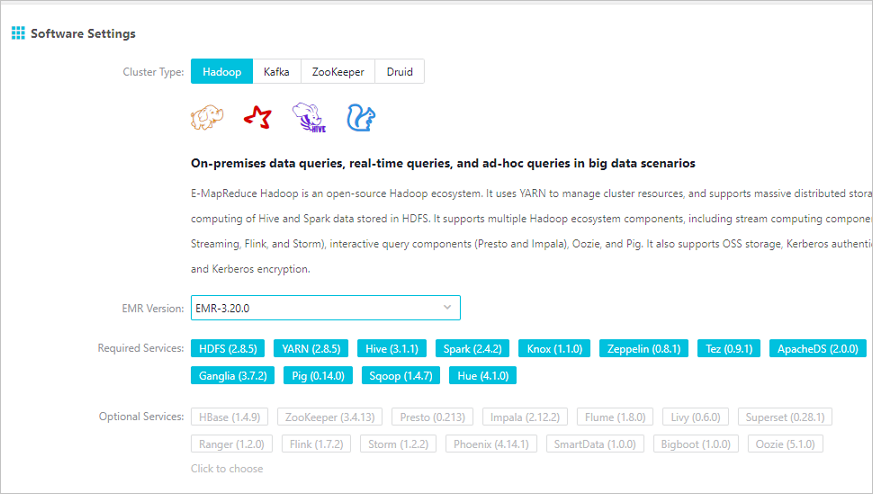
E-MapReduce 3.20.0 y versiones posteriores son compatibles con JindoFS. Para usar JindoFS, seleccione los servicios requeridos al crear un clúster.
Esta guía aborda el uso de JindoFS en versiones de E-MapReduce desde la 3.20.0 hasta la 3.22.0 (sin incluirla). Para obtener instrucciones sobre cómo utilizar JindoFS en E-MapReduce 3.22.0 y versiones posteriores, consulte SmartData User Guide (E-MapReduce 3.22.0 to 3.25.1).
Casos de uso
Actualmente, E-MapReduce ofrece tres sistemas de almacenamiento de big data: E-MapReduce OssFileSystem, E-MapReduce HDFS y E-MapReduce JindoFS. Tanto OssFileSystem como JindoFS son soluciones de almacenamiento basadas en la nube. La siguiente tabla compara las características de estos tres sistemas de almacenamiento y la compatibilidad de Hadoop con Alibaba Cloud OSS.
|
Función |
Compatibilidad de Hadoop con Alibaba Cloud OSS |
E-MapReduce OssFileSystem |
E-MapReduce HDFS |
E-MapReduce JindoFS |
|
Capacidad de almacenamiento |
Enorme |
Enorme |
Depende de la escala del clúster |
Enorme |
|
Confiabilidad |
Alta |
Alta |
Alta |
Alta |
|
Factor de rendimiento |
Servidor |
Rendimiento de E/S de las cachés de disco |
Rendimiento de E/S de los discos |
Rendimiento de E/S de los discos |
|
Eficiencia en consultas de metadatos |
Baja |
Media |
Alta |
Alta |
|
Escalado horizontal |
Sencillo |
Sencillo |
Sencillo |
Sencillo |
|
Reducción de escala |
Sencilla |
Sencilla |
Requiere desmantelamiento de nodos |
Sencilla |
|
Localidad de datos |
Ninguna |
Débil |
Fuerte |
Media |
El modo block storage de JindoFS cuenta con las siguientes funciones:
Capacidad de almacenamiento elástico ilimitada: OSS funciona como backend de almacenamiento. El almacenamiento no está limitado por el clúster local, el cual puede escalarse horizontalmente o reducirse libremente.
Aceleración de lectura local: JindoFS utiliza los recursos de almacenamiento del clúster local para agilizar la lectura de datos. Este método resulta adecuado para clústeres con capacidades de almacenamiento local y mejora el rendimiento de lectura incluso cuando dicho almacenamiento es limitado. Es especialmente eficaz para cargas de trabajo de escritura única y lectura múltiple (WORM).
Operaciones de metadatos de alto rendimiento: La eficiencia de las operaciones de metadatos es comparable a la de HDFS. Esto evita la latencia de las operaciones de metadatos del sistema de archivos OSS y la inestabilidad que podría causar el acceso frecuente.
Localidad de datos: Se maximiza la localidad de datos durante la ejecución de trabajos, lo que reduce el tráfico de red y mejora aún más el rendimiento de lectura.
Requisitos previos
-
Seleccione una versión de E-MapReduce desde la 3.20.0 hasta la 3.22.0 (sin incluirla). En la sección de servicios opcionales, seleccione SmartData y Bigboot. Para obtener más información, consulte Create a cluster. El servicio Bigboot proporciona servicios básicos de plataforma, como gestión distribuida de datos y monitoreo de componentes. Sobre la base de Bigboot, el servicio SmartData ofrece el sistema de archivos JindoFS a las aplicaciones.
-
Configuración del clúster
El sistema de archivos JindoFS proporcionado por SmartData utiliza OSS como backend de almacenamiento. Antes de usar JindoFS, configure los parámetros de OSS requeridos mediante uno de estos dos métodos: modifique los parámetros de Bigboot después de crear el clúster y reinicie SmartData, o bien agregue configuraciones personalizadas durante la creación del clúster para que los servicios se inicien con los parámetros especificados.
-
Método 1: Configurar después de crear el clúster
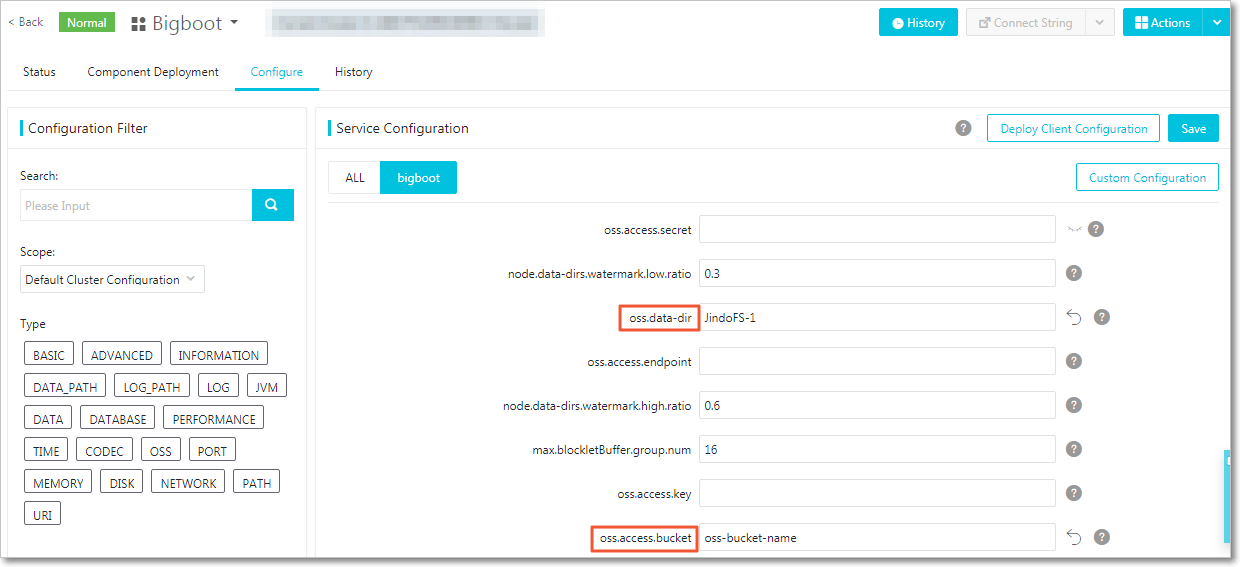
oss.access.bucketespecifica el nombre del bucket de OSS.oss.data-direspecifica el directorio que JindoFS utiliza dentro del bucket de OSS. Nota: Este directorio sirve como backend de almacenamiento de JindoFS. No altere manualmente los datos que contiene y asegúrese de que se use exclusivamente para JindoFS. No es necesario crear este directorio en OSS con antelación; JindoFS lo crea automáticamente al escribir datos por primera vez.oss.access.endpointespecifica la región donde se encuentra el bucket.oss.access.keyespecifica el AccessKey ID para el backend de almacenamiento de OSS.oss.access.secretespecifica el AccessKey secret para el backend de almacenamiento de OSS.
Para obtener un rendimiento y una estabilidad óptimos, utilice un bucket de OSS en la misma región que su clúster de E-MapReduce. Esto permite el acceso sin credenciales, sin necesidad de configurar un AccessKey ID ni un AccessKey secret.
Todas las configuraciones de JindoFS se encuentran en el componente Bigboot. La siguiente imagen resalta los elementos obligatorios en rojo.
 Nota
JindoFS admite varios namespaces. En este tema se utiliza como ejemplo un namespace llamado
test
.
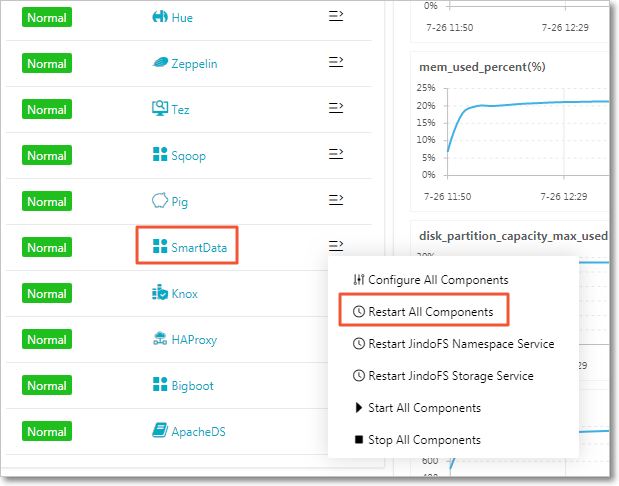
Una vez completada la configuración, guárdela y despliéguela. Después, reinicie todos los componentes del servicio SmartData para comenzar a utilizar JindoFS.
-
Método 2: Configurar durante la creación del clúster
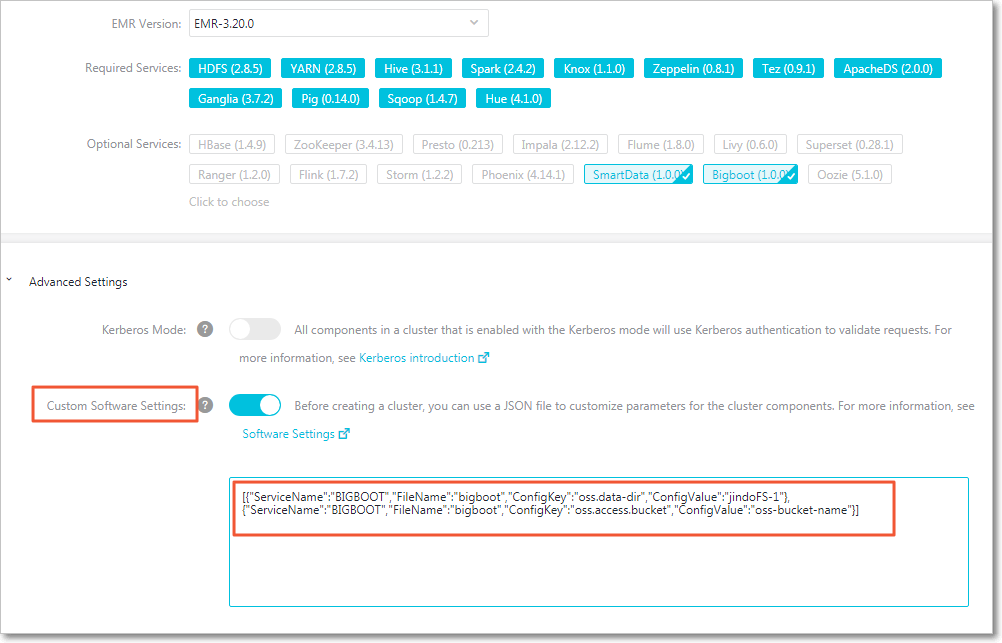
Es posible agregar configuraciones personalizadas al crear un clúster de E-MapReduce. Por ejemplo, para habilitar el acceso a un bucket de OSS en la misma región sin credenciales, seleccione
Custom Software Configuration
como se muestra en la imagen, y agregue el siguiente JSON para configurar
oss.data-dir
y
oss.access.bucket
.
[
    {
    "ServiceName":"BIGBOOT",
    "FileName":"bigboot",
    "ConfigKey":"oss.data-dir",
    "ConfigValue":"jindoFS-1"
    },
    {
    "ServiceName":"BIGBOOT",
    "FileName":"bigboot",
    "ConfigKey":"oss.access.bucket",
    "ConfigValue":"oss-bucket-name"
    }
]
-
Uso de JindoFS
El uso de JindoFS es similar al de HDFS. Reemplace el prefijo
hdfs://
por
jfs://
. Por ejemplo:
hadoop fs -ls jfs:///
hadoop fs -mkdir jfs:///test-dir
hadoop fs -put test.log jfs:///test-dir/
JindoFS admite trabajos de Hadoop, Hive y Spark en clústeres de E-MapReduce. Aún no se ofrece compatibilidad completa con otros componentes.
Control de niveles de espacio en disco
JindoFS utiliza OSS como backend para ofrecer una capacidad de almacenamiento masiva, pero el espacio en disco local es limitado. JindoFS expulsa automáticamente las copias de seguridad de datos fríos con base en dos parámetros de nivel: node.data-dirs.watermark.high.ratio y node.data-dirs.watermark.low.ratio. Ambos parámetros se establecen como una proporción (un valor decimal de 0 a 1) respecto a la capacidad total del disco. Cuando el uso del disco alcanza el nivel alto, JindoFS expulsa datos hasta que el nivel de uso desciende al nivel bajo. El valor del nivel bajo debe ser inferior al del nivel alto.
Aplicar una política de almacenamiento
Ejecute el siguiente comando para establecer una política de almacenamiento en un directorio:
jindo dfsadmin -R -setStoragePolicy [path] [policy]Ejecute el siguiente comando para consultar la política de almacenamiento de un directorio:
jindo dfsadmin -getStoragePolicy [path]|
Parámetro |
Descripción |
|
|
La ruta del directorio donde se aplicará o consultará la política. |
|
|
El nombre de la política de almacenamiento: |
|
|
Aplica la política de forma recursiva a todos los subdirectorios. |