Delta Lake es una solución de data lake de Databricks que gestiona todo el ciclo de vida de los datos, desde la ingesta, organización y administración hasta las consultas y la extracción. En combinación con herramientas externas ascendentes y descendentes, Delta Lake le permite construir un data lake rápido, fácil de usar y seguro.
Contexto
Una solución típica de data lake almacena diversos tipos de datos en un motor de almacenamiento de big data, como Alibaba Cloud Object Storage Service (OSS) o un sistema de archivos distribuidos Hadoop local (HDFS), y se conecta a un motor de análisis como Spark o Presto para analizar sintácticamente los datos. Sin embargo, este enfoque presenta los siguientes problemas:
Las importaciones con errores generan datos sucios difíciles de limpiar, y los trabajos fallidos son complicados de recuperar.
No existe un proceso de extracción, transformación y carga (ETL), lo que provoca una supervisión inadecuada de la calidad de los datos.
Falta compatibilidad con transacciones para aislar las operaciones de lectura y escritura, lo que impide ejecutar de forma independiente las operaciones de lectura y escritura por lotes y en streaming.
La solución Delta Lake funciona de la siguiente manera:
Añade una capa de gestión de datos sobre la capa de almacenamiento de big data, similar a la gestión de metadatos en una base de datos. Los metadatos se almacenan junto con los datos y son visibles para los usuarios, como se muestra en Data warehouse and data lake.
Delta Lake introduce atomicidad, consistencia, aislamiento y durabilidad (ACID) mediante la gestión de metadatos, lo que resuelve los problemas de datos sucios por importaciones fallidas y la falta de aislamiento de lectura y escritura durante la ingesta de datos.
Los metadatos almacenan las columnas de la tabla de origen, y Delta Lake valida los datos durante la importación para garantizar su calidad.
La compatibilidad con transacciones permite que las operaciones de lectura y escritura por lotes y en streaming se ejecuten de forma aislada.
ACID es el acrónimo de las cuatro propiedades clave que garantizan transacciones fiables en bases de datos: atomicidad, consistencia, aislamiento y durabilidad.
Figura 1. Data warehouse y data lake 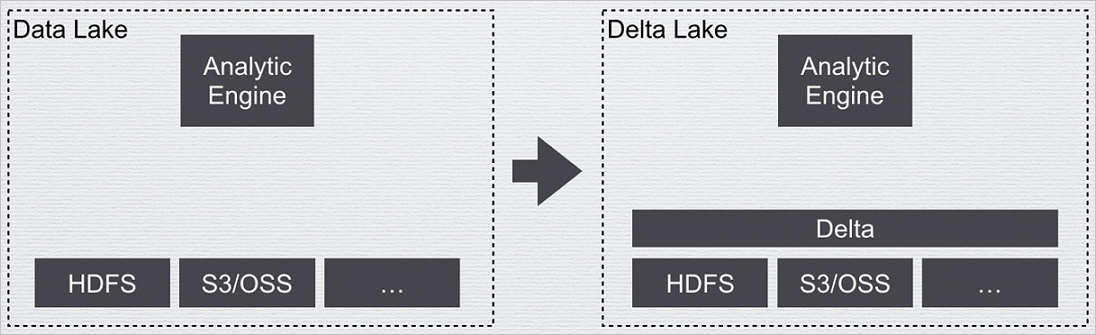
A continuación se comparan Data Warehouse, Data Lake y Delta Lake.
|
Criterio de comparación |
Data Warehouse |
Data Lake |
Delta Lake |
|
Arquitectura |
Cómputo y almacenamiento acoplados o desacoplados |
Cómputo y almacenamiento desacoplados |
Cómputo y almacenamiento desacoplados |
|
Gestión del almacenamiento |
Estricta y propietaria |
Formato nativo |
Formato común y ligero |
|
Escenarios |
Informes y análisis |
Informes, análisis y ciencia de datos |
Informes, análisis y ciencia de datos |
|
Flexibilidad |
Baja |
Alta |
Alta |
|
Calidad y fiabilidad de los datos |
Muy alta |
Baja |
Alta |
|
Transaccional |
Compatible |
No compatible |
Compatible |
|
Rendimiento |
Alto |
Bajo |
Alto |
|
Extensibilidad |
Depende de la implementación |
Alta |
Alta |
|
Usuarios |
Administradores |
Administradores y científicos de datos |
Administradores y científicos de datos |
|
Costo |
Alto |
Bajo |
Bajo |
Escenarios
Delta Lake es adecuado para la gestión de data lakes basados en la nube y admite los siguientes escenarios:
Consultas en tiempo real: los datos fluyen desde fuentes ascendentes hacia Delta Lake en tiempo real y están disponibles de inmediato para consultas. Por ejemplo, en un escenario de captura de datos modificados (CDC), puede usar Spark Streaming para consumir binlogs en tiempo real. La función merge de Delta Lake actualiza los datos ascendentes en el data lake, y luego puede consultarlos con Hive, Spark o Presto. Gracias a la compatibilidad con ACID, la ingesta de datos y las consultas están aisladas, lo que evita lecturas sucias.
Eliminación o actualización para el Reglamento General de Protección de Datos (GDPR): las soluciones típicas de data lake no admiten eliminaciones ni actualizaciones. Para modificar datos en estas soluciones, debe borrar los datos sin procesar y reescribirlos en el almacenamiento. Delta Lake admite la eliminación y actualización directa de datos.
Sincronización de datos en tiempo real con CDC: utilice la función merge de Delta Lake para ejecutar un trabajo de streaming que fusione datos ascendentes en el data lake en tiempo real.
Control de calidad de datos: utilice la validación de esquemas de Delta Lake para filtrar datos anómalos durante la importación o procesarlos posteriormente.
Evolución de esquemas: los esquemas de datos no son fijos. Delta Lake le permite modificar el esquema de datos mediante una API.
Machine learning en tiempo real: en los escenarios de machine learning, gran parte del esfuerzo se dedica al procesamiento de datos (limpieza, transformación y extracción de características), lo que normalmente requiere manejar por separado los datos históricos y en tiempo real. Delta Lake simplifica esto al unificar todo el pipeline de procesamiento de datos en un único flujo confiable en tiempo real. Operaciones como la limpieza de datos, la transformación y la ingeniería de características se convierten en acciones de streaming, lo que elimina la necesidad de procesar por separado los datos históricos y en tiempo real.
Comparación con Delta Lake de código abierto
EMR Delta Lake amplía Delta Lake de código abierto con compatibilidad adicional para SQL, Optimize y más. A continuación se comparan las funciones de EMR Delta Lake y Delta Lake de código abierto (versión 0.6.1).
|
Función |
EMR Delta |
Delta de código abierto |
|
SQL |
|
|
|
API |
|
|
|
Conector de Hive |
Compatible |
Compatible |
|
Conector de Presto |
Compatible |
Compatible |
|
Parquet |
Compatible |
Compatible |
|
ORC |
No compatible |
No compatible |
|
Formato de texto |
No compatible |
No compatible |
|
Data Skipping |
Compatible |
No compatible |
|
ZOrder |
Compatible |
No compatible |
|
Native DeltaLog |
Compatible |
No compatible |