Data Transmission Service (DTS) sincroniza datos desde una base de datos PostgreSQL —incluidas bases de datos PostgreSQL autogestionadas e instancias de RDS for PostgreSQL— hacia una instancia de SelectDB para análisis a gran escala. Este tema utiliza una instancia de RDS for PostgreSQL como origen.
Funcionamiento
Una tarea de sincronización de DTS ejecuta tres fases en secuencia:
Sincronización de esquemas: DTS replica la estructura de las tablas del origen al destino.
Sincronización completa de datos: DTS copia todos los datos existentes del origen al destino como línea base.
Sincronización incremental de datos: DTS captura los cambios continuos del registro de escritura anticipada (WAL) de PostgreSQL mediante replicación lógica y los aplica en el destino.
La sincronización incremental de datos tiene costo. La sincronización de esquemas y la sincronización completa de datos son gratuitas. Para más detalles, consulte Descripción general de facturación.
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
Una instancia de SelectDB de destino con un espacio de almacenamiento mayor que el tamaño de los datos utilizados por la instancia de RDS for PostgreSQL de origen. Para crear una, consulte Create an instance.
El parámetro
wal_levelde la instancia de RDS for PostgreSQL de origen establecido enlogical. Para configurarlo, consulte Set instance parameters.
Permisos obligatorios
|
Base de datos |
Permisos obligatorios |
Cómo otorgarlos |
|
Instancia de RDS for PostgreSQL de origen |
Una cuenta con privilegios que sea propietaria (Owner) de la base de datos que se va a sincronizar |
|
|
Instancia de SelectDB de destino |
Permisos de acceso al clúster (Usage_priv) y permisos de lectura/escritura en la base de datos (Select_priv, Load_priv, Alter_priv, Create_priv, Drop_priv) |
Operaciones SQL compatibles
|
Tipo de operación |
Sentencias SQL |
|
DML |
INSERT, UPDATE, DELETE |
|
DDL |
ADD COLUMN, DROP COLUMN |
No se admiten operaciones DDL que modifican varias columnas a la vez, ni operaciones DDL consecutivas en la misma tabla.
Limitaciones
Revise las siguientes limitaciones antes de configurar la tarea de sincronización.
Requisitos de la base de datos de origen
-
Claves primarias y restricciones UNIQUE: Todas las tablas que se van a sincronizar deben tener una clave primaria o una restricción UNIQUE para evitar datos duplicados en el destino.
Si la tabla de destino no fue creada por DTS (es decir, si no seleccionó Schema synchronization en Synchronization types), asegúrese de que la tabla de destino tenga la misma clave primaria o una restricción UNIQUE no vacía que la tabla de origen. De lo contrario, podrían aparecer datos duplicados en el destino.
-
Para tablas que no tienen clave primaria ni restricción UNIQUE: seleccione Schema synchronization en Synchronization types y luego establezca Engine en duplicate para esas tablas en el paso Configurations for databases, tables, and columns. Si omite este paso, la tarea podría fallar o se podrían perder datos.
NotaDurante la sincronización inicial de esquemas, DTS agrega columnas a la tabla de destino. Para más detalles, consulte Additional columns.
Nombres de bases de datos: Los nombres de las bases de datos que se van a sincronizar no pueden contener guiones (-). Por ejemplo,
dts-testdatano es válido.Gran cantidad de tablas: Si sincroniza a nivel de tabla, edita objetos (como la asignación de nombres de columnas) y el número total de tablas en una sola tarea supera las 5,000, divida las tablas en varias tareas o configure la tarea para sincronizar toda la base de datos. Superar este límite puede causar un error de solicitud al enviar la tarea.
-
Retención de registros WAL: DTS lee los cambios incrementales del WAL. Si los registros se purgan antes de que DTS los procese, la tarea falla y puede provocar inconsistencia o pérdida de datos no cubierta por el acuerdo de nivel de servicio (SLA) de DTS. Puede cambiar el periodo de retención de registros a más de 24 horas después de que finalice la sincronización completa inicial de datos.
Tipo de sincronización
Periodo mínimo de retención de WAL
Solo sincronización incremental de datos
Más de 24 horas
Sincronización completa de datos + sincronización incremental de datos
Como mínimo 7 días
Comportamiento durante failover: Si el origen es una base de datos PostgreSQL autogestionada y ocurre un failover, la tarea de sincronización falla. Para instancias de RDS for PostgreSQL, habilite Logical Replication Slot Failover para evitar interrupciones de la replicación durante los failovers. Para más detalles, consulte Logical Replication Slot Failover.
Registros incrementales grandes: Si un solo cambio incremental supera los 256 MB después de la codificación, la instancia de sincronización falla y no se puede recuperar. Vuelva a configurar la instancia de sincronización.
-
Operaciones DDL durante la sincronización: No ejecute operaciones de lenguaje de definición de datos (DDL) que cambien los esquemas de la base de datos o de las tablas durante la sincronización de esquemas o la sincronización completa de datos. Estas operaciones provocan el fallo de la tarea.
Durante la sincronización completa de datos, DTS consulta la base de datos de origen y adquiere bloqueos de metadatos. Esto puede bloquear las operaciones DDL en el origen.
Transacciones de larga duración: Si la base de datos de origen tiene transacciones de larga duración durante la sincronización incremental, los registros WAL generados antes de que se confirmen esas transacciones no se pueden borrar. Esto provoca la acumulación de registros WAL y puede agotar el espacio en disco de la base de datos de origen.
Actualizaciones de versión principal: No realice una actualización de versión principal del motor en la base de datos de origen mientras se ejecuta una tarea de sincronización. La tarea falla y no se puede recuperar. Vuelva a configurar la instancia de sincronización.
Requisitos de destino y de configuración
Motores de tabla compatibles: DTS solo puede sincronizar datos a tablas que utilizan el motor Unique o Duplicate en SelectDB.
Tablas con motor Unique: Todas las claves únicas en la tabla de destino también deben existir en la tabla de origen e incluirse como objetos de sincronización. De lo contrario, puede ocurrir inconsistencia de datos.
-
Tablas con motor Duplicate: Pueden aparecer datos duplicados en el destino en estos escenarios. Utilice las columnas adicionales (
_is_deleted,_versiony_record_id) para identificar y eliminar duplicados. Para detalles de las columnas, consulte Additional columns.Se ha reintentado la instancia de sincronización.
Se ha reiniciado la instancia de sincronización.
Se realizan dos o más operaciones DML en el mismo registro de datos después de iniciar la tarea.
Cuando la tabla de destino utiliza el motor Duplicate, DTS convierte las sentencias UPDATE y DELETE en sentencias INSERT.
Parámetro
bucket_count: En el cuadro Selected objects, solo puede establecer el parámetrobucket_count. El valor debe ser un entero positivo. El valor predeterminado es auto.Requisitos de nomenclatura: SelectDB solo admite nombres de bases de datos y tablas que comienzan con una letra. Si un nombre no comienza con una letra, utilice la función de asignación para renombrarlo. Del mismo modo, si el nombre de un objeto de sincronización (base de datos, tabla o columna) contiene caracteres chinos, utilice la función de asignación para renombrarlo a un nombre en inglés. De lo contrario, la tarea podría fallar.
Una base de datos por tarea: Una instancia de sincronización solo puede sincronizar una base de datos. Para sincronizar varias bases de datos, configure una instancia independiente para cada una.
Tipos de objeto no compatibles: DTS no sincroniza tablas de extensión de TimescaleDB, tablas con herencia entre esquemas ni tablas que contienen índices únicos basados en expresiones.
-
Requisito REPLICA IDENTITY FULL: Antes de escribir datos en las siguientes tablas, ejecute el comando siguiente para garantizar la consistencia de los datos. No realice operaciones de bloqueo de tablas mientras ejecuta este comando, ya que las tablas podrían quedar bloqueadas. Si omite los elementos de verificación previa relacionados, DTS ejecuta este comando automáticamente durante la inicialización de la instancia. Ejecute este comando cuando:
La instancia se ejecuta por primera vez.
La granularidad de sincronización es de esquema y se crea una nueva tabla en el esquema sincronizado, o se reconstruye una tabla mediante RENAME.
Utiliza la función Modify objects.
ALTER TABLE schema.table REPLICA IDENTITY FULL;Reemplace
schemaytablecon los nombres reales del esquema y la tabla. Ejecute este comando fuera del horario de máxima actividad. Carga de sincronización completa de datos: Durante la sincronización completa de datos, DTS utiliza recursos de lectura y escritura tanto en la base de datos de origen como en la de destino, lo que aumenta la carga de la base de datos. Evalúe el rendimiento de ambas bases de datos antes de comenzar y programe la sincronización fuera del horario de máxima actividad, cuando la carga de CPU sea inferior al 30%.
Cambios en nodos de backend: No agregue nodos de backend (BE) a la base de datos de SelectDB durante la sincronización. Hacerlo provoca el fallo de la tarea. Reinicie la instancia de sincronización para reanudarla.
Nuevos clústeres: No cree un nuevo clúster en la instancia de SelectDB de destino durante la sincronización. Hacerlo provoca el fallo de la tarea. Reinicie la instancia de sincronización para reanudarla.
Fusión de múltiples tablas: En un escenario de fusión de múltiples tablas donde los datos de varias tablas de origen se sincronizan a una sola tabla de destino, todas las tablas de origen deben tener el mismo esquema. De lo contrario, puede ocurrir inconsistencia de datos o fallo de la tarea.
Validación de metadatos: DTS valida el contenido de los datos, pero no valida metadatos como las secuencias. Valide los metadatos manualmente.
Tablas particionadas: Incluya tanto la tabla padre como todas sus tablas hijas como objetos de sincronización. La tabla padre de una tabla particionada de PostgreSQL no almacena datos directamente; todos los datos residen en las tablas hijas. Omitir las tablas hijas provoca inconsistencia de datos.
Tablas temporales: DTS crea las siguientes tablas temporales en la base de datos de origen para capturar sentencias DDL, estructuras de tablas e información de latido. No elimine estas tablas durante la sincronización, ya que la tarea se volverá anómala. Se eliminan automáticamente cuando se libera la instancia de DTS:
public.dts_pg_class,public.dts_pg_attribute,public.dts_pg_type,public.dts_pg_enum,public.dts_postgres_heartbeat,public.dts_ddl_command,public.dts_args_sessionypublic.aliyun_dts_instance.-
Ranuras de replicación: DTS crea una ranura de replicación con el prefijo
dts_sync_en la base de datos de origen. DTS utiliza esta ranura para obtener registros incrementales de la base de datos de origen dentro de un plazo de 15 minutos. Cuando la tarea falla o se libera la instancia, DTS intenta borrar esta ranura automáticamente.ImportanteSi cambia la contraseña de la cuenta de la base de datos o elimina las direcciones IP de DTS de la lista de permitidos de la base de datos de origen durante la sincronización, la ranura de replicación no se puede borrar automáticamente. Bórrela manualmente para evitar la acumulación de espacio en disco. Si ocurre un failover en la base de datos de origen, inicie sesión en la base de datos secundaria para borrar la ranura de replicación manualmente.
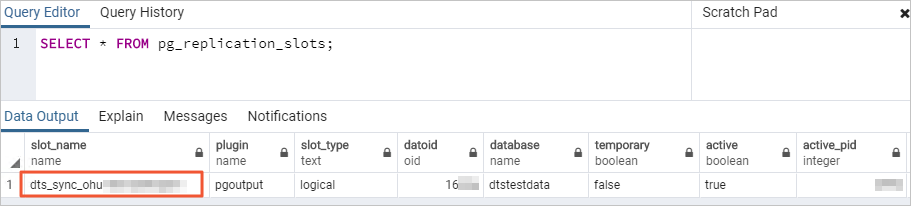
-
Latencia de sincronización incremental: DTS utiliza una política de sincronización por lotes para reducir la carga en el destino. De forma predeterminada, DTS escribe datos como máximo una vez cada 5 segundos por objeto de sincronización, lo que resulta en una latencia típica de menos de 10 segundos. Para reducir la latencia, modifique el parámetro
selectdb.reservoir.timeout.millisecondsde la instancia de DTS en la consola. El rango válido es de 1,000 a 10,000 milisegundos.Reducir el intervalo de procesamiento por lotes aumenta la frecuencia de escritura. Esto puede incrementar la carga y el tiempo de respuesta de escritura de la instancia de destino, lo que a su vez aumenta la latencia de sincronización. Ajústelo según la carga real del destino.
Recuperación de tareas: Si la tarea falla, el soporte técnico de DTS intenta recuperarla dentro de un plazo de 8 horas. Durante la recuperación, DTS puede reiniciar la tarea o ajustar sus parámetros (no los parámetros de la base de datos). Los parámetros que se pueden modificar incluyen los descritos en Modify instance parameters.
Casos especiales
|
Escenario |
Requisito |
|
El origen es una instancia de RDS for PostgreSQL |
No cambie el endpoint ni la zona de la instancia durante la sincronización. Hacerlo provoca el fallo de la tarea. |
|
El origen es una base de datos PostgreSQL autogestionada |
Asegúrese de que los valores de |
|
El origen es Google Cloud SQL for PostgreSQL |
La cuenta de la base de datos debe tener el permiso |
Creación de una tarea de sincronización
Paso 1: Ir a la lista de tareas de sincronización de datos
Utilice uno de los siguientes métodos para navegar a la lista de tareas de sincronización en la región de destino.
Desde la consola de DTS:
Inicie sesión en la consola de Data Transmission Service (DTS).
En el panel de navegación izquierdo, haga clic en Data Synchronization.
En la esquina superior izquierda, seleccione la región donde reside la instancia de sincronización.
Desde la consola de DMS:
Los pasos reales pueden variar según el modo y el diseño de la consola de DMS. Para más detalles, consulte Consola en modo simple y Personalizar el diseño y estilo de la interfaz de DMS .
Inicie sesión en Data Management (DMS).
En la barra de menú superior, elija Data + AI > Data Transmission (DTS) > Data Synchronization.
A la derecha de Data Synchronization Tasks, seleccione la región donde reside la instancia de sincronización.
Paso 2: Configurar las bases de datos de origen y de destino
Haga clic en Create Task.
-
Configure las bases de datos de origen y de destino. Task name: DTS genera un nombre de tarea automáticamente. Especifique un nombre descriptivo para facilitar su identificación. El nombre no necesita ser único.
Base de datos de origen
Parámetro
Descripción
Select existing connection
Seleccione una instancia de base de datos guardada de la lista si la ha agregado al sistema. De lo contrario, configure la conexión manualmente. En la consola de DMS, este parámetro se llama Select a DMS database instance.
Database type
Seleccione PostgreSQL.
Access method
Seleccione Alibaba Cloud Instance.
Instance region
Seleccione la región donde reside la instancia de RDS for PostgreSQL de origen.
Replicate data across Alibaba Cloud accounts
Seleccione No si la instancia de origen pertenece a la cuenta actual de Alibaba Cloud.
Instance ID
Seleccione el ID de la instancia de RDS for PostgreSQL de origen.
Database name
Introduzca el nombre de la base de datos que contiene los objetos que se van a sincronizar.
Database account
Introduzca la cuenta de la base de datos. Para los permisos obligatorios, consulte Permisos obligatorios.
Database password
Introduzca la contraseña de la cuenta de la base de datos.
Base de datos de destino
Parámetro
Descripción
Select existing connection
Seleccione una instancia de base de datos guardada de la lista si la ha agregado al sistema. De lo contrario, configure la conexión manualmente. En la consola de DMS, este parámetro se llama Select a DMS database instance.
Database type
Seleccione SelectDB.
Access method
Seleccione Alibaba Cloud Instance.
Instance region
Seleccione la región donde reside la instancia de SelectDB de destino.
Replicate data across Alibaba Cloud accounts
Seleccione No si la instancia de destino pertenece a la cuenta actual de Alibaba Cloud.
Instance ID
Seleccione el ID de la instancia de SelectDB de destino.
Database account
Introduzca la cuenta de la base de datos. Para los permisos obligatorios, consulte Permisos obligatorios.
Database password
Introduzca la contraseña de la cuenta de la base de datos.
-
Haga clic en Test Connectivity and Proceed.
Asegúrese de que los bloques de direcciones IP de los servidores de DTS estén agregados a la configuración de seguridad de las bases de datos de origen y de destino. Esto se puede hacer automática o manualmente. Para más detalles, consulte Agregar los bloques de direcciones IP de los servidores de DTS a una lista de permitidos . Si el origen o el destino es una base de datos autogestionada (donde Access method no es Alibaba Cloud Instance ), haga clic también en Test Connectivity en el cuadro de diálogo CIDR blocks of DTS servers .
Paso 3: Configurar objetos de sincronización
En la página Configure objects, establezca los siguientes parámetros.
| Parámetro | Descripción |
|---|---|
| Synchronization types | Incremental Data Synchronization está seleccionado de forma predeterminada. Seleccione también Schema Synchronization y Full Data Synchronization. Después de que la verificación previa se apruebe, DTS inicializa todos los objetos seleccionados del origen y los utiliza como línea base para la sincronización incremental. Importante
Al sincronizar de PostgreSQL a SelectDB, los tipos de datos se convierten. Si no selecciona Schema Synchronization, cree tablas de modelo Unique o Duplicate con los esquemas correctos en la instancia de SelectDB de destino con antelación. Para más detalles, consulte Data type mapping y Data models. |
| Processing mode of conflicting tables | Precheck and report errors: DTS comprueba si existe una tabla con el mismo nombre en el destino. Si existe, la verificación previa falla y la tarea no se inicia. Para resolver esto sin eliminar la tabla, utilice la función de asignación para renombrarla. Consulte Asignar esquemas, tablas y columnas. Ignore errors and proceed: Omite la comprobación. Aviso
Esto puede causar inconsistencia de datos. Si los esquemas coinciden, los registros con la misma clave primaria o clave única en el destino se sobrescriben. Si los esquemas difieren, la inicialización puede fallar o solo se sincronizan datos parciales. |
| Capitalization of object names in destination instance | Configure la política de distinción entre mayúsculas y minúsculas para los nombres de bases de datos, tablas y columnas sincronizados en el destino. El valor predeterminado es la política predeterminada de DTS. Para más detalles, consulte Política de distinción entre mayúsculas y minúsculas para nombres de objetos de destino. |
| Source objects | Haga clic en un objeto en el cuadro Source objects y luego haga clic en  para moverlo al cuadro Selected objects. Seleccione objetos a nivel de esquema o de tabla. |
| Selected objects | Haga clic derecho en un objeto para renombrarlo, establecer una cláusula WHERE para filtrar filas o seleccionar qué operaciones SQL incluir para la sincronización incremental. Para eliminar un objeto, haga clic en él y luego haga clic en  . Si seleccionó Schema Synchronization y agregó objetos a nivel de tabla, haga clic derecho en una tabla para establecer el parámetro bucket_count en Parameter settings. Nota
El uso de la función de asignación de nombres de objetos puede causar fallos de sincronización en otros objetos que dependen del objeto renombrado. |
Haga clic en Next: Advanced Settings.
Paso 4: Configurar ajustes avanzados (opcional)
| Parámetro | Descripción |
|---|---|
| Dedicated cluster for task scheduling | De forma predeterminada, DTS programa tareas en un clúster compartido. Para un rendimiento más estable, adquiera un clúster dedicado. Consulte ¿Qué es un clúster dedicado de DTS?. |
| Retry time for failed connections | Después de iniciar la tarea, si falla la conexión al origen o al destino, DTS reintenta durante un máximo de 720 minutos de forma predeterminada. Establezca una duración personalizada entre 10 y 1,440 minutos. Configure este valor en 30 minutos o más. Si la reconexión tiene éxito dentro del periodo de reintento, la tarea se reanuda automáticamente. Nota
Si varias instancias de DTS comparten el mismo origen o destino, el tiempo de reintento más corto entre esas instancias se aplica a todas. DTS cobra por el tiempo de ejecución de la tarea durante el periodo de reintento. |
| Retry time for other issues | Si ocurren problemas que no son de conectividad (como errores de ejecución DDL o DML), DTS reintenta durante un máximo de 10 minutos de forma predeterminada. Establezca una duración personalizada entre 1 y 1,440 minutos. Configure este valor en 10 minutos o más. Importante
Este valor debe ser menor que el tiempo de reintento para conexiones fallidas. |
| Enable throttling for full data synchronization | Limite la tasa de lectura en el origen y la tasa de escritura en el destino durante la sincronización completa para reducir la carga de la base de datos. Configure Queries per second (QPS) to the source database, RPS of full data migration y Data migration speed for full migration (MB/s). Esta configuración solo está disponible cuando se selecciona Full Data Synchronization. También puede ajustar la velocidad de sincronización completa después de que la instancia esté en ejecución. |
| Enable throttling for incremental data synchronization | Limite la tasa de escritura en el destino durante la sincronización incremental. Configure RPS of incremental data synchronization y Data synchronization speed for incremental synchronization (MB/s). |
| Environment tag | Seleccione una etiqueta de entorno para identificar la instancia. Esta configuración es opcional. |
| Configure ETL | Habilite la función de extracción, transformación y carga (ETL) para transformar datos durante la sincronización. Seleccione Yes e introduzca las sentencias de procesamiento en el editor de código. Para más detalles, consulte Configurar ETL en una tarea de migración o sincronización de datos. |
| Monitoring and alerting | Configure alertas para fallos de tareas o infracciones de umbrales de latencia. Seleccione Yes y luego especifique el umbral de alerta y los destinatarios de la notificación. Para más detalles, consulte Configurar monitoreo y alertas durante la configuración de la tarea. |
Paso 5: Configurar campos de base de datos y tablas (opcional)
Si seleccionó Schema Synchronization, haga clic en Next: Configure Database and Table Fields para establecer la Primary Key Column, Distribution Key y Engine para cada tabla de destino.
Establezca Definition status en All para ver y modificar todas las tablas.
Seleccione una o más columnas para Primary Key Column . La Distribution Key debe incluir al menos una columna de la clave primaria.
Para tablas sin clave primaria o restricción UNIQUE, establezca Engine en duplicate . De lo contrario, la tarea podría fallar o se podrían perder datos.
Paso 6: Ejecutar la verificación previa y adquirir la instancia
-
Haga clic en Next: Save Task Settings and Precheck.
Para obtener una vista previa de los parámetros de OpenAPI para esta tarea, pase el cursor sobre el botón y haga clic en Preview OpenAPI parameters antes de hacer clic en él.
-
Espere a que finalice la verificación previa. La tarea solo puede iniciarse después de que se aprueben todos los elementos de la verificación previa.
Si un elemento de la verificación previa falla, haga clic en View Details, solucione el problema y ejecute la verificación previa nuevamente.
Si un elemento de la verificación previa genera una advertencia que se puede ignorar, haga clic en Confirm Alert Details, Ignore, OK y Precheck Again en secuencia. Ignorar advertencias puede causar inconsistencia de datos.
Cuando Success Rate alcance el 100%, haga clic en Next: Purchase Instance.
-
En la página Purchase, seleccione el método de facturación y la especificación de enlace.
Parámetro
Descripción
Billing method
Subscription: Pague por adelantado por una duración determinada. Adecuado para uso a largo plazo y más rentable que pay-as-you-go. Las suscripciones más largas ofrecen mayores descuentos. Pay-as-you-go: Se cobra por hora. Adecuado para uso a corto plazo. Libere la instancia después de usarla para detener los cargos.
Resource group configuration
El resource group al que pertenece la instancia. El valor predeterminado es el resource group predeterminado. Consulte What is Resource Management?.
Link specification
El nivel de rendimiento de sincronización. Las especificaciones más altas admiten tasas de sincronización más altas. Consulte Especificaciones de enlace de sincronización de datos.
Subscription duration
(Solo Subscription) Elija mensual (1–9 meses) o anual (1, 2, 3 o 5 años).
Lea los Data Transmission Service (Pay-as-you-go) Service Terms y luego haga clic en Buy and Start. En el cuadro de diálogo de confirmación, haga clic en OK.
Puede monitorear el progreso de la tarea en la página Data Synchronization.
Asignación de tipos de datos
| Categoría | Tipo de datos de PostgreSQL | Tipo de datos de SelectDB |
|---|---|---|
| Numérico | SMALLINT | SMALLINT |
| INTEGER | INT | |
| BIGINT | BIGINT | |
| DECIMAL | DECIMAL | |
| NUMERIC | DECIMAL | |
| REAL | DOUBLE | |
| DOUBLE | DOUBLE | |
| SMALLSERIAL | SMALLINT | |
| SERIAL | INT | |
| BIGSERIAL | BIGINT | |
| Monetario | MONEY | STRING |
| Carácter | CHAR(n), VARCHAR(n) | VARCHAR Importante
Para evitar la pérdida de datos, CHAR(n) y VARCHAR(n) se convierten a VARCHAR(4\*n). Si no se especifica longitud, se utiliza el valor predeterminado de SelectDB VARCHAR(65533). Si la longitud de los datos supera los 65,533 caracteres, los datos se convierten a STRING. |
| TEXT | STRING | |
| Binario | BYTEA | STRING |
| Fecha y hora | TIMESTAMP [(P)] [WITHOUT TIME ZONE] | DATETIMEV2 |
| TIMESTAMP [(P)] WITH TIME ZONE | DATETIMEV2 | |
| DATE | DATEV2 | |
| TIME [(P)] [WITHOUT TIME ZONE] | VARCHAR(50) | |
| TIME [(P)] WITH TIME ZONE | VARCHAR(50) | |
| INTERVAL [FIELDS] [(P)] | STRING | |
| Booleano | BOOLEAN | BOOLEAN |
| Geométrico | POINT, LINE, LSEG, BOX, PATH, POLYGON, CIRCLE | STRING |
| Dirección de red | CIDR, INET, MACADDR, MACADDR8 | STRING |
| Búsqueda de texto | TSVECTOR | STRING |
| XML | XML | STRING |
| JSON | JSON | JSON |
Columnas adicionales
DTS agrega automáticamente las siguientes columnas a las tablas de destino que utilizan el motor Duplicate. Si la tabla no fue creada por DTS, agregue estas columnas manualmente.
|
Columna |
Tipo de datos |
Valor predeterminado |
Descripción |
|
|
Int |
0 |
Indica si la fila está eliminada. INSERT: 0. UPDATE: 0. DELETE: 1. |
|
|
Bigint |
0 |
Para sincronización completa de datos: 0. Para sincronización incremental de datos: la marca de tiempo (en segundos) del registro binario de origen. |
|
|
Bigint |
0 |
Para sincronización completa de datos: 0. Para sincronización incremental de datos: el ID de registro único de la entrada de registro incremental. Este valor es único y se incrementa monótonamente. |