MaxCompute, antes conocido como ODPS, es una solución de almacenamiento de datos rápida y totalmente administrada que procesa exabytes de información. Con Data Transmission Service (DTS) se sincronizan los datos desde una instancia de ApsaraDB RDS for MySQL o de Serverless ApsaraDB RDS for MySQL hacia MaxCompute. Esto le permite construir rápidamente un sistema de análisis de datos en tiempo real.
Serverless ApsaraDB RDS for MySQL
Requisitos previos
Asegúrese de haber completado las siguientes operaciones:
Precauciones
Durante la inicialización completa de los datos, DTS consume recursos de lectura y escritura de las bases de datos de origen y destino, lo cual aumenta la carga de la base de datos. Si las bases de datos tienen un rendimiento bajo, especificaciones reducidas o cargas de trabajo intensas (por ejemplo, una gran cantidad de sentencias SQL lentas, tablas sin claves primarias o interbloqueos en la base de datos de destino), la presión sobre la base de datos puede incrementarse aún más y los servicios pueden dejar de estar disponibles. Por lo tanto, evalúe el rendimiento de las bases de datos de origen y destino antes de iniciar la sincronización de datos. Se recomienda ejecutar la sincronización durante las horas de menor actividad (por ejemplo, cuando la carga de CPU de ambas bases de datos sea inferior al 30 %).
Solo se admite la sincronización de datos a nivel de tabla.
Durante la sincronización de datos, no utilice herramientas como gh-ost o pt-online-schema-change para ejecutar operaciones DDL en línea sobre los objetos de sincronización en la base de datos de origen. De lo contrario, la tarea de sincronización fallará.
MaxCompute no admite restricciones PRIMARY KEY. Si DTS retransmite datos debido a problemas de red, pueden aparecer registros duplicados en MaxCompute.
Facturación
|
Tipo de sincronización |
Precio |
|
Sincronización de esquemas y sincronización completa de datos |
Sin costo. |
|
Sincronización incremental de datos |
Con costo. Para obtener más información, consulte Billing overview. |
Tipos de instancias de origen compatibles
La sincronización de datos es compatible con los siguientes tipos de bases de datos MySQL:
Una base de datos autogestionada en una instancia de ECS
Una base de datos autogestionada conectada mediante una línea dedicada, VPN Gateway o Smart Access Gateway
Una base de datos autogestionada conectada mediante Database Gateway
Una instancia de ApsaraDB RDS for MySQL que pertenezca a la misma cuenta de Alibaba Cloud o a una diferente
En este tema se utiliza una RDS Instance como ejemplo para describir el procedimiento de configuración. El procedimiento es similar para otros tipos de instancias de base de datos de origen.
Si la base de datos de origen es una base de datos MySQL autogestionada, también debe completar los pasos de preparación. Para obtener más información, consulte Preparation overview.
Operaciones SQL compatibles
Operaciones DDL: ALTER TABLE, ADD COLUMN
Operaciones DML: INSERT, UPDATE, DELETE
Proceso de sincronización
-
Sincronización inicial del esquema.
DTS sincroniza las definiciones de esquema de las tablas seleccionadas desde la base de datos de origen hacia MaxCompute. Durante la inicialización, DTS agrega el sufijo
_basea los nombres de las tablas. Por ejemplo, si la tabla de origen escustomer, la tabla en MaxCompute pasa a sercustomer_base. -
Sincronización inicial completa de datos.
DTS sincroniza todos los datos históricos de las tablas de la base de datos de origen hacia las tablas
_baseen MaxCompute. Por ejemplo, los datos se sincronizan desde la tablacustomerde la base de datos de origen hacia la tablacustomer_baseen MaxCompute. Estos datos sirven como línea base para la posterior sincronización incremental de datos.NotaEsta tabla también se conoce como tabla de línea base completa.
-
Sincronización incremental de datos.
DTS crea una tabla de registros incrementales en MaxCompute. El nombre de la tabla es el nombre de la tabla de destino con el sufijo
_log, comocustomer_log. Luego, DTS sincroniza los datos incrementales de la base de datos de origen hacia esta tabla en tiempo real.NotaPara obtener más información sobre la estructura de la tabla de registros incrementales, consulte Incremental log table schema.
Procedimiento
Para garantizar que la cuenta de sincronización de DTS reciba la autorización correspondiente, complete los siguientes pasos con su cuenta raíz.
-
Adquiera una instancia de sincronización de datos. Para obtener más información, consulte Purchase a DTS instance.
NotaAl adquirir la instancia, establezca la instancia de origen en MySQL, la instancia de destino en MaxCompute y la topología de sincronización en One-way Synchronization.
-
Inicie sesión en la consola de Data Transmission Service.
NotaSi el sistema lo redirige automáticamente a la consola de Data Management (DMS), haga clic en el ícono
 en la esquina inferior derecha y luego haga clic en
 para volver a la consola clásica de DTS.
En el panel de navegación izquierdo, haga clic en Data Synchronization.
-
En la barra de navegación superior de la página Data Synchronization, seleccione la región donde se encuentra la instancia de destino.
Busque la instancia de sincronización de datos adquirida y haga clic en Configure Synchronization Channel.
-
Configure las instancias de origen y destino.
Categoría
Configuración
Descripción
Ninguna
Synchronization Job Name
DTS genera automáticamente un nombre para el trabajo de sincronización. Se recomienda especificar un nombre descriptivo para identificarlo fácilmente. No es necesario que el nombre sea único.
Source Instance Information
Instance Type
Seleccione RDS Instance.
Instance Region
La región de la instancia de origen que seleccionó al adquirir la instancia de sincronización de datos. Este valor no se puede modificar.
Instance ID
Seleccione el ID de la instancia de RDS que funciona como origen de datos.
Database Account
Introduzca la cuenta de la base de datos de la instancia de RDS de origen.
NotaCuando el tipo de base de datos de la instancia de RDS de origen es MySQL 5.5 o MySQL 5.6, no es necesario configurar Database Account ni Database Password.
Database Password
Introduzca la contraseña correspondiente a la cuenta de la base de datos.
Connection Method
Seleccione Unencrypted Connection o Secure SSL Connection según sus necesidades. Si selecciona Secure SSL Connection, primero debe habilitar la función de cifrado SSL en la instancia de RDS. Para obtener más información, consulte Set SSL encryption.
ImportanteActualmente, Encryption solo se puede configurar en las regiones de China continental y China (Hong Kong).
Destination Instance Information
Instance Type
Establecido en MaxCompute; no se puede modificar.
Instance Region
La región de la instancia de destino que seleccionó al adquirir la instancia de sincronización de datos. Este valor no se puede modificar.
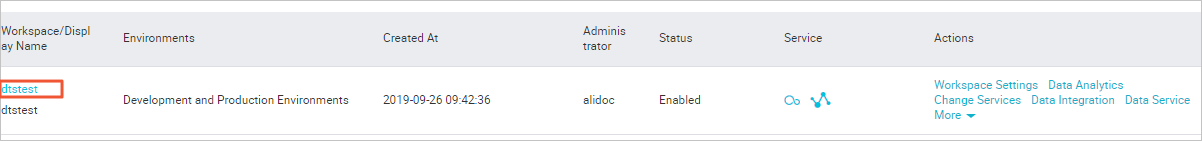
Project
Introduzca el Project de la instancia de MaxCompute. Puede encontrarlo en la página MaxCompute Workspace List.
-
En la esquina inferior derecha de la página, haga clic en Authorize Whitelist And Go To Next Step.
NotaSi la base de datos de origen o de destino es una instancia de base de datos de Alibaba Cloud, como una instancia de ApsaraDB RDS for MySQL, una instancia de ApsaraDB for MongoDB o una base de datos autogestionada en una instancia de ECS, DTS agrega automáticamente la dirección IP del servicio DTS de la región correspondiente a la lista de permitidos de la instancia de base de datos de Alibaba Cloud o a las reglas de seguridad de la instancia de ECS. No es necesario agregar la dirección IP manualmente. Para obtener más información, consulte IP address blocks of DTS servers.
-
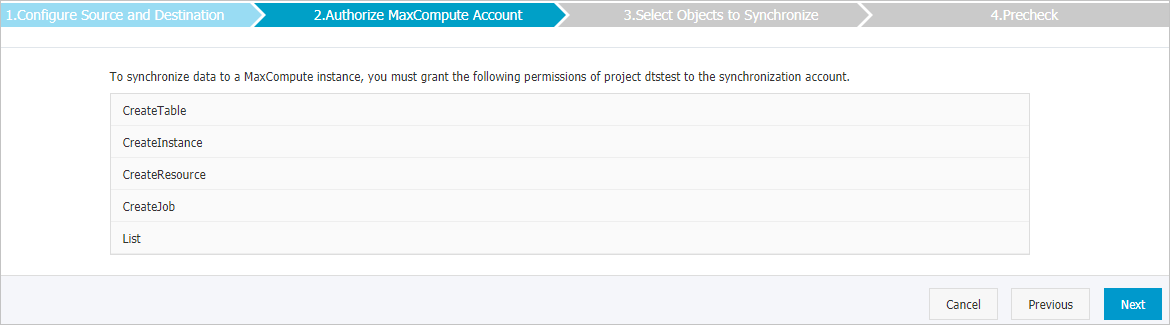
En la esquina inferior derecha de la página, haga clic en Next. Luego, otorgue a la cuenta de sincronización de DTS los permisos sobre el proyecto de MaxCompute, como se muestra en la siguiente figura.
-
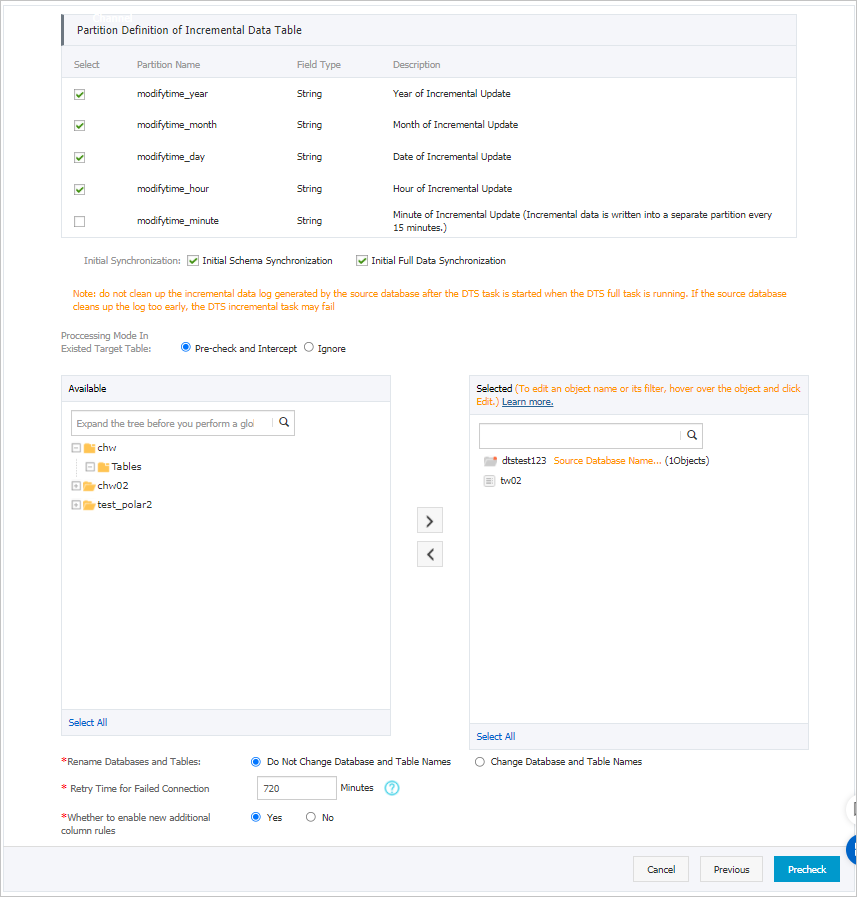
Configure la directiva y los objetos de sincronización.
Configuración
Descripción
Incremental Log Table Partition Definition
Seleccione los nombres de partición según sus necesidades. Para obtener más información sobre las particiones, consulte Partition.
Synchronization Initialization
La inicialización de la sincronización incluye la sincronización inicial del esquema y la sincronización inicial completa de datos.
Seleccione tanto Initial Schema Synchronization como Initial Full Data Synchronization. DTS sincronizará los esquemas y los datos históricos de los objetos seleccionados antes de sincronizar los datos incrementales.
Processing Mode for Existing Tables in the Destination
-
Precheck And Block On Error: La comprobación previa se supera si la base de datos de destino no contiene tablas con los mismos nombres que las tablas de la base de datos de origen. De lo contrario, se devuelve un error durante la comprobación previa y no se puede iniciar la tarea de sincronización de datos.
NotaSi no puede eliminar ni cambiar el nombre de la tabla con el mismo nombre en la base de datos de destino, puede set the name of the synchronization object in the destination instance para evitar conflictos de nombres.
-
Ignore Errors And Continue Execution: Omite la comprobación de tablas con los mismos nombres en la base de datos de destino.
AvisoSeleccionar Ignore Errors And Continue Execution puede provocar inconsistencias en los datos y representar riesgos para su negocio:
-
Si las estructuras de las tablas son consistentes y un registro de la base de datos de destino tiene el mismo valor de clave primaria que un registro de la base de datos de origen, el registro de la base de datos de destino se conserva durante la inicialización. Durante la sincronización incremental, el registro de la base de datos de destino se sobrescribe.
-
Si las estructuras de las tablas no son consistentes, la inicialización de datos puede fallar. Esto puede dar lugar a una sincronización parcial de los datos o a un fallo total de la sincronización.
-
Select Synchronization Objects
En el cuadro Source Objects, seleccione una o más tablas para sincronizar y haga clic en el ícono
 para moverlas al cuadro Selected Objects.Nota
-
Solo puede seleccionar tablas como objetos de sincronización. Es posible seleccionar tablas de varias bases de datos.
-
De forma predeterminada, los nombres de los objetos de sincronización permanecen sin cambios. Si desea que los nombres de los objetos sean diferentes en la instancia de destino, utilice la función de asignación de nombres de objetos. Para obtener más información, consulte Set the name of the synchronization object in the destination instance.
Select Additional Column Rule
Cuando DTS sincroniza datos hacia MaxCompute, agrega columnas a la tabla de destino. Si los nombres de estas columnas adicionales entran en conflicto con nombres de columnas existentes, la tarea de sincronización de datos falla. Según los requisitos de su negocio, establezca Enable New Additional Column Rule en Yes o No.
AvisoAntes de seleccionar una regla de columnas adicionales, evalúe si los nombres de dichas columnas entrarán en conflicto con los nombres de las columnas existentes en la tabla de destino. De lo contrario, la tarea podría fallar o podrían perderse datos. Para obtener más información sobre las reglas y definiciones de las columnas adicionales, consulte Additional column names and definitions.
Change mapping name
Cambie los nombres de los objetos sincronizados en la instancia de destino. Para obtener más información, consulte Map databases, tables, and columns.
Whether to copy temporary tables to the destination database during an online DDL operation on the source table using DMS
Si utiliza Data Management (DMS) para aplicar cambios DDL en línea en la base de datos de origen, puede elegir si desea sincronizar las tablas temporales generadas por dichos cambios.
-
Yes: Sincroniza las tablas temporales generadas por los cambios DDL en línea.
NotaSi los cambios DDL en línea generan una gran cantidad de datos en tablas temporales, la tarea de sincronización de datos podría retrasarse.
-
No: No sincroniza las tablas temporales generadas por los cambios DDL en línea. Solo se sincronizan las operaciones DDL originales de la base de datos de origen.
NotaEsta opción provoca que las tablas de la base de datos de destino se bloqueen.
Retry Time for Failed Connections to Source and Destination Databases
Si DTS no logra conectarse a la instancia de origen o de destino, reintenta la conexión durante 720 minutos (12 horas) de forma predeterminada. También puede especificar una duración de reintento personalizada. Si DTS se reconecta a la instancia de origen o de destino dentro de la duración especificada, la tarea de sincronización se reanuda automáticamente. De lo contrario, la tarea falla.
NotaSe le cobra por el tiempo de ejecución de la tarea durante los reintentos de conexión. Personalice la duración de reintento según las necesidades de su negocio o libere la instancia de DTS tan pronto como se liberen las instancias de origen y destino.
-
-
Después de completar las configuraciones anteriores, haga clic en Precheck and Start en la esquina inferior derecha de la página.
NotaAntes de que la tarea de sincronización comience oficialmente, se ejecuta una comprobación previa. La tarea de sincronización solo puede iniciarse después de superar dicha comprobación.
-
Si la comprobación previa falla, haga clic en el ícono
 junto a un elemento de comprobación específico para consultar los detalles del error.
Siga las indicaciones para corregir el problema y vuelva a ejecutar la comprobación previa.
Si no necesita corregir los elementos de comprobación con advertencia, también puede seleccionar Ignore, Ignore Warning Items and Rerun Precheck para omitir dichos elementos y volver a ejecutar la comprobación previa.
Una vez que se muestre Precheck Passed en el cuadro de diálogo Precheck, cierre el cuadro de diálogo. La tarea de sincronización comenzará automáticamente.
-
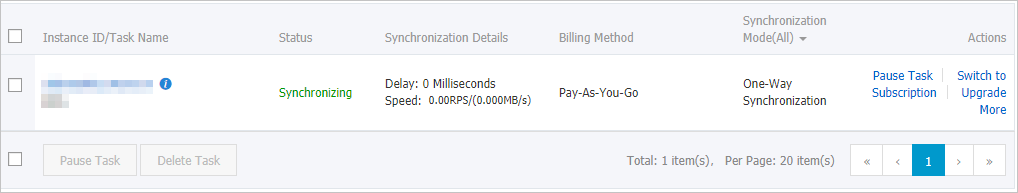
Espere hasta que el canal de sincronización se inicialice y la tarea entre en el estado Synchronizing.
La página
Data Synchronization
muestra el estado de los trabajos de sincronización de datos.
Esquema de la tabla de registros incrementales
Debe ejecutar set odps.sql.allow.fullscan=true; en MaxCompute para establecer las propiedades del proyecto y permitir exploraciones completas de tablas.
Cuando DTS sincroniza datos incrementales de MySQL a la tabla de registros incrementales en MaxCompute, almacena metadatos además de los datos incrementales, como se muestra en el siguiente ejemplo.
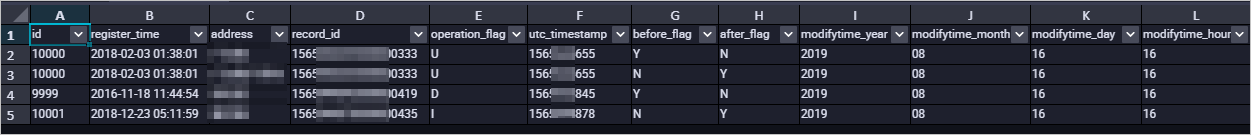
En el ejemplo, modifytime_year, modifytime_month, modifytime_day, modifytime_hour y modifytime_minute son campos de partición especificados en el paso Configure the synchronization policy and objects.
Definición del esquema
|
Campo |
Descripción |
|
record_id |
El ID de registro del registro incremental, que es el identificador único del registro. Nota
|
|
operation_flag |
El tipo de operación. Valores válidos:
|
|
utc_timestamp |
La marca de tiempo de la operación, que corresponde a la marca de tiempo del registro binario (en UTC). |
|
before_flag |
Indica si todos los valores de columna son los valores anteriores a la actualización. Valores válidos: Y o N. |
|
after_flag |
Indica si todos los valores de columna son los valores posteriores a la actualización. Valores válidos: Y o N. |
Información adicional sobre los campos before_flag y after_flag
Para los distintos tipos de operación, los campos before_flag y after_flag de un registro incremental se definen de la siguiente manera:
-
INSERT
Cuando el tipo de operación es INSERT, todos los valores de columna son los valores del registro recién insertado. Estos son los valores posteriores a la actualización. Por lo tanto, el valor de
before_flages N y el valor deafter_flages Y, como se muestra en el siguiente ejemplo.
-
UPDATE
Cuando el tipo de operación es UPDATE, DTS divide la operación UPDATE en dos registros incrementales. Estos dos registros tienen los mismos valores para
record_id,operation_flagyutc_timestamp.El primer registro contiene los valores anteriores a la actualización, por lo que el valor de
before_flages Y y el valor deafter_flages N. El segundo registro contiene los valores posteriores a la actualización, por lo que el valor debefore_flages N y el valor deafter_flages Y, como se muestra en el siguiente ejemplo.
-
DELETE
Cuando el tipo de operación es DELETE, todos los valores de columna del registro incremental son los valores eliminados. Esto significa que los valores de las columnas no cambian. Por lo tanto, el valor de
before_flages Y y el valor deafter_flages N, como se muestra en el siguiente ejemplo.
Ejemplo de combinación de datos completos
Después de la operación de sincronización de datos, DTS crea una tabla de línea base completa y una tabla de registros incrementales para cada tabla en MaxCompute. Puede utilizar comandos SQL de MaxCompute para combinar estas dos tablas y obtener los datos completos en un momento específico.
Este ejemplo utiliza la tabla customer (con la siguiente estructura) para describir el procedimiento.
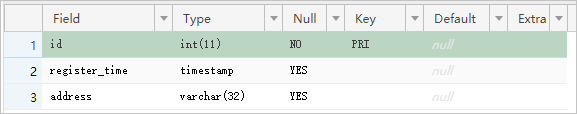
-
Según la estructura de la tabla que se va a sincronizar en la base de datos de origen, cree una tabla en MaxCompute para almacenar los resultados combinados.
Por ejemplo, para obtener los datos completos de la tabla
customeren la marca de tiempo1565944878, cree la siguiente tabla de datos para facilitar su identificación en el negocio:CREATE TABLE `customer_1565944878` ( `id` bigint NULL, `register_time` datetime NULL, `address` string);NotaPuede ejecutar comandos SQL en el editor de consultas ad hoc de MaxCompute.
Para obtener más información sobre los tipos de datos compatibles con MaxCompute, consulte Tipos de datos.
-
Ejecute el siguiente comando SQL en MaxCompute para combinar la tabla de línea base completa y la tabla de registros incrementales, y así obtener los datos completos de la tabla en un momento específico.
set odps.sql.allow.fullscan=true; insert overwrite table <result_storage_table> select <col1>, <col2>, <colN> from( select row_number() over(partition by t.<primary_key_column> order by record_id desc, after_flag desc) as row_number, record_id, operation_flag, after_flag, <col1>, <col2>, <colN> from( select incr.record_id, incr.operation_flag, incr.after_flag, incr.<col1>, incr.<col2>,incr.<colN> from <table_log> incr where utc_timestamp< <timestamp> union all select 0 as record_id, 'I' as operation_flag, 'Y' as after_flag, base.<col1>, base.<col2>,base.<colN> from <table_base> base) t) gt where row_number=1 and after_flag='Y'Nota<result_storage_table>: El nombre de la tabla que almacena el conjunto de resultados completo combinado.
<col1>/<col2>/<colN>: Los nombres de las columnas de la tabla sincronizada.
<primary_key_column>: El nombre de la columna de clave primaria de la tabla sincronizada.
<table_log>: El nombre de la tabla de registros incrementales.
<table_base>: El nombre de la tabla de línea base completa.
<timestamp>: El momento para el cual desea obtener los datos completos.
Para combinar las tablas de datos y obtener los datos completos de la tabla
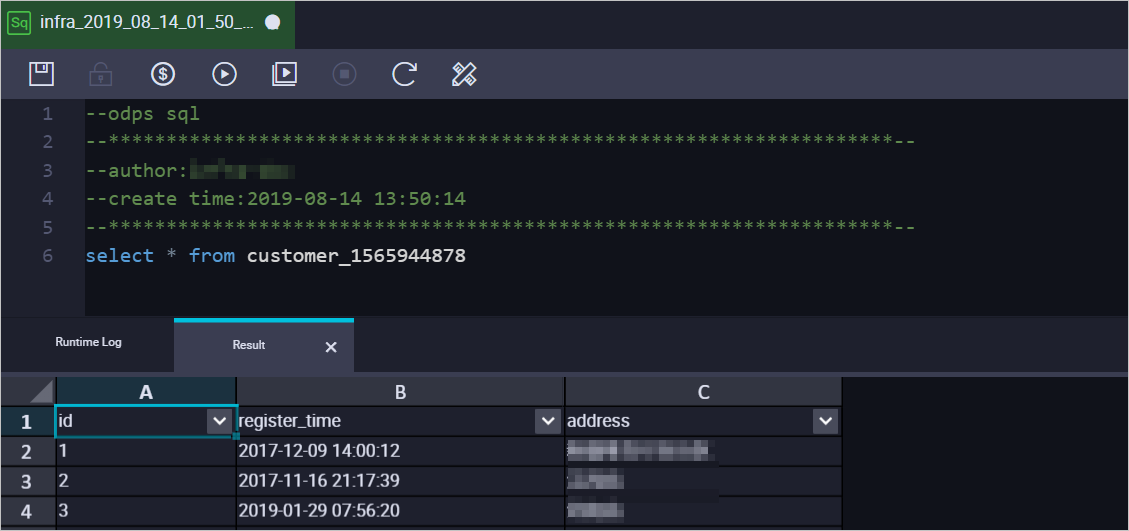
customeren la marca de tiempo1565944878, utilice el siguiente ejemplo:set odps.sql.allow.fullscan=true; insert overwrite table customer_1565944878 select id, register_time, address from( select row_number() over(partition by t.id order by record_id desc, after_flag desc) as row_number, record_id, operation_flag, after_flag, id, register_time, address from( select incr.record_id, incr.operation_flag, incr.after_flag, incr.id, incr.register_time, incr.address from customer_log incr where utc_timestamp< 1565944878 union all select 0 as record_id, 'I' as operation_flag, 'Y' as after_flag, base.id, base.register_time, base.address from customer_base base) t) gt where gt.row_number= 1 and gt.after_flag= 'Y'; -
Una vez ejecutado el comando anterior, puede consultar los datos combinados en la tabla
customer_1565944878.