Utilice Data Transmission Service (DTS) para sincronizar continuamente los datos desde una base de datos PostgreSQL autogestionada hacia una instancia de ApsaraDB RDS for PostgreSQL. DTS admite la sincronización de esquemas, la sincronización completa de datos y la sincronización incremental de datos, lo que permite realizar la migración con un tiempo de inactividad mínimo.
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
Una base de datos PostgreSQL autogestionada y una instancia de ApsaraDB RDS for PostgreSQL. Para crear una instancia de RDS, consulte Crear una instancia.
Una versión de la base de datos de destino igual o posterior a la versión de la base de datos de origen. Las versiones de destino anteriores pueden causar problemas de compatibilidad. Para consultar las combinaciones de versiones compatibles, véase Descripción general de los escenarios de sincronización de datos.
Espacio de almacenamiento libre suficiente en la instancia de RDS para alojar todos los datos de la base de datos PostgreSQL autogestionada.
Una cuenta de superusuario en la base de datos PostgreSQL autogestionada y una cuenta propietaria del esquema en la instancia de RDS. Consulte Permissions required for database accounts.
Facturación
|
Synchronization type |
Cost |
|
Sincronización de esquemas y sincronización completa de datos |
Gratuita |
|
Sincronización incremental de datos |
Con cargo. Consulte Descripción general de la facturación. |
Topologías de sincronización compatibles
Sincronización unidireccional uno a uno
Sincronización unidireccional uno a varios
Sincronización unidireccional en cascada
Sincronización unidireccional varios a uno
Para obtener más detalles, consulte Topologías de sincronización.
Objetos compatibles
|
Category |
Objects |
|
Esquema y tabla |
SCHEMA, TABLE (incluidos PRIMARY KEY, UNIQUE KEY, FOREIGN KEY, tipos de datos integrados y DEFAULT CONSTRAINT) |
|
Otros objetos de base de datos |
VIEW, PROCEDURE (PostgreSQL 11 o posterior), FUNCTION, RULE, SEQUENCE, EXTENSION, TRIGGER, AGGREGATE, INDEX, OPERATOR, DOMAIN |
Operaciones SQL que se pueden sincronizar
|
Type |
Statements |
|
DML |
INSERT, UPDATE, DELETE |
|
DDL |
Solo para tareas creadas después del 1 de octubre de 2020. Consulte Límites de sincronización de DDL. |
Permisos necesarios para las cuentas de base de datos
|
Database |
Required permissions |
Reference |
|
Base de datos PostgreSQL autogestionada |
superuser |
|
|
Instancia de RDS |
Permisos de propietario del esquema |
Límites
Límites de la base de datos de origen
-
Las tablas que se van a sincronizar deben tener restricciones PRIMARY KEY o UNIQUE, y todos los campos deben ser únicos. De lo contrario, la base de datos de destino podría contener registros duplicados.
Si crea una tarea de sincronización de datos sin seleccionar Schema Synchronization , asegúrese de que la tabla de destino tenga las mismas restricciones PRIMARY KEY o NOT NULL UNIQUE que la tabla de origen.
Si selecciona tablas como objetos de sincronización y necesita cambiar el nombre de tablas o columnas en la base de datos de destino, una sola tarea admite hasta 5,000 tablas. Para más de 5,000 tablas, configure varias tareas o sincronice toda la base de datos.
DTS no puede sincronizar tablas temporales, desencadenadores internos ni procedimientos y funciones internos escritos en C. DTS sí puede sincronizar parámetros personalizados de los tipos COMPOSITE, ENUM y RANGE. Las tablas deben tener restricciones PRIMARY KEY, FOREIGN KEY, UNIQUE o CHECK.
-
Requisitos de registros WAL:
Establezca
wal_levelenlogical.Para sincronización solo incremental: conserve los registros de escritura anticipada (WAL) durante más de 24 horas.
Para sincronización completa e incremental: conserve los registros WAL durante al menos 7 días. Una vez completada la sincronización completa, puede reducir el período de retención a más de 24 horas.
Si los registros WAL no se conservan durante el tiempo requerido, DTS podría no poder leerlos, lo que provocaría un error en la tarea o pérdida de datos.
Los valores de
max_wal_sendersymax_replication_slotsdeben ser mayores que la suma de: el número de slots de replicación utilizados actualmente en la base de datos de origen, más el número de instancias de DTS cuya fuente es esta base de datos.Si ocurre un cambio de rol principal/secundario en la base de datos de origen mientras se ejecuta una tarea de sincronización, la tarea fallará. Después del cambio, inicie sesión en la base de datos secundaria para eliminar el slot de replicación con el prefijo
dts_sync_.Si la base de datos de origen tiene transacciones de larga duración durante la sincronización incremental, los registros WAL generados antes de que esas transacciones se confirmen pueden acumularse y agotar el espacio en disco.
-
Si el origen es una instancia de Cloud SQL for PostgreSQL en Google Cloud Platform, debe establecer el parámetro Database Account en una cuenta de base de datos con el permiso
cloudsqlsuperuser. Al seleccionar los objetos que se van a sincronizar, debe seleccionar únicamente los objetos que la cuenta especificada tenga autorización para gestionar. De lo contrario, deberá otorgar el permiso OWNER sobre los objetos seleccionados a la cuenta especificada.Una cuenta
cloudsqlsuperuserno puede gestionar datos propiedad de otras cuentascloudsqlsuperuser. Si un solo cambio incremental de datos supera los 256 MB, la tarea de sincronización fallará y no se podrá recuperar. Vuelva a configurar la tarea.
Durante la sincronización de esquemas y la sincronización completa de datos, no ejecute sentencias DDL que modifiquen los esquemas de la base de datos o de las tablas. La tarea fallará.
Si la base de datos de origen experimenta una actualización de versión principal mientras se ejecuta una tarea, la tarea fallará y no se podrá recuperar. Vuelva a configurar la tarea.
Otros límites
Una sola tarea de sincronización de datos puede sincronizar información de una única base de datos. Para sincronizar desde varias bases de datos, cree una tarea independiente para cada una.
DTS no puede sincronizar tablas que tengan relaciones de herencia entre esquemas.
-
Si selecciona un esquema como objeto de sincronización: cuando cree una tabla en el esquema o cambie el nombre de una tabla con RENAME, ejecute la siguiente sentencia antes de escribir datos en la tabla:
ALTER TABLE schema.table REPLICA IDENTITY FULL;Reemplace
schemaytablepor los nombres reales. Ejecute esta sentencia fuera del horario pico y sin mantener un bloqueo de tabla para evitar interbloqueos. DTS no valida metadatos como las secuencias. Verifique manualmente la validez de las secuencias antes y después de la tarea.
Después de trasladar sus cargas de trabajo a la base de datos de destino, las secuencias recién escritas no continuarán desde el valor máximo del origen. Actualice el valor inicial de las secuencias en la base de datos de destino antes de realizar el corte.
-
DTS crea las siguientes tablas temporales en la base de datos de origen durante la sincronización. No las elimine mientras la tarea esté en ejecución. Se eliminan automáticamente cuando se libera la instancia de DTS:
public.dts_pg_classpublic.dts_pg_attributepublic.dts_pg_typepublic.dts_pg_enumpublic.dts_postgres_heartbeatpublic.dts_ddl_commandpublic.dts_args_session
DTS agrega una tabla de latidos llamada
dts_postgres_heartbeata la base de datos de origen para rastrear la latencia de sincronización.-
DTS crea un slot de replicación con el prefijo
dts_sync_en la base de datos de origen y lo utiliza para leer registros incrementales de los últimos 15 minutos. El slot se elimina automáticamente cuando la tarea se libera o falla. Si ocurre un cambio de rol principal/secundario, elimine manualmente el slot de la base de datos secundaria.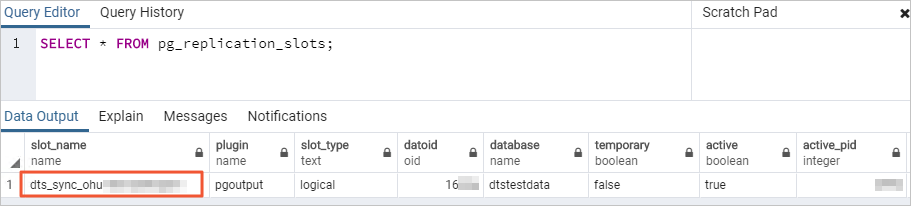
Evalúe el impacto en el rendimiento de ambas bases de datos antes de iniciar la sincronización y programe la tarea fuera del horario pico. Durante la sincronización completa inicial, DTS utiliza recursos de lectura y escritura en ambas bases de datos, lo que aumenta la carga del servidor.
Durante la sincronización completa inicial, las operaciones INSERT simultáneas causan fragmentación de tablas en la base de datos de destino. El espacio de tablas utilizado por la base de datos de destino será mayor que el de la base de datos de origen una vez completada la sincronización completa.
Si DTS es la única fuente que escribe en la base de datos de destino, puede utilizar Data Management Service (DMS) para ejecutar operaciones DDL en línea sobre las tablas de origen durante la sincronización. Consulte Cambiar esquemas sin bloquear tablas.
Si se escriben datos de otras fuentes en la base de datos de destino durante la sincronización, puede producirse inconsistencia en los datos. Ejecutar sentencias DDL en línea en DMS mientras otras fuentes escriben en el destino puede provocar pérdida de datos.
Si utiliza una cuenta privilegiada o de superusuario para la base de datos de destino, y las tablas que se sincronizan contienen claves externas, desencadenadores o desencadenadores de eventos, DTS establece temporalmente
session_replication_roleenreplicaa nivel de sesión. Si la cuenta de destino no tiene permisos suficientes, establezca manualmentesession_replication_roleenreplica. Las operaciones UPDATE o DELETE en cascada en el origen durante este período pueden causar inconsistencia en los datos. Después de liberar la tarea, restablezcasession_replication_roleaorigin.Si una tarea de DTS falla, el soporte técnico de DTS intentará restaurarla dentro de un plazo de 8 horas. Durante la restauración, la tarea podría reiniciarse y ciertos parámetros de la tarea podrían modificarse (los parámetros de la base de datos no se cambian). Para consultar los parámetros que podrían modificarse, véase Modificar parámetros de instancia.
Límites de sincronización de DDL
La sincronización de DDL solo está disponible para tareas creadas después del 1 de octubre de 2020.
Para tareas creadas antes del 12 de mayo de 2023: cree desencadenadores y funciones en la base de datos de origen antes de configurar la tarea. Consulte Use triggers and functions to implement incremental DDL migration for PostgreSQL databases.
Para utilizar una tarea de sincronización de datos creada antes del 12 de mayo de 2023 con el fin de sincronizar operaciones DDL, debe crear desencadenadores y funciones en la base de datos de origen para capturar la información DDL antes de configurar la tarea de sincronización de datos. Para obtener más información, consulte Use triggers and functions to implement incremental DDL migration for PostgreSQL.
Los datos de tipo BIT no se pueden sincronizar durante la sincronización incremental.
Para la sincronización de DDL, la cuenta de la base de datos de origen debe ser una cuenta privilegiada y la versión menor de la base de datos debe ser 20210228 o posterior. Sentencias DDL compatibles:
CREATE TABLEyDROP TABLEALTER TABLE: RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK, ALTER COLUMN DROP DEFAULTTRUNCATE TABLE(PostgreSQL 11 o posterior)CREATE INDEX ON TABLE
Sentencias DDL que no se pueden sincronizar:
Sentencias con modificadores CASCADE o RESTRICT
DDL de sesiones que han ejecutado
SET session_replication_role = replicaDDL ejecutado mediante la invocación de funciones
DDL mezclado con DML en la misma confirmación (commit)
DDL para objetos no seleccionados para sincronización
Preparar la base de datos de origen
Los ejemplos de esta sección utilizan una base de datos PostgreSQL autogestionada que se ejecuta en Linux.
DTS utiliza la replicación lógica de PostgreSQL para capturar cambios de la base de datos de origen. La replicación lógica requierewal_level = logicalpara que el registro de escritura anticipada incluya suficiente información para reconstruir los cambios a nivel de fila. Los parámetrosmax_wal_sendersymax_replication_slotscontrolan cuántas conexiones de replicación simultáneas y slots puede mantener la base de datos de origen.
Paso 1: Comprobar y configurar los ajustes de WAL
Inicie sesión en el servidor que aloja la base de datos PostgreSQL autogestionada.
-
Consulte el número de slots de replicación utilizados actualmente:
SELECT count(1) FROM pg_replication_slots; -
Abra
postgresql.confy configure los siguientes parámetros. Los valores demax_wal_sendersymax_replication_slotsdeben superar individualmente la suma de: el número actual de slots de replicación utilizados más el número de instancias de DTS que tienen como destino esta base de datos.# Replication settings wal_level = logical # Change requires restart max_wal_senders = 10 # Max number of walsender processes; change requires restart max_replication_slots = 10 # Max number of replication slots; change requires restartReinicie la base de datos después de guardar estos cambios.
Paso 2: Permitir el acceso al servidor de DTS
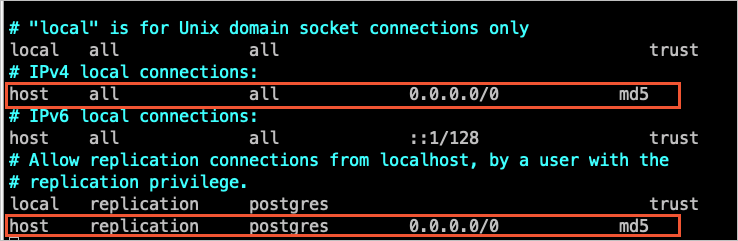
Agregue los bloques CIDR de los servidores de DTS a pg_hba.conf. Agregue únicamente los bloques CIDR correspondientes a los servidores de DTS en la misma región que la base de datos de destino. Consulte Add the CIDR blocks of DTS servers.
Después de actualizar pg_hba.conf, ejecute la siguiente sentencia o reinicie la base de datos para aplicar los cambios:
SELECT pg_reload_conf();Omita este paso sipg_hba.confya contiene0.0.0.0/0. Para consultar referencia sobre el formato del archivo, véase El archivo pg_hba.conf .
Paso 3: Crear la base de datos y el esquema de destino
En la instancia de RDS, cree una base de datos y un esquema que coincidan con los del origen. Los nombres de esquema en las bases de datos de origen y de destino deben ser idénticos. Consulte Create a database y Gestionar cuentas mediante esquemas.
Pasos adicionales para PostgreSQL 9.4.8 a 10.0
Si la versión de su base de datos de origen se encuentra en el rango de PostgreSQL 9.4.8 a 10.0, complete los siguientes pasos antes de configurar la tarea de sincronización.
1. Compilar e instalar PostgreSQL desde el código fuente
Inicie sesión en el servidor.
Descargue el código fuente de su versión de PostgreSQL desde el sitio web oficial de PostgreSQL.
-
Ejecute los siguientes comandos para configurar, compilar e instalar:
ImportanteLa versión del sistema operativo debe ser compatible con la versión de GNU Compiler Collection (GCC) utilizada. - Si
sudo ./configurefalla con un error comoreadline library not found, agregue la bandera--without-readline:sudo ./configure --without-readline. - Si instala PostgreSQL mediante otro método, compileali_decodingen un entorno de prueba con las mismas versiones de sistema operativo y GCC.
sudo ./configure
sudo make
sudo make install
2. Compilar e instalar la extensión ali_decoding
Descargue ali_decoding.
-
Copie el directorio
ali_decodingen el directoriocontribde la instalación compilada de PostgreSQL.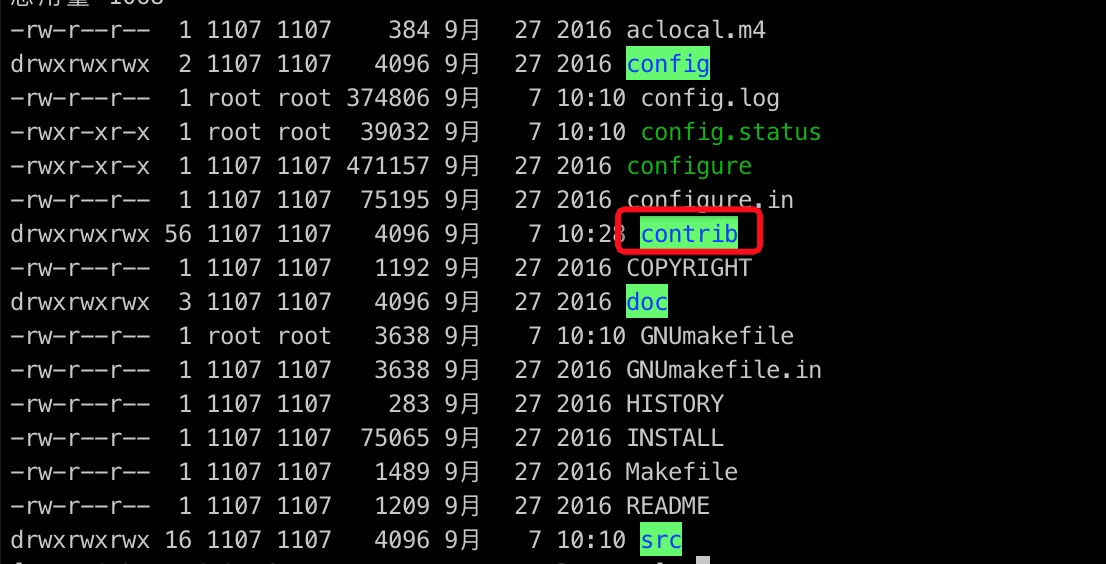
-
En el directorio
ali_decoding, reemplace el contenido delMakefilecon lo siguiente:# contrib/ali_decoding/Makefile MODULE_big = ali_decoding MODULES = ali_decoding OBJS = ali_decoding.o DATA = ali_decoding--0.0.1.sql ali_decoding--unpackaged--0.0.1.sql EXTENSION = ali_decoding NAME = ali_decoding ifdef USE_PGXS PG_CONFIG = pg_config PGXS := $(shell $(PG_CONFIG) --pgxs) include $(PGXS) else subdir = contrib/ali_decoding top_builddir = ../.. include $(top_builddir)/src/Makefile.global include $(top_srcdir)/contrib/contrib-global.mk endif -
En el directorio
ali_decoding, compile e instale la extensión:sudo make sudo make install -
Copie los archivos generados a los directorios que se muestran a continuación.

Cree la base de datos y el esquema de destino en la instancia de RDS, tal como se describe en Paso 3: Crear la base de datos y el esquema de destino.
Configurar la tarea de sincronización
Paso 1: Abrir la página Data Synchronization
Utilice la consola de DTS o la consola de DMS.
Consola de DTS:
Inicie sesión en la consola de DTS.
En el panel de navegación izquierdo, haga clic en Data Synchronization.
En la esquina superior izquierda, seleccione la región donde residirá la instancia de sincronización.
Consola de DMS:
El diseño puede variar según el modo de su consola de DMS. Consulte Simple mode y Customize the layout and style of the DMS console .
Inicie sesión en la consola de DMS.
En la barra de navegación superior, pase el puntero sobre Data + AI y elija DTS (DTS) > Data Synchronization.
En la lista desplegable junto a Data Synchronization Tasks, seleccione la región de destino.
Paso 2: Crear la tarea
Haga clic en Create Task para abrir la página de configuración de la tarea.
Si la página muestra un botón New Configuration Page en la esquina superior derecha, haga clic en él para cambiar a la nueva versión.
Si en su lugar se muestra Back to Previous Version , ya se encuentra en la nueva página de configuración. Se recomienda utilizar la nueva versión.
Paso 3: Configurar las bases de datos de origen y de destino
Después de configurar ambas bases de datos, lea los Limits que se muestran en la página. Omitir este paso puede provocar errores en la tarea o inconsistencia en los datos.
Sección | Parámetro | Descripción |
N/A | Task name | Nombre de la tarea de DTS. DTS genera uno automáticamente. Especifique un nombre descriptivo para facilitar su identificación. Los nombres no necesitan ser únicos. |
Source database | Database type | Seleccione PostgreSQL. |
Access method | Seleccione Cloud Enterprise Network (CEN). | |
Instance region | La región donde reside la base de datos PostgreSQL autogestionada. | |
CEN instance ID | El ID de la instancia de Cloud Enterprise Network (CEN) conectada a la base de datos de origen. | |
Connected VPC | La virtual private cloud (VPC) conectada a la base de datos de origen. | |
Domain name or IP | La dirección IP del servidor de la base de datos de origen. | |
Port number | El puerto de servicio de la base de datos de origen. Valor predeterminado: 3433. | |
Database name | El nombre de la base de datos de origen. | |
Database account | La cuenta de la base de datos de origen. Para consultar los permisos obligatorios, consulte Permissions required for database accounts. | |
Database password | La contraseña de la cuenta de la base de datos. | |
Encryption | Indica si se debe cifrar la conexión. Para este ejemplo, seleccione Non-encrypted. Para usar cifrado SSL: seleccione SSL-encrypted, cargue el CA certificate y, opcionalmente, cargue el Client certificate, la Private key of client certificate, y especifique la Private key password of client certificate. Para obtener información sobre la configuración de SSL en RDS, consulte SSL encryption. | |
Destination database | Database type | Seleccione PostgreSQL. |
Access method | Seleccione Alibaba Cloud Instance. | |
Instance region | La región donde reside la instancia de RDS. | |
Instance ID | El ID de la instancia de RDS. | |
Database name | El nombre de la base de datos de destino en la instancia de RDS. | |
Database account | La cuenta de la base de datos de destino. Para consultar los permisos obligatorios, consulte Permissions required for database accounts. | |
Database password | La contraseña de la cuenta de la base de datos. | |
Encryption | Indica si se debe cifrar la conexión. La configuración es la misma que la del cifrado de la base de datos de origen descrita anteriormente. |
Paso 4: Probar la conectividad
Haga clic en Test Connectivity and Proceed en la parte inferior de la página.
Debe agregar los bloques CIDR de los servidores de DTS a la configuración de seguridad de las bases de datos de origen y de destino. Consulte Add the CIDR blocks of DTS servers .
Si el método de acceso a la base de datos de origen no es Alibaba Cloud Instance , haga clic en Test Connectivity en el cuadro de diálogo CIDR Blocks of DTS Servers que aparece.
Paso 5: Configurar los objetos de sincronización
En el paso Configure Objects, establezca los siguientes parámetros.
Parámetro | Descripción |
Synchronization types | Incremental Data Synchronization está seleccionado de forma predeterminada. Seleccione también Schema Synchronization y Full Data Synchronization para realizar una migración completa con un tiempo de inactividad mínimo. Después de la verificación previa, DTS sincroniza primero los datos históricos y luego pasa a la sincronización incremental continua. Nota Al seleccionar Schema Synchronization, DTS sincroniza los esquemas de las tablas, incluidas las claves externas, desde el origen hasta el destino. |
Processing mode of conflicting tables | Precheck and report errors (predeterminado): verifica que no existan tablas con nombres idénticos en el destino antes de comenzar. Si se encuentran nombres coincidentes, la verificación previa falla y la tarea no puede iniciarse. Utilice el mapeo de nombres de objetos para renombrar las tablas de destino si no es posible eliminarlas o cambiarles el nombre. Ignore errors and proceed: omite la comprobación de nombres de tabla duplicados. Aviso Esto puede causar inconsistencia en los datos. Durante la sincronización completa, se conservan los registros existentes en el destino que tengan claves principales o únicas coincidentes. Durante la sincronización incremental, estos se sobrescriben. Si los esquemas difieren, la sincronización podría fallar o sincronizarse solo parcialmente algunas columnas. |
Synchronization topology | Seleccione One-way Synchronization. |
Capitalization of object names in destination instance | Controla el uso de mayúsculas y minúsculas en los nombres de bases de datos, tablas y columnas en el destino. El valor predeterminado es DTS default policy. Consulte Specify the capitalization of object names. |
Source objects | Seleccione los objetos de la lista Source Objects y haga clic en el icono |
Selected objects | Para renombrar un solo objeto: haga clic derecho sobre él y siga las instrucciones en Map the name of a single object. Para renombrar varios objetos: haga clic en Batch Edit en la esquina superior derecha. Consulte Map multiple object names at a time. Para filtrar operaciones SQL de un objeto específico: haga clic derecho sobre él y seleccione las operaciones SQL que desea sincronizar. Para filtrar filas por condición: haga clic derecho en una tabla y especifique las condiciones WHERE. Consulte Specify filter conditions. Nota Renombrar un objeto puede provocar que los objetos dependientes fallen durante la sincronización. |
 para agregarlos a Selected Objects. Puede seleccionar columnas, tablas o esquemas.
Paso 6: Configurar los ajustes avanzados
Haga clic en Next: Advanced Settings y configure los siguientes parámetros.
Parámetro | Descripción |
Dedicated cluster for task scheduling | De forma predeterminada, DTS programa la tarea en el clúster compartido. Para mejorar la estabilidad, adquiera un clúster dedicado. Consulte What is a DTS dedicated cluster. |
Retry time for failed connections | Tiempo durante el cual DTS reintenta la conexión tras un fallo. Valores válidos: de 10 a 1,440 minutos. Valor predeterminado: 720 minutos. Establezca un valor superior a 30 minutos. Si DTS logra reconectarse dentro de esta ventana, la tarea se reanudará; de lo contrario, fallará. Nota Si varias tareas comparten la misma base de datos de origen o de destino, prevalecerá el tiempo de reintento más corto entre ellas. Los cargos por la instancia de DTS continúan aplicándose durante los reintentos. |
Retry time for other issues | Tiempo durante el cual DTS reintenta la operación tras fallos en DDL o DML. Valores válidos: de 1 a 1,440 minutos. Valor predeterminado: 10 minutos. Establezca un valor superior a 10 minutos e inferior al tiempo de reintento para conexiones fallidas. |
Enable throttling for full data synchronization | Limita las consultas por segundo (QPS) a la base de datos de origen, las solicitudes por segundo (RPS) para la sincronización completa y la velocidad de sincronización de datos (MB/s) para reducir la carga en el destino. Solo se muestra cuando Full Data Synchronization está seleccionado. |
Enable throttling for incremental data synchronization | Limita las RPS y la velocidad de sincronización de datos (MB/s) para la sincronización incremental con el fin de reducir la carga en el destino. |
Environment tag | Etiqueta para identificar la instancia de DTS. Selecciónela según su entorno (por ejemplo, producción o desarrollo). |
Configure ETL | Indica si se debe habilitar la extracción, transformación y carga (ETL). Seleccione Yes para introducir sentencias de procesamiento de datos. Consulte Configure ETL in a data migration or data synchronization task. Seleccione No para omitir este paso. |
Monitoring and alerting | Seleccione Yes para recibir alertas cuando la tarea falle o la latencia de sincronización supere un umbral determinado. Configure el umbral de alerta y los ajustes de notificación. Consulte Configure monitoring and alerting. |
Paso 7: Configurar la verificación de datos
Haga clic en Next Step: Data Verification para configurar la verificación. Consulte Configure a data verification task.
Paso 8: Ejecutar la verificación previa
Haga clic en Next: Save Task Settings and Precheck.
Para previsualizar los parámetros de la API correspondientes a esta configuración, pase el puntero sobre Next: Save Task Settings and Precheck y haga clic en Preview OpenAPI parameters .
DTS ejecuta una verificación previa antes de que la tarea pueda iniciarse. La tarea solo comienza después de superar dicha verificación.
Si la verificación previa falla, haga clic en View Details junto a cada elemento fallido, resuelva los problemas y haga clic en Precheck Again .
Para los elementos de alerta que pueden ignorarse de forma segura: haga clic en Confirm Alert Details , luego en Ignore y confirme. A continuación, haga clic en Precheck Again . Ignorar alertas puede provocar inconsistencia en los datos.
Paso 9: Adquirir la instancia de sincronización
Espere hasta que el Success Rate alcance el 100% y luego haga clic en Next: Purchase Instance.
En la página Buy, configure los siguientes parámetros.
Sección | Parámetro | Descripción |
New instance class | Billing method | Subscription: pago por adelantado; más rentable para uso a largo plazo. Pay-as-you-go: facturación por hora; adecuado para uso a corto plazo. Libere la instancia cuando ya no la necesite para evitar cargos innecesarios. |
Instance class | DTS ofrece clases de instancia con distintas velocidades de sincronización. Seleccione la adecuada según el volumen de datos y sus requisitos de throughput. Consulte Instance classes of data synchronization instances. | |
Subscription duration | Disponible cuando se selecciona Subscription. Opciones: de 1 a 9 meses, 1 año, 2 años, 3 años o 5 años. | |
Resource group settings | Resource group | El resource group para la instancia. Valor predeterminado: default resource group. Consulte What is Resource Management? |
Seleccione Data Transmission Service (Pay-as-you-go) Service Terms y luego haga clic en Buy and Start. En el cuadro de diálogo, haga clic en OK.
Una vez adquirida la instancia, la tarea se inicia automáticamente. Supervise su progreso en la lista de tareas.
Verificar y realizar el corte
Verificar la consistencia de los datos
Una vez que la tarea alcance la fase de sincronización incremental, compruebe que los datos en las bases de datos de origen y de destino sean consistentes antes de cambiar sus cargas de trabajo.
Para realizar una comprobación exhaustiva, utilice la función de verificación de datos de DTS. Consulte Configure a data verification task.
Cambiar las cargas de trabajo a la base de datos de destino
Antes de cambiar las cargas de trabajo, confirme que la latencia de sincronización sea igual o cercana a 0. Puede monitorear la latencia desde la lista de tareas en la consola de DTS.
Antes del corte:
Detenga las escrituras en la base de datos de origen para permitir que se sincronicen los cambios restantes.
Espere a que la latencia de sincronización llegue a 0.
Actualice el valor inicial de las secuencias en la base de datos de destino. Las secuencias recién escritas no continuarán desde el valor máximo del origen después del corte.
Después del corte, si session_replication_role se estableció en replica durante la sincronización, restablézcalo a origin.