Puede utilizar Data Transmission Service (DTS) para sincronizar datos desde una instancia de PolarDB-X 2.0 hacia un proyecto de MaxCompute.
Requisitos previos
Debe haber activado MaxCompute y creado un proyecto en este servicio. Para obtener más información, consulte Activate MaxCompute y Create a project.
Debe haber configurado la lista de permitidos de MaxCompute para autorizar el acceso de DTS. Para obtener más información, consulte Configure the MaxCompute whitelist to allow access from Alibaba Cloud services.
-
Debe haber utilizado su cuenta de Alibaba Cloud (cuenta raíz) para Create an AccessKey.
NotaComo alternativa, puede Create a RAM user y después Set a RAM user as the super administrator for a MaxCompute project.
Límites
DTS no sincroniza las claves foráneas de la base de datos de origen a la de destino. Por lo tanto, las operaciones en cascada y de eliminación realizadas en la base de datos de origen no se replican en la base de datos de destino.
|
Tipo |
Descripción |
|
Límites de la base de datos de origen |
|
|
Otros límites |
|
|
Precauciones |
DTS actualiza periódicamente la tabla |
Facturación
|
Tipo de sincronización |
Precios |
|
Sincronización de esquemas y sincronización completa de datos |
Sin costo. |
|
Sincronización incremental de datos |
Con costo. Para obtener más información, consulte Billing overview. |
Operaciones SQL compatibles
Tipo | Sentencia SQL |
DML | INSERT, UPDATE y DELETE |
DDL | ALTER TABLE, ADD COLUMN Nota Solo se admiten operaciones simples de adición de columnas, como
|
Procedimiento
-
Vaya a la página de lista de tareas de sincronización de la región de destino. Puede utilizar uno de los dos métodos siguientes:
Desde la consola de DTS
Inicie sesión en la consola de Data Transmission Service (DTS).
En el panel de navegación izquierdo, haga clic en Data Synchronization.
En la esquina superior izquierda de la página, seleccione la región donde se encuentra la instancia de sincronización.
Desde la consola de DMS
NotaLas operaciones reales pueden variar según el modo y el diseño de la consola de DMS. Para obtener más información, consulte Simple mode y Customize the layout and style of the DMS interface.
Inicie sesión en Data Management (DMS).
En la barra de menú superior, elija .
A la derecha de Data Synchronization Tasks, seleccione la región donde se encuentra la instancia de sincronización.
Haga clic en Create Task para abrir la página de configuración de tareas.
-
Configure las bases de datos de origen y de destino.
Categoría
Parámetro
Descripción
N/A
Task Name
DTS genera automáticamente un nombre de tarea. Se recomienda especificar un nombre descriptivo para facilitar su identificación. El nombre no tiene que ser único.
Source Database
Select Existing Connection
-
Para usar una instancia de base de datos que esté added to the system (recién creada o guardada), seleccione la instancia de la lista desplegable. La información de la base de datos se configura automáticamente.
NotaEn la consola de DMS, este elemento de configuración se denomina Select a DMS database instance..
-
Si no ha agregado la instancia de base de datos al sistema, o si no necesita usar una instancia ya agregada, configure manualmente la siguiente información de la base de datos.
Database Type
Seleccione PolarDB-X 2.0.
Connection Type
Seleccione Alibaba Cloud Instance.
Instance Region
Seleccione la región donde se encuentra la instancia de PolarDB-X 2.0.
Replicate Data Across Alibaba Cloud Accounts
Este ejemplo muestra la sincronización de datos dentro de la misma cuenta de Alibaba Cloud. Seleccione No.
Instance ID
Seleccione el ID de la instancia de origen de PolarDB-X 2.0.
Database Account
Introduzca la cuenta de la base de datos de la instancia de PolarDB-X 2.0. La cuenta debe tener los permisos REPLICATION SLAVE, REPLICATION CLIENT y SELECT sobre los objetos que se van a sincronizar.
NotaPara obtener información sobre cómo otorgar permisos, consulte Account permission issues during data synchronization.
Database Password
Introduzca la contraseña correspondiente a la cuenta de la base de datos.
Destination Database
Select Existing Connection
-
Para usar una instancia de base de datos que esté added to the system (recién creada o guardada), seleccione la instancia de la lista desplegable. La información de la base de datos se configura automáticamente.
NotaEn la consola de DMS, este elemento de configuración se denomina Select a DMS database instance..
-
Si no ha agregado la instancia de base de datos al sistema, o si no necesita usar una instancia ya agregada, configure manualmente la siguiente información de la base de datos.
Database Type
Seleccione MaxCompute.
Connection Type
Seleccione Alibaba Cloud Instance.
Instance Region
Seleccione la región donde se encuentra la instancia de MaxCompute de destino.
Project
Introduzca el nombre del proyecto de MaxCompute de destino.
AccessKey ID of Alibaba Cloud Account
Introduzca el par de AccessKey que preparó en la sección Prerequisites.
AccessKey Secret of Alibaba Cloud Account
-
-
Una vez completada la configuración, haga clic en Test Connectivity and Proceed en la parte inferior de la página.
NotaAsegúrese de que los bloques CIDR de direcciones IP de los servidores de DTS estén agregados a la configuración de seguridad de las bases de datos de origen y de destino para permitir el acceso desde dichos servidores. Esto puede hacerse de forma automática o manual. Para obtener más información, consulte Add the IP address CIDR blocks of DTS servers to a whitelist.
Si la base de datos de origen o de destino es una base de datos autogestionada (donde el Access Method no es Alibaba Cloud Instance), también debe hacer clic en Test Connectivity en el cuadro de diálogo CIDR Blocks of DTS Servers.
Haga clic en OK para autorizar la cuenta de MaxCompute.
-
Configure los objetos de la tarea.
-
En la página Configure Objects, configure los objetos que desea sincronizar.
Parámetro
Descripción
Synchronization Types
Los tipos de sincronización. De forma predeterminada, Incremental Data Synchronization está seleccionado. También debe seleccionar Schema Synchronization y Full Data Synchronization. Una vez completada la verificación previa, DTS sincroniza los datos históricos de los objetos seleccionados desde la base de datos de origen hacia el clúster de destino. Los datos históricos constituyen la base para la posterior sincronización incremental.
Processing Mode for Existing Tables in Destination
-
Precheck and Report Errors: Comprueba si existe una tabla con el mismo nombre en la base de datos de destino. Si no existe ninguna tabla con el mismo nombre, la verificación previa se aprueba. Si existe una tabla con el mismo nombre, la verificación previa falla y la tarea de sincronización de datos no se inicia.
NotaSi no puede eliminar ni cambiar el nombre de la tabla con el mismo nombre en la base de datos de destino, puede asignarle un nombre de tabla diferente. Para obtener más información, consulte Map table and column names.
-
Ignore Errors and Proceed: Omite la comprobación de nombres de tabla duplicados en la base de datos de destino.
AvisoSeleccionar Ignore Errors and Proceed puede causar inconsistencia en los datos y poner en riesgo su negocio. Por ejemplo:
-
Si los esquemas de las tablas son iguales y un registro en la base de datos de destino tiene el mismo valor de clave principal o clave única que un registro en la base de datos de origen:
-
Durante la sincronización completa, DTS conserva el registro en el clúster de destino. El registro correspondiente de la base de datos de origen no se sincroniza.
-
Durante la sincronización incremental, el registro de la base de datos de origen sobrescribe el registro en la base de datos de destino.
-
-
Si los esquemas de las tablas son diferentes, la sincronización inicial de datos puede fallar. Esto puede provocar que solo se sincronicen parcialmente los datos de las columnas o que la sincronización falle por completo. Proceda con precaución.
-
Naming Rules of Additional Columns
DTS agrega columnas adicionales a las tablas de destino durante la sincronización. Si estos nombres de columna entran en conflicto con las columnas existentes, la sincronización falla. Seleccione New Rule o Previous Rule según sus requisitos empresariales.
AvisoCompruebe si los nombres de las columnas adicionales entran en conflicto con los nombres de columna existentes en las tablas de destino antes de seleccionar una regla. De lo contrario, pueden producirse pérdidas de datos o fallos en la tarea. Para obtener más información sobre las reglas y definiciones de columnas adicionales, consulte Additional column names and definitions.
Partition Definition of Incremental Data Table
Seleccione los nombres de partición según sus requisitos empresariales. Para obtener más información sobre las particiones, consulte PartitionPartition.
Case Sensitivity Policy for Destination Object Names
Puede configurar la directiva de distinción entre mayúsculas y minúsculas para los nombres de objetos de base de datos, tabla y columna que se sincronizan con la instancia de destino. De forma predeterminada, se selecciona la DTS default policy. También puede optar por utilizar las directivas predeterminadas de las bases de datos de origen y de destino. Para obtener más información, consulte Case sensitivity policy for destination object names.
Source Objects
En el cuadro Source Objects, haga clic en un objeto para sincronizarlo y, a continuación, haga clic en
 para moverlo al cuadro Selected Objects.Nota
Solo puede seleccionar objetos para sincronizar a nivel de tabla.
Selected Objects
-
Para cambiar el nombre de un solo objeto de sincronización en la instancia de destino, haga clic con el botón derecho en el objeto dentro del cuadro Selected Objects. Para obtener más información sobre cómo cambiar el nombre de los objetos, consulte Map a single database, table, or column.
-
Para cambiar los nombres de varios objetos de sincronización en la instancia de destino por lotes, haga clic en Batch Edit en la esquina superior derecha del cuadro Selected Objects. Para obtener más información, consulte Map databases, tables, and columns in a batch.
NotaPara seleccionar las operaciones SQL que se sincronizarán a nivel de base de datos o de tabla, haga clic con el botón derecho en el objeto dentro del cuadro Selected Objects y, a continuación, seleccione las operaciones SQL deseadas en el cuadro de diálogo que aparece.
Para establecer una cláusula WHERE que filtre los datos, haga clic con el botón derecho en la tabla que desea sincronizar dentro del cuadro Selected Objects y, a continuación, establezca la condición de filtro en el cuadro de diálogo que aparece. Para obtener más información, consulte Filter task data by using SQL conditions.
-
-
Haga clic en Next: Advanced Settings para configurar los parámetros avanzados.
Parámetro
Descripción
Dedicated Cluster for Task Scheduling
De forma predeterminada, DTS programa las tareas en un clúster compartido, por lo que no es necesario seleccionar uno. Para obtener un rendimiento más estable, puede adquirir un clúster dedicado para ejecutar tareas de sincronización de DTS. Para obtener más información, consulte What is a DTS dedicated cluster?.
Retry Time for Failed Connections
Después de que se inicia una tarea de sincronización, si falla la conexión a la base de datos de origen o de destino, DTS reporta un error y comienza inmediatamente a reintentar la conexión. La duración predeterminada de reintento es de 720 minutos. También puede especificar una duración personalizada de entre 10 y 1,440 minutos. Se recomienda establecer la duración en 30 minutos o más. Si DTS logra reconectarse a la base de datos dentro de la duración especificada, la tarea de sincronización se reanuda automáticamente. De lo contrario, la tarea falla.
Nota-
Si tiene varias instancias de DTS (por ejemplo, Instancia A e Instancia B) que comparten el mismo origen o destino, y establece el tiempo de reintento de red en 30 minutos para la Instancia A y en 60 minutos para la Instancia B, se utilizará la duración más corta de 30 minutos para ambas.
-
Dado que DTS cobra por el tiempo de ejecución de la tarea durante el período de reintento de conexión, se recomienda personalizar la duración del reintento según sus necesidades empresariales o liberar la instancia de DTS lo antes posible después de que se liberen las instancias de base de datos de origen y de destino.
Retry Time for Other Issues
Después de que se inicia la tarea de sincronización, si ocurren otros problemas no relacionados con la conectividad en la base de datos de origen o de destino (como excepciones en la ejecución de DDL o DML), DTS reporta un error e inicia inmediatamente operaciones de reintento continuas. La duración predeterminada de reintento es de 10 minutos. También puede personalizar la duración del reintento dentro de un rango de 1 a 1,440 minutos. Se recomienda establecerla en 10 minutos o más. Si las operaciones correspondientes se realizan correctamente dentro de la duración de reintento establecida, la tarea de sincronización se reanuda automáticamente. De lo contrario, la tarea falla.
ImportanteEl valor de Retry Time for Other Issues debe ser menor que el de Retry Time for Failed Connections.
Enable Throttling for Full Data Synchronization
Durante la fase de sincronización completa, DTS consume recursos de lectura y escritura de las bases de datos de origen y de destino, lo que puede aumentar la carga de la base de datos. Para reducir la carga en las bases de datos de origen y de destino, puede establecer un límite de velocidad para la tarea de sincronización completa mediante la configuración de los parámetros Queries per second (QPS) to the source database, RPS of Full Data Migration y Data migration speed for full migration (MB/s).
Nota-
Este elemento de configuración solo está disponible cuando Synchronization Types está establecido en Full Data Synchronization.
-
También puede adjust the full synchronization rate después de que la instancia de sincronización se esté ejecutando.
Enable Throttling for Incremental Data Synchronization
También puede establecer un límite de velocidad para la tarea de sincronización incremental. Para aliviar la presión sobre la base de datos de destino, configure RPS of Incremental Data Synchronization y Data synchronization speed for incremental synchronization (MB/s).
Whether to delete SQL operations on heartbeat tables of forward and reverse tasks
Elija si desea escribir información SQL de latido en la base de datos de origen mientras se ejecuta la instancia de DTS.
-
Yes: No se escribe información SQL de latido en la base de datos de origen. Esto puede provocar que la instancia de DTS reporte un retraso.
-
No: Escribe información SQL de latido en la base de datos de origen. Esto puede interferir con funciones como la copia de seguridad física y la clonación de la base de datos de origen.
Environment Tag
Seleccione una etiqueta de entorno para identificar la instancia. Este parámetro es opcional para este ejemplo.
Configure ETL
Elija si desea habilitar la función de extracción, transformación y carga (ETL). Para obtener más información, consulte What is ETL? Valores válidos:
-
Yes: Habilita la función ETL. Introduzca las instrucciones de procesamiento de datos en el editor de código. Para obtener más información, consulte Configure ETL in a data migration or data synchronization task.
-
No: Deshabilita la función ETL.
Monitoring and Alerting
Especifique si desea configurar alertas. Si la sincronización falla o la latencia supera el umbral especificado, se envía una notificación a un contacto de alerta.
-
No: No se configuran alertas.
-
Yes: Configure las alertas estableciendo un umbral de alerta y especificando un notificación de alerta. Para obtener más información, consulte Configure monitoring and alerting during task configuration.
-
-
-
Guarde la tarea y ejecute una verificación previa.
Para ver los parámetros de la API para configurar esta instancia, pase el cursor sobre el botón Next: Save Task Settings and Precheck y haga clic en Preview OpenAPI parameters en la burbuja emergente.
Si ha terminado de ver los parámetros de la API, haga clic en Next: Save Task Settings and Precheck en la parte inferior de la página.
NotaAntes de que comience el trabajo de sincronización, DTS ejecuta una verificación previa. El trabajo solo puede iniciarse después de que todos los elementos de la verificación previa se aprueben.
Si la verificación previa falla, haga clic en View Details para el elemento fallido. Solucione el problema según las indicaciones y, a continuación, vuelva a ejecutar la verificación previa.
-
Si la verificación previa devuelve una advertencia:
Si un elemento de comprobación falla y no puede ignorarse, haga clic en View Details junto al elemento. Siga las instrucciones para solucionar el problema y, a continuación, vuelva a ejecutar la verificación previa.
Para los elementos de comprobación que pueden ignorarse, puede hacer clic en Confirm Alert Details, Ignore, OK y Precheck Again en secuencia para omitir la advertencia y volver a ejecutar la verificación previa. Si decide ignorar el elemento de advertencia, esto podría causar problemas como inconsistencia de datos y poner en riesgo su negocio.
-
Adquiera la instancia.
Cuando la Success Rate sea del 100 %, haga clic en Next: Purchase Instance.
-
En la página Purchase, seleccione el método de facturación y la especificación de enlace para la instancia de sincronización de datos. La siguiente tabla describe estos parámetros en detalle.
Categoría
Parámetro
Descripción
New Instance Class
Método de facturación
-
Subscription: Paga al crear la instancia. Es adecuado para necesidades a largo plazo y resulta más rentable que pay-as-you-go. Cuanto mayor sea la duración de la suscripción, mayor será el descuento.
-
Pay-as-you-go: Se le cobra por hora. Es adecuado para necesidades a corto plazo. Puede liberar la instancia inmediatamente después de usarla para ahorrar costos.
Configuración de resource group
El resource group al que pertenece la instancia. El valor predeterminado es default resource group. Para obtener más información, consulte What is Resource Management?.
Especificación de enlace
DTS proporciona especificaciones de sincronización con diferentes niveles de rendimiento. La especificación del enlace de sincronización afecta la tasa de sincronización. Puede elegir una especificación según su escenario empresarial. Para obtener más información, consulte Data synchronization link specifications.
Duración de la suscripción
En el modo de suscripción, seleccione la duración y la cantidad para la instancia de suscripción. Puede elegir una suscripción mensual de 1 a 9 meses, o una suscripción anual de 1, 2, 3 o 5 años.
NotaEsta opción solo está disponible cuando el método de facturación es Subscription.
-
Una vez completada la configuración, lea y seleccione Data Transmission Service (Pay-as-you-go) Service Terms.
-
Haga clic en Buy and Start. En el cuadro de diálogo OK, haga clic en OK.
Puede consultar el progreso de la tarea en la página Data Synchronization.
Esquema de tabla de registros incrementales
Ejecute set odps.sql.allow.fullscan=true; en MaxCompute para permitir escaneos completos de tablas.
DTS almacena datos incrementales con metadatos adicionales al sincronizar desde MySQL hacia una tabla de registros incrementales en MaxCompute.
En este ejemplo, modifytime_year, modifytime_month, modifytime_day, modifytime_hour y modifytime_minute son claves de partición, que se especifican en el paso Configure Task Object.
Definición del esquema
Campo | Descripción |
record_id | El ID de registro único para cada entrada de registro incremental. Nota
|
operation_flag | El tipo de operación. Los valores válidos son:
|
utc_timestamp | La marca de tiempo de la operación proveniente del binlog, en formato UTC. |
before_flag | Especifica si los valores de las columnas representan el estado previo a la actualización. Valores válidos: Y o N. |
after_flag | Especifica si los valores de las columnas representan el estado posterior a la actualización. Valores válidos: Y o N. |
Información adicional sobre los campos before_flag y after_flag
Los campos before_flag y after_flag en un registro incremental se definen de la siguiente manera según el tipo de operación:
-
INSERT
Cuando el tipo de operación es INSERT, todos los valores de las columnas corresponden al registro recién insertado. Estos son los valores posteriores a la actualización. Por lo tanto, el valor de
before_flages N y el valor deafter_flages Y, como se muestra en el siguiente ejemplo.
-
UPDATE
Cuando el tipo de operación es UPDATE, DTS divide la operación UPDATE en dos registros incrementales. Ambos registros comparten los mismos valores para
record_id,operation_flagyutc_timestamp.El primer registro contiene los valores anteriores a la actualización, por lo que el valor de
before_flages Y y el valor deafter_flages N. El segundo registro contiene los valores posteriores a la actualización, así que el valor debefore_flages N y el valor deafter_flages Y, como se muestra en el siguiente ejemplo.
-
DELETE
Cuando el tipo de operación es DELETE, todos los valores de las columnas en el registro incremental corresponden a los valores eliminados. Esto significa que los valores de las columnas no cambian. En consecuencia, el valor de
before_flages Y y el valor deafter_flages N, como se muestra en el siguiente ejemplo.
Ejemplo de fusión de datos completos
Después de la operación de sincronización de datos, DTS crea una tabla base completa y una tabla de registros incrementales para cada tabla en MaxCompute. Puede utilizar comandos SQL de MaxCompute para fusionar estas dos tablas y obtener los datos completos en un momento específico.
Este ejemplo utiliza la tabla customer (con la siguiente estructura) para describir el procedimiento.
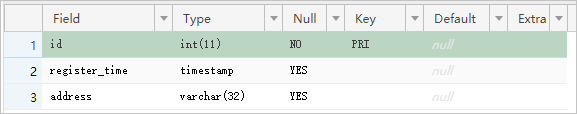
-
Según la estructura de la tabla que se va a sincronizar en la base de datos de origen, cree una tabla en MaxCompute para almacenar los resultados fusionados.
Por ejemplo, para obtener los datos completos de la tabla
customeren la marca de tiempo1565944878, cree la siguiente tabla de datos para facilitar su identificación empresarial:CREATE TABLE `customer_1565944878` ( `id` bigint NULL, `register_time` datetime NULL, `address` string);NotaPuede ejecutar comandos SQL en el editor de consultas ad-hoc de MaxCompute.
Para obtener más información sobre los tipos de datos compatibles con MaxCompute, consulte Tipos de datos.
-
Ejecute el siguiente comando SQL en MaxCompute para fusionar la tabla base completa y la tabla de registros incrementales, y así obtener los datos completos de la tabla en un momento específico.
set odps.sql.allow.fullscan=true; insert overwrite table <result_storage_table> select <col1>, <col2>, <colN> from( select row_number() over(partition by t.<primary_key_column> order by record_id desc, after_flag desc) as row_number, record_id, operation_flag, after_flag, <col1>, <col2>, <colN> from( select incr.record_id, incr.operation_flag, incr.after_flag, incr.<col1>, incr.<col2>,incr.<colN> from <table_log> incr where utc_timestamp< <timestamp> union all select 0 as record_id, 'I' as operation_flag, 'Y' as after_flag, base.<col1>, base.<col2>,base.<colN> from <table_base> base) t) gt where row_number=1 and after_flag='Y'Nota<result_storage_table>: El nombre de la tabla que almacena el conjunto de resultados completos fusionados.
<col1>/<col2>/<colN>: Los nombres de las columnas en la tabla sincronizada.
<primary_key_column>: El nombre de la columna de clave principal en la tabla sincronizada.
<table_log>: El nombre de la tabla de registros incrementales.
<table_base>: El nombre de la tabla base completa.
<timestamp>: El momento específico para el cual desea obtener los datos completos.
Para fusionar las tablas de datos y obtener los datos completos de la tabla
customeren la marca de tiempo1565944878, utilice el siguiente ejemplo:set odps.sql.allow.fullscan=true; insert overwrite table customer_1565944878 select id, register_time, address from( select row_number() over(partition by t.id order by record_id desc, after_flag desc) as row_number, record_id, operation_flag, after_flag, id, register_time, address from( select incr.record_id, incr.operation_flag, incr.after_flag, incr.id, incr.register_time, incr.address from customer_log incr where utc_timestamp< 1565944878 union all select 0 as record_id, 'I' as operation_flag, 'Y' as after_flag, base.id, base.register_time, base.address from customer_base base) t) gt where gt.row_number= 1 and gt.after_flag= 'Y'; -
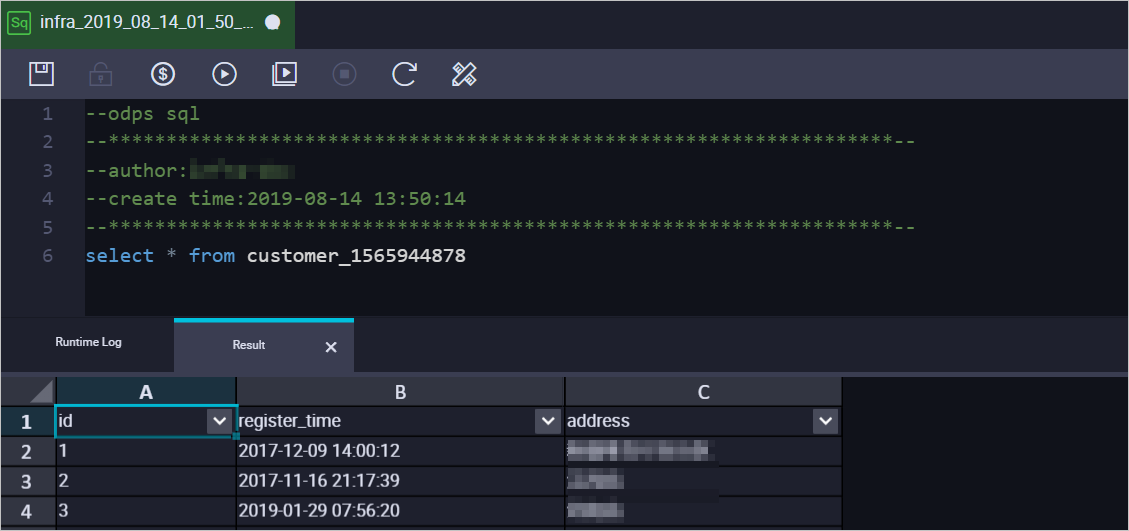
Una vez ejecutado el comando anterior, puede consultar los datos fusionados en la tabla
customer_1565944878.