AnalyticDB for MySQL es un servicio de procesamiento analítico en línea (OLAP) de alta concurrencia y tiempo real desarrollado por Alibaba Cloud. Este servicio ejecuta análisis y exploración multidimensional de petabytes de datos con una latencia de milisegundos. Puede usar Data Transmission Service (DTS) para sincronizar datos desde un clúster de PolarDB for MySQL hacia un clúster de AnalyticDB for MySQL. Esto le permite construir rápidamente sistemas internos de inteligencia empresarial (BI), plataformas de consultas interactivas y aplicaciones de informes en tiempo real.
Requisitos previos
Se creó un clúster de destino de AnalyticDB for MySQL. Para obtener más información, consulte Create a cluster.
Compruebe que el clúster de destino de AnalyticDB for MySQL cuente con espacio de almacenamiento suficiente.
El registro binario está habilitado en el clúster de origen de PolarDB for MySQL. Para obtener más información, consulte Habilitar el registro binario.
Limitaciones
Durante la inicialización completa de datos, DTS consume recursos de lectura y escritura de las bases de datos de origen y de destino, lo cual puede aumentar la carga de la base de datos. Cuando las bases de datos tienen un rendimiento bajo, especificaciones reducidas o cargas de trabajo pesadas (por ejemplo, una gran cantidad de sentencias SQL lentas, tablas sin claves primarias o bloqueos mutuos en la base de datos de destino), la presión sobre la base de datos puede incrementarse aún más y los servicios podrían dejar de estar disponibles. Por lo tanto, debe evaluar el rendimiento de las bases de datos de origen y de destino antes de iniciar la sincronización de datos. Se recomienda ejecutar la sincronización durante las horas de menor actividad (por ejemplo, cuando la carga de CPU de ambas bases de datos sea inferior al 30 %).
-
No utilice herramientas como gh-ost o pt-online-schema-change para ejecutar operaciones DDL en línea sobre los objetos que se van a sincronizar en la base de datos de origen durante la sincronización de datos. De lo contrario, la tarea de sincronización fallará.
Debido a una limitación de uso de AnalyticDB for MySQL, si el uso de disco de cualquier nodo del clúster supera el 80 %, el clúster se bloquea. Antes de comenzar, calcule el espacio de almacenamiento necesario para los objetos que se van a sincronizar y compruebe que el clúster de destino tenga capacidad suficiente.
Los índices de prefijo no se pueden sincronizar. Si la base de datos de origen contiene índices de prefijo, la sincronización de datos podría fallar.
Si el clúster de destino de AnalyticDB for MySQL 3.0 está creando una copia de seguridad mientras se ejecuta la tarea de DTS, la tarea falla.
Facturación
|
Tipo de sincronización |
Precio |
|
Sincronización de esquemas y sincronización completa de datos |
Sin costo. |
|
Sincronización incremental de datos |
Con costo. Para obtener más información, consulte Billing overview. |
Operaciones SQL compatibles
Operaciones DDL: CREATE TABLE, DROP TABLE, RENAME TABLE, TRUNCATE TABLE, ADD COLUMN, DROP COLUMN y MODIFY COLUMN
Operaciones DML: INSERT, UPDATE y DELETE
Si el tipo de dato de un campo en la tabla de origen cambia durante la sincronización de datos, la tarea reporta un error y se detiene. Este problema se puede corregir manualmente. Para obtener más información, consulte Fix a synchronization failure caused by a data type change.
Permisos de cuentas de base de datos
Base de datos | Permisos obligatorios |
PolarDB for MySQL | Permisos de lectura sobre los objetos que se van a sincronizar. |
AnalyticDB for MySQL | Permisos de lectura y escritura. |
Para obtener más información sobre cómo crear y autorizar una cuenta de base de datos, consulte Crear una cuenta de base de datos de PolarDB for MySQL o Crear una cuenta de base de datos para el almacén de datos nativo de la nube AnalyticDB for MySQL.
Asignaciones de tipos de datos
Para obtener más información, consulte Data type mappings for initial schema synchronization.
Procedimiento
-
Purchase a data synchronization task.
NotaAl adquirir la tarea, establezca Source Instance en Apsara PolarDB, Target Instance en AnalyticDB MySQL y Synchronization Topology en One-way synchronization.
-
Inicie sesión en la consola de Data Transmission Service.
NotaSi el sistema lo redirige automáticamente a la consola de Data Management (DMS), haga clic en el icono
 en la esquina inferior derecha y luego haga clic en
 para volver a la consola clásica de DTS.
En el panel de navegación izquierdo, haga clic en Data Synchronization.
-
En la barra de navegación superior de la página Data Synchronization, seleccione la región donde se encuentra la instancia de destino.
Busque la instancia de sincronización de datos adquirida y haga clic en Configure Synchronization Channel.
-
Configure las instancias de origen y de destino para el canal de sincronización.
Sección
Parámetro
Descripción
N/A
Synchronization task name
DTS genera automáticamente un nombre de tarea. Para facilitar su identificación, se recomienda usar un nombre descriptivo. El nombre no necesita ser único.
Source instance details
Instance type
Establezca este valor en PolarDB Instance. Este parámetro no se puede modificar.
Instance region
La región de la instancia de origen que seleccionó al adquirir la tarea. Este parámetro no se puede modificar.
PolarDB instance ID
Seleccione el identificador del clúster de origen de PolarDB for MySQL.
Database account
Introduzca la cuenta de la base de datos del clúster de PolarDB for MySQL. Para conocer los permisos obligatorios, consulte Database account permissions.
Database password
Introduzca la contraseña de la cuenta de la base de datos.
Destination instance details
Instance type
Establezca este valor en ADS. Este parámetro no se puede modificar.
Instance region
La región de la instancia de destino que seleccionó al adquirir la tarea. Este parámetro no se puede modificar.
Version
Seleccione 3.0.
Database
Seleccione el identificador de clúster de la instancia de destino de AnalyticDB for MySQL.
Database account
Introduzca la cuenta de la base de datos de la instancia de AnalyticDB for MySQL. Para conocer los permisos obligatorios, consulte Database account permissions.
Database password
Introduzca la contraseña de la cuenta de la base de datos.
-
En la esquina inferior derecha de la página, haga clic en Set Whitelist and Next.
Si la base de datos de origen o de destino es una instancia de base de datos de Alibaba Cloud, como una instancia de ApsaraDB RDS for MySQL o de ApsaraDB for MongoDB, DTS agrega automáticamente los bloques CIDR de los servidores de DTS a la lista blanca de direcciones IP de la instancia. Si la base de datos de origen o de destino es una base de datos autogestionada alojada en una instancia de Elastic Compute Service (ECS), DTS agrega automáticamente los bloques CIDR de los servidores de DTS a las reglas del security group de la instancia de ECS; en este caso, debe comprobar que la instancia de ECS pueda acceder a la base de datos. Si la base de datos autogestionada está alojada en varias instancias de ECS, debe agregar manualmente los bloques CIDR de los servidores de DTS a las reglas del security group de cada instancia de ECS. Si la base de datos de origen o de destino es una base de datos autogestionada implementada en un centro de datos o proporcionada por un proveedor de servicios en la nube externo, debe agregar manualmente los bloques CIDR de los servidores de DTS a la lista blanca de direcciones IP de la base de datos para permitir que DTS acceda a ella. Para obtener más información, consulte Whitelist DTS server IP addresses.
AvisoAgregar los bloques CIDR de direcciones IP públicas de los servidores de DTS, ya sea de forma automática o manual, puede implicar riesgos de seguridad. Al usar este producto, usted reconoce y acepta estos riesgos potenciales. Debe implementar protecciones de seguridad básicas, entre las que se incluyen, sin limitarse a ellas, reforzar la seguridad de las contraseñas, restringir los puertos abiertos para los bloques CIDR, utilizar autenticación en la comunicación interna mediante API, y revisar y limitar periódicamente los bloques CIDR innecesarios. Como alternativa, puede conectarse a la base de datos a través de una red interna, como una línea dedicada, VPN Gateway o Smart Access Gateway.
-
Configure la política y los objetos de sincronización.
Parámetro
Descripción
Synchronization initialization
De manera predeterminada, las opciones Initial schema synchronization y Initial full data synchronization están seleccionadas. Una vez completada la verificación previa, DTS inicializa el esquema y los datos de los objetos sincronizados en el clúster de destino. Este proceso establece una línea base para la posterior sincronización incremental de datos.
Action on existing tables in destination
Precheck and report error: comprueba si existe una tabla con el mismo nombre en la base de datos de destino. Si no existe, la comprobación se aprueba. Si existe una tabla con el mismo nombre, se reporta un error durante la fase de verificación previa y la tarea de sincronización de datos no se inicia.
NotaSi no puede eliminar ni cambiar el nombre de la tabla en conflicto en la base de datos de destino, puede asignarle un nombre nuevo en el destino. Para obtener más información, consulte Set object names in the destination instance.
Ignore Errors and Proceed: omite la comprobación de tablas con el mismo nombre en la base de datos de destino.
AvisoSeleccionar Ignore Errors and Proceed puede provocar inconsistencias en los datos y riesgos para el negocio. Por ejemplo:
Si un registro del clúster de destino tiene la misma clave primaria que un registro de origen, se conserva el registro de destino y el registro de origen no se sincroniza.
Si los esquemas de las tablas son diferentes, es posible que los datos no se inicialicen, que solo se sincronicen algunas columnas o que la tarea falle.
Merge multiple tables
Seleccione Yes: DTS agrega la columna
__dts_data_sourcea cada tabla para almacenar el origen de los datos y deja de admitir la sincronización DDL.No: opción predeterminada. La sincronización DDL es compatible.
NotaLa función de combinación de tablas se aplica a nivel de tarea, no de tabla. Si necesita combinar algunas tablas pero no otras, cree dos tareas de sincronización de datos independientes.
Synchronization operation types
Seleccione los tipos de operación que desea sincronizar. Para obtener más información sobre las operaciones compatibles, consulte Supported SQL operations. De manera predeterminada, todos los tipos de operación están seleccionados.
Select synchronization objects
En el cuadro Available objects, haga clic en los objetos que desea sincronizar y luego haga clic en el icono
 para moverlos al cuadro Selected objects.
Puede seleccionar bases de datos y tablas como objetos de sincronización.
NotaSi selecciona una base de datos completa, todas las operaciones de cambio de esquema de los objetos dentro de esa base de datos se sincronizan con el destino.
Si selecciona una tabla específica, solo las operaciones
ADD COLUMNde esa tabla se sincronizan con el destino.De manera predeterminada, los nombres de los objetos de sincronización permanecen iguales. Si necesita cambiar los nombres de los objetos en el clúster de destino, utilice la función de asignación de nombres de objetos. Para obtener más información, consulte Set object names in the destination instance.
Rename object mappings
Cambie los nombres de los objetos sincronizados en la instancia de destino. Para obtener más información, consulte Map databases, tables, and columns.
Replicate temporary tables during online DDL process in DMS
Si utiliza Data Management (DMS) para aplicar cambios DDL en línea en la base de datos de origen, puede elegir si desea sincronizar las tablas temporales generadas por dichos cambios.
-
Yes: sincroniza las tablas temporales generadas por los cambios DDL en línea.
NotaSi los cambios DDL en línea generan una gran cantidad de datos en tablas temporales, la tarea de sincronización de datos podría retrasarse.
-
No: no sincroniza las tablas temporales generadas por los cambios DDL en línea. Solo se sincronizan las operaciones DDL originales de la base de datos de origen.
NotaEsta opción provoca que las tablas de la base de datos de destino se bloqueen.
Connection retry timeout
Si DTS no logra conectarse a la instancia de origen o de destino, reintenta la conexión durante 720 minutos (12 horas) de manera predeterminada. También puede especificar una duración de reintento personalizada. Si DTS vuelve a conectarse a la instancia de origen o de destino dentro del tiempo indicado, la tarea de sincronización se reanuda automáticamente. De lo contrario, la tarea falla.
NotaSe le cobra por el tiempo de ejecución de la tarea durante los reintentos de conexión. Personalice la duración de reintento según sus necesidades comerciales o libere la instancia de DTS tan pronto como se liberen las instancias de origen y de destino.
Una vez completadas las configuraciones anteriores, haga clic en Next en la esquina inferior derecha de la página.
-
Establezca los tipos de las tablas que se van a sincronizar en la base de datos de destino.
La tabla de configuración también incluye las columnas ADB Table Group, ADB Table Name, Number of Partitions y Definition Status. Cuando coloca el cursor sobre el nombre de una base de datos o de una tabla, DTS muestra el nombre de la tabla de origen.
NotaSi selecciona Initial Schema Synchronization, debe definir las tablas que se van a sincronizar en AnalyticDB for MySQL, incluidos Type, la columna de clave primaria y la columna de partición. Para obtener más información, consulte CREATE TABLE.
-
Una vez completadas las configuraciones anteriores, haga clic en Precheck and Start en la esquina inferior derecha de la página.
NotaAntes de que la tarea de sincronización se inicie formalmente, se ejecuta una verificación previa. La tarea de sincronización solo puede iniciarse después de aprobar esta verificación.
-
Si la verificación previa falla, haga clic en el icono
 junto a un elemento de comprobación específico para consultar los detalles del fallo.
Siga las indicaciones para corregir el problema y vuelva a ejecutar la verificación previa.
Si no necesita corregir los elementos de comprobación con advertencias, también puede seleccionar Ignore y Ignore Warning Items and Rerun Precheck para omitir dichos elementos y volver a ejecutar la verificación previa.
Cuando aparezca Precheck Passed en el cuadro de diálogo Precheck, cierre el cuadro de diálogo. La tarea de sincronización se inicia automáticamente.
-
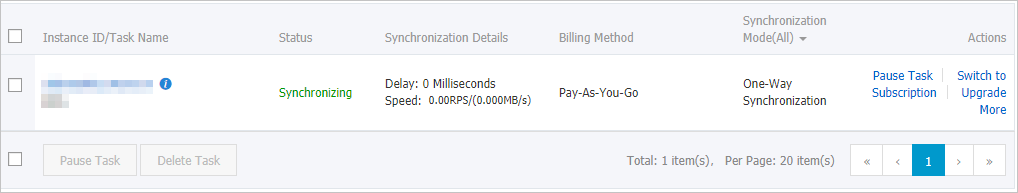
Espere hasta que el canal de sincronización se inicialice y la tarea pase al estado Synchronizing.
La página
Data Synchronization
muestra el estado de los trabajos de sincronización de datos.