Utilice Data Transmission Service (DTS) para mantener sincronizados dos clústeres de PolarDB for PostgreSQL (Compatible with Oracle) en ambas direcciones.
La sincronización bidireccional se ejecuta como un par de tareas: una tarea directa (del clúster A al clúster B) y una tarea inversa (del clúster B al clúster A). DTS evita los bucles de datos porque crea un esquema dts en cada clúster de destino para rastrear el origen de cada escritura.
La sincronización bidireccional no garantiza la ausencia de conflictos. Cuando el mismo registro se actualiza en ambos clústeres de forma simultánea, DTS aplica la política de resolución de conflictos que usted configure. Para minimizar los conflictos, restrinja las escrituras de registros con la misma clave primaria o clave única a un solo clúster a la vez.
Facturación
|
Tipo de sincronización |
Precio |
|
Sincronización de esquemas y sincronización completa de datos |
Gratuita |
|
Sincronización incremental de datos |
De pago. Consulte Billing overview. |
Requisitos previos
Antes de empezar, compruebe lo siguiente:
Ambos clústeres de PolarDB for PostgreSQL (Compatible with Oracle) ya están creados. Consulte Create a PolarDB for PostgreSQL (Compatible with Oracle) cluster.
El parámetro
wal_levelestá establecido enlogicalen ambos clústeres. Esto agrega la información necesaria para la replicación lógica al registro por adelantado (WAL). Consulte Set cluster parameters.El clúster de destino cuenta con más espacio de almacenamiento del que utiliza actualmente el clúster de origen.
Límites
Límites de la base de datos de origen
Ancho de banda: El servidor que aloja el clúster de origen debe tener suficiente ancho de banda de salida. Un ancho de banda insuficiente reduce la velocidad de sincronización.
Tablas sin clave primaria ni clave única: Habilite la función Exactly-Once write al configurar la tarea. De lo contrario, pueden aparecer registros duplicados en el destino. Consulte Synchronize tables without a primary key or UNIQUE constraint.
Selecciones de objetos grandes con asignación de nombres: Si necesita asignar nombres de tablas o columnas y la tarea incluye más de 1,000 tablas, divida las tablas en varias tareas o sincronice toda la base de datos. Enviar una sola tarea que asigne más de 1,000 tablas puede generar un error de solicitud.
-
Retención de registros WAL: Si los registros WAL se purgan antes de que DTS los lea, la tarea termina con errores. En casos extremos, puede producirse pérdida o inconsistencia de datos. Los problemas causados por una retención de WAL insuficiente no están cubiertos por el SLA (Acuerdo de Nivel de Servicio).
Solo sincronización incremental: conserve los registros WAL durante más de 24 horas.
Sincronización completa e incremental: conserve los registros WAL durante como mínimo 7 días. Una vez finalizada la sincronización completa, puede reducir el periodo de retención a más de 24 horas.
Transacciones de larga duración: El WAL generado antes de que se confirme una transacción de larga duración se acumula durante la sincronización incremental. Esto puede agotar el espacio en disco del clúster de origen.
Operaciones DDL durante la sincronización: No ejecute operaciones DDL que modifiquen la estructura de la base de datos o de las tablas durante la sincronización de esquemas o la sincronización completa de datos. La tarea terminará con errores.
Escrituras durante la sincronización exclusiva de datos completos: No escriba datos nuevos en el clúster de origen si solo seleccionó la sincronización completa de datos. Para mantener la consistencia en tiempo real, seleccione también la sincronización de esquemas y la sincronización incremental de datos.
-
Logical Replication Slot Failover: Para evitar que la replicación lógica se interrumpa durante un cambio entre nodo primario y secundario, el clúster de origen debe admitir Logical Replication Slot Failover y tenerlo habilitado.
Si el clúster no es compatible con Logical Replication Slot Failover (por ejemplo, si Database Engine es Oracle syntax compatible 2.0 ), un cambio de alta disponibilidad (HA) puede provocar que la instancia de sincronización termine con errores y no se pueda recuperar.
Límite de tamaño de un cambio individual: Si un solo cambio de datos incrementales supera los 256 MB, la instancia de sincronización puede terminar con errores y no se podrá recuperar. En ese caso, deberá volver a configurar la instancia de sincronización.
Límites de la sincronización bidireccional
Esquema de prevención de bucles: DTS crea un esquema llamado
dtsen cada clúster de destino para evitar bucles de datos. No modifique este esquema mientras la tarea esté en ejecución.Campos de tipo SERIAL: Si una tabla tiene un campo de tipo SERIAL, el clúster de origen crea automáticamente una secuencia para ese campo. Si selecciona Schema Synchronization en Synchronization Types, seleccione también Sequence o sincronice todo el esquema. De lo contrario, la instancia de sincronización puede terminar con errores.
Alcance de los datos de la tarea: En un par de sincronización bidireccional, solo una tarea puede sincronizar datos completos e incrementales. La otra tarea admite únicamente la sincronización incremental.
Dirección del flujo de datos: Los datos del origen de una tarea se sincronizan únicamente con el destino de esa misma tarea. No se tratan como datos de origen para la otra tarea.
Una sola base de datos por tarea: Cada tarea de sincronización procesa una base de datos. Configure tareas independientes para las bases de datos adicionales.
Objetos no compatibles: DTS no admite tablas de la extensión TimescaleDB, tablas con herencia entre esquemas ni tablas con índices únicos basados en expresiones.
Esquemas creados por plugins: Los esquemas generados al instalar plugins no se pueden sincronizar.
-
`REPLICA IDENTITY FULL` requirement: Ejecute
ALTER TABLE schema.table REPLICA IDENTITY FULL;en las tablas del clúster de origen antes de escribir datos en ellas en los siguientes escenarios:Cuando la instancia de sincronización se ejecuta por primera vez.
Cuando selecciona Schema como granularidad para la selección de objetos y se crea una tabla nueva o se reconstruye una existente mediante el comando
RENAME.Cuando utiliza la función para modificar objetos de sincronización.
Reemplace
schemaytablecon el nombre real del esquema y de la tabla. Ejecute este comando fuera del horario de mayor actividad. No bloquee las tablas durante la ejecución, ya que esto puede causar interbloqueos. Si omite los elementos de comprobación previa relacionados, DTS ejecutará este comando automáticamente durante la inicialización de la instancia. Tablas temporales: DTS crea las siguientes tablas temporales en el clúster de origen para capturar sentencias DDL, estructuras de tablas e información de latidos. No las elimine durante la sincronización, ya que la tarea terminará con errores. DTS las elimina automáticamente cuando se libera la instancia:
public.dts_pg_class,public.dts_pg_attribute,public.dts_pg_type,public.dts_pg_enum,public.dts_postgres_heartbeat,public.dts_ddl_command,public.dts_args_sessionypublic.aliyun_dts_instance.Tabla de latidos: DTS agrega una tabla de latidos llamada
dts_postgres_heartbeatal clúster de origen para mantener precisas las mediciones de latencia incremental.-
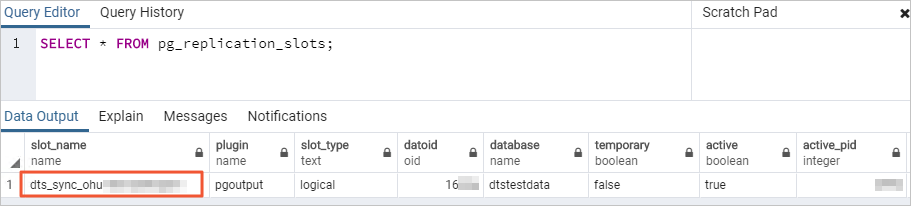
Espacio de replicación: DTS crea un espacio de replicación con el prefijo
dts_sync_en el clúster de origen. Este espacio permite que DTS acceda a los registros incrementales de los últimos 15 minutos. Cuando la tarea de sincronización termina con errores o se libera la instancia, DTS intenta limpiar el espacio automáticamente.Si cambia la contraseña de la cuenta de la base de datos de origen o quita la dirección IP de DTS de la lista blanca del clúster de origen durante la sincronización, el espacio no se podrá limpiar de forma automática. Límpielo manualmente para evitar que el WAL acumulado llene el disco y deje el clúster de origen no disponible. Si ocurre una conmutación por error, inicie sesión en el clúster secundario para limpiar el espacio manualmente.
Momento de la sincronización: Sincronice los datos fuera del horario de mayor actividad, cuando la carga de CPU de ambos clústeres sea inferior al 30 %. La sincronización completa de datos ejecuta operaciones INSERT concurrentes, lo que aumenta la carga en ambos clústeres y provoca fragmentación de tablas en el destino. Después de completar la sincronización completa, el espacio de las tablas de destino puede ser mayor que el de origen.
Comprobaciones de restricciones durante la sincronización: Durante la sincronización de esquemas, DTS sincroniza las claves externas del origen al destino. En la sincronización completa e incremental, DTS deshabilita temporalmente las comprobaciones de restricciones y las operaciones en cascada de claves externas a nivel de sesión. Si se producen actualizaciones o eliminaciones en cascada en el origen mientras la tarea se ejecuta, puede haber inconsistencia de datos.
Precisión de FLOAT y DOUBLE: DTS lee los valores FLOAT y DOUBLE mediante
ROUND(COLUMN, PRECISION). Si la precisión no se define explícitamente, DTS usa 38 para FLOAT y 308 para DOUBLE de forma predeterminada. Confirme que estos valores predeterminados cumplen sus requisitos.Recuperación de tareas y protección contra escrituras: DTS intenta recuperar automáticamente las tareas con errores durante un máximo de 7 días. Antes de cambiar su carga de trabajo al clúster de destino, finalice o libere la tarea, o bien utilice
REVOKEpara revocar los permisos de escritura de la cuenta de base de datos de DTS en el destino. Esto evita que los datos de origen sobrescriban los de destino si la tarea se recupera.Claves externas, disparadores y disparadores de eventos: DTS establece
session_replication_roleenreplicaa nivel de sesión si la cuenta de destino es una cuenta con privilegios o tiene permisos de superusuario. Si la cuenta no cuenta con estos permisos, establezcasession_replication_roleenreplicamanualmente en el destino. Durante este periodo, las actualizaciones o eliminaciones en cascada en el origen pueden causar inconsistencia de datos. Una vez liberada la tarea, cambiesession_replication_rolede nuevo aorigin.Recuperación por parte del soporte de DTS: Si una tarea termina con errores, el personal de soporte de DTS intentará restaurarla en un plazo de 8 horas. Para ello, puede reiniciar la tarea o ajustar sus parámetros (no los de la base de datos). Los parámetros que se pueden ajustar se enumeran en Modify instance parameters.
Tablas particionadas: Incluya tanto la tabla principal como todas las particiones secundarias como objetos de sincronización. La tabla principal de una tabla particionada no almacena datos directamente, ya que todos se encuentran en las particiones secundarias. Omitir la tabla principal o alguna partición secundaria puede provocar inconsistencia de datos.
Detección de conflictos compatible
DTS detecta los siguientes tipos de conflictos durante la sincronización bidireccional. Debido a las diferencias horarias y a la latencia, no se garantiza la prevención de conflictos. Para mantener la consistencia, actualice los registros con la misma clave primaria o clave única en un solo clúster a la vez.
|
Tipo de conflicto |
Condición de activación |
Comportamiento de DTS |
|
Conflicto de inserción |
Se insertan registros con la misma clave primaria en ambos clústeres de forma simultánea |
Aplica la política de resolución de conflictos configurada |
|
Actualización: registro ausente |
El registro que se va a actualizar no existe en el destino |
Convierte UPDATE en INSERT y luego aplica la política de resolución de conflictos si hay un conflicto de claves |
|
Actualización: conflicto de claves |
El valor actualizado genera un conflicto de clave primaria o única en el destino |
Aplica la política de resolución de conflictos configurada |
|
Eliminación: registro ausente |
El registro que se va a eliminar no existe en el destino |
Omite DELETE, independientemente de la política de resolución de conflictos |
Políticas de resolución de conflictos:
|
Política |
Comportamiento |
|
TaskFailed |
La tarea se detiene y entra en estado de error. Se requiere intervención manual para reanudarla. |
|
Ignore |
DTS omite la sentencia conflictiva y conserva el registro existente en el destino. |
|
Overwrite |
DTS sobrescribe el registro conflictivo del destino con los datos de origen. |
Si la tarea se pausa o se reinicia y existe un retraso, las políticas de resolución de conflictos no surten efecto. En ese caso, DTS sobrescribe los datos de destino de forma predeterminada.
Objetos compatibles
SCHEMA, TABLE (incluye PRIMARY KEY, UNIQUE KEY, FOREIGN KEY, tipos de datos integrados y DEFAULT CONSTRAINT)
VIEW y PROCEDURE (PostgreSQL 11 y versiones posteriores): la compatibilidad varía según el tipo de base de datos de destino. Consulte la consola para ver qué opciones están disponibles.
Operaciones SQL compatibles
|
Tipo de operación |
Sentencias compatibles |
|
DML (Data Manipulation Language) |
INSERT, UPDATE, DELETE |
|
DDL (Data Definition Language) |
CREATE TABLE, DROP TABLE; ALTER TABLE (RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK, ALTER COLUMN DROP DEFAULT); CREATE INDEX ON TABLE |
Restricciones de sincronización DDL: Las sentencias DDL no se sincronizan en los siguientes casos:
La sentencia DDL incluye cláusulas adicionales como CASCADE o RESTRICT.
Una transacción contiene sentencias DML y DDL al mismo tiempo.
Solo una parte de las sentencias DDL de una transacción se incluye en la tarea de sincronización.
La sentencia DDL se ejecuta desde una sesión creada con
SET session_replication_role = replica.La sentencia DDL se ejecuta mediante la llamada a una FUNCTION o un método similar.
La sentencia DDL no especifica un esquema (en este caso, se asume el esquema
publica través deSHOW search_path).La sentencia DDL contiene
IF NOT EXISTS.
Solo las tareas directas admiten la sincronización DDL. Las tareas inversas filtran automáticamente todas las operaciones DDL.
Permisos de cuentas de base de datos
|
Base de datos |
Permisos obligatorios |
Cómo crear y autorizar |
|
Clúster de PolarDB for PostgreSQL (Compatible with Oracle) de origen |
Una cuenta con privilegios que sea propietaria de la base de datos |
|
|
Clúster de PolarDB for PostgreSQL (Compatible with Oracle) de destino |
Una cuenta con privilegios que sea propietaria de la base de datos |
Igual que el anterior |
Configuración de la sincronización bidireccional
La sincronización bidireccional se configura en dos etapas: primero la tarea directa (del origen al destino) y después la tarea inversa (del destino al origen). La tarea inversa estará disponible cuando la tarea directa alcance el estado Running.
Paso 1: Abrir la lista de tareas de sincronización
Acceda a la lista de tareas de sincronización de una de estas dos maneras.
Consola de DTS
Inicie sesión en la consola de DTS.
En el panel de navegación izquierdo, haga clic en Data Synchronization.
En la esquina superior izquierda, seleccione la región donde se encuentra la instancia de sincronización.
Consola de DMS
Los pasos pueden variar según el modo y el diseño de la consola de DMS. Consulte Simple mode console y Customize the layout and style of the DMS console .
Inicie sesión en la consola de DMS.
En la barra de menú superior, elija Data + AI > DTS (DTS) > Data Synchronization.
A la derecha de Data Synchronization Tasks, seleccione la región de la instancia de sincronización.
Paso 2: Crear la tarea directa
Haga clic en Create Task.
-
Configure las bases de datos de origen y de destino.
Categoría Parámetro Descripción — Task Name DTS genera un nombre automáticamente. Especifique un nombre descriptivo para identificarlo con mayor facilidad. No es obligatorio que el nombre sea único. Source Database Select Existing Connection Seleccione una registered database instance de la lista para rellenar automáticamente los campos siguientes. En la consola de DMS, este parámetro es Select a DMS database instance. Si no ha registrado la instancia, complete los campos manualmente. Database Type Seleccione PolarDB (Compatible with Oracle). Access Method Seleccione Alibaba Cloud Instance. Instance Region Seleccione la región donde reside el clúster de origen. Replicate Data Across Alibaba Cloud Accounts Seleccione No para la sincronización dentro de la misma cuenta. Instance ID Seleccione el ID del clúster de origen. Database Name Introduzca el nombre de la base de datos de origen. Database Account Introduzca la cuenta de la base de datos. Consulte Database account permissions. Database Password Introduzca la contraseña de la cuenta. Destination Database Select Existing Connection Igual que en el origen: seleccione una instancia registrada o complete los campos manualmente. En la consola de DMS, este parámetro es Select a DMS database instance. Database Type Seleccione PolarDB (Compatible with Oracle). Connection Type Seleccione Alibaba Cloud Instance. Instance Region Seleccione la región donde reside el clúster de destino. Instance ID Seleccione el ID del clúster de destino. Database Name Introduzca el nombre de la base de datos de destino. Database Account Introduzca la cuenta de la base de datos. Consulte Database account permissions. Database Password Introduzca la contraseña de la cuenta. -
Haga clic en Test Connectivity and Proceed.
Agregue los bloques CIDR del servidor de DTS a la configuración de seguridad de ambos clústeres para permitir el acceso de DTS. Consulte Add the IP address whitelist of DTS servers . Si el origen o el destino utiliza un método de acceso autogestionado (distinto de Alibaba Cloud Instance ), haga clic también en Test Connectivity en el cuadro de diálogo CIDR Blocks of DTS Servers .
-
En la página Configure Objects, establezca los siguientes parámetros.
Parámetro Descripción Synchronization Types Seleccione Schema Synchronization, Full Data Synchronization y Incremental Data Synchronization. DTS sincroniza primero los datos históricos y luego cambia a la sincronización incremental. Processing mode of conflicting tables Precheck and Report Errors: comprueba si existen tablas con el mismo nombre en el destino. La tarea no se inicia si encuentra alguna. Para continuar, cambie el nombre de la tabla conflictiva en el destino o utilice la asignación de nombres de objetos. Consulte Database Table Column Name Mapping. Ignore Errors and Proceed: omite la comprobación. Durante la sincronización completa, DTS conserva el registro de destino y omite el de origen cuando hay conflicto de claves. En la sincronización incremental, DTS sobrescribe el registro de destino. Si los esquemas de las tablas difieren, la inicialización puede fallar. Utilice esta opción con precaución. Synchronization Topology Seleccione Two-way Synchronization. Exclude DDL Operations Seleccione Yes para omitir la sincronización DDL en la tarea directa. Seleccione No para incluirla. Las tareas inversas siempre filtran las operaciones DDL, sin importar esta configuración. Conflict Resolution Policy Seleccione cómo manejará DTS los conflictos. Consulte Supported conflict detection para obtener detalles sobre cada política. Capitalization of Object Names in Destination Instance Configure la política de mayúsculas y minúsculas para los nombres de bases de datos, tablas y columnas. El valor predeterminado es DTS default policy. Consulte Case policy for destination object names. Source Objects Haga clic en los objetos del cuadro Source Objects y luego en el ícono de flecha para moverlos a Selected Objects. Seleccione a nivel de esquema o de tabla. Al seleccionar tablas no se incluyen vistas, disparadores ni procedimientos almacenados. Si las tablas contienen tipos de datos SERIAL y se seleccionó Schema Synchronization, seleccione también Sequence o elija la sincronización de todo el esquema. Selected Objects Para cambiar el nombre de un solo objeto en el destino, haga clic derecho sobre él y siga Map a single object name. Para cambiar varios nombres de forma masiva, haga clic en Batch Edit y siga Map multiple object names in bulk. Para seleccionar operaciones SQL específicas o establecer un filtro WHERE para una tabla, haga clic derecho en la tabla. Consulte Set a filter condition. La asignación de nombres de objetos puede impedir que los objetos dependientes se sincronicen correctamente. -
Haga clic en Next: Advanced Settings y configure lo siguiente.
Parámetro Descripción Dedicated Cluster for Task Scheduling DTS utiliza un clúster compartido de forma predeterminada. Para mayor estabilidad, adquiera un clúster dedicado. Consulte What is a DTS dedicated cluster?. Retry Time for Failed Connections Durante la cual DTS reintenta tras un error de conexión. Valor predeterminado: 720 minutos. Rango: de 10 a 1,440 minutos. Recomendación: 30 minutos o más. Si la conexión se restablece dentro de la ventana de reintentos, la tarea se reanuda automáticamente. NotaCuando varias instancias de DTS comparten un origen o un destino, DTS utiliza la duración de reintento más corta configurada entre todas las instancias. DTS cobra por el tiempo de ejecución durante los reintentos.
Retry Time for Other Issues Durante la cual DTS reintenta tras errores distintos a los de conexión (como fallos al ejecutar DDL o DML). Valor predeterminado: 10 minutos. Rango: de 1 a 1,440 minutos. Recomendación: 10 minutos o más. Este valor debe ser menor que Retry Time for Failed Connections. Enable Throttling for Full Data Migration Limite la velocidad de sincronización completa para reducir la carga en el destino. Establezca QPS to the source database, RPS of Full Data Migration y Data migration speed (MB/s). Disponible solo cuando se selecciona Full Data Synchronization. También puede adjust the rate after the task starts. Enable Throttling for Incremental Data Synchronization Limite la velocidad de sincronización incremental. Establezca RPS of Incremental Data Synchronization y Data synchronization speed (MB/s). Environment Tag Etiquete la instancia para identificar su entorno. Opcional. Configure ETL Habilite la función de extracción, transformación y carga (ETL) para transformar los datos en tránsito. Consulte What is ETL? y Configure ETL. Monitoring and Alerting Configure alertas para errores de tareas o latencias que superen un umbral. Consulte Configure monitoring and alerting. Haga clic en Next: Data Validation para configurar opcionalmente una tarea de validación de datos. Consulte Configure data validation.
-
Guarde la tarea y ejecute la comprobación previa.
Para previsualizar los parámetros de API de esta configuración, pase el cursor sobre Next: Data Verification y haga clic en Preview OpenAPI parameters.
Haga clic en Next: Data Verification.
DTS ejecuta una comprobación previa antes de iniciar la tarea. Esta solo comienza si la comprobación se aprueba. Si falla, haga clic en View Details junto al elemento con errores, corrija el problema y vuelva a ejecutar la comprobación. Para advertencias que no se pueden ignorar, corrija el problema antes de continuar. Para advertencias que sí se pueden ignorar, haga clic en Confirm Alert Details > Ignore > OK y, a continuación, haga clic en Precheck Again .
-
Adquiera la instancia de sincronización. La tarea directa aparecerá en la página de sincronización de datos.
Cuando Success Rate alcance el 100 %, haga clic en Next: Purchase Instance.
-
Seleccione el método de facturación y las especificaciones de la instancia.
Parámetro
Descripción
Billing Method
Subscription: pago anticipado por una duración fija. Opciones mensuales: de 1 a 9 meses. Opciones anuales: 1, 2, 3 o 5 años. Resulta rentable para tareas de larga duración. Pay-as-you-go: facturación por hora según el uso real. Adecuado para tareas de prueba o de corta duración.
Resource Group Settings
El resource group de la instancia. De forma predeterminada es default resource group. Consulte What is Resource Management?.
Instance Class
Determina el rendimiento de la sincronización. Consulte Data synchronization link specifications.
Seleccione la casilla Data Transmission Service (Pay-as-you-go) Service Terms.
Haga clic en Purchase and Start y luego en OK en el cuadro de diálogo de confirmación.
Si se seleccionan tanto Full Data Synchronization como Incremental Data Synchronization , la tarea aparecerá como una única tarea de Incremental Data Synchronization en la página de lista de tareas.
Paso 3: Configurar la tarea inversa
Una vez que la tarea directa esté en ejecución, configure la tarea inversa para completar la sincronización bidireccional.
Espere hasta que el Status de la tarea directa sea Running.
En la columna Actions de la tarea inversa, haga clic en Configure Task.
-
Configure la tarea inversa con los mismos pasos que la tarea directa (pasos 2 a 7 anteriores). La tarea inversa intercambia el origen y el destino; a continuación se muestran las diferencias principales.
ImportanteConfirme que la información de la instancia (nombre de la base de datos, cuenta y contraseña) sea correcta para cada dirección. El origen y el destino se intercambian en la tarea inversa.
Parámetro
Tarea directa
Tarea inversa
Source database
Clúster A (origen original)
Clúster B (destino original)
Destination database
Clúster B (destino original)
Clúster A (origen original)
DDL synchronization
Configurable mediante Exclude DDL Operations
Siempre se filtra automáticamente
Processing mode of conflicting tables
Comprueba conflictos con todas las tablas de destino
No comprueba las tablas sincronizadas por la tarea directa
Synchronization objects
Su selección
Deben estar dentro de Selected Objects de la tarea directa
Instance Region
Configurable
Fijo, no se puede modificar
Object name mapping
Compatible
Evítelo, ya que puede causar inconsistencia de datos
Cuando Success Rate alcance el 100 %, haga clic en Back.
Espere hasta que el Status de ambas tareas sea Running. La sincronización bidireccional de datos ya está activa.