Utilice Data Transmission Service (DTS) para configurar la replicación bidireccional de datos entre dos clústeres de PolarDB for PostgreSQL. La sincronización bidireccional mantiene ambos clústeres alineados mediante la ejecución simultánea de una tarea directa (del clúster A al clúster B) y una tarea inversa (del clúster B al clúster A).
Para evitar conflictos de datos, segmente el tráfico de escritura en la capa de aplicación de modo que los registros con la misma clave primaria se actualicen en un solo clúster a la vez. Sin esta segmentación, las escrituras simultáneas sobre la misma clave primaria en ambos clústeres provocan conflictos que DTS no puede prevenir por completo.
Requisitos previos
Antes de empezar, asegúrese de que:
Tanto el clúster de origen como el de destino de PolarDB for PostgreSQL existen. Consulte Create a database cluster.
Existe una base de datos en el clúster de destino para recibir los datos. Consulte Database management.
El parámetro
wal_levelestá establecido enlogicalen ambos clústeres. Consulte Set cluster parameters.Ambos clústeres admiten y tienen habilitada la función Logical Replication Slot Failover. De lo contrario, un cambio de rol primario/secundario en el clúster de origen podría provocar que la instancia de sincronización falle y sea irrecuperable.
Si el clúster de origen de PolarDB for PostgreSQL no admite Logical Replication Slot Failover (por ejemplo, si el Database Engine del clúster es PostgreSQL 14 ), un cambio de rol de alta disponibilidad (HA) en la base de datos de origen podría causar que la instancia de sincronización falle y sea irrecuperable. Para consultar las versiones de base de datos compatibles, revise Synchronization overview . Ajuste las especificaciones del clúster de destino para que coincidan con las del clúster de origen.
Facturación
|
Tipo de sincronización |
Precio |
|
Sincronización de esquema y sincronización completa de datos |
Gratis |
|
Sincronización incremental de datos |
Con cargo. Consulte Billing overview. |
Límites
Requisitos de la base de datos de origen
Las tablas deben tener una clave primaria o un índice único no nulo.
Evite transacciones de larga duración en el clúster de origen. Las transacciones sin confirmar provocan la acumulación del registro de escritura anticipada (WAL), lo cual puede agotar el espacio en disco.
Si un solo cambio incremental supera los 256 MB, la instancia de sincronización falla y no se puede recuperar. Reconfigure la tarea desde cero.
No ejecute operaciones DDL durante la sincronización de esquemas ni durante la sincronización completa de datos. DTS crea bloqueos de metadatos durante la sincronización completa que pueden impedir la ejecución de DDL en el origen.
Objetos no compatibles
DTS no sincroniza:
Tablas de la extensión TimescaleDB
Tablas con herencia entre esquemas
Tablas con índices únicos basados en expresiones
Esquemas creados mediante la instalación de complementos
Tablas particionadas
Incluya tanto la tabla principal como todas las particiones secundarias como objetos de sincronización. Una tabla particionada de PostgreSQL no almacena datos en la tabla principal; todos los datos residen en las particiones secundarias. Si omite alguna partición secundaria, esos datos no se sincronizarán.
Columnas SERIAL y secuencias
Si una tabla sincronizada tiene una columna SERIAL, PostgreSQL crea automáticamente una secuencia de respaldo. Cuando selecciona Schema Synchronization, seleccione también Sequence o sincronice todo el esquema para evitar fallos en la instancia de sincronización.
Después de un cambio de negocio hacia el clúster de destino, las secuencias no reanudan automáticamente su conteo desde el valor máximo del origen. Antes de realizar el cambio, ejecute la siguiente consulta en el clúster de origen para obtener los valores actuales de las secuencias y luego aplique las sentencias setval devueltas en el clúster de destino:
do language plpgsql $$
declare
  nsp name;
  rel name;
  val int8;
begin
  for nsp,rel in select nspname,relname from pg_class t2 , pg_namespace t3 where t2.relnamespace=t3.oid and t2.relkind='S'
  loop
    execute format($_$select last_value from %I.%I$_$, nsp, rel) into val;
    raise notice '%',
    format($_$select setval('%I.%I'::regclass, %s);$_$, nsp, rel, val+1);
  end loop;
end;
$$;
La consulta devuelve sentencias setval para todas las secuencias de la base de datos de origen. Ejecute únicamente las sentencias correspondientes a las tablas que sincronizó.
Tablas que requieren REPLICA IDENTITY FULL
Ejecute ALTER TABLE schema.table REPLICA IDENTITY FULL; en las tablas de origen antes de escribir datos en cualquiera de estas tres situaciones:
Cuando la instancia de sincronización se ejecuta por primera vez.
Cuando utiliza la selección de objetos a nivel de esquema y se agrega una nueva tabla al esquema, o cuando se reconstruye una tabla existente con
RENAME.Cuando utiliza la función de modificación de objetos de sincronización.
Ejecute este comando fuera del horario pico y evite los bloqueos de tabla para prevenir interbloqueos. Si omite los elementos de verificación previa relacionados, DTS ejecutará este comando automáticamente durante la inicialización.
Claves externas, disparadores y disparadores de eventos
Para tablas con claves externas, disparadores o disparadores de eventos, DTS establece temporalmente session_replication_role en replica a nivel de sesión si la cuenta de la base de datos de destino es una cuenta privilegiada o tiene permisos de superusuario. Si la cuenta carece de dichos permisos, establezca manualmente session_replication_role en replica en el destino. Las operaciones de actualización o eliminación en cascada en el origen durante este periodo pueden causar inconsistencia en los datos. Una vez liberada la tarea de DTS, restablezca session_replication_role a origin.
Ranuras de replicación
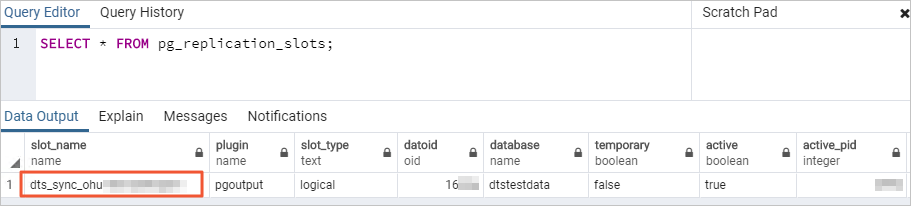
DTS crea una ranura de replicación con el prefijo dts_sync_ en la base de datos de origen para leer registros incrementales de hasta 15 minutos anteriores. Cuando una tarea de sincronización falla o se libera su instancia, DTS intenta limpiar la ranura automáticamente.
La ranura no se puede limpiar automáticamente si cambia la contraseña de la cuenta de la base de datos de origen o si elimina las direcciones IP de DTS de la lista blanca del clúster de origen. En esos casos, elimine manualmente la ranura de replicación en la base de datos de origen para evitar que se agote el disco. Si ocurre un cambio de rol, inicie sesión en el nodo secundario para borrar la ranura.
Tablas temporales
DTS crea las siguientes tablas temporales en la base de datos de origen para capturar sentencias DDL, estructuras incrementales de tablas y datos de latido. No elimine estas tablas mientras la tarea esté en ejecución, ya que se quitan automáticamente cuando se libera la instancia de DTS:
public.dts_pg_class, public.dts_pg_attribute, public.dts_pg_type, public.dts_pg_enum, public.dts_postgres_heartbeat, public.dts_ddl_command, public.dts_args_session, public.aliyun_dts_instance
Otros límites
Una sola tarea de sincronización solo puede sincronizar una base de datos. Cree una tarea independiente por cada base de datos adicional.
No escriba datos en el clúster de destino desde fuentes distintas a DTS durante la sincronización. Esto provoca inconsistencia en los datos.
Una tarea de sincronización bidireccional incluye tareas de sincronización directa e inversa. Al configurar o restablecer la tarea, si el objeto de destino de una coincide con el objeto de sincronización de la otra: solo una tarea puede realizar la sincronización completa e incremental; la otra solo admite sincronización incremental. Los datos del origen de una tarea se sincronizan únicamente con el destino de esa misma tarea y no se convierten en datos de origen para la otra tarea.
La sincronización completa de datos ejecuta operaciones INSERT concurrentes y consume recursos de lectura y escritura en ambos clústeres. Ejecute la sincronización completa fuera del horario pico, cuando la carga de CPU en ambos clústeres sea inferior al 30%. Espere que el espacio de tabla en el destino sea mayor que en el origen tras la sincronización completa debido a la fragmentación de tablas.
DTS valida el contenido de los datos, pero no valida metadatos como las secuencias. Valide los metadatos manualmente.
Si una tarea falla, el soporte de DTS intenta restaurarla en un plazo de 8 horas. La restauración puede implicar reiniciar la tarea o ajustar sus parámetros (no los parámetros de la base de datos). Consulte Modify instance parameters para ver la lista de parámetros ajustables.
Detección y resolución de conflictos
En la sincronización bidireccional, el mismo registro puede modificarse en ambos clústeres simultáneamente. DTS detecta los siguientes tipos de conflicto y aplica la política de resolución de conflictos que usted configure:
|
Tipo de conflicto |
Qué detecta DTS |
Cómo responde DTS |
|
INSERT duplicado |
Dos clústeres insertan una fila con la misma clave primaria |
Aplica la política de resolución de conflictos configurada al sincronizar el INSERT conflictivo con el clúster par |
|
UPDATE sin fila coincidente |
La fila por actualizar no existe en el destino |
Convierte el UPDATE en un INSERT; aplica la política de conflictos si resulta un conflicto de unicidad |
|
UPDATE con conflicto de clave |
El UPDATE provoca una violación de clave primaria o única |
Aplica la política de resolución de conflictos configurada |
|
DELETE sin fila coincidente |
La fila por eliminar no existe en el destino |
Ignora el DELETE independientemente de la política configurada |
DTS no puede garantizar la prevención de conflictos al 100% debido a la latencia de red y a las diferencias de reloj entre clústeres. Para asegurar la consistencia, actualice los registros con la misma clave primaria o única en un solo clúster a la vez.
Políticas de resolución de conflictos
Seleccione una política al configurar la tarea de sincronización bidireccional:
|
Política |
Comportamiento |
|
TaskFailed |
La tarea se detiene y entra en estado de error si ocurre un conflicto. Se requiere intervención manual para reanudarla. |
|
Ignore |
Se omite la sentencia conflictiva. Se conserva el registro existente en el clúster de destino. |
|
Overwrite |
El registro conflictivo en el clúster de destino se sobrescribe con los datos del origen. |
Estas políticas se aplican únicamente cuando la tarea se ejecuta con normalidad. Si la tarea se pausa o se reinicia con latencia, DTS sobrescribe los datos de destino de forma predeterminada, sin importar la política configurada.
Objetos de sincronización compatibles
DTS sincroniza objetos SCHEMA y TABLE, incluidos PRIMARY KEY, UNIQUE KEY, FOREIGN KEY, tipos de datos integrados y DEFAULT CONSTRAINT.
Los objetos compatibles varían según el tipo de base de datos de destino. Revise la consola de DTS para más detalles.
Operaciones SQL compatibles
Las operaciones DDL se sincronizan únicamente en la tarea directa (del origen al destino). La tarea inversa filtra automáticamente las operaciones DDL.
|
Tipo de operación |
Sentencias compatibles |
|
DML |
INSERT, UPDATE, DELETE |
|
DDL |
CREATE TABLE, DROP TABLE, ALTER TABLE (RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK, ALTER COLUMN DROP DEFAULT), TRUNCATE TABLE (requiere motor de origen PostgreSQL 11 o posterior), CREATE INDEX ON TABLE |
Condiciones de compatibilidad con DDL:
La sincronización de DDL solo está disponible para tareas creadas después del 1 de octubre de 2020.
Para tareas creadas antes del 12 de mayo de 2023, cree disparadores y funciones en la base de datos de origen para capturar sentencias DDL antes de configurar la tarea. Consulte Use triggers and functions to implement incremental DDL migration for PostgreSQL.
Los datos de tipo bit no son compatibles durante la sincronización incremental de datos.
Patrones DDL no compatibles:
Sentencias DDL que contienen cláusulas CASCADE o RESTRICT
Sentencias DDL ejecutadas en sesiones donde
SET session_replication_role = replicaestá activoSentencias DDL invocadas mediante funciones
Transacciones que combinan sentencias DML y DDL (el DDL no se sincroniza)
DDL para objetos no incluidos en el alcance de la sincronización
Permisos obligatorios de la cuenta de base de datos
|
Base de datos |
Permiso obligatorio |
Cómo crearlo y otorgarlo |
|
Clústeres de origen y destino de PolarDB for PostgreSQL |
Una cuenta privilegiada propietaria de la base de datos |
Configurar la sincronización bidireccional
La sincronización bidireccional requiere una tarea directa y una tarea inversa. Configure primero la tarea directa (pasos 1–7) y luego configure la tarea inversa (paso 8).
Diferencias de configuración entre la tarea directa y la inversa
Antes de comenzar, revise las diferencias entre ambas tareas. Configurar incorrectamente la tarea inversa es la causa más frecuente de errores.
|
Parámetro |
Tarea directa (A a B) |
Tarea inversa (B a A) |
|
Base de datos de origen |
Clúster A |
Clúster B (igual que el destino de la directa) |
|
Base de datos de destino |
Clúster B |
Clúster A (igual que el origen de la directa) |
|
Instance Region |
Configurable |
No se puede cambiar |
|
Sincronización de esquema |
Seleccionable |
No aplica (hay menos opciones disponibles) |
|
Sincronización completa de datos |
Seleccionable |
No seleccionable: solo incremental |
|
Sincronización de DDL |
Configurable |
Filtrada automáticamente |
|
Asignación de nombres de objetos |
Compatible |
No recomendada: puede causar inconsistencia de datos |
|
Verificación de tablas en conflicto |
Verifica todas las tablas de destino |
No verifica las tablas ya sincronizadas por la tarea directa |
Paso 1: Abrir la lista de tareas de sincronización de datos
Abra la lista de tareas de DTS mediante la consola de DTS o la consola de DMS.
Consola de DTS
Inicie sesión en la consola de DTS.DTS console
En el panel de navegación izquierdo, haga clic en Data Synchronization.
En la esquina superior izquierda, seleccione la región de la instancia de sincronización.
Consola de DMS
Los pasos pueden variar según el modo de su consola de DMS. Consulte Simple mode console y Customize the layout and style of the DMS console .
Inicie sesión en la consola de DMS.DMS console
En la barra de menú superior, elija Data + AI > DTS (DTS) > Data Synchronization.
A la derecha de Data Synchronization Tasks, seleccione la región de la instancia de sincronización.
Paso 2: Crear la tarea
Haga clic en Create Task para abrir la página de configuración de la tarea.
Paso 3: Configurar las bases de datos de origen y destino
|
Campo |
Valor |
|
Task Name |
DTS genera un nombre automáticamente. Introduzca un nombre descriptivo para facilitar su identificación. Los nombres no necesitan ser únicos. |
|
Source Database |
|
|
Select Existing Connection |
Seleccione una registered database instance de la lista para completar automáticamente los campos siguientes. En la consola de DMS, este campo aparece como Select a DMS database instance. Si no hay ninguna instancia registrada disponible, complete los campos siguientes manualmente. |
|
Database Type |
Seleccione PolarDB for PostgreSQL. |
|
Access Method |
Seleccione Alibaba Cloud Instance. |
|
Instance Region |
Seleccione la región del clúster de origen de PolarDB for PostgreSQL. |
|
Replicate Data Across Alibaba Cloud Accounts |
Seleccione No si el clúster de origen pertenece a la cuenta actual de Alibaba Cloud. |
|
Instance ID |
Seleccione el ID del clúster de origen de PolarDB for PostgreSQL. |
|
Database Name |
Introduzca el nombre de la base de datos que contiene los objetos a sincronizar. |
|
Database Account |
Introduzca la cuenta del clúster de origen. Consulte Required database account permissions. |
|
Database Password |
Introduzca la contraseña de la cuenta. |
|
Destination Database |
|
|
Select Existing Connection |
Seleccione una registered database instance de la lista. En la consola de DMS, este campo aparece como Select a DMS database instance. |
|
Database Type |
Seleccione PolarDB for PostgreSQL. |
|
Access Method |
Seleccione Alibaba Cloud Instance. |
|
Instance Region |
Seleccione la región del clúster de destino de PolarDB for PostgreSQL. |
|
Instance ID |
Seleccione el ID del clúster de destino de PolarDB for PostgreSQL. |
|
Database Name |
Introduzca el nombre de la base de datos en el clúster de destino que recibirá los datos. |
|
Database Account |
Introduzca la cuenta del clúster de destino. Consulte Required database account permissions. |
|
Database Password |
Introduzca la contraseña de la cuenta. |
Haga clic en Test Connectivity and Proceed en la parte inferior de la página.
DTS debe poder alcanzar ambos clústeres. Agregue los bloques de direcciones IP del servicio DTS a la configuración de seguridad de ambos clústeres, ya sea automáticamente durante la prueba de conectividad o manualmente con antelación. Consulte Add the IP address whitelist of DTS servers .
Paso 4: Configurar los objetos de sincronización
En la página Configure Objects, defina las siguientes opciones:
| Opción | Descripción |
|---|---|
| Synchronization Types | Incremental Data Synchronization siempre está seleccionado. De forma predeterminada, Schema Synchronization y Full Data Synchronization también están seleccionados. DTS utiliza los datos completos de los objetos de origen seleccionados para inicializar el clúster de destino, lo cual sirve como línea base para la sincronización incremental. |
| Synchronization Topology | Seleccione Two-way Synchronization. |
| Exclude DDL Operations | Seleccione Yes para omitir la sincronización de DDL. Seleccione No para sincronizar operaciones DDL. La sincronización de DDL se aplica únicamente a la tarea directa; la tarea inversa filtra el DDL automáticamente. |
| Global Conflict Resolution Policy | Seleccione una de las siguientes políticas según sus necesidades de negocio: TaskFailed: la tarea se detiene si ocurre un conflicto y requiere intervención manual; Ignore: se omite la sentencia conflictiva y se conserva el registro existente en el destino; Overwrite: el registro de destino se sobrescribe con los datos del origen. Consulte Políticas de resolución de conflictos para más detalles. |
| Processing Mode of Conflicting Tables | Precheck and Report Errors: Reporta un error durante la verificación previa si existen tablas de destino con el mismo nombre. Utilice la asignación de nombres de objetos para evitar conflictos de nombres sin renombrar tablas. Ignore Errors and Proceed: Omite esta verificación. Durante la sincronización completa, se conservan los registros existentes en el destino y se omiten los registros de origen con la misma clave primaria o única. Durante la sincronización incremental, los registros de origen sobrescriben los registros de destino. Si los esquemas difieren, la inicialización puede fallar o resultar en una sincronización parcial. Úselo con precaución. |
| Capitalization of Object Names in Destination Instance | Configure la política de distinción entre mayúsculas y minúsculas para los nombres de bases de datos, tablas y columnas en el destino. El valor predeterminado es DTS default policy. Consulte Case policy for destination object names. |
| Source Objects | Haga clic en los objetos del cuadro Source Objects y luego en la flecha derecha para moverlos a Selected Objects. Seleccione esquemas o tablas. Si selecciona tablas, se excluyen vistas, disparadores y procedimientos almacenados. Si una tabla tiene una columna SERIAL y Schema Synchronization está seleccionado, seleccione también Sequence o sincronice todo el esquema. |
| Selected Objects | Para renombrar un objeto en el destino, haga clic derecho sobre él en Selected Objects y edite el nombre. Consulte Map database, table, and column names. Para quitar un objeto, haga clic en él y luego en la flecha izquierda para devolverlo. Para filtrar filas mediante una cláusula WHERE, haga clic derecho en una tabla dentro de Selected Objects y establezca la condición. Consulte Set filter conditions. Para limitar qué operaciones DML se sincronizan, haga clic derecho en un objeto y seleccione las operaciones. Nota
La asignación de nombres de objetos puede causar fallos de sincronización en objetos dependientes. |
Haga clic en Next: Advanced Settings.
Paso 5: Configurar ajustes avanzados
|
Opción |
Descripción |
|
Dedicated Cluster for Task Scheduling |
DTS utiliza un clúster compartido de forma predeterminada. Para mayor estabilidad, adquiera un clúster dedicado. Consulte What is a DTS dedicated cluster? |
|
Retry Time for Failed Connections |
Tiempo durante el cual DTS reintenta tras un fallo de conexión. Predeterminado: 720 minutos. Rango: 10–1,440 minutos. Establezca 30 minutos o más para la mayoría de los casos. Si varias instancias de DTS comparten el mismo origen o destino, DTS utiliza la duración de reintento más corta configurada entre dichas instancias. DTS cobra por el tiempo de ejecución de la tarea durante los reintentos, así que libere la instancia de DTS a la brevedad si libera el clúster de origen o de destino. |
|
Retry Time for Other Issues |
Tiempo durante el cual DTS reintenta tras errores distintos a fallos de conexión (por ejemplo, fallos en la ejecución de DDL o DML). Predeterminado: 10 minutos. Rango: 1–1,440 minutos. Debe ser menor que Retry Time for Failed Connections. |
|
Enable Throttling for Full Data Synchronization |
Limite la velocidad de sincronización completa para reducir la carga en el destino. Configure Queries per second (QPS) to the source database, RPS of Full Data Migration y Data migration speed for full migration (MB/s). Disponible únicamente cuando Full Data Synchronization está seleccionado. También puede ajustar la velocidad mientras la tarea se ejecuta. |
|
Enable Throttling for Incremental Data Synchronization |
Limite la velocidad de sincronización incremental. Configure RPS of Incremental Data Synchronization y Data synchronization speed for incremental synchronization (MB/s). |
|
Environment Tag |
Seleccione una etiqueta para identificar el entorno. |
|
Configure ETL |
Seleccione Yes para habilitar extracción, transformación y carga (ETL) e introducir sentencias de procesamiento de datos. Seleccione No para omitirlo. Consulte What is ETL? y Configure ETL in a data migration or data synchronization task. |
|
Monitoring and Alerting |
Seleccione Yes para recibir alertas cuando la tarea falle o la latencia supere un umbral. Configure el umbral y los contactos de notificación. Consulte Configure monitoring and alerting during task configuration. |
Paso 6: Configurar la verificación de datos (opcional)
Haga clic en Data Verification para configurar una tarea de verificación de datos. Consulte Configure data verification.
DTS valida el contenido de los datos, pero no valida metadatos como las secuencias. Valide los metadatos manualmente después de la sincronización.
Paso 7: Guardar la configuración, ejecutar la verificación previa y adquirir la instancia
Para previsualizar los parámetros de la API antes de guardar, pase el cursor sobre Next: Save Task Settings and Precheck y haga clic en Preview OpenAPI parameters.
-
Haga clic en Next: Save Task Settings and Precheck. DTS ejecuta una verificación previa antes de iniciar la tarea.
Si la verificación previa falla, haga clic en View Details junto al elemento fallido, corrija el problema y vuelva a ejecutar la verificación.
-
Si la verificación previa muestra advertencias:
Para advertencias no ignorables: haga clic en View Details, corrija el problema y vuelva a ejecutar.
Para advertencias ignorables: haga clic en Confirm Alert Details > Ignore > OK > Precheck Again. Ignorar advertencias puede causar inconsistencias en los datos.
Cuando Success Rate alcance 100%, haga clic en Next: Purchase Instance.
-
En la página Purchase, seleccione las opciones de facturación e instancia:
Opción
Descripción
Billing Method
Subscription: Pago anticipado por una duración fija. Ideal para tareas continuas a largo plazo. Pay-as-you-go: Facturación por hora. Ideal para tareas de corto plazo o de prueba.
Resource Group Settings
El resource group para la instancia. Predeterminado: default resource group. Consulte What is Resource Management?
Instance Class
Seleccione según el rendimiento de sincronización requerido. Consulte Data synchronization link specifications.
Subscription Duration
Disponible cuando se selecciona Subscription. Mensual: 1–9 meses. Anual: 1, 2, 3 o 5 años.
Marque la casilla Data Transmission Service (Pay-as-you-go) Service Terms y luego haga clic en Buy and Start > OK.
La tarea de sincronización directa aparecerá en la página de sincronización de datos.
Paso 8: Configurar la tarea de sincronización inversa
Espere hasta que el Status de la tarea directa muestre Running.
En la columna Actions de la tarea inversa, haga clic en Configure Task.
-
Repita los pasos 3–6 para la tarea inversa, con las siguientes diferencias:
ImportanteEl origen y el destino están intercambiados: el destino de la tarea directa es el origen en la tarea inversa, y viceversa. Verifique cuidadosamente los ID de instancia, nombres de bases de datos, cuentas y contraseñas.
Instance Region no se puede cambiar para la tarea inversa. Hay menos opciones de configuración disponibles.
Processing Mode of Conflicting Tables para la tarea inversa no verifica las tablas ya sincronizadas por la tarea directa.
La tarea inversa solo puede sincronizar objetos que ya estén en la lista de Selected Objects de la tarea directa.
No utilice la función de asignación de nombres de objetos en la tarea inversa, ya que esto puede causar inconsistencia en los datos.
Cuando Success Rate muestre 100%, haga clic en Back.
Espere hasta que tanto la tarea directa como la inversa muestren Status como Running.
La sincronización bidireccional ahora está activa.
Pasos siguientes
Monitoree la latencia de sincronización y configure alertas: Configure monitoring and alerting
Valide los datos sincronizados: Configure data verification
Revise los parámetros de la tarea: Modify instance parameters