Data Transmission Service (DTS) admite la sincronización bidireccional de datos entre dos bases de datos ApsaraDB RDS for PostgreSQL. Esta función se utiliza comúnmente para la redundancia geográfica activa (basada en unidades) y la recuperación ante desastres geográfica.
Requisitos previos
Antes de empezar, asegúrese de haber cumplido con lo siguiente:
Cree tanto la instancia de origen como la de destino de ApsaraDB RDS for PostgreSQL. Consulte Creación de una instancia de ApsaraDB RDS for PostgreSQL.
Establezca el parámetro
wal_levelenlogicalen ambas instancias. Consulte Modify the parameters of an ApsaraDB RDS for PostgreSQL instance.
Para conocer las versiones de bases de datos de origen y destino compatibles, consulte Descripción general de los escenarios de sincronización de datos .
Límites
Bases de datos de origen y destino
Tablas sin claves primarias ni restricciones UNIQUE: Habilite la función de escritura Exactly-Once al configurar la tarea. De lo contrario, la base de datos de destino podría contener registros duplicados. Consulte Sincronización de tablas sin claves primarias ni restricciones UNIQUE.
Límite de tablas por tarea: Si selecciona tablas como objetos para sincronizar y cambia el nombre de tablas o columnas en el destino, una sola tarea admite hasta 5,000 tablas. Superar este límite provoca un error de solicitud. Divida las tablas en varias tareas o sincronice toda la base de datos.
Objetos no compatibles: DTS no puede sincronizar tablas temporales, desencadenadores internos ni procedimientos y funciones internas escritos en C. DTS sí puede sincronizar parámetros personalizados de los tipos COMPOSITE, ENUM y RANGE. Las tablas deben tener restricciones PRIMARY KEY, FOREIGN KEY, UNIQUE o CHECK.
-
Retención de registros WAL: Si los registros WAL no se conservan durante el tiempo necesario, DTS podría no obtenerlos y la tarea podría fallar. En circunstancias excepcionales, esto puede causar inconsistencia o pérdida de datos. Asegúrese de configurar el periodo de retención de los registros WAL según los requisitos anteriores. De lo contrario, no se garantiza la fiabilidad ni el rendimiento del servicio especificado en el Acuerdo de Nivel de Servicio (SLA) de DTS. Una vez completada la sincronización completa de datos, puede reducir la retención a más de 24 horas.
wal_leveldebe establecerse enlogical.Solo sincronización incremental: conserve los registros WAL durante más de 24 horas.
Sincronización completa + sincronización incremental: conserve los registros WAL durante al menos 7 días.
Conmutación por error primaria/secundaria: Habilite la función Logical Replication Slot Failover antes de realizar una conmutación en la instancia de origen. Sin esta función, las suscripciones lógicas podrían interrumpirse.
Límite de tamaño por registro: Si un cambio incremental de datos supera los 256 MB, la instancia de sincronización fallará y no podrá recuperarse. Vuelva a configurar la tarea.
Restricciones de DDL: No ejecute sentencias DDL para modificar esquemas de bases de datos o tablas durante la sincronización de esquemas o la sincronización completa de datos, ya que esto provocará el fallo de la tarea.
Transacciones de larga duración: Los registros WAL generados antes de confirmar transacciones prolongadas pueden acumularse y agotar el espacio en disco de la base de datos de origen.
Actualizaciones de versión principal: Realizar una actualización de versión principal en la base de datos de origen mientras se ejecuta una instancia de sincronización provoca que la instancia falle y sea irrecuperable. Vuelva a configurar la tarea.
Otras limitaciones
Una tarea de sincronización solo sincroniza desde una base de datos. Cree una tarea independiente para cada base de datos adicional.
DTS no puede sincronizar tablas que tengan relaciones de herencia entre esquemas.
-
Schema-level synchronization: Si crea o cambia el nombre de una tabla en un esquema sincronizado, ejecute la siguiente sentencia antes de escribir datos en dicha tabla:
ALTER TABLE schema.table REPLICA IDENTITY FULL;Reemplace
schemaytablecon el nombre real del esquema y de la tabla. Ejecute esta sentencia fuera de las horas pico y evite bloquear la tabla para prevenir interbloqueos. DTS no valida metadatos como las secuencias. Valídelos manualmente.
-
Secuencias tras el cambio de carga de trabajo: Las nuevas secuencias en la base de datos de destino no continúan desde el valor máximo del origen. Antes de trasladar la carga de trabajo al destino, consulte los valores máximos de las secuencias en el origen y establézcalos como valores iniciales en el destino:
Las sentencias SQL devueltas incluyen todas las secuencias de la base de datos de origen. Aplíquelas en el destino según sus necesidades.
do language plpgsql $$
declare
  nsp name;
  rel name;
  val int8;
begin
  for nsp,rel in select nspname,relname from pg_class t2 , pg_namespace t3 where t2.relnamespace=t3.oid and t2.relkind='S'
  loop
    execute format($_$select last_value from %I.%I$_$, nsp, rel) into val;
    raise notice '%',
    format($_$select setval('%I.%I'::regclass, %s);$_$, nsp, rel, val+1);
  end loop;
end;
$$;
Tablas temporales de DTS: DTS crea las siguientes tablas temporales en la base de datos de origen. No las elimine durante la sincronización, ya que se borran automáticamente después de liberar la instancia de DTS:
public.dts_pg_class,public.dts_pg_attribute,public.dts_pg_type,public.dts_pg_enum,public.dts_postgres_heartbeat,public.dts_ddl_commandypublic.dts_args_session.Tabla de latidos: DTS agrega una tabla de latidos llamada
dts_postgres_heartbeata la base de datos de origen para mantener precisa la latencia de sincronización.-
Slot de replicación: DTS crea un slot de replicación con el prefijo
dts_sync_en la base de datos de origen para obtener registros incrementales de los últimos 15 minutos.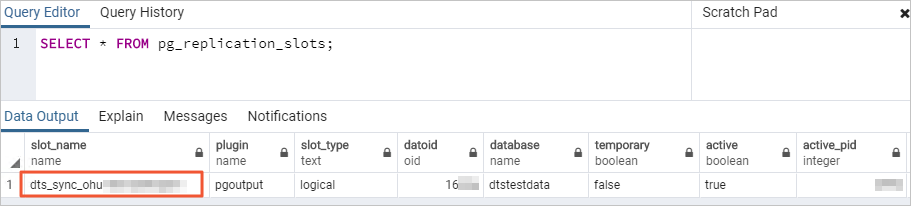
El slot de replicación se elimina automáticamente tras liberar la instancia de DTS. Si cambia la contraseña de la base de datos de origen o quita direcciones IP de DTS de la lista de permitidos, el slot no se eliminará automáticamente; bórrelo manualmente para evitar su acumulación.
Si la tarea se libera o falla, DTS elimina automáticamente el slot de replicación. Tras una conmutación por error primaria/secundaria en la base de datos PostgreSQL de origen, inicie sesión en la base de datos secundaria para eliminar el slot de replicación.
Impacto en el rendimiento: Evalúe el impacto de la sincronización en el rendimiento de las bases de datos de origen y destino antes de comenzar. Siempre que sea posible, ejecute la sincronización fuera de las horas pico. La sincronización inicial completa consume recursos de lectura y escritura en ambas bases de datos.
Tamaño del tablespace: Después de la sincronización inicial completa, el tablespace en el destino puede ser mayor que en el origen debido a la fragmentación causada por operaciones INSERT concurrentes.
DDL en línea durante la sincronización: Si DTS es el único proceso que escribe en el destino, puede usar Data Management (DMS) para ejecutar operaciones DDL en línea sobre las tablas de origen. Consulte Cambio de esquemas sin bloqueo de tablas. Si otras fuentes también escriben en el destino, ejecutar DDL en línea puede provocar pérdida de datos.
Claves foráneas y desencadenadores: Si la cuenta de la base de datos de destino tiene privilegios elevados o de superusuario y las tablas contienen claves foráneas, desencadenadores o desencadenadores de eventos, DTS establece temporalmente
session_replication_roleenreplicaa nivel de sesión. Si se realizan actualizaciones o eliminaciones en cascada en el origen mientras esta configuración está activa, puede producirse inconsistencia de datos. Una vez liberada la tarea, restablezcasession_replication_roleaorigin.-
Reglas de tareas bidireccionales: Una instancia de sincronización bidireccional contiene una tarea directa y una inversa. Si un objeto se incluye en ambas tareas:
Solo una tarea puede sincronizar tanto datos completos como incrementales. La otra tarea sincroniza únicamente datos incrementales.
Los datos sincronizados hacia el destino en una tarea no se reutilizan como datos de origen para la otra tarea.
Restauración de tareas: Si una tarea de DTS falla, el soporte técnico intentará restaurarla dentro de las 8 horas siguientes. Durante la restauración, la tarea podría reiniciarse y modificarse sus parámetros. Los parámetros de la base de datos no se modifican.
Casos especiales
Origen ApsaraDB RDS for PostgreSQL: No modifique el endpoint ni la zona de la instancia de origen durante la sincronización, ya que esto provocará el fallo de la tarea.
Origen PostgreSQL autogestionado: Los valores de
max_wal_sendersymax_replication_slotsdeben superar individualmente la suma de: slots de replicación actuales en uso + número de instancias de DTS que se crearán para esta base de datos.Origen Google Cloud SQL for PostgreSQL (GCP): Establezca Database Account en una cuenta con el permiso
cloudsqlsuperuser. Seleccione solo los objetos que la cuenta tenga autorización para gestionar, o conceda el permiso OWNER sobre los objetos seleccionados a dicha cuenta. Una cuenta con permisocloudsqlsuperuserno puede gestionar datos propiedad de otras cuentas con el mismo permiso.
Facturación
|
Tipo de sincronización |
Tarifa |
|
Sincronización de esquemas y sincronización completa de datos |
Gratuita |
|
Sincronización incremental de datos |
Con cargo. Consulte Descripción general de la facturación. |
Topologías de sincronización compatibles
DTS admite la sincronización bidireccional exclusivamente entre dos bases de datos PostgreSQL. No se admite la sincronización bidireccional entre tres o más bases de datos.
Objetos compatibles
|
Tipo de objeto |
Detalles |
|
SCHEMA, TABLE |
Incluye PRIMARY KEY, UNIQUE KEY, FOREIGN KEY, tipos de datos integrados y restricciones DEFAULT |
|
VIEW, FUNCTION, RULE, SEQUENCE, EXTENSION, TRIGGER, AGGREGATE, INDEX, OPERATOR, DOMAIN |
— |
|
PROCEDURE |
Solo PostgreSQL V11 o posterior |
Operaciones SQL
|
Tipo de operación |
Sentencias compatibles |
|
DML |
INSERT, UPDATE, DELETE |
|
DDL |
CREATE TABLE, DROP TABLE, ALTER TABLE (RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK, ALTER COLUMN DROP DEFAULT), TRUNCATE TABLE (la base de datos PostgreSQL autogestionada de origen debe ser versión 11 o posterior), CREATE INDEX ON TABLE |
Requisitos previos y restricciones para DDL:
La sincronización de DDL solo está disponible para tareas creadas después del 1 de octubre de 2020.
Para tareas creadas antes del 12 de mayo de 2023: cree desencadenadores y funciones en la base de datos de origen para capturar DDL antes de configurar la tarea. Consulte Uso de desencadenadores y funciones para implementar la migración incremental de DDL en bases de datos PostgreSQL.
La cuenta de la base de datos de origen debe ser una cuenta con privilegios y la versión menor del motor de la instancia ApsaraDB RDS for PostgreSQL debe ser 20210228 o posterior. Consulte Actualización de la versión menor del motor.
Para utilizar una tarea de sincronización de datos creada antes del 12 de mayo de 2023 con el fin de sincronizar operaciones DDL, debe crear desencadenadores y funciones en la base de datos de origen para capturar la información DDL antes de configurar la tarea. Para más información, consulte Uso de desencadenadores y funciones para implementar la migración incremental de DDL en bases de datos PostgreSQL.
Los datos de tipo BIT no se pueden sincronizar durante la sincronización incremental.
No se pueden sincronizar los siguientes elementos DDL: modificadores adicionales como CASCADE o RESTRICT; DDL de sesiones que ejecutan
SET session_replication_role = replica; DDL ejecutado mediante invocaciones de funciones; confirmaciones que mezclan DML y DDL; DDL para objetos no incluidos en el ámbito de sincronización.
Las operaciones DDL se sincronizan únicamente en dirección directa (del origen al destino). El DDL se ignora en la dirección inversa.
Detección de conflictos
Para mantener la consistencia de los datos, actualice los registros con la misma clave primaria, clave primaria de negocio o clave única en un solo nodo de sincronización a la vez.
DTS detecta y gestiona los siguientes tipos de conflictos:
|
Tipo de conflicto |
Desencadenante |
Comportamiento de DTS |
|
Conflicto de unicidad en INSERT |
Un INSERT en un nodo entra en conflicto con un registro existente en el otro (misma clave primaria) |
El INSERT conflictivo no se sincroniza |
|
UPDATE — registro ausente |
El registro a actualizar no existe en el destino |
DTS convierte el UPDATE en un INSERT; pueden surgir conflictos de unicidad |
|
UPDATE — conflicto de clave |
La clave primaria o única del registro insertado entra en conflicto con un registro existente |
Falla el INSERT proveniente del UPDATE convertido |
|
DELETE — registro ausente |
El registro a eliminar no existe en el destino |
DTS ignora el DELETE, independientemente de la directiva de resolución de conflictos |
Debido a las diferencias de hora del sistema entre las instancias de origen y destino, sumado a la latencia de sincronización, DTS no puede garantizar que la detección de conflictos evite todos los conflictos de datos. Mantenga los registros con la misma clave primaria, clave primaria de negocio o clave única en un solo nodo.
Seleccione una directiva de resolución de conflictos al configurar la sincronización bidireccional:
|
Directiva |
Comportamiento |
|
TaskFailed |
La tarea reporta un error y se detiene. Resuelva el conflicto manualmente. |
|
Ignore |
La tarea omite la sentencia conflictiva y continúa. Se conserva el registro existente en el destino. |
|
Overwrite |
Se sobrescribe el registro conflictivo en el destino. |
Si ocurre una latencia al pausar o reiniciar una tarea de sincronización, la directiva seleccionada no se aplica durante ese periodo. Por defecto, los datos en el destino se sobrescriben con los datos sincronizados durante la latencia.
Configuración de la sincronización bidireccional
La sincronización bidireccional requiere dos tareas: una tarea directa (Instancia A a Instancia B) y una tarea inversa (Instancia B a Instancia A). Configure primero la tarea directa, espere a que alcance el estado Running y luego configure la tarea inversa.
Paso 1: Adquisición de una instancia de DTS
Purchase a DTS instance y, en la página de compra, establezca tanto Source Instance como Destination Instance en PostgreSQL, y defina Synchronization Topology como Two-way Synchronization.
Paso 2: Apertura de la página de sincronización de datos
Vaya a la página de sincronización de datos de la consola de DTS.
Alternativamente, inicie sesión en la consola de Data Management (DMS) y, en la barra de navegación superior, elija Data + AI > DTS (DTS) > Data Synchronization .
Paso 3: Configuración de la tarea directa
En la esquina superior izquierda, seleccione la región donde reside la instancia de sincronización adquirida.
Localice la instancia de sincronización y haga clic en Configure Task para la tarea de sincronización directa.
-
Configure las bases de datos de origen y destino.
AvisoDespués de configurar las bases de datos de origen y destino, lea los Limits mostrados en la página antes de continuar.
Task Name
Parámetro
Descripción
Task Name
Introduzca un nombre descriptivo. El nombre no necesita ser único.
Base de datos de origen [Instancia A]
Parámetro
Descripción
Database Type
Seleccione PostgreSQL.
Connection Type
Seleccione Alibaba Cloud Instance.
Instance Region
Prellenado desde la página de compra. No se puede modificar.
Instance ID
Seleccione la instancia de origen de ApsaraDB RDS for PostgreSQL.
Database Name
Introduzca el nombre de la base de datos de origen.
Database Account
Introduzca una cuenta con privilegios propietaria de la base de datos de origen. Consulte Create an account y Create a database.
Database Password
Introduzca la contraseña de la cuenta.
Encryption
Seleccione Non-encrypted o SSL-encrypted. Para SSL, cargue el CA Certificate y opcionalmente el Client Certificate, la Private Key of Client Certificate y la Private Key Password of Client Certificate. Consulte Cifrado SSL.
Base de datos de destino [Instancia B]
Parámetro
Descripción
Database Type
Seleccione PostgreSQL.
Connection Type
Seleccione Alibaba Cloud Instance.
Instance Region
Prellenado desde la página de compra. No se puede modificar.
Instance ID
Seleccione la instancia de destino de ApsaraDB RDS for PostgreSQL.
Database Name
Introduzca el nombre de la base de datos de destino.
Database Account
Introduzca una cuenta con privilegios propietaria de la base de datos de destino.
Database Password
Introduzca la contraseña de la cuenta.
Encryption
Seleccione Non-encrypted o SSL-encrypted.
-
Haga clic en Test Connectivity and Proceed.
Asegúrese de que los bloques CIDR de los servidores DTS estén agregados a la configuración de seguridad de las bases de datos de origen y destino. Consulte Adición de los bloques CIDR de los servidores DTS . Para bases de datos autogestionadas con un método de acceso distinto a Alibaba Cloud Instance , haga clic en Test Connectivity en el cuadro de diálogo CIDR Blocks of DTS Servers .
-
Configure los objetos a sincronizar. En el paso Configure Objects, establezca los siguientes parámetros:
Parámetro
Descripción
Synchronization Types
Seleccione Schema Synchronization, Full Data Synchronization y Incremental Data Synchronization. La sincronización completa migra los datos históricos como línea base para la sincronización incremental. Si selecciona Schema Synchronization, DTS sincroniza los esquemas de las tablas seleccionadas desde la base de datos de origen hacia la de destino, incluyendo las claves foráneas.
Processing Mode of Conflicting Tables
Precheck and Report Errors: falla la comprobación previa si existen tablas con nombres idénticos en origen y destino (recomendado). Ignore Errors and Proceed: omite esta comprobación; úselo con precaución. Si las bases de datos de origen y destino tienen el mismo esquema y existe un registro con la misma clave primaria o única en ambas: durante la sincronización completa, DTS no sincroniza el registro conflictivo y se conserva el existente en el destino; durante la sincronización incremental, DTS sincroniza el registro y se sobrescribe el existente en el destino. Si los esquemas difieren, la inicialización de datos podría fallar, sincronizándose solo algunas columnas o fallando la tarea.
Synchronization Topology
Seleccione Two-way Synchronization.
Enable Exactly-Once Write
Seleccione Yes si alguna tabla a sincronizar carece de claves primarias y restricciones UNIQUE.
Exclude DDL Operations
No para sincronizar DDL; Yes para excluirlo. Solo se muestra al configurar la tarea directa. El DDL siempre se ignora en la dirección inversa.
Conflict Resolution Policy
Seleccione TaskFailed, Ignore o Overwrite. Consulte Conflict detection.
Capitalization of Object Names in Destination Instance
El valor predeterminado es DTS default policy. Ajústelo para coincidir con las convenciones de origen o destino si es necesario. Consulte Especificación de mayúsculas y minúsculas en nombres de objetos de la instancia de destino.
Source Objects
Seleccione objetos y haga clic en el icono de flecha para moverlos a Selected Objects. Puede seleccionar columnas, tablas o esquemas.
Selected Objects
Haga clic derecho en un objeto para cambiarle el nombre o filtrar datos con condiciones WHERE. Haga clic en Batch Edit para renombrar varios objetos a la vez. Consulte Asignación de nombres de objetos y Use SQL conditions to filter data.
-
Haga clic en Next: Advanced Settings y configure lo siguiente:
Parámetro
Descripción
Dedicated Cluster for Task Scheduling
Déjelo en blanco para usar el clúster compartido. Para mayor estabilidad, adquiera un clúster dedicado. Consulte ¿Qué es un clúster dedicado de DTS?.
Retry Time for Failed Connections
Intervalo de tiempo para reintentar conexiones fallidas. Valores válidos: 10–1440 minutos. Predeterminado: 720. Establézcalo en al menos 30 minutos. Si múltiples tareas comparten origen o destino y tienen distintos tiempos mínimos de reintento, prevalece ese valor mínimo. Mientras DTS reintenta la conexión, se cobra la instancia de DTS.
Retry Time for Other Issues
Intervalo de tiempo para reintentar operaciones DDL o DML fallidas. Valores válidos: 1–1440 minutos. Predeterminado: 10. Establézcalo en más de 10 minutos. Debe ser menor que Retry Time for Failed Connections.
Enable Throttling for Full Data Migration
Establezca QPS to the source database, RPS of Full Data Migration y Data migration speed (MB/s) para reducir la carga durante la sincronización completa. Solo se muestra si se selecciona Full Data Synchronization.
Enable Throttling for Incremental Data Synchronization
Establezca RPS of Incremental Data Synchronization y Data synchronization speed (MB/s) para reducir la carga durante la sincronización incremental.
Environment Tag
Opcional. Seleccione una etiqueta para identificar la instancia de DTS.
Monitoring and Alerting
Seleccione Yes para recibir alertas cuando la tarea falle o la latencia supere un umbral. Configure el umbral de alerta y la configuración de notificaciones. Consulte Configuración de monitoreo y alertas.
Haga clic en Next Step: Data Verification para configurar la verificación de datos. Consulte Configuración de una tarea de verificación de datos.
-
Guarde la tarea y ejecute una comprobación previa.
Para previsualizar los parámetros de la API: pase el cursor sobre Next: Save Task Settings and Precheck y haga clic en Preview OpenAPI parameters.
Haga clic en Next: Save Task Settings and Precheck para continuar.
La comprobación previa debe aprobarse antes de iniciar la tarea.
Si la comprobación previa falla: haga clic en View Details junto a cada elemento fallido, corrija los problemas y vuelva a ejecutar la comprobación.
-
Si se activa una alerta:
Para alertas que no se pueden ignorar: haga clic en View Details, corrija el problema y vuelva a ejecutar la comprobación previa.
Para alertas que se pueden ignorar: haga clic en Confirm Alert Details > Ignore > OK, y luego haga clic en Precheck Again.
Espere hasta que la success rate alcance el 100%, y luego haga clic en Back.
Paso 4: Configuración de la tarea inversa
Espere hasta que la tarea directa entre en estado Running.
Localice la tarea de sincronización inversa y haga clic en Configure Task.
-
Configure la tarea inversa siguiendo los pasos 3 al 9 anteriores, intercambiando las bases de datos de origen y destino:
Base de datos de origen [Instancia B]: utilice la instancia que fue destino en la tarea directa.
Base de datos de destino [Instancia A]: utilice la instancia que fue origen en la tarea directa.
Tenga en cuenta lo siguiente:
ImportanteLa Instance Region no se puede modificar para la tarea inversa.
La tarea inversa sincroniza únicamente datos incrementales para los objetos que se sincronizaron en la tarea directa (no se repite la sincronización completa).
El número de parámetros a configurar para la tarea inversa es menor que para la directa. Configure solo los parámetros mostrados en la consola.
Las tablas ya sincronizadas por la tarea directa se excluyen de la comprobación de Processing Mode of Conflicting Tables.
No seleccione los mismos objetos de Selected Objects de la tarea directa para la tarea inversa.
Evite usar la función de asignación de nombres de objetos para la tarea inversa, ya que podría causar inconsistencia de datos.
Una vez que ambas tareas entren en estado Running, la sincronización bidireccional de datos estará activa.