DataWorks Data Map proporciona información detallada sobre el linaje de tablas y API de DataService Studio en sus respectivas páginas de detalles, lo que facilita el rastreo del origen de los datos y la gestión de dependencias. La consola clasifica los recursos de cómputo y los metadatos por tipo, como EMR Hive, Data Lake Formation (DLF) y Data Lake Formation (DLF-Legacy). Esta página explica cómo consultar el linaje para cada tipo.
Table Lineage
Punto de acceso para consulta
En Data Map, busque una tabla y vaya a su página de detalles. Haga clic en la pestaña Lineage Information para consultar los detalles del linaje a nivel de tabla y a nivel de campo. También puede realizar un análisis de impacto para obtener una lista de tablas descendientes, descargar dicha lista como archivo local o enviar notificaciones de cambios por correo electrónico.
Data Map muestra el linaje interpretado a partir de trabajos de programación e información de reenvío de datos. No se incluye el linaje generado por operaciones manuales, como consultas temporales. El linaje de datos sin conexión se actualiza con base T+1.
Para visualizar un linaje complejo y multinivel en un área más amplia, haga clic en el botón Open in New Page (el ícono de pantalla completa) situado en la barra de herramientas superior derecha del gráfico de linaje. Esto abre el linaje en una página independiente. Este botón está disponible en las pestañas de linaje correspondientes a tablas, conjuntos de datos, API de DataService Studio y activos de IA.
Si la función de linaje de datos no está habilitada para su espacio de trabajo o inquilino, aparecerá una página de suscripción al navegar a la pestaña de linaje. Siga las instrucciones en pantalla para adquirir o habilitar la función.
Límites por fuente de datos
EMR Hive, DLF y DLF-Legacy
EMR Hive: Para gestionar metadatos de un clúster EMR en DataWorks, primero debe configurar EMR-HOOK en el clúster. Si no se configura EMR-HOOK, no será posible mostrar el linaje en DataWorks. Para más información, consulte Configure EMR-HOOK for Hive.
-
DLF y DLF-Legacy: En el caso de tablas en Data Lake Formation (DLF) y Data Lake Formation (DLF-Legacy), el linaje se muestra en Data Map tras la recopilación de metadatos. Esto es compatible cuando los trabajos de cómputo utilizan metadatos de DLF con el motor Serverless Spark, Serverless StarRocks o Serverless Flink. Para otros motores o escenarios, la visualización del linaje depende de las capacidades de adquisición e interpretación de metadatos. Para más información, consulte Metadata acquisition.
ImportanteLos motores Serverless Spark, Serverless StarRocks y Serverless Flink deben estar asociados a un espacio de trabajo de DataWorks. De lo contrario, el linaje correspondiente se considera irrelevante para DataWorks y se omite.
Para clústeres de cómputo EMR Hive: La consulta de linaje no es compatible con clústeres EMR on ACK Spark, pero sí con clústeres EMR Serverless Spark.
Para clústeres de cómputo EMR Hive: El linaje no está disponible para tareas ejecutadas en nodos EMR Presto.
-
Motor EMR Impala: La adquisición de linaje para trabajos de EMR Impala depende de los propios registros de linaje de Impala. En la consola del clúster EMR, vaya a Cluster Services > Impala > Configuration. Establezca el parámetro
lineage_event_log_diren/mnt/disk1/log/impala/lineage_logy reinicie el servicio Impala. Tras completar estos pasos, DataWorks Data Map podrá mostrar el linaje a nivel de tabla y de campo para trabajos de EMR Impala.NotaSolo son compatibles los trabajos de Impala en clústeres EMR DataLake. Se admiten tanto los metadatos HMS (correspondientes al tipo de fuente de datos EMR Hive) como DLF (correspondientes al tipo de fuente de datos DLF).
No existen requisitos específicos sobre la versión del clúster EMR ni la versión de Impala. Solo es necesario que Impala esté desplegado en el clúster.
Esta función se encuentra actualmente en versión preliminar. Antes de utilizarla, envíe un ticket o póngase en contacto con el soporte técnico de Alibaba Cloud para habilitarla.
AnalyticDB for MySQL
Ejecute la sentencia SQL
set adb_config RC_LINEAGE_INFO_LOG_ENABLE=trueen el motor correspondiente para habilitar la función de linaje de datos en la instancia de AnalyticDB for MySQL.Cuando la fuente de metadatos es del tipo AnalyticDB for Spark, se admite la recopilación automática.
Si la fuente de metadatos es del tipo AnalyticDB for Spark, puede habilitar el linaje en tiempo real mediante la configuración del parámetro de Spark
spark.sql.queryExecutionListeners = com.aliyun.dataworks.meta.lineage.LineageListener.
En tablas del tipo AnalyticDB for MySQL, algunos comandos de procesamiento SQL no permiten generar información de linaje en Data Map. Se aplican los siguientes límites.
-
Comandos SQL que no admiten la visualización de linaje:
SQL no compatible
Ejemplo
No se admiten
join,unionni el uso de palabras clave como*.Por ejemplo, el siguiente SQL utiliza
*, por lo que Data Map no puede mostrar el linaje.INSERT INTO test SELECT * FROM test1, test2 WHERE test1.id = test2.idNo se admiten subconsultas.
Por ejemplo, el siguiente SQL contiene una subconsulta, por lo que Data Map no puede mostrar el linaje.
SELECT column1, column2 FROM table1 WHERE column3 IN (SELECT column4 FROM table2 WHERE column5 = 'value') -
Ejemplos de comandos SQL que sí admiten la visualización de linaje:
-
Ejemplo 1: Crear una tabla llamada A (sin especificar columnas) y seleccionar columnas específicas (excluyendo *) de la tabla B como contenido de la tabla A. Por ejemplo:
CREATE TABLE test AS SELECT id,name FROM test1; -
Ejemplo 2: Insertar columnas específicas (excluyendo *) de la tabla A que cumplan la condición column1 = value1 en la tabla B (sin especificar columnas). Por ejemplo:
INSERT INTO test SELECT id,name FROM test1 WHERE name='test'; -
Ejemplo 3: Sobrescribir columnas específicas (excluyendo *) de la tabla A en la tabla B dentro de una base de datos. Por ejemplo:
INSERT OVERWRITE INTO db_name.test SELECT id,name FROM test1;
-
CDH
Para mostrar el linaje de tablas en el procesamiento de datos mediante CDH Spark SQL y nodos CDH Spark dentro de Data Map, configure los parámetros de Spark para cada módulo de procesamiento de datos en .
-
Inicie sesión en la consola de DataWorks. En la región objetivo, haga clic en en el panel de navegación izquierdo. Seleccione un espacio de trabajo en la lista desplegable y haga clic en Go to Management Center.
En el panel de navegación izquierdo, haga clic en Cluster Management y localice el clúster CDH objetivo que ha creado.
-
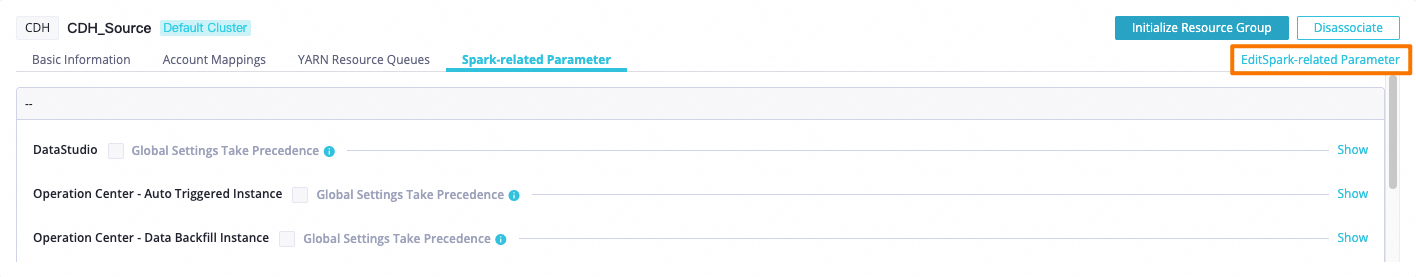
Haga clic en Edit Spark Parameters.
-
Agregue parámetros de Spark según el módulo específico de procesamiento de datos.
Por ejemplo, para mostrar el linaje de tablas en el procesamiento de datos mediante nodos CDH Spark SQL y CDH Spark dentro del módulo Operation Center - Scheduled Instances en Data Map, agregue los siguientes parámetros en el módulo correspondiente:
Spark Property Name:
spark.sql.queryExecutionListeners.Spark Property Value:
com.aliyun.dataworks.meta.lineage.LineageListener.
Haga clic en Confirm para finalizar la edición.
Lindorm
La recopilación de información de linaje solo es compatible en modo instancia. El modo de cadena de conexión no admite la recopilación de información de linaje.
Para mostrar el linaje de tablas en el procesamiento de datos mediante nodos Lindorm Spark y Lindorm Spark SQL dentro de Data Map, configure los parámetros de Spark para cada módulo de procesamiento de datos en .
-
Inicie sesión en la consola de DataWorks. En la región objetivo, haga clic en en el panel de navegación izquierdo. Seleccione un espacio de trabajo en la lista desplegable y haga clic en Go to Management Center.
En el panel de navegación izquierdo, haga clic en Computing Resources y localice el recurso de cómputo Lindorm que ha creado.
Haga clic en Edit Spark Parameters.
-
Agregue parámetros de Spark según el módulo específico de procesamiento de datos.
Por ejemplo, para mostrar el linaje de tablas en el procesamiento de datos mediante nodos Lindorm Spark y Lindorm Spark SQL dentro del módulo Operation Center - Scheduled Instances en Data Map, agregue los siguientes parámetros en el módulo correspondiente:
Spark Property Name:
spark.sql.queryExecutionListeners.Spark Property Value:
com.aliyun.dataworks.meta.lineage.LineageListener.
Haga clic en Confirm para finalizar la configuración de parámetros de Spark.
Compatibilidad con linaje por origen de datos
La categoría original E-MapReduce en Data Map se dividió en EMR Hive, DLF y DLF-Legacy según los orígenes de metadatos. A continuación se muestra la tabla que lista la compatibilidad con linaje por categoría de origen de datos, tal como aparece en la consola actual.
Data source | Data Integration | Data Studio | ||
Table-level lineage | Column-level lineage | Table-level lineage | Column-level lineage | |
AnalyticDB MySQL
|
|
|
|
|
AnalyticDB PostgreSQL
|
|
|
|
|
ClickHouse
|
|
|
|
|
CDH/CDP
|
|
| Hive, Impala, Spark, Spark SQL
| Hive, Impala, Spark, Spark SQL
|
EMR Hive
|
(OSS, Hive)
|
(OSS, Hive)
| Motores compatibles: E-MapReduce, Serverless Spark, Serverless StarRocks, Serverless Flink y EMR Impala (solo clústeres EMR DataLake; actualmente en versión gris; contacte al soporte técnico de Alibaba Cloud para habilitarlo antes de usarlo).
| Motores compatibles: E-MapReduce, Serverless Spark, Serverless StarRocks, Serverless Flink y EMR Impala (solo clústeres EMR DataLake; actualmente en versión gris; contacte al soporte técnico de Alibaba Cloud para habilitarlo antes de usarlo).
|
DLF-Legacy
|
(OSS, Hive)
|
(OSS, Hive)
| Motores compatibles: E-MapReduce, Serverless Spark, Serverless StarRocks, Serverless Flink y EMR Impala (solo clústeres EMR DataLake; actualmente en versión gris; contacte al soporte técnico de Alibaba Cloud para habilitarlo antes de usarlo).
| Motores compatibles: E-MapReduce, Serverless Spark, Serverless StarRocks, Serverless Flink y EMR Impala (solo clústeres EMR DataLake; actualmente en versión gris; contacte al soporte técnico de Alibaba Cloud para habilitarlo antes de usarlo).
|
DLF
|
(OSS, Hive)
|
(OSS, Hive)
| Motores compatibles: Serverless Spark, Serverless StarRocks, Serverless Flink y EMR Impala (solo clústeres EMR DataLake; actualmente en versión gris; contacte al soporte técnico de Alibaba Cloud para habilitarlo antes de usarlo).
| Motores compatibles: Serverless Spark, Serverless StarRocks, Serverless Flink y EMR Impala (solo clústeres EMR DataLake; actualmente en versión gris; contacte al soporte técnico de Alibaba Cloud para habilitarlo antes de usarlo).
|
Hologres
|
|
|
|
|
Kafka
|
(Kafka synchronized to MaxCompute/Hologres) |
|
|
|
Lindorm
|
|
|
|
|
MaxCompute
|
|
|
|
|
MySQL
|
(MySQL synchronized to MaxCompute/Hologres) |
|
|
|
Oracle
|
|
|
|
|
OceanBase
|
|
|
|
|
OSS
|
|
|
|
|
PolarDB MySQL
|
|
|
|
|
PolarDB PostgreSQL
|
|
|
|
|
PostgreSQL
|
|
|
|
|
StarRocks
|
|
|
|
|
SelectDB
|
|
|
|
|
SQL Server
|
|
|
|
|
Tablestore (OTS)
|
|
|
|
|
 Details page
 Real-time synchronization
Linaje de API de DataService Studio
Localice una API de DataService Studio en Data Map y vaya a su página de detalles. Haga clic en la pestaña Lineage Information para consultar los detalles del linaje de la API.
Linaje de activos de IA
El linaje de activos de IA rastrea los conjuntos de datos de entrada, los conjuntos de resultados de salida y las relaciones entre los modelos utilizados durante el entrenamiento. Para obtener más información, consulte AI asset lineage.