Tablestore es un servicio de almacenamiento NoSQL basado en Apsara Distributed File System de Alibaba Cloud. El origen de datos de Tablestore en DataWorks permite la sincronización bidireccional de datos con tablas de Tablestore.
Limitaciones
-
Los complementos Tablestore Reader y Writer leen y escriben datos en Tablestore. Estos complementos operan sobre tablas de columna ancha y series temporales en dos modos: row mode y column mode.
column mode: En el modelo de múltiples versiones de Tablestore, los datos se organizan en una estructura de tres niveles: . Una fila puede tener cualquier cantidad de columnas y los nombres de estas no son fijos. Cada columna admite varias versiones, y cada versión cuenta con una marca de tiempo específica que también funciona como número de versión. En column mode, los datos se exportan como una cuádrupla: (valor de clave primaria, nombre de columna, marca de tiempo, valor de columna). La importación de datos en este modo también utiliza el formato de cuádrupla: (valor de clave primaria, nombre de columna, marca de tiempo, valor de columna).
-
row mode: Este modo exporta cada registro actualizado como una fila con el formato (valor de clave primaria, valores de columna).
En row mode, cada fila de datos corresponde a una sola fila en la tabla de Tablestore. Los datos escritos en este modo incluyen valores tanto para las columnas de clave primaria como para las columnas de atributos.
Las columnas de Tablestore se componen de columnas de clave primaria primaryKey y columnas de atributos column. El orden de las columnas de origen debe coincidir con el orden de las columnas de clave primaria y de atributos en la instancia de Tablestore de destino; de lo contrario, se producirá un error de asignación de columnas.
Tablestore Reader divide el rango de datos de una tabla en N tareas según el nivel de concurrencia especificado (N). Un hilo dedicado de Tablestore Reader ejecuta cada tarea.
-
Las tablas externas de MaxCompute no pueden leer directamente columnas de Tablestore que contengan tipos de datos mixtos; por ejemplo, una columna con valores STRING y DOUBLE simultáneamente. Si su tabla de Tablestore incluye este tipo de columnas, la importación mediante una tabla externa de MaxCompute fallará. Como alternativa, utilice la función de sincronización por lotes de tabla única en DataWorks Data Integration para sincronizar datos de Tablestore hacia MaxCompute.
Al utilizar la sincronización por lotes de tabla única, el resource group de Data Integration requiere acceso de red a la VPC donde reside la instancia de Tablestore para poder leer los datos y ejecutar la tarea de sincronización. Esta solución no garantiza compatibilidad total para datos de tipos mixtos, por lo que podría ser necesario convertir o filtrar los tipos de datos mediante la asignación de columnas durante la sincronización. El uso de un resource group de Data Integration genera costos adicionales.
Tipos de columna compatibles
Tablestore Reader y Tablestore Writer admiten todos los tipos de datos de Tablestore. La siguiente tabla muestra las asignaciones de tipos compatibles.
|
Categoría de tipo |
Tipo de dato de Tablestore |
|
Entero |
INTEGER |
|
Punto flotante |
DOUBLE |
|
Cadena |
STRING |
|
Booleano |
BOOLEAN |
|
Binario |
BINARY |
Tablestore no admite de forma nativa el tipo de dato de fecha. Por lo general, la capa de aplicación utiliza un valor Long para almacenar la marca de tiempo Unix.
En modo script, configure el tipo de dato INTEGER como INT. DataWorks lo convierte automáticamente al tipo INTEGER. Si configura el tipo directamente como INTEGER, se registrará un error en los registros y la tarea fallará.
Agregar un origen de datos
Antes de desarrollar una tarea de sincronización en DataWorks, agregue el origen de datos correspondiente siguiendo las instrucciones en Data source configuration. Consulte las descripciones de parámetros en la consola de DataWorks para comprender el significado de cada parámetro al agregar un origen de datos.
Desarrollar una tarea de sincronización de datos
Para obtener información sobre el punto de entrada y el procedimiento para configurar una tarea de sincronización, consulte las siguientes guías de configuración.
Lineamientos para configurar una tarea de sincronización por lotes de tabla única
Para consultar el procedimiento, véase Configure a single-table batch synchronization task.
Para revisar la lista completa de parámetros y ejemplos de scripts para la configuración en modo script, consulte Appendix 1: Reader script demos and parameter description a continuación.
Apéndice 1: Ejemplos de scripts del lector y descripción de parámetros
Configurar una tarea de sincronización por lotes mediante el editor de código
Si desea configurar una tarea de sincronización por lotes mediante el editor de código, debe establecer los parámetros correspondientes en el script según los requisitos unificados de formato. Para obtener más información, consulte Script mode configuration. A continuación se describen los parámetros que debe configurar para los orígenes de datos al utilizar el editor de código en una tarea de sincronización por lotes.
Ejemplos de scripts del lector
Configuración en modo fila para leer tablas de columna ancha
{ "type":"job", "version":"2.0",// The version number. "steps":[ { "stepType":"ots",// The plugin name. "parameter":{ "datasource":"",// The data source. "newVersion":"true",// Use the new version of otsreader. "mode": "normal",// Read data in row mode. "isTimeseriesTable":"false",// Configure this table as a wide-column table (not a time-series table). "column":[// The columns. { "name":"column1"// The column name. }, { "name":"column2" }, { "name":"column3" }, { "name":"column4" }, { "name":"column5" } ], "range":{ "split":[ { "type":"STRING", "value":"beginValue" }, { "type":"STRING", "value":"splitPoint1" }, { "type":"STRING", "value":"splitPoint2" }, { "type":"STRING", "value":"splitPoint3" }, { "type":"STRING", "value":"endValue" } ], "end":[ { "type":"STRING", "value":"endValue" }, { "type":"INT", "value":"100" }, { "type":"INF_MAX" }, { "type":"INF_MAX" } ], "begin":[ { "type":"STRING", "value":"beginValue" }, { "type":"INT", "value":"0" }, { "type":"INF_MIN" }, { "type":"INF_MIN" } ] }, "table":""// The table name. }, "name":"Reader", "category":"reader" }, { "stepType":"stream", "parameter":{}, "name":"Writer", "category":"writer" } ], "setting":{ "errorLimit":{ "record":"0"// The error count. }, "speed":{ "throttle":true,// false indicates that throttling is disabled and the throttling speed below does not take effect. true indicates that throttling is enabled. "concurrent":1 // The concurrency. "mbps":"12"// The throttling speed. } }, "order":{ "hops":[ { "from":"Reader", "to":"Writer" } ] } }
Configuración en modo fila para leer tablas de series temporales
{ "type":"job", "version":"2.0",// The version number. "steps":[ { "stepType":"ots",// The plugin name. "parameter":{ "datasource":"",// The data source. "table": "",// The table name. // mode must be set to normal for reading time-series data. "mode": "normal", // newVersion must be set to true for reading time-series data. "newVersion": "true", // Configure this table as a time-series table. "isTimeseriesTable":"true", // measurementName: The measurement name of the time-series data to read. This parameter is optional. If left empty, data from the entire table is read. "measurementName":"measurement_1", "column": [ { "name": "_m_name" }, { "name": "tagA", "is_timeseries_tag":"true" }, { "name": "double_0", "type":"DOUBLE" }, { "name": "string_0", "type":"STRING" }, { "name": "long_0", "type":"INT" }, { "name": "binary_0", "type":"BINARY" }, { "name": "bool_0", "type":"BOOL" }, { "type":"STRING", "value":"testString" } ] }, "name":"Reader", "category":"reader" }, { "stepType":"stream", "parameter":{}, "name":"Writer", "category":"writer" } ], "setting":{ "errorLimit":{ "record":"0"// The error count. }, "speed":{ "throttle":true,// false indicates that throttling is disabled and the throttling speed below does not take effect. true indicates that throttling is enabled. "concurrent":1 // The concurrency. "mbps":"12"// The throttling speed. } }, "order":{ "hops":[ { "from":"Reader", "to":"Writer" } ] } }
Configuración en modo columna para leer tablas de columna ancha
{ "type":"job", "version":"2.0",// The version number. "steps":[ { "stepType":"ots",// The plugin name. "parameter":{ "datasource":"",// The data source. "table":"",// The table name. "newVersion":"true",// The new version of otsreader. "mode": "multiversion",// The multi-version mode. "column":[// Configure the column names to export (must be non-primary key columns). {"name":"mobile"}, {"name":"name"}, {"name":"age"}, {"name":"salary"}, {"name":"marry"} ], "range":{// The export range. "begin":[ {"type":"INF_MIN"}, {"type":"INF_MAX"} ], "end":[ {"type":"INF_MAX"}, {"type":"INF_MIN"} ], "split":[ ] }, }, "name":"Reader", "category":"reader" }, { "stepType":"stream", "parameter":{}, "name":"Writer", "category":"writer" } ], "setting":{ "errorLimit":{ "record":"0"// The error count. }, "speed":{ "throttle":true,// false indicates that throttling is disabled and the throttling speed below does not take effect. true indicates that throttling is enabled. "concurrent":1 // The concurrency. "mbps":"12"// The throttling speed. } }, "order":{ "hops":[ { "from":"Reader", "to":"Writer" } ] } }
Parámetros comunes del script del lector
|
Parámetro |
Descripción |
Obligatorio |
Valor predeterminado |
|
endpoint |
El endpoint (dirección del servicio) del servidor de Tablestore. Para obtener más información, consulte Endpoints. |
Sí |
N/A |
|
accessId |
El AccessKey ID de la instancia de Tablestore. |
Sí |
N/A |
|
accessKey |
El AccessKey Secret de la instancia de Tablestore. |
Sí |
N/A |
|
instanceName |
El nombre de la instancia de Tablestore. Una instancia es la entidad que se utiliza para gestionar el servicio Tablestore. Después de activar el servicio Tablestore, debe crear una instancia en la consola y posteriormente crear y gestionar las tablas dentro de dicha instancia. La instancia constituye la unidad básica para la gestión de recursos de Tablestore. El servicio aplica el control de acceso y la medición de recursos a nivel de instancia. |
Sí |
N/A |
|
table |
El nombre de la tabla de la cual extraer datos. Solo puede especificar una tabla, ya que Tablestore no admite la sincronización de varias tablas. |
Sí |
N/A |
|
newVersion |
Especifica la versión del plugin Tablestore Reader.
La nueva versión de Tablestore Reader no solo incluye funciones adicionales, sino que también reduce la sobrecarga de recursos del sistema. Se recomienda utilizar esta versión actualizada. El plugin de la nueva versión mantiene compatibilidad retroactiva con la configuración de la versión anterior. Puede agregar la configuración newVersion=true a las tareas existentes y estas se ejecutarán correctamente. |
No |
false |
|
mode |
Define el modo de lectura de datos. Se admiten dos modos:
Este parámetro solo surte efecto cuando se utiliza la nueva versión de Tablestore Reader (newVersion:true). La versión heredada de Tablestore Reader ignora el parámetro mode y solo permite la lectura en modo fila. |
No |
normal |
|
isTimeseriesTable |
Indica si la tabla de datos corresponde a una tabla de series temporales:
Este parámetro solo tiene efecto cuando se configura newVersion:true & mode:normal. La versión heredada de Tablestore Reader no es compatible con tablas de series temporales, y estas no pueden leerse en modo columna. |
No |
false |
Parámetros adicionales del script del lector
Tablestore Reader permite leer tablas de columna ancha en modo fila, tablas de series temporales en modo fila y tablas de columna ancha en modo columna. Cada modo cuenta con sus propios parámetros adicionales.
Parámetros del modo fila para leer tablas de columna ancha
|
Parámetro |
Descripción |
Obligatorio |
Valor predeterminado |
|
column |
Conjunto de nombres de columnas que se sincronizarán desde la tabla configurada, descrito mediante un arreglo JSON. Dado que Tablestore es un sistema NoSQL, es necesario especificar los nombres de las columnas durante la extracción de datos por parte de Tablestore Reader.
|
Sí |
N/A |
|
begin y end |
Los parámetros begin y end definen el intervalo de datos que se extraerá de la tabla de Tablestore. begin y end describen la distribución de intervalos de la PrimaryKey de Tablestore. Para intervalos infinitos, puede emplear Nota
Por ejemplo, para extraer datos de una tabla de Tablestore con tres columnas de clave principal
|
No |
(INF_MIN, INF_MAX) |
|
split |
Se trata de un parámetro de configuración avanzada que le permite definir divisiones personalizadas. No se recomienda su uso en escenarios generales. Al configurar el parámetro split, puede establecer rangos de datos personalizados para la fragmentación. Esto suele aplicarse cuando surgen puntos críticos (hotspots) en el almacenamiento de datos de Tablestore. A continuación se muestra un ejemplo de configuración de tarea: Durante la ejecución, los datos se dividen en 6 segmentos que se leen de forma concurrente. Se recomienda que la cantidad de segmentos sea mayor que la concurrencia de la tarea. |
No |
Si no se configura el parámetro split, se aplica la lógica de división automática. Dicha lógica identifica los valores máximo y mínimo de la Partition Key y realiza una segmentación uniforme. La Partition Key admite tipos enteros y de cadena. Las claves enteras utilizan división entera para la segmentación, mientras que las claves de cadena emplean el código Unicode del primer carácter. |
Parámetros del modo fila para leer tablas de series temporales
|
Parámetro |
Descripción |
Obligatorio |
Valor predeterminado |
|
column |
column es un arreglo donde cada elemento representa una columna. Puede configurar tanto columnas constantes como regulares. Para las columnas constantes, configure los siguientes campos:
Para las columnas regulares, configure los siguientes campos:
Ejemplo de script para leer cuatro columnas: |
Sí |
N/A |
|
measurementName |
Nombre de la medición de la serie temporal que se va a leer. Si no se configura este parámetro, se leerán los datos de toda la tabla. |
No |
N/A |
|
timeRange |
Intervalo de tiempo de los datos a leer. Corresponde a [begin, end), un intervalo cerrado a la izquierda y abierto a la derecha, donde begin debe ser menor que end. La unidad de la marca de tiempo es microsegundos. El formato es el siguiente: |
No |
Todas las versiones |
Parámetros del modo columna para leer tablas de columna ancha
|
Parámetro |
Descripción |
Obligatorio |
Valor predeterminado |
|
column |
Especifica las columnas a exportar. En modo columna solo se admiten columnas regulares. Formato: Nota
|
Sí |
Todas las columnas |
|
range |
Rango de datos a leer. Corresponde a [begin, end), un intervalo cerrado a la izquierda y abierto a la derecha, donde:
El campo type admite los siguientes tipos:
Formato: |
No |
Todos los datos |
|
timeRange |
Intervalo de tiempo de los datos a leer. Corresponde a [begin, end), un intervalo cerrado a la izquierda y abierto a la derecha, donde begin debe ser menor que end. La unidad de la marca de tiempo es microsegundos. Formato: |
No |
Todas las versiones |
|
maxVersion |
Número máximo de versiones de datos a solicitar. El rango de valores válidos va de 1 a INT32_MAX. |
No |
Todas las versiones |
Apéndice 2: Ejemplos de scripts de Writer y descripción de parámetros
Configurar una tarea de sincronización por lotes mediante el editor de código
Si desea configurar una tarea de sincronización por lotes mediante el editor de código, debe configurar los parámetros correspondientes en el script según los requisitos unificados de formato de script. Para obtener más información, consulte Script mode configuration. A continuación se describen los parámetros que debe configurar para los orígenes de datos al utilizar el editor de código para tareas de sincronización por lotes.
Ejemplos de scripts de Writer
Configuración en modo fila para escritura en tablas de columna ancha
{ "type":"job", "version":"2.0",// The version number. "steps":[ { "stepType":"stream", "parameter":{}, "name":"Reader", "category":"reader" }, { "stepType":"ots",// The plugin name. "parameter":{ "datasource":"",// The data source. "table":"",// The table name. "newVersion":"true",// Use the new version of otswriter. "mode": "normal",// Write data in row mode. "isTimeseriesTable":"false",// Configure this table as a wide-column table (not a time-series table). "primaryKey" : [// The primary key information of the Tablestore table. {"name":"gid", "type":"INT"}, {"name":"uid", "type":"STRING"} ], "column" : [// The columns. {"name":"col1", "type":"INT"}, {"name":"col2", "type":"DOUBLE"}, {"name":"col3", "type":"STRING"}, {"name":"col4", "type":"STRING"}, {"name":"col5", "type":"BOOL"} ], "writeMode" : "PutRow" // The write mode. }, "name":"Writer", "category":"writer" } ], "setting":{ "errorLimit":{ "record":"0"// The error count. }, "speed":{ "throttle":true,// When throttle is set to false, the mbps parameter does not take effect, indicating no throttling. When throttle is set to true, throttling is enabled. "concurrent":1, // The concurrency. "mbps":"12"// The throttling speed. 1 mbps = 1 MB/s. } }, "order":{ "hops":[ { "from":"Reader", "to":"Writer" } ] } }
Configuración en modo fila para escritura en tablas de series temporales
{ "type":"job", "version":"2.0",// The version number. "steps":[ { "stepType":"stream", "parameter":{}, "name":"Reader", "category":"reader" }, { "stepType":"ots",// The plugin name. "parameter":{ "datasource":"",// The data source. "table": "testTimeseriesTableName01", "mode": "normal", "newVersion": "true", "isTimeseriesTable":"true", "timeunit":"microseconds", "column": [ { "name": "_m_name" }, { "name": "_data_source", }, { "name": "_tags", }, { "name": "_time", }, { "name": "string_1", "type":"string" }, { "name":"tag3", "is_timeseries_tag":"true", } ] }, "name":"Writer", "category":"writer" } ], "setting":{ "errorLimit":{ "record":"0"// The error count. }, "speed":{ "throttle":true,// When throttle is set to false, the mbps parameter does not take effect, indicating no throttling. When throttle is set to true, throttling is enabled. "concurrent":1, // The concurrency. "mbps":"12"// The throttling speed. 1 mbps = 1 MB/s. } }, "order":{ "hops":[ { "from":"Reader", "to":"Writer" } ] } }
Configuración en modo columna para escritura en tablas de columna ancha
{ "type":"job", "version":"2.0",// The version number. "steps":[ { "stepType":"stream", "parameter":{}, "name":"Reader", "category":"reader" }, { "stepType":"ots",// The plugin name. "parameter":{ "datasource":"",// The data source. "table":"", "newVersion":"true", "mode":"multiVersion", "primaryKey" : [ "gid", "uid" ] }, "name":"Writer", "category":"writer" } ], "setting":{ "errorLimit":{ "record":"0"// The error count. },x` "speed":{ "throttle":true,// When throttle is set to false, the mbps parameter does not take effect, indicating no throttling. When throttle is set to true, throttling is enabled. "concurrent":1, // The concurrency. "mbps":"12"// The throttling speed. 1 mbps = 1 MB/s. } }, "order":{ "hops":[ { "from":"Reader", "to":"Writer" } ] } }
Parámetros comunes del script de Writer
|
Parámetro |
Descripción |
Obligatorio |
Valor predeterminado |
|
datasource |
Nombre del origen de datos. El modo script permite agregar orígenes de datos. El valor de este parámetro debe coincidir con el nombre del origen de datos agregado. |
Sí |
N/A |
|
endPoint |
Endpoint (dirección del servicio) del servidor de Tablestore. Para obtener más información, consulte Endpoints. |
Sí |
N/A |
|
accessId |
AccessKey ID de la instancia de Tablestore. |
Sí |
N/A |
|
accessKey |
AccessKey Secret de la instancia de Tablestore. |
Sí |
N/A |
|
instanceName |
Nombre de la instancia de Tablestore. Una instancia es la entidad que se utiliza para gestionar el servicio Tablestore. Después de activar el servicio Tablestore, debe crear una instancia en la consola y luego crear y gestionar tablas dentro de dicha instancia. La instancia es la unidad básica para la gestión de recursos de Tablestore. Tablestore aplica el control de acceso y la medición de recursos a nivel de instancia. |
Sí |
N/A |
|
table |
Nombre de la tabla donde se escribirán los datos. Solo puede especificar una tabla. Tablestore no admite la sincronización de múltiples tablas. |
Sí |
N/A |
|
newVersion |
Especifica la versión del plugin Tablestore Writer.
La nueva versión de Tablestore Writer no solo incluye nuevas funciones, sino que también reduce la sobrecarga de recursos del sistema. Se recomienda utilizar esta versión actualizada. El plugin de la nueva versión mantiene la compatibilidad con la configuración de la versión anterior. Puede agregar la configuración newVersion=true a las tareas existentes y estas se ejecutarán correctamente. |
Sí |
false |
|
mode |
Especifica el modo de escritura de datos. Se admiten dos modos:
Este parámetro solo surte efecto cuando se configura newVersion:true. La versión anterior de Tablestore Writer ignora el parámetro mode y solo admite escritura en modo fila. |
No |
normal |
|
isTimeseriesTable |
Especifica si la tabla de datos es una tabla de series temporales.
Este parámetro solo surte efecto cuando se configura newVersion:true & mode:normal (el modo columna no es compatible con tablas de series temporales). |
No |
false |
Parámetros adicionales del script de Writer
Tablestore Writer admite la escritura en tablas de columna ancha en modo fila, en tablas de series temporales en modo fila y en tablas de columna ancha en modo columna. Cada modo cuenta con sus propios parámetros adicionales.
Parámetros del modo fila para escritura en tablas de columna ancha
|
Parámetro |
Descripción |
Obligatorio |
Valor predeterminado |
|
primaryKey |
Información de la clave principal de la tabla de Tablestore, descrita mediante un array JSON. Dado que Tablestore es un sistema NoSQL, debe especificar los nombres de las columnas durante la importación de datos mediante Tablestore Writer. El sistema de sincronización de datos admite conversión de tipos, por lo que Tablestore Writer realiza la conversión de tipos de datos para los datos de origen que no son STRING o INT. Ejemplo de configuración: Nota
PrimaryKey de Tablestore solo admite los tipos STRING e INT. Por lo tanto, Tablestore Writer únicamente acepta estos dos tipos. |
Sí |
N/A |
|
column |
Conjunto de nombres de columnas que se sincronizarán desde la tabla configurada, descrito mediante un array JSON. Ejemplo de configuración: El campo name especifica el nombre de la columna de Tablestore donde se escribirá, mientras que el campo type indica el tipo de dato a escribir. Tablestore admite los tipos STRING, INT, DOUBLE, BOOL y BINARY. Nota
No se admiten constantes, funciones ni expresiones personalizadas durante la escritura. |
Sí |
N/A |
|
writeMode |
Modo para escribir datos en Tablestore. Se admiten los siguientes dos modos:
|
Sí |
N/A |
|
enableAutoIncrement |
Especifica si se permite escribir datos en una tabla de Tablestore que contiene columnas de clave principal de incremento automático.
|
No |
false |
|
requestTotalSizeLimitation |
Este parámetro limita el tamaño de una sola fila de datos al escribir en Tablestore. El tipo de configuración es numérico. |
No |
1MB |
|
attributeColumnSizeLimitation |
Este parámetro limita el tamaño de una sola columna de atributo al escribir en Tablestore. El tipo de configuración es numérico. |
No |
2MB |
|
primaryKeyColumnSizeLimitation |
Este parámetro limita el tamaño de una sola columna de clave principal al escribir en Tablestore. El tipo de configuración es numérico. |
No |
1KB |
|
attributeColumnMaxCount |
Este parámetro limita el número de columnas de atributo al escribir en Tablestore. El tipo de configuración es numérico. |
No |
1,024 |
Parámetros del modo fila para escritura en tablas de series temporales
|
Parámetro |
Descripción |
Obligatorio |
Valor predeterminado |
|
column |
Cada elemento del array de columnas corresponde a un campo en los datos de series temporales. Cada elemento se puede configurar con los siguientes parámetros:
Dado que el nombre de la métrica y la marca de tiempo de los datos de series temporales no pueden estar vacíos, debe configurar los campos Ejemplo: Un registro de datos para escribir contiene seis campos: Utilice la siguiente configuración: |
Sí |
N/A |
|
timeunit |
Unidad del campo de marca de tiempo _time. Valores admitidos: NANOSECONDS, MICROSECONDS, MILLISECONDS, SECONDS y MINUTES. |
No |
MICROSECONDS |
Parámetros del modo columna para escritura en tablas de columna ancha
|
Parámetro |
Descripción |
Obligatorio |
Valor predeterminado |
|
primaryKey |
Columnas de clave principal de la tabla. Para reducir la sobrecarga de configuración, no es necesario especificar la posición de primaryKey en el registro (línea). Sin embargo, el formato del registro debe ser fijo: primaryKey debe ir al inicio de la fila, seguido por primaryKey y luego columnName. El formato del registro es: Por ejemplo, dados los siguientes 9 registros de datos: Resultado de escritura en formato de fila ancha: |
Sí |
N/A |
|
columnNamePrefixFilter |
Filtro de prefijo de nombre de columna. Para los datos importados desde HBase, cf y qulifier forman conjuntamente el columnName. Sin embargo, Tablestore no admite cf, por lo que es necesario filtrar el prefijo cf. Ejemplo de configuración: Nota
|
No |
N/A |
Preguntas frecuentes
-
P: ¿Cómo configuro Tablestore Writer para escribir datos en una tabla de destino que contiene columnas de clave principal de incremento automático?
-
La configuración de Tablestore Writer debe cumplir con los siguientes dos requisitos:
"newVersion": "true",
"enableAutoIncrement": "true",
No configure el nombre de la columna de clave principal de incremento automático en Tablestore Writer.
La suma de las entradas primaryKey y las entradas column configuradas en Tablestore Writer debe ser igual al número de columnas en los datos del Tablestore Reader ascendente.
-
-
P: En la configuración del modelo de series temporales, ¿cómo debo interpretar los campos
_tagyis_timeseries_tag?Ejemplo: Un registro de datos tiene tres etiquetas: [phone=Xiaomi, RAM=8G, camera=Leica].
-
Ejemplo de exportación de datos (Tablestore Reader)
-
Si desea combinar las etiquetas anteriores en una sola columna para la exportación, utilice la siguiente configuración:
"column": [
      {
        "name": "_tags",
      }
    ],
DataWorks exporta las etiquetas como una sola columna de datos con el siguiente formato:
["phone=xiaomi","camera=LEICA","RAM=8G"] -
Si desea exportar la etiqueta
phoney la etiquetacamera, con cada etiqueta exportada como una columna separada, utilice la siguiente configuración:"column": [ { "name": "phone", "is_timeseries_tag":"true", }, { "name": "camera", "is_timeseries_tag":"true", } ],DataWorks exporta dos columnas de datos con el siguiente formato:
xiaomi, LEICA
-
-
Ejemplo de importación de datos (Tablestore Writer)
El origen de datos ascendente (Reader) tiene dos columnas de datos:
Una columna contiene:
["phone=xiaomi","camera=LEICA","RAM=8G"].La otra columna contiene: 6499.
Para agregar ambas columnas al campo de etiquetas, el formato esperado del campo de etiquetas después de la escritura es el siguiente:
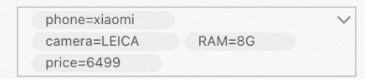 Utilice la siguiente configuración:
"column": [
      {
        "name": "_tags",
      },
      {
        "name": "price",
        "is_timeseries_tag":"true",
      },
    ],
La configuración de la primera columna importa
["phone=xiaomi","camera=LEICA","RAM=8G"]en su totalidad al campo de etiquetas.La configuración de la segunda columna importa
price=6499individualmente al campo de etiquetas.
-