Este tema describe las preguntas frecuentes sobre dependencias.
-
Lo que debe saber antes de configurar dependencias de programación
-
Preguntas frecuentes sobre la configuración de dependencias de programación
Error: The parent node output that the current node depends on does not exist
Why are downstream node name and ID sometimes empty and not editable in the node output section
What are the rules for downstream tasks depending on upstream tasks
Can multiple nodes that write to the same table have the same output name
How to exclude intermediate tables when using auto-parsed dependencies
How to configure the parent node of the topmost node in a workflow
-
Preguntas frecuentes sobre eliminación y modificación de nodos
-
Escenarios para la configuración de dependencias entre ciclos
How does self-dependency on an hourly task affect the task and its downstream nodes
How to configure dependencies when a daily task depends on an hourly task in different scenarios
When a daily task depends on an hourly task, when does the daily task run
How to make a daily task depend on a specific hourly instance instead of all hourly instances
How to make a daily task depend on all of yesterday's hourly instances instead of today's
When to configure the cross-cycle dependency to depend on the current node itself
How to configure dependencies when a downstream node depends on multiple upstream tasks
If an upstream hourly task runs past midnight, will the downstream daily task still run
How to trigger a daily task after the first hourly task instance succeeds each day
-
Escenarios para la configuración de dependencias de programación
-
Otras preguntas frecuentes
Concepto clave
Una dependencia de programación es una relación ascendente-descendente entre nodos. En DataWorks, un nodo de tarea descendente comienza a ejecutarse solo después de que su nodo de tarea ascendente se ejecuta correctamente.
Después de configurar una dependencia, uno de los requisitos previos para que se ejecute el nodo actual es que los nodos principales de los que depende el nodo actual deben ejecutarse correctamente. Para obtener más información sobre las dependencias de programación, consulte Scheduling dependencies.
¿Por qué necesito configurar dependencias de programación?
Al configurar las dependencias de programación, el sistema de programación garantiza que una tarea programada recupere los datos correctos durante la ejecución. Una vez que el nodo ascendente del que depende el nodo actual se ejecuta correctamente, DataWorks identifica que se han generado los datos más recientes en la tabla ascendente según el estado de ejecución del nodo. Posteriormente, el nodo descendente recupera los datos. Esto evita problemas donde el nodo descendente recupera datos antes de que la tabla ascendente haya terminado de generarlos.
¿Cómo configuro las dependencias de programación en DataWorks?
En DataWorks, la salida de un nodo ascendente sirve como entrada de un nodo descendente para formar una dependencia de nodo.
-
Las tareas SQL configuran automáticamente las entradas y salidas de los nodos de las siguientes maneras:
Cuando ejecuta
selectdesde una tabla, el sistema analiza automáticamente el nodo que genera la tabla como la dependencia ascendente del nodo actual.Cuando ejecuta
inserten ocreateuna tabla, el sistema analiza automáticamente la tabla como la salida del nodo actual.
Para las tareas de Data Integration, debe agregar manualmente la tabla de salida con el formato
projectname.tablenamecomo salida del nodo. Esto asegura que la función de análisis automático pueda resolver la dependencia cuando los nodos descendentes procesan la tabla de salida sincronizada.Dado que se requiere una salida única para localizar un nodo único y formar una dependencia de nodo, la salida del nodo (
projectname.tablename) debe ser única.
¿En qué escenarios no son compatibles las dependencias de programación?
Las dependencias de programación en DataWorks están diseñadas principalmente para garantizar que las tablas actualizadas periódicamente por nodos programados tengan sus datos consumidos correctamente por los nodos descendentes. Por lo tanto, la plataforma no puede supervisar las tablas que no son actualizadas por nodos programados de DataWorks.
Si una tabla no se genera mediante programación periódica y un nodo utiliza select para consultar datos de dicha tabla, debe eliminar manualmente la dependencia del nodo ascendente que se generó automáticamente a partir de la instrucción select. Las tablas no generadas por programación periódica incluyen:
Tablas cargadas en DataWorks desde un origen local
Tablas de dimensiones
Tablas no generadas por la programación de DataWorks
Tablas generadas por tareas manuales
¿Cómo elimino las tablas que no requieren dependencias?
Haga clic con el botón derecho en el nombre de la tabla en el código y seleccione Delete Output, luego vuelva a ejecutar el análisis automático. Agregue la anotación --@exclude_input=table_name en la primera línea del editor de código para excluir una dependencia de entrada específica (por ejemplo, --@exclude_input=xc_dw_user_info_all_d). A continuación, haga clic con el botón derecho en el editor y seleccione Delete Output para quitar las dependencias de salida innecesarias. Haga clic en el botón Parse Inputs and Outputs en el panel de configuración de programación a la derecha para volver a analizar las dependencias de programación. En la tabla de dependencias de programación, puede consultar el nombre de salida del nodo principal actual, el origen (agregado manualmente o analizado automáticamente) y otra información. También puede hacer clic en Delete en la columna Actions para eliminar la dependencia correspondiente.
Error de envío: La salida del nodo principal de la que depende el nodo actual no existe
Cuando envía un nodo, el sistema muestra un error que indica que la salida del nodo principal de la que depende el nodo actual no existe. Para conocer las posibles causas y soluciones, consulte Troubleshoot the error that the parent node output does not exist.
Aviso de envío: Las entradas y salidas no coinciden con el análisis de linaje de código
Cuando envía un nodo, el sistema muestra un aviso que indica que las entradas y salidas no coinciden con el análisis de linaje de código. Para conocer las posibles causas y soluciones, consulte Troubleshoot the mismatch between inputs/outputs and code lineage analysis.
¿Por qué un nombre de nodo principal analizado automáticamente reporta que la salida del nodo principal dependiente (tabla) no existe?
Cuando envía un nodo en Data Studio, aparece un error en la parte superior del panel de configuración de dependencias de nodo: The dependent parent node output workshop_yanshi.tb_2 does not exist. You cannot submit this node. Submit the parent node first. Esta dependencia es generada automáticamente por el sistema a partir de la instrucción FROM tb_2 en el código SQL.
Este error no significa que la tabla no exista. Significa que el sistema no puede encontrar un nodo que genere los datos de la tabla para establecer la dependencia de nodo.
Este problema puede ocurrir por las siguientes dos razones:
El nodo ascendente no se ha enviado. Envíelo e inténtelo de nuevo.
El nodo ascendente se ha enviado, pero su nombre de salida no es workshop_yanshi.tb_2.
Si tb_2 es una tabla generada por una tarea de sincronización, agréguela manualmente como salida del nodo con el formato
projectname.tablenameen la sección de salida del nodo de tarea de sincronización que genera la tabla tb_2. Para obtener más información, consulte Configure scheduling dependencies.Si tb_2 es una tabla que no se actualiza diariamente mediante un nodo programado, haga clic con el botón derecho en la tabla dentro del código para eliminar la entrada y, a continuación, vuelva a ejecutar el análisis automático.
Para tablas que no se actualizan diariamente mediante nodos programados, consulte In which scenarios are scheduling dependencies not supported?
¿Por qué algunos nodos tienen nombres e ID de nodos descendentes en la sección de salida del nodo mientras que otros están vacíos y no se pueden editar manualmente?
Las dependencias de nodo se establecen cuando los nodos descendentes hacen referencia a las salidas de los nodos ascendentes. Si el nodo actual no tiene nodos secundarios descendentes, esta sección estará vacía. Después de configurar un nodo secundario descendente de este nodo, el contenido se analiza y se muestra automáticamente.
¿Cómo elimino las dependencias innecesarias?
Haga clic con el botón derecho en la tabla dentro del código y elimine la entrada; luego, seleccione nuevamente el análisis automático para excluir los nodos de dependencia ascendente innecesarios.
Concepto clave
En el sistema de programación de DataWorks, las dependencias ascendentes-descendentes entre nodos se configuran para garantizar una producción y recuperación eficaz de datos. La decisión de configurar una dependencia puede determinarse según si los datos tienen una correlación fuerte. Para obtener más información, consulte Configure scheduling dependencies.
Concepto clave
Un nombre de salida de nodo se utiliza para establecer dependencias entre nodos. Por ejemplo, si el nombre de salida del nodo A es ABC y el nodo B utiliza ABC como su entrada, se establece una relación ascendente-descendente entre el nodo A y el nodo B.
¿Puede un nodo tener varios nombres de salida?
Sí. Una salida de nodo sirve como identificador del nodo actual. Si un nodo descendente necesita depender del nodo actual, puede hacer referencia a cualquier nombre de salida de este nodo como el nombre de salida del nodo principal del nodo descendente para establecer una dependencia.
Si varios nodos escriben datos en la misma tabla, el análisis automático reporta un error indicando que los nombres de salida del nodo son iguales. ¿Pueden los nodos tener el mismo nombre de salida?
No. Los nombres de salida de los nodos, al igual que los nodos y las tablas, deben ser únicos a nivel de inquilino. Esto garantiza que el análisis automático pueda localizar un nodo único basándose en una salida única para establecer la dependencia del nodo. Si en su escenario hay varios nodos que generan datos para la misma tabla, debe determinar de qué nodo debe depender el nodo descendente al analizar automáticamente esta tabla (el nodo que escribe datos en la tabla en último lugar, garantizando la correcta recuperación de datos por parte del nodo descendente). También debe modificar las salidas de los otros nodos para garantizar la unicidad.
Si dos nodos programados en el mismo espacio de trabajo insertan datos en la misma tabla, el análisis automático provocará que uno de los nodos genere el siguiente error: The output name of node ${nodename1} in workspace ${projectname} is the same as that of node ${nodename2} in workspace ${projectname}: ${node_outputname}. Multiple nodes cannot use the same output name.
¿Cómo evito que se analicen las tablas intermedias al usar el análisis automático?
Seleccione el nombre de la tabla intermedia en el código SQL, haga clic con el botón derecho y seleccione Delete Input o Delete Output, y luego vuelva a ejecutar el análisis automático para entradas y salidas.
¿Cómo configuro el nodo principal para el nodo más ascendente en un flujo de trabajo?
Si el nodo es el nodo inicial de un flujo de trabajo, puede agregar un nodo virtual como nodo inicial del flujo de trabajo. El nodo ascendente del nodo virtual se puede establecer en el nodo raíz del espacio de trabajo. Para obtener más información sobre cómo utilizar nodos virtuales, consulte Use virtual nodes.
¿Por qué el nodo A encuentra un nombre de salida inexistente del nodo B al buscar nombres de salida de nodos ascendentes?
El análisis de dependencias se basa en la información de los nodos que ya se han enviado y desplegado. Si elimina un nombre de salida del nodo B después de enviarlo, pero sin enviar el cambio al sistema de programación, el nombre de salida eliminado del nodo B aún se podrá encontrar al buscar desde el nodo A.
¿Por qué el sistema reporta que el nodo actual tiene nodos secundarios y no se puede retirar del despliegue, aunque no se muestre ninguna dependencia en la configuración de programación?
Un nodo solo se puede retirar del despliegue cuando ningún otro nodo depende de él, tanto en el entorno de desarrollo como en el entorno de producción. Puede comprobar esto revisando el Operation Center del entorno de desarrollo y el Operation Center del entorno de producción.
¿Por qué algunas líneas de dependencia aparecen discontinuas en Operation Center?
Las líneas discontinuas indican dependencias entre ciclos. Para obtener más información sobre las dependencias entre ciclos, consulte Cross-cycle dependencies.
Conceptos clave
-
Impacto en el nodo actual: La instancia del siguiente ciclo del nodo ascendente comienza a ejecutarse solo después de que la instancia del ciclo anterior se ejecuta correctamente.
Escenario: Suponga que una tarea horaria está programada a partir de las 00:00. La instancia de las 01:00 debe esperar a que la instancia de las 00:00 se ejecute correctamente antes de poder iniciarse.
Impacto en los nodos descendentes: Suponga que el nodo descendente es una tarea programada diariamente. El nodo diario descendente pasa de depender directamente de varias instancias horarias a depender directamente de una instancia horaria específica del nodo ascendente. Dado que se configura la autodependencia para las instancias horarias, la tarea diaria descendente depende efectivamente de todas las instancias horarias ascendentes de manera indirecta.
¿Cómo configuro las dependencias cuando una tarea diaria depende de una tarea horaria en diferentes escenarios?
-
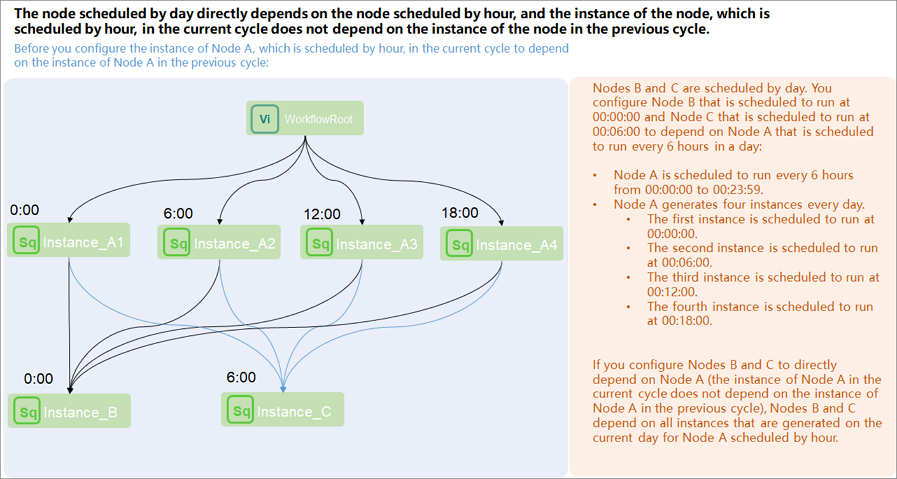
Escenario 1: Una tarea diaria depende de todas las instancias horarias de la tarea horaria del día actual.
Cuando una tarea diaria depende directamente de una tarea horaria, depende de todas las instancias de la tarea horaria del día actual.
-
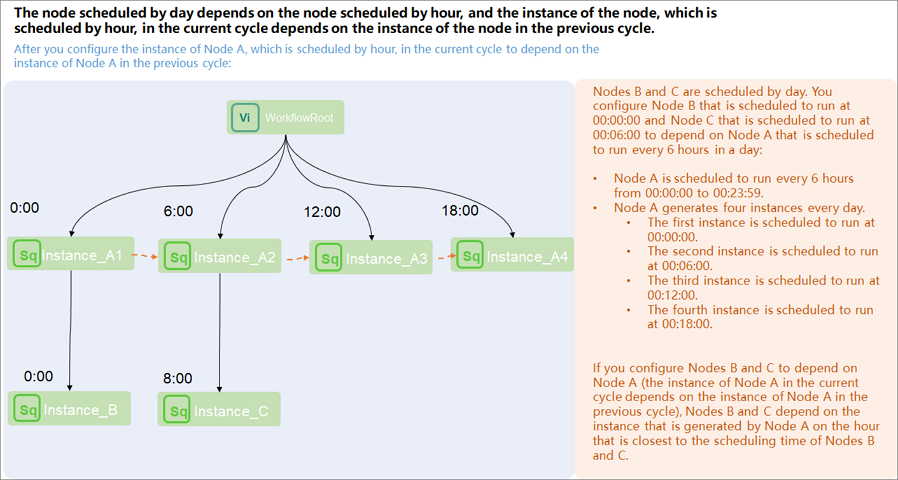
Escenario 2: Una tarea diaria depende de una instancia horaria específica del día actual.
Configuración de la tarea horaria: Configure la autodependencia para la tarea horaria. En la configuración de programación de la tarea horaria, seleccione el nodo actual como la dependencia del ciclo anterior.
Configuración de la tarea diaria: La tarea diaria depende directamente de la tarea horaria. Configure la tarea horaria como la entrada (nodo ascendente dependiente) de la tarea diaria.
-
Escenario 3: Una tarea diaria depende de todas las instancias horarias de la tarea horaria del día anterior.
Configure una dependencia entre ciclos para la tarea diaria respecto a la tarea horaria. En la configuración de programación de la tarea diaria, seleccione Previous-cycle Scheduling Dependency, seleccione Custom e introduzca el ID de nodo de la tarea horaria.
Elimine la dependencia del mismo ciclo respecto a la tarea horaria de la configuración de programación de la tarea diaria. En la sección de dependencia del mismo ciclo (Parent Nodes), elimine la dependencia del mismo ciclo respecto a la tarea horaria.
Si ha configurado una dependencia entre ciclos respecto a la tarea horaria para la tarea diaria, compruebe que se haya eliminado la dependencia del mismo ciclo. De lo contrario, la tarea diaria dependerá tanto de todas las instancias horarias del día actual como de todas las instancias horarias del día anterior.
Cuando una tarea diaria depende directamente de una tarea horaria, ¿cuándo se ejecuta la tarea diaria?
Funcionamiento: Cuando una tarea diaria depende directamente de una tarea horaria, la tarea diaria depende de todas las instancias de la tarea horaria del día actual. La tarea diaria se inicia solo después de que la última instancia horaria del día se ejecuta correctamente.
Escenario:
Suponga que una tarea horaria está programada a partir de las 00:00 y se ejecuta una vez cada hora. La tarea diaria debe esperar a que se completen las 24 instancias horarias antes de poder iniciarse.
Visualización de dependencias en Operation Center: Al hacer clic con el botón derecho en la tarea diaria para ver los nodos principales, se observa que depende de todas las instancias de la tarea horaria del día actual, lo que significa que depende de 24 instancias horarias. (línea de dependencia: continua)
Cuando una tarea diaria depende de una tarea horaria, ¿cómo hago para que la tarea diaria dependa de una instancia horaria específica en lugar de todas las instancias horarias?
Funcionamiento: Para que una tarea diaria dependa de una instancia horaria específica del día actual, configure la autodependencia para la tarea horaria y establezca la hora programada de la tarea diaria para que coincida con la instancia horaria específica.
Escenario: Cuando la tarea diaria necesita depender de la instancia horaria programada a las 12:00 del día actual
-
Configuración de dependencias:
Configuración de la tarea horaria ascendente: Configure la autodependencia para la tarea horaria. En Scheduling Settings, en la sección Time attribute, seleccione .
Configuración de la tarea diaria descendente: Establezca la hora programada de la tarea diaria en 12:00.
-
Visualización de dependencias en Operation Center:
Al hacer clic con el botón derecho en la instancia diaria para ver los nodos principales, se observa que depende de la instancia horaria programada a las 12:00 del día actual. (línea de dependencia: continua)
Al hacer clic con el botón derecho en la instancia horaria para ver los nodos principales, se observa que el nodo principal ascendente es la instancia horaria anterior. La instancia de las 12:00 depende de la instancia de las 11:00. (línea de dependencia: discontinua, porque la tarea horaria tiene configurada una dependencia entre ciclos con el elemento de dependencia establecido en el nodo actual)
Cuando una tarea diaria depende de una tarea horaria, ¿cómo hago para que la tarea diaria dependa de todas las instancias horarias del día anterior en lugar del día actual?
Funcionamiento: Para que una tarea diaria dependa de todas las instancias horarias del día anterior, configure una dependencia entre ciclos respecto a la tarea horaria para la tarea diaria.
Escenario: La tarea diaria necesita depender de todas las instancias horarias del día anterior.
-
Configuración de dependencias:
Configuración de la tarea diaria descendente: Configure una dependencia entre ciclos respecto a la tarea horaria. En Scheduling Settings, en la sección Time attribute, seleccione e introduzca el ID de nodo.
Configuración de la tarea horaria ascendente: No se requiere configuración.
-
Visualización de dependencias en Operation Center:
Al hacer clic con el botón derecho en la instancia diaria descendente para ver los nodos principales, se observa que depende de todas las instancias horarias de la tarea horaria del día anterior. (línea de dependencia: discontinua, porque la tarea diaria tiene configurada una dependencia entre ciclos respecto a la tarea horaria)
¿Cuándo debo configurar el elemento de dependencia del ciclo anterior como el nodo actual?
Escenario de negocio: Si el nodo actual necesita datos generados por el mismo nodo en el ciclo anterior, puede configurar la autodependencia para el nodo actual. Esto significa que la instancia del siguiente ciclo del nodo actual comienza a ejecutarse solo después de que finaliza la instancia del ciclo anterior, lo que evita la recuperación de datos mientras la instancia del ciclo anterior aún se está ejecutando (los datos aún no se han generado).
Si el nodo actual depende de datos generados por sí mismo en el ciclo anterior y necesita confirmar la hora en que el ciclo anterior generó datos, vaya a de la tarea y configure .
Si una tarea horaria depende de una tarea diaria, y la tarea horaria descendente tiene varios ciclos cuyas horas programadas ya han pasado cuando la tarea diaria ascendente termina de ejecutarse, la tarea horaria podría ejecutar varios ciclos simultáneamente. En este caso, vaya a de la tarea y configure .
¿Cómo configuro las dependencias cuando un nodo descendente depende de varias tareas simultáneamente?
Si un nodo descendente está configurado para depender de varias tareas, debe evaluar desde el punto de vista del negocio si todas las dependencias son necesarias. Si los datos de la tabla tienen correlaciones fuertes, se recomienda configurar todos los nodos como dependencias. Para obtener información sobre si debe configurar dependencias de nodo, consulte Why do I need to configure scheduling dependencies.
Por ejemplo, el nodo descendente C depende tanto de la tarea diaria B como de la tarea horaria A del día actual. La tarea horaria A genera la tabla A, y la tarea diaria B genera la tabla B. El nodo descendente C necesita datos tanto de la tabla A como de la tabla B.
Suponga que el nodo descendente C consulta datos tanto de la tabla A como de la tabla B. Si configura solo la tarea horaria A como Parent Nodes sin configurar la tarea diaria B como Parent Nodes, el nodo descendente C podría comenzar a ejecutarse antes de que finalice la tarea diaria ascendente B. Esto provoca un fallo al recuperar datos de la tabla de salida B de la tarea diaria. Por lo tanto, en este ejemplo, debe configurar tanto la tarea diaria como la tarea horaria como Parent Nodes del nodo descendente C.
Si el nodo descendente no tiene una dependencia fuerte de la tabla ascendente, lo que significa que el nodo descendente puede recuperar datos de la tabla ascendente en cualquier momento sin problemas (incluso si el nodo ascendente no ha generado los datos más recientes), no es necesario configurar una dependencia de nodo.
Si la tarea ascendente A es una tarea horaria y la tarea descendente B es una tarea diaria que se ejecuta una vez después de que finalizan todas las instancias de la tarea A, ¿se ejecutará la tarea diaria si la tarea horaria se extiende hasta el día siguiente? ¿Se ven afectados los parámetros de programación?
La tarea diaria B depende directamente de todas las instancias de la tarea horaria A del día actual. La tarea diaria B agrega los datos de la tarea horaria correspondientes al día actual. Si la tarea horaria finaliza su última instancia después de la medianoche (al día siguiente), la tarea diaria descendente se ejecuta de todos modos. Solo difiere la hora de ejecución; la sustitución de parámetros de programación no se ve afectada.
El nodo A se ejecuta cada hora en punto todos los días, y el nodo B se ejecuta una vez al día. ¿Cómo hago para que el nodo B se inicie después de que el nodo A se ejecute correctamente por primera vez cada día?
Al configurar el nodo A, seleccione Previous-cycle Scheduling Dependency y elija Current Node. Establezca la hora programada del nodo B en 00:00. En las instancias programadas automáticamente a diario, la instancia del nodo B dependerá únicamente de la instancia del nodo A generada a las 00:00, que es la primera instancia del nodo A.
Hay tres tareas A, B y C. ¿Cómo ejecuto A->B->C cada hora (B se inicia después de que termina A, y C se inicia después de que termina B)?
Configuración de dependencias: Establezca la relación de dependencia de modo que la salida de A sirva como entrada de B, y la salida de B sirva como entrada de C.
Configuración de frecuencia de programación: Dado que la programación se configura a nivel de nodo, los tres nodos A, B y C deben tener su programación establecida en horaria.
¿Cómo configuro dependencias entre flujos de trabajo y entre proyectos dentro de la misma región?
Funcionamiento: La salida de un nodo ascendente sirve como entrada de un nodo descendente para formar una dependencia de nodo. Agregue la salida del nodo del que desea depender (entre proyectos o entre flujos de trabajo) a la sección de entrada del nodo que requiere la dependencia.
Una tarea configurada con reejecución tras fallo no se reejecutó después del error y reportó el mensaje: Task Run Timed Out, Killed by System!!
-
Mensaje de error:
Cuando Scheduling Settings > Time attribute > Rerun de la tarea objetivo está establecido en Allow Regardless of Running Status o Allow upon Failure Only, la tarea no se reejecuta tras el fallo y genera el error
Task Run Timed Out, Killed by System!. -
Posible causa:
En Scheduling Settings > Time attribute de esta tarea se ha configurado el Timeout. Cuando la duración de la tarea supera el periodo de tiempo de espera, la tarea finaliza automáticamente. Las tareas que fallan debido a un tiempo de espera agotado no activan el mecanismo de reejecución.
-
Solución:
Cuando una tarea falla debido a un tiempo de espera agotado, el mecanismo de reejecución tras fallo no surte efecto. Debe reiniciar la tarea manualmente.