Todos los productos
Search
Centro de documentos

DataWorks:Preguntas frecuentes sobre la sincronización por lotes

Última actualización: Sep 17, 2026

Respuestas a las dudas más habituales sobre las tareas de sincronización por lotes. Se abordan problemas de conectividad, ajustes de recursos, datos incorrectos y errores específicos de cada plugin.

Descripción general

Utilice las palabras clave de la siguiente tabla para localizar los problemas y sus soluciones.

Categoría

Palabra clave

Tema relacionado

Problemas comunes de operación y mantenimiento en tareas de sincronización por lotes

Network communication issues

Why does a data source pass the connectivity test but an offline sync task fails with a data source connection error?

Switch resource groups

How do I switch the resource group for an offline sync task?

Dirty data

Run timeout

How do I troubleshoot long-running offline sync tasks?

Slow sync caused by a missing index in the WHERE condition of a data sync task

Whether default values of source tables are retained

Are default values and NOT NULL constraints retained in the destination table created by Data Integration?

Split key

Can a composite primary key be used as a split key for offline sync tasks?

Data loss

Data inconsistency between the destination table and source table after data sync

Causas y soluciones de errores no relacionados con plugins

Dirty data

How do I handle dirty data errors caused by encoding format or garbled characters?

SSRF attacks

How do I handle the error "Task have SSRF attacks"?

Network communication issues

Offline sync task intermittently succeeds or fails

Table/column name keywords

How do I handle sync task failures caused by reserved keywords in table or column names?

Adding columns to a table

How do I handle column additions in the source table for offline sync tasks?

Date writing

How do I preserve milliseconds or specify a custom date-time format when writing date-time data to text?

Causas y soluciones de errores específicos de plugins

MongoDB

OSS

Is there a file count limit when reading OSS files?

DataHub

How do I handle write failures caused by exceeding the data limit when writing to DataHub?

Lindorm

Does writing data using the Lindorm bulk method always replace historical data?

Elasticsearch

How do I query all fields in an Elasticsearch index?

OTS Writer configuration

How do I configure OTS Writer to write data to a destination table with auto-increment primary key columns?

Time series model configuration

How do I understand the _tag and is_timeseries_tag fields in time series model configuration?

Escenarios y soluciones de sincronización por lotes

Custom table names

How do I customize table names for offline sync tasks?

MaxCompute

Task configuration issues

How do I handle the issue of not being able to view all tables when configuring an offline sync node?

LogHub

Kafka

OSS

MySQL

Modify TTL

Can the TTL of a synced data table only be modified by using the ALTER statement?

Function aggregation

Does API-based sync support using source-side functions (such as MaxCompute functions) for aggregation?

Elasticsearch

Field mapping

How do I handle field mapping issues when data preview is unavailable for unstructured data sources?

Mensajes de error y soluciones

Resource configuration issues

OSS

Error when reading OSS data: AccessDenied The bucket you access does not belong to you

Redis

Error when writing to Redis in hash mode: Code:[RedisWriter-04] source column number is invalid

PostgreSQL

Error when reading PostgreSQL data: FATAL: terminating connection due to conflict with recovery

MySQL

Instance run conflicts

Offline task error: Duplicate entry 'xxx' for key 'uk_uk_op'

Network communication issues

Offline sync task with MySQL data source error: Communications link failure

Field mapping

Offline task error: plugin xx does not specify column

MaxCompute

RestAPI

RestAPI Writer error: The JSON string found by path is not an array type

RDS

Error when the offline sync source is Amazon RDS: Host is blocked

MongoDB

Elasticsearch

Hive

Error when syncing data to local Hive offline: Could not get block locations

Run timeout

Offline sync task with MongoDB source error: MongoExecutionTimeoutException: operation exceeded time limit

Conectividad de red

¿Por qué la prueba de conectividad del origen de datos se ejecuta correctamente, pero la tarea de sincronización por lotes falla con un error de conexión al origen de datos?

  • Si la prueba de conectividad pasó anteriormente, vuelva a ejecutarla para confirmar que el resource group y la base de datos siguen conectados. Compruebe también que no se hayan aplicado cambios en la base de datos.

  • Compruebe si el resource group que superó la prueba de conectividad es el mismo que se utiliza para ejecutar la tarea.

    Consulte el resource group que usa la tarea:

    • Si la tarea se ejecuta en el resource group predeterminado, los registros contienen la siguiente información: running in Pipeline[basecommon_ group_xxxxxxxxx]

    • Si la tarea se ejecuta en un resource group exclusivo para Data Integration, los registros contienen la siguiente información: running in Pipeline[basecommon_S_res_group_xxx]

    • Si la tarea se ejecuta en un resource group serverless, los registros contienen la siguiente información: running in Pipeline[basecommon_Serverless_res_group_xxx]

  • Si la tarea falla ocasionalmente durante la programación de madrugada, pero se completa correctamente al volver a ejecutarla, revise la carga de la base de datos en el momento del error.

La tarea de sincronización por lotes se completa y falla de manera intermitente

Si una tarea de sincronización por lotes falla de forma intermitente, es probable que la causa sea una configuración incompleta de la lista de permitidos. Compruebe si la lista de permitidos de la base de datos está configurada por completo.

Al usar un resource group exclusivo para Data Integration:

  • Si agregó previamente las direcciones IP de la interfaz de red elástica (ENI) del resource group exclusivo para Data Integration a la lista de permitidos del origen de datos y después escaló horizontalmente dicho grupo, actualice la lista de permitidos del origen de datos. Incluya las direcciones IP de ENI del resource group ampliado.

  • Para evitar actualizar la lista de permitidos cada vez que el resource group escale horizontalmente, se recomienda agregar el bloque CIDR del vSwitch asociado al resource group exclusivo para Data Integration como lista de permitidos de la base de datos. Para obtener más información, consulte Add an allowlist.

Al usar un resource group serverless: consulte Network connectivity of a serverless resource group para revisar la configuración de la lista de permitidos del resource group y asegúrese de que la red esté configurada correctamente.

Si la lista de permitidos está bien configurada, compruebe si la carga de la base de datos es demasiado alta, ya que esto puede interrumpir las conexiones.

Ajustes de recursos

La tarea de sincronización por lotes falla con el error: [TASK_MAX_SLOT_EXCEED]:Unable to find a gateway that meets resource requirements. 20 slots are requested, but the maximum is 16 slots.

  • Posible causa:

    La concurrencia está configurada con un valor demasiado alto, lo que provoca una falta de recursos.

  • Solución:

    Reduzca la concurrencia de la tarea de sincronización por lotes.

    • Si configura la tarea de sincronización por lotes en modo asistente, reduzca el valor de Expected Maximum Concurrency en Channel Control. Para obtener más información, consulte Configure channel control in wizard mode.

    • Si configura la tarea de sincronización por lotes en modo script, reduzca el valor del parámetro concurrent en Channel Control. Para obtener más información, consulte Configure channel control in script mode.

La tarea de sincronización por lotes falla con el error: OutOfMemoryError: Java heap space

Para resolver este error:

  1. Si la configuración del plugin admite parámetros como batchsize o maxfilesize, reduzca los valores correspondientes.

    Puede comprobar si cada plugin admite los parámetros anteriores. Vaya al tema Supported data sources and readers/writers y haga clic en el plugin correspondiente para consultar los detalles de los parámetros.

  2. Reduzca la concurrencia.

    • Si configura la tarea de sincronización por lotes en modo asistente, reduzca el valor de Expected Maximum Concurrency en Channel Control. Para obtener más información, consulte Configure channel control in wizard mode.

    • Si configura la tarea de sincronización por lotes en modo script, reduzca el valor del parámetro concurrent en Channel Control. Para obtener más información, consulte Configure channel control in script mode.

  3. Si sincroniza archivos, como los de OSS, reduzca la cantidad de archivos que se van a leer.

  4. En la sección Running Resources de la configuración de la tarea, aumente el valor de Resource Usage (CU) según corresponda. Defina el valor de CU con cuidado para no afectar otras tareas en ejecución.

Conflictos de ejecución de instancias

La tarea de sincronización por lotes falla con el error: Duplicate entry 'xxx' for key 'uk_uk_op'

  • Mensaje de error: Error updating database. Cause: com.mysql.jdbc.exceptions.jdbc4.MySQLIntegrityConstraintViolationException: Duplicate entry 'cfc68cd0048101467588e97e83ffd7a8-0' for key 'uk_uk_op'.

  • Posible causa: Data Integration no permite que distintas instancias de un mismo nodo (es decir, tareas de sincronización con la misma configuración JSON) se ejecuten al mismo tiempo. Por ejemplo, si una tarea de sincronización tiene una programación de 5 minutos y los retrasos en los procesos anteriores provocan que tanto la instancia de las 00:00 como la de las 00:05 se activen a las 00:05, una de ellas no podrá iniciarse. Esto también ocurre cuando se rellenan datos o se vuelve a ejecutar una instancia mientras la instancia de la tarea sigue activa.

  • Solución: Especifique intervalos entre las horas de ejecución de las instancias. Para las tareas programadas cada hora o cada minuto, se recomienda configurar la autodependencia. De esta forma, la instancia actual solo se inicia cuando termina la instancia del ciclo anterior. Para la configuración en la versión anterior de Data Studio, consulte Self-dependency. Para la configuración en la nueva versión de Data Studio, consulte Configure self-dependency.

Tiempo de espera agotado durante la ejecución

Una tarea de sincronización por lotes con MongoDB como origen falla y muestra el error: MongoDBReader$Task - operation exceeded time limitcom.mongodb.MongoExecutionTimeoutException: operation exceeded time limit.

  • Detalles del error: Durante una tarea de sincronización de datos, la tarea falla y muestra el siguiente error: MongoDBReader$Task - operation exceeded time limitcom.mongodb.MongoExecutionTimeoutException: operation exceeded time limit.

  • Causa posible: La extracción completa de datos es demasiado grande.

  • Solución:

    • Aumente la concurrencia.

    • Reduzca el valor de BatchSize.

    • Agregue la configuración cursorTimeoutInMs en la sección de parámetros del Reader y establézcala en un valor alto, como 3600000 ms.

Una tarea de sincronización por lotes con MySQL como origen de datos falla y muestra un error de tiempo de espera de conexión agotado: Communications link failure

  • Error de lectura

    • Síntoma:

      Al leer los datos, se produce el siguiente error: Communications link failure The last packet successfully received from the server was 7,200,100 milliseconds ago. The last packet sent successfully to the server was 7,200,100 milliseconds ago. - com.mysql.jdbc.exceptions.jdbc4.CommunicationsException: Communications link failure

    • Causa posible:

      La base de datos ejecuta las consultas SQL de forma lenta, lo que provoca que se agote el tiempo de espera de lectura de MySQL.

    • Solución:

      • Compruebe si se configuró una condición de filtro where y asegúrese de que las columnas filtradas tengan índices.

      • Verifique si la tabla de origen contiene demasiados datos. Si es así, divida la tarea en varias tareas.

      • Revise los registros para encontrar la instrucción SQL que causó el bloqueo y consulte al administrador de la base de datos para resolver el problema.

  • Error de escritura

    • Síntoma:

      Al escribir los datos, se produce el siguiente error: Caused by: java.util.concurrent.ExecutionException: ERR-CODE: [TDDL-4614][ERR_EXECUTE_ON_MYSQL] Error occurs when execute on GROUP 'xxx' ATOM 'dockerxxxxx_xxxx_trace_shard_xxxx': Communications link failure The last packet successfully received from the server was 12,672 milliseconds ago. The last packet sent successfully to the server was 12,013 milliseconds ago. More...

    • Causa posible:

      Una consulta lenta provoca un SocketTimeout. El valor predeterminado de SocketTimeout para las conexiones TDDL es de 12 segundos. Si una instrucción SQL tarda más de 12 segundos en ejecutarse en MySQL, se reporta el error 4614. Este error puede ocurrir de manera ocasional cuando el volumen de datos es grande o el servidor está saturado.

    • Solución:

      • Espere a que la base de datos se estabilice y luego vuelva a ejecutar la tarea de sincronización.

      • Contacte al administrador de la base de datos para ajustar el valor del tiempo de espera.

¿Cómo soluciono los problemas de una tarea de sincronización por lotes que tarda mucho tiempo en ejecutarse?

Causa posible 1: La ejecución tarda demasiado.

  • Las instrucciones pre-SQL o post-SQL (como preSql y postSql) tardan demasiado en ejecutarse en la base de datos, lo que hace que la tarea se ejecute lentamente.

  • La clave de división no se configuró correctamente, lo que ralentiza la tarea.

    La sincronización por lotes utiliza la clave de división (splitPk) para fragmentar los datos e inicia tareas concurrentes para mejorar la eficiencia. Consulte la documentación de cada plugin específico para determinar si es necesario configurar una clave de división.

Solución 1:

  • Si configuró instrucciones pre-SQL o post-SQL, utilice columnas indexadas para filtrar los datos.

  • Si el sistema admite la clave de división, configúrela correctamente. A continuación se muestra un ejemplo de configuración de la clave de división para el plugin MySQL Reader:

    • Se recomienda usar la clave principal de la tabla como splitPk, ya que las claves principales suelen estar distribuidas de manera uniforme. Esto ayuda a evitar puntos críticos de datos en los fragmentos resultantes.

    • Actualmente, splitPk solo admite la fragmentación de datos basada en enteros y no es compatible con cadenas, números de punto flotante, fechas u otros tipos. Si especifica un tipo no admitido, se utilizará la sincronización por canal único.

    • Si deja splitPk vacío o no lo especifica, la sincronización de datos utilizará un solo canal para sincronizar los datos de la tabla.

Causa posible 2: La tarea está esperando recursos de ejecución de Data Integration.

Solución 2: Si los registros muestran un estado WAIT prolongado, significa que el resource group exclusivo de Data Integration utilizado por la tarea actual no tiene suficiente concurrencia disponible para ejecutarla. Para obtener más detalles sobre la causa y la solución, consulte Troubleshoot resource group concurrency issues.

Nota

Dado que una tarea de sincronización por lotes se envía desde un resource group de programación a un resource group de ejecución de Data Integration, consume un recurso de programación. Si la tarea se ejecuta durante un periodo prolongado sin liberar recursos, podría bloquear no solo otras tareas de sincronización por lotes, sino también otros tipos de tareas programadas.

¿Qué debo hacer cuando una tarea de sincronización de datos se vuelve lenta debido a un escaneo completo de tabla causado por una cláusula WHERE sin índice?

  • Ejemplo de escenario

    El código SQL ejecutado es el siguiente:

    SELECT bid,inviter,uid,createTime FROM `relatives` WHERE createTime>='2016-10-2300:00:00' AND reateTime<'2016-10-24 00:00:00';

    La ejecución comenzó a las 2016-10-25 11:01:24.875 y los resultados empezaron a devolverse a las 2016-10-25 11:11:05.489. El programa de sincronización esperó a que la base de datos devolviera los resultados de la consulta SQL, por lo que MaxCompute tuvo que esperar mucho tiempo antes de continuar con la ejecución.

  • Análisis de la causa raíz

    La columna createTime de la cláusula WHERE no tiene índice, lo que provoca un escaneo completo de la tabla.

  • Solución

    Se recomienda que la cláusula where utilice columnas indexadas para mejorar el rendimiento. También puede agregar índices según sea necesario.

Cambiar el resource group

¿Cómo cambio el resource group de ejecución de una tarea de sincronización por lotes?

Data Studio anterior:

Modifique el resource group utilizado para la depuración en la página de detalles de la tarea de sincronización por lotes dentro de DataStudio. También puede cambiar el resource group de ejecución de tareas de Data Integration que se usa durante la programación en Operation Center. Para obtener más información, consulte Switch the Data Integration resource group.

Nuevo Data Studio:

Modifique el resource group utilizado para depurar las tareas de Data Integration en DataStudio. Además, cambie el resource group de ejecución de tareas de Data Integration que se usa durante la programación en Operation Center. Para obtener más información, consulte Switch the Data Integration resource group.

Datos erróneos

¿Cómo soluciono problemas y localizo datos erróneos?

Datos erróneos: Un registro que no se pudo escribir en el origen de datos de destino debido a una excepción.

Impacto de los datos erróneos: Los datos erróneos no se escriben en el destino. Usted controla si se permiten datos erróneos y especifica la cantidad máxima de registros permitidos. De forma predeterminada, Data Integration permite datos erróneos. Especifique el umbral de datos erróneos al configurar una tarea de sincronización. Para obtener más información, consulte Configure channel control in wizard mode.

  • Si la tarea permite datos erróneos: La tarea continúa ejecutándose cuando se generan datos erróneos, pero estos se descartan y no se escriben en el destino.

  • Control de la cantidad de registros erróneos permitidos:

    • Si establece el recuento permitido de datos erróneos en 0, la tarea falla y finaliza cuando se genera cualquier dato erróneo.

    • Si establece el recuento permitido de datos erróneos en x, la tarea falla y finaliza cuando dicho recuento supera x. Si el recuento de datos erróneos es menor que x, la tarea continúa ejecutándose, pero los datos erróneos se descartan y no se escriben en el destino.

Análisis de escenarios con datos erróneos:

  • Escenario 1:

    • Mensaje de error: {"message":"Dirty data encountered when writing to the ODPS destination table: An error occurred in the data of field [3]. Please check the data and make corrections, or you can increase the threshold to ignore this record.","record":[{"byteSize":0,"index":0,"type":"DATE"},{"byteSize":0,"index":1,"type":"DATE"},{"byteSize":1,"index":2,"rawData":0,"type":"LONG"},{"byteSize":0,"index":3,"type":"STRING"},{"byteSize":1,"index":4,"rawData":0,"type":"LONG"},{"byteSize":0,"index":5,"type":"STRING"},{"byteSize":0,"index":6,"type":"STRING"}]}.

    • Cómo manejarlo: El registro muestra la columna con datos erróneos. La tercera columna presenta anomalías.

      • El writer reporta los datos erróneos. Revise la instrucción DDL de la tabla de destino. El tamaño de columna especificado para la tabla de ODPS es menor que el tamaño real de los datos en la columna correspondiente de MySQL.

      • Principio de sincronización de datos: Los datos del origen deben poder escribirse en el destino (los tipos de origen y destino deben coincidir, al igual que las definiciones de tamaño de columna). En concreto, el tipo de datos de origen debe coincidir con el tipo de datos de destino. Por ejemplo, los datos VARCHAR del origen no pueden escribirse en una columna INT del destino. El tamaño de la columna de destino debe ser lo suficientemente grande para contener el tamaño real de los datos de la columna de origen mapeada. Los datos de origen de tipos como LONG, VARCHAR y DOUBLE pueden almacenarse en tipos más amplios, como string o text, en el destino.

      • Si el mensaje de error de datos erróneos no es claro, copie todo el registro erróneo del registro, examine los datos y compárelos con los tipos de datos de destino para identificar qué columna o columnas incumplen las reglas.

      Por ejemplo:

      {"byteSize":28,"index":25,"rawData":"ohOM71vdGKqXOqtmtriUs5QqJsf4","type":"STRING"}

      byteSize: recuento de bytes; index: 25, la columna número 26; rawData: el valor real; type: tipo de datos.

  • Escenario 2:

    • Mensaje de error: DataX reporta datos erróneos al leer valores null de MySQL.

    • Cómo manejarlo: Compruebe si el tipo de datos de la columna de origen con valores null coincide con el tipo de la columna de destino mapeada. Una discrepancia de tipos provoca un error. Por ejemplo, escribir un valor null de tipo string en una columna de destino de tipo int genera un error.

  • Escenario 3:

    • Mensaje de error: Los tipos de campo de origen y destino son incompatibles. Por ejemplo, un campo de origen de Simple Log Service (SLS) se lee como STRING, pero la columna de destino mapeada está definida como INT u otro tipo que no es cadena.

    • Cómo manejarlo: Data Integration valida los tipos de campo antes de escribir los datos. Si el tipo de campo de origen es incompatible con el tipo de campo de destino, el registro se identifica como dato erróneo, se intercepta y nunca se escribe en el destino. Asegúrese de que los tipos de campo de origen y destino sean iguales o compatibles. Por ejemplo, cambie el campo de destino a VARCHAR para recibir el valor o convierta el tipo de datos antes de la sincronización.

      Nota

      Un trigger de MySQL en la tabla de destino no puede resolver este tipo de datos erróneos. Data Integration intercepta los registros con tipos de campo incompatibles antes de que lleguen a la base de datos de destino, por lo que no se ejecuta ninguna instrucción INSERT ni UPDATE en la tabla de destino y el trigger nunca se invoca. Asegúrese de que los tipos de campo sean compatibles cuando configure la tarea de sincronización en DataWorks.

¿Cómo consulto los datos erróneos?

Consulte view the task logs y haga clic en Detail log url en los registros para obtener el runtime log detallado y la información de los datos erróneos.

DI Submit at       : 2023-01-04 00:21:05
DI Start at        : 2023-01-04 00:21:07
DI Finish at       : 2023-01-04 07:00:05

2023-01-04 07:00:06 : Use "cdp job -log xxx" for more detail.
2023-01-04 07:00:06 :Detail log url: https://di-cn-chengdu.data.aliyun.com/web/di/insxxx
Exit with SUCCESS.
2023-01-04 07:00:06 [INFO] Sandbox context cleanup temp file success.
2023-01-04 07:00:06 [INFO] Data synchronization ended with return code: [0].
2023-01-04 07:00:06 INFO ============================================================

Si la cantidad de datos erróneos supera el límite durante una tarea de sincronización por lotes, ¿se conservan los datos ya sincronizados?

La tarea acumula el recuento de registros erróneos durante la ejecución. Una vez que el recuento supera el umbral de datos erróneos configurado, la tarea finaliza de inmediato.

  • Conservación de datos: Los datos que se escribieron correctamente en el destino antes de que la tarea finalizara se conservan. No se revierten los cambios.

  • Política de tolerancia cero: Cuando el umbral de datos erróneos se establece en 0, el sistema aplica una política de tolerancia cero. Esto significa que la tarea falla y se detiene inmediatamente al detectar el primer registro erróneo.

¿Cómo manejo los errores de datos erróneos causados por la configuración del formato de codificación o por caracteres ilegibles?

  • Mensaje de error:

    Si los datos contienen caracteres emoji, pueden producirse errores de datos erróneos durante la sincronización: [13350975-0-0-writer] ERROR StdoutPluginCollector - Dirty data {"exception":"Incorrect string value: '\\xF0\\x9F\\x98\\x82\\xE8\\xA2...' for column 'introduction' at row 1","record":[{"byteSize":8,"index":0,"rawData":9642,"type":"LONG"}],"type":"writer"} .

  • Causa posible:

    • La codificación de la base de datos no está configurada como utf8mb4, lo que provoca errores al sincronizar caracteres emoji.

    • Los datos de origen contienen caracteres ilegibles.

    • La codificación de la base de datos y la del cliente no coinciden.

    • La codificación del navegador es diferente, lo que provoca fallos en la vista previa o caracteres ilegibles.

  • Solución:

    Elija la solución adecuada según la causa de los caracteres ilegibles:

    • Si los datos originales contienen caracteres ilegibles, corríjalos antes de ejecutar la tarea de sincronización.

    • Si los formatos de codificación de la base de datos y del cliente no coinciden, modifique primero el formato de codificación.

    • Si la codificación del navegador no coincide con la de la base de datos o la del cliente, unifique los formatos de codificación antes de previsualizar los datos.

    Intente lo siguiente:

    1. Para los orígenes de datos agregados en formato JDBC, modifique utf8mb4 de la siguiente manera: jdbc:mysql://xxx.x.x.x:3306/database?com.mysql.jdbc.faultInjection.serverCharsetIndex=45.

    2. Para los orígenes de datos agregados por ID de instancia, agregue lo siguiente al nombre de la base de datos: database?com.mysql.jdbc.faultInjection.serverCharsetIndex=45.

    3. Modifique el formato de codificación de la base de datos a utf8mb4. Por ejemplo, cambie el formato de codificación de la base de datos RDS desde la consola de RDS.

      Nota

      Comando para establecer el formato de codificación del origen de datos RDS: set names utf8mb4. Comando para comprobar el formato de codificación de la base de datos RDS: show variables like 'char%'.

La sincronización hacia MaxCompute falla o trunca los datos porque un solo campo supera el límite de tamaño de 8 MB

  • Escenario: Al sincronizar datos hacia MaxCompute (ODPS), la tarea falla o los datos escritos se truncan porque un campo de origen supera los 8 MB.

  • Causa: En las tareas de sincronización que utilizan MaxCompute como destino, MaxCompute (ODPS) Writer impone un límite de tamaño de 8 MB por campo.

  • Solución:

    • En la configuración avanzada de MaxCompute (ODPS) Writer, establezca la política de manejo de campos de longitud excesiva (overLengthRule) para especificar cómo se gestionan los campos sobredimensionados: truncar el campo a 8 MB, establecer el campo como NULL o escribir el campo tal cual sin truncarlo.

    • En escenarios que involucran objetos grandes, como archivos o registros, almacene los datos sin procesar en Object Storage Service (OSS) y conserve únicamente la URL en la base de datos. Luego, use DataWorks para sincronizar la URL en lugar del objeto grande.

    • Como paso previo al procesamiento, divida el campo sobredimensionado en varios subcampos más pequeños en el origen, por ejemplo, en segmentos de 7 MB. Sincronice los subcampos por separado y concaténelos de nuevo en el destino.

Nota

El límite de tamaño de campo de 8 MB y la configuración avanzada overLengthRule aplican a MaxCompute (ODPS) Writer. Otros destinos de sincronización podrían aplicar límites diferentes.

Conservación de los valores predeterminados

¿Data Integration conserva propiedades como los valores predeterminados y las restricciones de no nulo cuando crea una tabla de destino?

Cuando DataWorks crea una tabla de destino, solo conserva los nombres de columna, los tipos de datos y los comentarios de la tabla de origen. No conserva los valores predeterminados ni las restricciones (incluidas las restricciones de no nulo y los índices).

Clave de división

¿Se puede usar una clave principal compuesta como clave de división en una tarea de sincronización por lotes?

Las tareas de sincronización por lotes no admiten el uso de una clave principal compuesta como clave de división.

La sincronización incremental falla con el error DBUtilErrorCode-04, que indica que la columna de clave principal no es válida

  • Escenario: Una tarea de sincronización incremental falla con un error que indica que la columna configurada como clave de división (splitPk) no es válida.

  • Causa posible: La configuración de la clave de división no cumple con los requisitos. Por ejemplo, se configuraron varias columnas como clave de división, el tipo de datos de la columna configurada no es compatible o la columna configurada no existe en la tabla.

  • Solución:

    1. Actualice el mapeo de la tabla de origen para consultar la columna de clave de división que el sistema sugiere automáticamente.

    2. Asegúrese de que solo se haya configurado una única columna como clave de división y de que su tipo de datos sea entero. Como se describió anteriormente en este documento, splitPk solo admite la fragmentación de datos basada en enteros y no es compatible con cadenas, números de punto flotante, fechas u otros tipos.

    3. Si la columna sugerida automáticamente no cumple estas condiciones, cambie manualmente la clave de división a una sola columna de tipo entero que cumpla con los requisitos.

Para obtener más información sobre cómo la clave de división afecta el rendimiento de la sincronización, consulte How do I troubleshoot a batch synchronization task that takes a long time to run?.

Datos faltantes

La sincronización de datos finaliza, pero los datos de la tabla de destino no coinciden con los de la tabla de origen

Si surgen problemas de calidad de datos después de la sincronización, consulte Troubleshoot data quality issues after synchronization para obtener información detallada sobre la solución de problemas.

Ataques SSRF

La tarea presenta ataques SSRF** Task have SSRF attacks **¿Cómo manejo esta situación?

P: ¿Cómo manejo el error "Task have SSRF attacks"?

Causa: Para garantizar la seguridad en la nube, DataWorks prohíbe que las tareas accedan a direcciones de red internas de la nube mediante direcciones IP públicas. Cuando una URL en la configuración del plugin (como HTTP Reader) apunta a una dirección IP interna o a un nombre de dominio VPC, se activa esta comprobación de seguridad.

Procedimiento correcto:

Solución: Para las tareas que acceden a orígenes de datos internos, deje de usar el resource group compartido y cambie a un serverless resource group seguro (recomendado) o a un exclusive resource group for Data Integration.

Escritura de fechas

¿Cómo conservo los milisegundos o especifico un formato de fecha y hora personalizado al escribir datos de fecha y hora en texto?

Cambie la tarea de sincronización al modo script y agregue la siguiente configuración en la sección setting de la página de configuración de la tarea:

"common": {
  "column": {
    "dateFormat": "yyyyMMdd",
    "datetimeFormatInNanos": "yyyyMMdd HH:mm:ss.SSS"
  }
}

Donde:

  • dateFormat especifica el formato de fecha que se utiliza al convertir datos de origen de tipo DATE (sin hora) a texto.

  • datetimeFormatInNanos especifica el formato de fecha que se utiliza al convertir datos de origen de tipo DATETIME/TIMESTAMP (con hora) a texto. Puede especificar una precisión de hasta milisegundos.

MaxCompute

Consideraciones al agregar una fila o columna en el mapeo de columnas al leer datos de una tabla de MaxCompute (ODPS)

  1. Puede introducir constantes. Los valores deben ir entre comillas simples, como 'abc' y '123'.

  2. Puede usar parámetros de programación, como '${bizdate}'. Para obtener información sobre cómo usar los parámetros de programación, consulte Configure scheduling parameters.

  3. Puede introducir las columnas de partición que desea sincronizar, como pt.

  4. Si el valor introducido no se puede analizar sintácticamente, el tipo se mostrará como 'Custom'.

  5. No se admiten las funciones de ODPS.

  6. Si una columna agregada manualmente se muestra como Custom (por ejemplo, una columna de partición de MaxCompute o una columna de LogHub que no aparece en la vista previa de datos), esto no afecta la ejecución real de la tarea.

¿Cómo sincronizo columnas de partición al leer datos de una tabla de MaxCompute (ODPS)?

En la lista de mapeo de columnas, haga clic en Add o Create Field debajo de las columnas de la tabla de origen, introduzca el nombre de la columna de partición (como pt) y configure el mapeo hacia la columna de la tabla de destino.

¿Cómo sincronizo datos de varias particiones al leer datos de una tabla de MaxCompute (ODPS)?

Especifique la información de partición de los datos que desea leer.

  • La configuración de particiones de ODPS admite comodines de shell de Linux: * coincide con cero o más caracteres, y ? coincide con cualquier carácter individual.

  • De forma predeterminada, la partición especificada debe existir. Si la partición no existe, la tarea falla. Si desea que la tarea finalice correctamente incluso cuando la partición no exista, establezca When partitions do not exist, en: ignore non-existing partitions and execute the task normally. Como alternativa, cambie al modo script y agregue "successOnNoPartition": true en la sección ODPS Parameter.

Por ejemplo, si la tabla particionada test tiene cuatro particiones: pt=1,ds=hangzhou, pt=1,ds=shanghai, pt=2,ds=hangzhou y pt=2,ds=beijing, las configuraciones para leer distintas particiones son las siguientes:

  • Para leer datos de la partición pt=1,ds=hangzhou, establezca la información de partición como "partition":"pt=1,ds=hangzhou".

  • Para leer datos de todas las particiones bajo pt=1, establezca la información de partición como "partition":"pt=1,ds=*".

  • Para leer datos de todas las particiones de la tabla test, establezca la información de partición como "partition":"pt=*,ds=*".

También puede establecer condiciones para recuperar datos de particiones según sus necesidades (las siguientes operaciones requieren el modo script):

  • Para especificar la partición máxima, agregue la siguiente configuración: /*query*/ ds=(select MAX(ds) from DataXODPSReaderPPR).

  • Para filtrar por condición, agregue la condición correspondiente con la configuración /*query*/ pt+expression. Por ejemplo, /*query*/ pt>=20170101 and pt<20170110 recupera todos los datos de la partición pt desde 20170101 (inclusive) hasta 20170110 (exclusive).

Nota

/*query*/ indica que el contenido posterior se reconoce como una condición WHERE.

Cómo implementar el filtrado de columnas, la reordenación y el llenado con valores nulos en MaxCompute

Al configurar MaxCompute Writer, puede implementar operaciones de filtrado de columnas, reordenación y llenado con valores nulos que MaxCompute no admite de forma nativa. Por ejemplo, para importar todas las columnas, configure "column": ["*"].

Si la tabla de MaxCompute tiene tres columnas a, b y c, y usted desea sincronizar únicamente las columnas c y b, configure la lista de columnas como "column": ["c","b"]. Esto significa que la primera y la segunda columna del Reader se importarán a las columnas c y b de la tabla de MaxCompute, mientras que la nueva columna insertada a en la tabla de MaxCompute se establecerá como null.

Manejo de errores de configuración de columnas en MaxCompute

Para garantizar la fiabilidad de la escritura de datos y evitar problemas de calidad causados por la pérdida de datos en columnas adicionales, MaxCompute Writer reporta un error si se intentan escribir columnas extra. Por ejemplo, si la tabla de MaxCompute tiene las columnas a, b y c, y MaxCompute Writer intenta escribir más de tres columnas, reportará un error.

La sincronización por lotes falla cuando la tabla de destino de MaxCompute contiene una columna de tipo JSON

  • Escenario: Una tarea de sincronización por lotes que escribe en MaxCompute (ODPS) falla, y la solución de problemas revela que la tabla de destino contiene una columna de tipo JSON.

  • Causa posible: Es posible que MaxCompute Writer no admita la escritura en una columna de destino de tipo JSON en todos los casos.

  • Solución: Revise el esquema de la tabla de destino de MaxCompute para confirmar si contiene una columna de tipo JSON. Si es así, pruebe uno de los siguientes métodos:

    • Cambie el tipo de la columna a STRING en MaxCompute, por ejemplo, ejecutando ALTER TABLE ADD COLUMN o un cambio de esquema equivalente.

    • Excluya la columna de tipo JSON del mapeo de campos para que no se escriba durante la sincronización.

Consideraciones sobre la configuración de particiones en MaxCompute

MaxCompute Writer solo admite la escritura en la partición de último nivel y no admite el enrutamiento de particiones basado en una columna. Si una tabla tiene tres niveles de particiones, debe especificar exactamente la partición de tercer nivel en la configuración de particiones. Por ejemplo, para escribir datos en la partición de tercer nivel, configúrela como pt=20150101, type=1, biz=2. No puede configurarla como pt=20150101, type=1 ni como pt=20150101.

Reejecución y recuperación ante fallos de tareas en MaxCompute

MaxCompute Writer garantiza la idempotencia de escritura al configurar "truncate": true. Cuando una escritura falla y se vuelve a ejecutar, MaxCompute Writer borra los datos anteriores e importa los nuevos, lo que garantiza la consistencia de los datos después de cada reejecución. Si la tarea se interrumpe debido a otras excepciones durante la ejecución, no se garantiza la atomicidad de los datos. Los datos no se revierten ni se vuelven a ejecutar automáticamente. Aproveche la función de idempotencia para volver a ejecutar la tarea y garantizar la integridad de los datos.

Nota

Cuando truncate se establece en true, se borran todos los datos de la partición o tabla especificada. Utilice esta configuración con precaución.

La lectura de datos de una tabla de MaxCompute (ODPS) falla con el error: The download session is expired.

  • Mensaje de error:

    Code:DATAX_R_ODPS_005:Failed to read ODPS data, Solution:[Please contact the ODPS administrator]. RequestId=202012091137444331f60b08cda1d9, ErrorCode=StatusConflict, ErrorMessage=The download session is expired.

  • Causa posible:

    Cuando la sincronización por lotes lee datos de MaxCompute, utiliza el comando tunnel de MaxCompute para cargar y descargar datos. Una sesión de Tunnel tiene una duración de 24 horas en el servidor. Por lo tanto, si una tarea de sincronización por lotes se ejecuta durante más de 24 horas, fallará. Para obtener más información sobre tunnel, consulte Tunnel overview.

  • Solución:

    Aumente la concurrencia de la tarea de sincronización por lotes y planifique adecuadamente el volumen de datos para asegurar que la tarea finalice en menos de 24 horas.

La escritura en MaxCompute (ODPS) falla con un error de bloque: Error writing request body to server

  • Mensaje de error:

    Code:[OdpsWriter-09], Description:[Failed to write data to the ODPS destination table.]. - Failed to write block:0 to the ODPS destination table, uploadId=[202012081517026537dc0b0160354b]. Please contact the ODPS administrator for assistance. - java.io.IOException: Error writing request body to server。

  • Causa posible:

    • Causa posible 1: Excepción de tipo de datos, lo que significa que los datos de origen no cumplen con las especificaciones de tipo de datos de ODPS. Por ejemplo, escribir el valor 4.2223 en un tipo de datos decimal(18,10) en ODPS.

    • Causa posible 2: Excepción de bloque o de comunicación en ODPS.

  • Solución:

    Convierta los tipos de datos y utilice datos que cumplan con las especificaciones de tipo de datos.

La sincronización por lotes de una base de datos completa hacia MaxCompute falla con el error: cdc mode not supported

  • Escenario: Una tarea de sincronización por lotes de una base de datos completa hacia MaxCompute falla con ErrorCode=MethodNotAllowed, ErrorMessage=cdc mode not supported.

  • Causa posible: Los atributos transaccionales o de captura de datos modificados (CDC) de la tabla de destino de MaxCompute podrían no coincidir con el modo de escritura que utiliza la tarea de sincronización.

  • Solución: Compruebe si la tabla de destino se creó con atributos CDC o transaccionales que sean incompatibles con el modo de escritura de la tarea de sincronización actual. Si no está seguro de los atributos de la tabla, contacte al soporte técnico para confirmarlo.

¿Por qué el Serverless resource group no está disponible al seleccionar el Tunnel resource group para un destino de MaxCompute?

  • Escenario: Al configurar una tarea de sincronización por lotes con MaxCompute como destino, el selector Tunnel resource group en la configuración del destino no muestra ningún Serverless resource group adquirido.

  • Causa: El Tunnel resource group y el resource group que ejecuta la tarea de sincronización, como un Serverless resource group, son dos elementos de configuración independientes con propósitos distintos. El Tunnel resource group se utiliza exclusivamente para la transmisión de carga y descarga de datos de MaxCompute y, de forma predeterminada, emplea el recurso de transmisión público, es decir, la cuota de MaxCompute Tunnel. El resource group que ejecuta la tarea se utiliza únicamente para ejecutar la tarea de sincronización en sí, lo que incluye la lectura del origen, el procesamiento de datos y la programación. Dado que ambas configuraciones tienen propósitos diferentes, son independientes y no pueden usarse de manera intercambiable.

Nota

Las opciones del selector de Tunnel resource group provienen de las cuotas de transmisión de MaxCompute Tunnel disponibles para su cuenta. No son intercambiables con los resource groups que ejecutan las tareas de sincronización.

MySQL

Cómo sincronizar tablas MySQL fragmentadas en una sola tabla de MaxCompute

Consulte el siguiente documento para conocer los detalles de configuración: Synchronize sharded MySQL tables to MaxCompute.

¿Cómo manejo los caracteres chinos ilegibles al sincronizar hacia una tabla MySQL con el conjunto de caracteres utf8mb4?

Agregue el origen de datos mediante una cadena de conexión. Se recomienda modificar la URL de JDBC a: jdbc:mysql://xxx.x.x.x:3306/database?com.mysql.jdbc.faultInjection.serverCharsetIndex=45. Para obtener más información, consulte Add a MySQL data source.

La escritura o lectura en MySQL falla con errores: Application was streaming results when the connection failed. Consider raising value of 'net_write_timeout/net_read_timeout' on the server.

  • Causa del error:

    • net_read_timeout: DataX divide los datos de MySQL en varios comandos SELECT del mismo tamaño según el SplitPk. Durante la ejecución, uno de estos comandos SQL supera el tiempo máximo de ejecución permitido en RDS.

    • net_write_timeout: el tiempo de espera para enviar un bloque al cliente está configurado con un valor demasiado bajo.

  • Solución:

    Agregue el parámetro a la URL de conexión del origen de datos, establezca net_write_timeout o net_read_timeout con un valor mayor, o ajuste el parámetro desde la consola de RDS.

  • Sugerencia de mejora:

    Si la tarea se puede volver a ejecutar, configúrela para que se reinicie automáticamente cuando ocurra un error.

Por ejemplo: jdbc:mysql://192.168.1.1:3306/lizi?useUnicode=true&characterEncoding=UTF8&net_write_timeout=72000

La sincronización por lotes hacia MySQL falla con errores: [DBUtilErrorCode-05]ErrorMessage: Code:[DBUtilErrorCode-05]Description:[Failed to write data to the configured destination table.]. - com.mysql.jdbc.exceptions.jdbc4.MySQLNonTransientConnectionException: No operations allowed after connection closed

Causa del error:

El parámetro de MySQL wait_timeout tiene un valor predeterminado de 8 horas. Si aún se están obteniendo datos cuando se alcanza este límite, la tarea de sincronización se interrumpe.

Solución:

Modifique el archivo de configuración de MySQL my.cnf (o my.ini en Windows). Agregue el parámetro dentro del módulo de MySQL, expresado en segundos: wait_timeout=2592000 interactive_timeout=2592000. Luego, reinicie MySQL, inicie sesión y ejecute el siguiente comando para comprobarlo: show variables like '%wait_time%'.

La lectura de la base de datos MySQL falla con errores: The last packet successfully received from the server was 902,138 milliseconds ago

Un uso normal de CPU combinado con un consumo alto de memoria puede provocar que se cierre la conexión.

Si comprueba que la tarea admite reintentos automáticos, se recomienda habilitar Auto Rerun on Error. Para obtener más información, consulte Configure auto rerun.

PostgreSQL

La lectura de datos de PostgreSQL falla con errores: org.postgresql.util.PSQLException: FATAL: terminating connection due to conflict with recovery

  • Escenario: cuando la herramienta de sincronización por lotes lee datos de PostgreSQL, aparece el siguiente error: org.postgresql.util.PSQLException: FATAL: terminating connection due to conflict with recovery

  • Posible causa: este error ocurre porque extraer los datos de la base de datos toma demasiado tiempo. Aumente los valores de max_standby_archive_delay y max_standby_streaming_delay. Para obtener más información, consulte Eventos del servidor en espera.

La sincronización en tiempo real de AWS PostgreSQL a MaxCompute falla con un error de privilegio REPLICATION faltante

  • Escenario: una tarea de sincronización en tiempo real de AWS PostgreSQL a MaxCompute falla porque el usuario de PostgreSQL de origen no cuenta con el privilegio REPLICATION.

  • Posible causa: al usuario de PostgreSQL de origen le falta el privilegio REPLICATION. En algunas instancias administradas de AWS RDS PostgreSQL, este atributo no se puede otorgar mediante ALTER ROLE.

  • Solución: la sincronización por lotes (sin conexión y programada) no requiere el privilegio REPLICATION. Si no es posible otorgar este privilegio en su instancia de AWS PostgreSQL, utilice una tarea de sincronización por lotes con programación periódica como alternativa a la sincronización en tiempo real.

Aparece una desviación de zona horaria después de sincronizar una columna timestamp de PostgreSQL con una columna DATETIME de MaxCompute

  • Escenario: tras sincronizar una columna timestamp (sin zona horaria) de PostgreSQL con una columna DATETIME de MaxCompute, el valor resultante presenta un desfase respecto al esperado, por ejemplo, de 2 horas.

  • Posible causa: el tipo timestamp (sin zona horaria) de PostgreSQL almacena el valor de hora local tal cual. El tipo DATETIME de MaxCompute guarda los valores en UTC y los convierte para mostrarlos según la zona horaria del proyecto o de la sesión. Esta diferencia en el almacenamiento y la conversión genera la desviación.

  • Solución:

    1. Compruebe si la zona horaria del servidor de PostgreSQL coincide con la del proyecto de MaxCompute. Puede consultarla ejecutando SHOW timezone;. La zona horaria del proyecto se visualiza en la página Basic Information del proyecto de MaxCompute.

    2. Si las zonas horarias difieren, configure la zona horaria en los ajustes avanzados de la tarea de sincronización por lotes. Establezca la zona horaria de la tarea para que coincida con la del servidor de PostgreSQL. De esta manera, los valores timestamp se analizan sintácticamente en esa zona horaria antes de escribirse en MaxCompute, lo que elimina la desviación.

      Una discrepancia de zona horaria entre el origen y el destino suele manifestarse como un desfijo fijo de N horas en todos los campos de tiempo. Por ejemplo, ambos extremos están configurados en Asia/Bangkok pero los valores sincronizados difieren en 1 hora, o bien el resource group se ejecuta en Alemania y usa Europe/Berlin de forma predeterminada mientras que su negocio requiere almacenar los valores en UTC. En estos casos, seleccione la zona horaria que desea utilizar en los ajustes avanzados de la tarea.

    Nota

    Cambiar la zona horaria de programación no afecta la zona horaria que utiliza el proceso de Data Integration, ya que ambas configuraciones son independientes. Si las columnas de fecha siguen devolviendo valores inesperados después de ajustar la zona horaria de programación, establezca también la zona horaria de forma explícita en los ajustes avanzados de la tarea de sincronización por lotes.

    La configuración de zona horaria tiene GMT+8 como valor predeterminado. Consérvela así cuando los campos de tiempo se sincronicen correctamente y modifíquela a la zona horaria esperada por su negocio únicamente cuando exista un desfase horario. En modo script, esta configuración equivale a lo siguiente:

    "common":{"column":{"timeZone":"Asia/Bangkok"}}

¿Cómo utilizo la función TO_TIMESTAMP para la extracción incremental basada en tiempo en una tarea de sincronización por lotes de PostgreSQL?

  • Escenario: al configurar una condición WHERE o un comando personalizado querySql para la sincronización incremental desde PostgreSQL, necesita convertir un parámetro de tiempo en formato de cadena a una marca de tiempo para realizar la comparación.

  • Solución: utilice la función estándar de PostgreSQL TO_TIMESTAMP en lugar de la función de MySQL STR_TO_DATE, dado que PostgreSQL y MySQL emplean dialectos SQL distintos para convertir cadenas de fecha y hora. Por ejemplo:

    TO_TIMESTAMP('${start_time}', 'YYYYMMDDHH24')
    TO_TIMESTAMP('${end_time}', 'YYYYMMDDHH24')

    TO_TIMESTAMP convierte una cadena con el formato especificado en un objeto de marca de tiempo. Posteriormente, este objeto permite filtrar filas dentro de un rango de tiempo en la condición WHERE o en el comando querySql.

Oracle

La sincronización por lotes desde Oracle falla con errores: ORA-00932: inconsistent datatypes en la cláusula WHERE

  • Escenario: cuando una tarea de sincronización por lotes lee datos de Oracle con una condición WHERE, la tarea falla con el error ORA-00932: inconsistent datatypes.

  • Posible causa: la cláusula WHERE compara directamente una columna DATE de Oracle con un valor NUMBER, por ejemplo, un literal de fecha escrito como un número simple. Esta comparación provoca una incompatibilidad de tipos de datos en Oracle.

  • Solución: convierta explícitamente el valor numérico de fecha al tipo DATE antes de la comparación. Por ejemplo, utilice TO_DATE('20250611', 'YYYYMMDD') o el literal DATE '2025-06-11' en la condición WHERE en lugar de comparar la columna con un número simple.

RDS

La sincronización por lotes falla cuando el origen es Amazon RDS con el error: Host is blocked

Si al conectarse a Amazon RDS recibe el error Host is blocked, deshabilite la comprobación de estado del load balancer de Amazon. Una vez deshabilitada, el problema de bloqueo dejará de presentarse.

MongoDB

Error al agregar un origen de datos de MongoDB con el usuario root

Al agregar un origen de datos de MongoDB, utilice un usuario creado en la base de datos que contiene las tablas por sincronizar. El usuario root no es compatible.

Por ejemplo, si desea importar la tabla name y esta se encuentra en la base de datos test, el nombre de la base de datos debe ser test y es necesario usar el nombre de un usuario creado dentro de dicha base de datos.

¿Cómo uso una marca de tiempo en el parámetro de consulta para implementar la sincronización incremental al leer MongoDB?

Utilice un nodo de asignación para convertir primero un valor de tipo fecha a una marca de tiempo y luego pase ese valor como parámetro de entrada a la tarea de sincronización de datos de MongoDB.

La zona horaria presenta un desfase de 8 horas después de sincronizar MongoDB con un origen de datos de destino. ¿Cómo lo soluciono?

Establezca la zona horaria en la configuración de MongoDB Reader. Para obtener más información, consulte MongoDB Reader.

Los registros actualizados en el origen durante la lectura de datos de MongoDB no se sincronizan con el destino. ¿Cómo lo soluciono?

Reinicie la tarea después de un retraso sin modificar las condiciones de consulta. Es decir, retrase el momento de ejecución manteniendo la configuración intacta.

¿MongoDB Reader distingue entre mayúsculas y minúsculas?

Durante la lectura de datos, el valor Column.name configurado por el usuario distingue entre mayúsculas y minúsculas. Una configuración incorrecta provoca que los datos leídos sean nulos. Por ejemplo:

  • Datos de origen en MongoDB:

    {
        "MY_NAME": "zhangsan"
    }
  • Configuración de columnas de la tarea de sincronización:

    {
        "column":
        [
            {
                "name": "my_name"
            }
        ]
    }

Dado que el uso de mayúsculas y minúsculas en la configuración de columnas no coincide con los datos de origen, la lectura falla.

¿Cómo configuro el tiempo de espera de MongoDB Reader?

El parámetro de configuración del tiempo de espera es cursorTimeoutInMs, cuyo valor predeterminado es 600000 ms (10 minutos). Este parámetro indica el tiempo total que MongoDB Server dedica a ejecutar la consulta, sin incluir el tiempo de transferencia de datos. Si la lectura completa abarca un volumen grande de datos, podría aparecer el siguiente error: MongoDBReader$Task - operation exceeded time limitcom.mongodb.MongoExecutionTimeoutException: operation exceeded time limit.

La lectura de MongoDB falla con errores: no master

Actualmente, las tareas de sincronización de DataWorks no admiten la lectura de datos desde un nodo secundario. Si configura un nodo secundario para la lectura, se produce el siguiente error: no master.

La lectura de MongoDB falla con errores: MongoExecutionTimeoutException: operation exceeded time limit

  • Análisis de la causa principal:

    Se origina por el agotamiento del tiempo de espera del cursor.

  • Solución:

    Aumente el valor del parámetro cursorTimeoutInMs.

La lectura de la sincronización por lotes desde MongoDB falla con errores: DataXException: operation exceeded time limit

Aumente la simultaneidad de la tarea y el BatchSize de lectura.

La tarea de sincronización de MongoDB falla con errores: no such cmd splitVector

  • Posible causa:

    De forma predeterminada, la tarea de sincronización utiliza el comando splitVector para fragmentar la tarea. Algunas versiones de MongoDB no admiten el comando splitVector, lo que desencadena el error no such cmd splitVector.

  • Solución:

    1. Vaya a la página de configuración de la tarea de sincronización y haga clic en el botón Convert to Script Convert to Script ubicado en la parte superior. Cambie la tarea al modo script.

    2. En la configuración de parámetros de MongoDB, agregue el siguiente parámetro:

      "useSplitVector" : false

      Esto evita el uso de splitVector.

La sincronización por lotes de MongoDB falla con errores: After applying the update, the (immutable) field '_id' was found to have been altered to _id: "2"

  • Mensaje de error:

    En la tarea de sincronización, tomando como ejemplo el modo asistente, este problema puede surgir cuando Write Mode (Overwrite) se establece en Yes y se configura una columna distinta de _id como Business Key.

    En la configuración de destino de la tarea de sincronización, seleccione el origen de datos de MongoDB (nombre de la instancia: xc_mongo_rds), establezca el nombre de la colección en xc_timestamp, habilite el modo de sobrescritura (establezca 'Overwrite' en Yes) y especifique my_id como clave principal de negocio."

  • Posible causa:

    Los datos que se escriben contienen registros cuyo _id no coincide con la Business Key configurada (como my_id en el ejemplo anterior).

  • Solución:

    • Opción 1: modifique la tarea de sincronización por lotes para asegurar que la Business Key configurada sea idéntica a _id.

    • Opción 2: utilice _id como clave principal de negocio durante la sincronización de datos.

Redis

La escritura en Redis en modo hash falla con errores: Code:[RedisWriter-04], Description:[Dirty data]. - source column number is in valid!

  • Causa:

    Cuando Redis utiliza el modo hash para el almacenamiento, los atributos y los valores del hash deben aparecer en pares. Por ejemplo: odpsReader: "column":[ "id", "name", "age", "address" ]. En el destino, si RedisWriter se configura como: "keyIndexes":[ 0, 1], entonces en Redis id y name actúan como la clave, age funciona como el atributo y address representa el valor dentro del tipo hash. Si solo se configuran dos columnas en el origen de ODPS, no es posible usar el modo hash para el almacenamiento en Redis y se lanza esta excepción.

  • Solución:

    Si solo desea utilizar dos columnas, configure el modo String de Redis para el almacenamiento. Si resulta obligatorio emplear el modo hash, configure como mínimo tres columnas en el lado del origen.

OSS

¿Cómo gestiono los datos incorrectos al leer archivos CSV con delimitadores de varios caracteres?

  • Síntoma:

    Al configurar una tarea de sincronización por lotes para leer datos de un almacenamiento de archivos como OSS o FTP, si el archivo tiene formato CSV y emplea varios caracteres como delimitador de columnas (por ejemplo, |,, ## o ;;), la tarea puede fallar con un error de datos incorrectos. En el registro de ejecución, observará un error IndexOutOfBoundsException acompañado de datos incorrectos.

  • Análisis de la causa principal:

    El lector integrado csv ("fileFormat": "csv") de DataWorks presenta limitaciones al procesar delimitadores de varios caracteres, lo que genera una división imprecisa de columnas en las filas de datos.

  • Solución:

    • Modo asistente: cambie el tipo de texto a text y especifique de forma explícita el delimitador de varios caracteres.

    • Modo script: cambie "fileFormat": "csv" por "fileFormat": "text" y defina correctamente el delimitador: "fieldDelimiter":"<multi-char delimiter>", "fieldDelimiterOrigin":"<multi-char delimiter>".

¿Existe un límite en la cantidad de archivos al leer archivos de OSS?

La sincronización por lotes no limita por sí misma la cantidad de archivos que lee el plugin OSS Reader. La restricción principal proviene de los recursos de CU que consume la tarea. Leer demasiados archivos de forma simultánea provoca fácilmente errores de falta de memoria. Por lo tanto, no se recomienda configurar el parámetro object como: *, con el fin de evitar errores OutOfMemoryError: Java heap space .

¿Cómo quito las cadenas aleatorias de los nombres de archivo al escribir en OSS?

OSS Writer escribe los nombres de archivo simulando directorios mediante los nombres de los objetos. OSS impone restricciones sobre dichos nombres. Al usar "object": "datax", los objetos escritos comienzan con datax y llevan cadenas aleatorias agregadas como sufijo. La cantidad de archivos depende del número real de tareas divididas.

Si no necesita los sufijos UUID aleatorios, configure "writeSingleObject" : "true". Para obtener más información, consulte la descripción del parámetro writeSingleObject en la documentación de OSS Writer.

La lectura de datos de OSS falla con errores: AccessDenied The bucket you access does not belong to you.

  • Causa:

    El AccessKey configurado para el origen de datos no cuenta con permisos sobre el bucket.

  • Solución:

    Otorgue permisos de lectura sobre el bucket a la cuenta del AccessKey configurada para el origen de datos de OSS.

Hive

La sincronización por lotes hacia Hive local falla con errores: Could not get block locations.

  • Análisis de la causa principal:

    Es posible que el parámetro mapred.task.timeout tenga un valor demasiado bajo. Esto provoca que Hadoop finalice la tarea y limpie el directorio temporal, lo que deja los datos temporales inaccesibles.

  • Solución:

    En la sección de origen de datos de la tarea de sincronización por lotes, si Hive read methods está establecido en Read Data Based on Hive JDBC (Supports Conditional Filtering), defina el valor del parámetro mapred.task.timeout dentro de Session Configuration, por ejemplo, mapred.task.timeout=600000.

DataHub

¿Cómo gestiono los errores de escritura cuando el volumen de datos en una sola escritura hacia DataHub supera el límite?

  • Mensaje de error:

    ERROR JobContainer - Exception when job runcom.alibaba.datax.common.exception.DataXException: Code:[DatahubWriter-04], Description:[Failed to write data.]. - com.aliyun.datahub.exception.DatahubServiceException: Record count 12498 exceed max limit 10000 (Status Code: 413; Error Code: TooLargePayload; Request ID: 20201201004200a945df0bf8e11a42)

  • Posible causa:

    El error ocurre porque el volumen de datos que DataX envía a DataHub en un solo lote excede el límite de DataHub. Los principales parámetros de configuración que afectan dicho volumen son:

    • maxCommitSize: define el tamaño acumulado de los datos en búfer. Cuando los datos acumulados alcanzan el valor de maxCommitSize (en MB), se envían al destino en un solo lote. El valor predeterminado es 1 MB (1,048,576 bytes).

    • batchSize: define la cantidad acumulada de registros de datos en búfer para DataX-On-Flume. Cuando el conteo de registros acumulados llega al batchSize, los datos se envían al destino en un solo lote.

  • Solución:

    Reduzca los valores de los parámetros maxCommitSize y batchSize.

LogHub

Una columna contiene datos en LogHub, pero aparece vacía después de la sincronización

Este plugin distingue entre mayúsculas y minúsculas en los nombres de las columnas. Revise la configuración de columnas de LogHub Reader.

Faltan datos al leer desde LogHub

Data Integration utiliza el momento en que los datos ingresan a LogHub. Consulte la consola de LogHub para comprobar si la columna de metadatos receive_time se encuentra dentro del rango de tiempo configurado para la tarea.

Las columnas leídas durante la asignación de columnas de LogHub no coinciden con lo esperado

Si esto ocurre, edite manualmente la configuración de columnas en la interfaz.

¿Por qué el valor leído de **__time__** queda fuera del rango de tiempo configurado, o por qué el conteo de registros de la consola para el mismo rango difiere del de la tarea de sincronización?

La hora de inicio y la hora de finalización configuradas en la tarea de sincronización por lotes permiten que el Reader llame a la API GetCursor de SLS para ubicar los cursores inicial y final. Este tiempo sirve para determinar el rango de lectura con base en la hora de recepción del lado del servidor de SLS. La tarea lee realmente los datos comprendidos dentro del rango de cursores, lo cual no equivale a filtrar por la columna de salida __time__.

La columna de salida __time__ proviene de log.getTime() de cada entrada de registro y representa la hora propia del registro. Las consultas en la consola de SLS suelen emplear el rango de tiempo de consulta, los comandos de consulta y las columnas de índice para generar estadísticas, generalmente basadas en la hora del registro __time__. Por lo tanto, incluso si la tarea de sincronización y la consola utilizan los mismos valores de tiempo, el rango de __time__ o el conteo de registros pueden diferir cuando ambos lados recurren a métricas de tiempo distintas.

Escenarios comunes:

  1. Cuando la recopilación o entrega de registros sufre retrasos, se rellenan registros históricos o los relojes de los clientes son imprecisos, la hora del registro __time__ puede ser anterior o posterior a la hora de recepción del servidor de SLS. La tarea de sincronización ubica los cursores según la hora de recepción del servidor, mientras que la consola realiza consultas basadas en __time__, lo que puede producir resultados diferentes.

  2. Cuando los datos se escriben en otro logstore mediante la transformación de datos de SLS, si el comando de transformación no establece explícitamente __time__, el __time__ del registro de destino suele conservar la hora del registro de origen en lugar de la hora de ejecución de la transformación. En este caso, la tarea de sincronización podría leer este lote de datos dentro del rango de tiempo en que la transformación escribe en el logstore de destino. Sin embargo, al consultar la consola del logstore de destino por la hora de ejecución de la transformación o por el rango de tiempo actual, es posible que estos registros no aparezcan. Resulta necesario consultar utilizando el rango real de __time__ de los registros.

  3. Cuando el comando de consulta de la consola, las columnas de índice, el rango de tiempo y el comando de filtrado de reglas (SPL) de la tarea de sincronización no coinciden, los conteos de registros pueden diferir aunque las métricas de tiempo sean iguales.

Sugerencias para la solución de problemas:

  1. Compruebe si el rango de tiempo de consulta de la consola, el comando de consulta, las columnas de índice, así como la hora de inicio y finalización y el comando de filtrado de reglas (SPL) de la tarea de sincronización coinciden entre sí.

  2. Incluya tanto __time__ (hora del registro) como __tag__:__receive_time__ (el campo observable para la hora de recepción del servidor de SLS, que requiere que este campo exista en las etiquetas del registro) en la configuración de column para comparar la hora del registro con la hora de recepción del servidor.

  3. Si los datos provienen de una transformación de datos de SLS, verifique si el comando de transformación establece explícitamente __time__ y ajuste el rango de tiempo de consulta en la consola del logstore de destino según el __time__ real.

  4. Si el sistema descendente requiere una conciliación estricta por hora de registro, filtre o agregue los datos por __time__ después de escribirlos en el destino.

Ejemplo: el __time__ del registro de origen es 2026-06-01 10:00:00. Una tarea de transformación de datos de SLS escribe este registro en el logstore de destino a las 2026-06-12 10:00:00 sin modificar explícitamente __time__. El __time__ del registro de destino permanece como 2026-06-01 10:00:00. Si las horas de inicio y finalización de la tarea de sincronización cubren 2026-06-12 10:00:00, la tarea podría leer este registro. No obstante, al consultar el logstore de destino en la consola alrededor de 2026-06-12 10:00:00 usando __time__ como filtro, es probable que el registro no aparezca. En este caso, ajuste la hora de consulta de la consola cerca de 2026-06-01 10:00:00 o establezca explícitamente el __time__ del registro de destino durante la transformación de datos, según sus necesidades.

¿Por qué una columna muestra un valor en la consulta de la consola de LogHub, pero aparece vacía después de la sincronización?

El Reader hace coincidir los nombres de columna a partir de los campos reales del contenido del registro extraído, las asignaciones de metacampos integradas del Reader y LogTag, todo ello según la configuración de column. Los nombres de columna distinguen entre mayúsculas y minúsculas. Si no encuentra coincidencia, emite null sin generar un error.

Entre las causas comunes se incluyen:

  1. El nombre de columna configurado en column tiene un uso de mayúsculas y minúsculas distinto al de la clave original del campo del registro.

  2. La consola muestra alias provenientes del análisis de consultas, campos de índice o campos JSON expandidos, los cuales difieren de la clave original del registro que el Reader recupera realmente.

  3. La columna proviene en realidad de LogTag y debe configurarse como __tag__:<tagKey>.

  4. Después de configurar un comando de filtrado de reglas (SPL) o una transformación, los nombres de los campos de salida no coinciden por completo con la configuración de column.

Al solucionar problemas, revise primero las columnas de la tabla de origen y la vista previa de datos en la página visual para confirmar los campos que el Reader identifica realmente. En modo script, también puede establecer temporalmente column como ["*"] para observar las claves reales de los campos del contenido del registro recuperadas por el Reader y, posteriormente, configurar column con base en las claves originales.

Lindorm

Al usar el modo masivo de Lindorm para escribir datos, ¿se reemplazan los datos históricos cada vez?

El comportamiento es idéntico a la lógica de escritura de la API: los datos de la misma fila y la misma columna se sobrescriben, mientras que el resto permanece sin cambios.

Elasticsearch

¿Cómo consulto todas las columnas de un índice de ES?

Obtenga el mapping del índice de ES con el comando curl y extraiga todas las columnas a partir de ese mapping.

  • Comando de shell para la consulta:

    //es7
    curl -u username:password --request GET 'http://esxxx.elasticsearch.aliyuncs.com:9200/indexname/_mapping'
    //es6
    curl -u username:password --request GET 'http://esxxx.elasticsearch.aliyuncs.com:9200/indexname/typename/_mapping'
  • Extracción de las columnas del resultado:

    {
        "indexname": {
            "mappings": {
                "typename": {
                    "properties": {
                        "field1": {
                            "type": "text"
                        },
                        "field2": {
                            "type": "long"
                        },
                        "field3": {
                            "type": "double"
                        }
                    }
                }
            }
        }
    }

    Las columnas y las definiciones de atributos dentro de properties en la respuesta corresponden a todas las columnas del índice. Por ejemplo, el índice anterior contiene tres columnas: field1, field2 y field3.

¿Cómo configuro el nombre del índice al sincronizar datos de ES a otros orígenes de datos con nombres de índice diarios distintos?

Agregue parámetros de programación de fechas a la configuración del índice. De esta forma, la cadena del índice se calcula automáticamente según la fecha y el nombre del índice de Elasticsearch Reader cambia sin intervención manual. La configuración consta de tres pasos: definir los parámetros de fecha, configurar los parámetros del índice y desplegar y ejecutar la tarea.

  1. Defina los parámetros de fecha: en la configuración de programación de la tarea de sincronización, agregue parámetros para definir las fechas. En el siguiente ejemplo, var1 representa la hora de ejecución de la tarea (el día actual) y var2 representa la fecha de negocio (el día anterior).

  2. Configure los parámetros del índice: cambie la tarea al modo script y configure el índice de Elasticsearch Reader con el formato ${nombre_variable}, como se muestra a continuación.

    {
        "type": "job",
        "version": "2.0",
        "steps": [
            {
                "stepType": "elasticsearch",
                "parameter": {
                    "retryCount": 30,
                    "scroll": "10m",
                    "column": [
                        "col18",
                        "col17"
    
                    ],
                    "index": "esstress_1_${var1}_${var2}",
                    "pageSize": 100,
                    "sort": {
                        "_id": "asc"
                    },
  3. Despliegue y ejecute la tarea: después de comprobar que todo es correcto, envíe y despliegue la tarea en Operation Center. Luego, ejecútela como una programación periódica o como una tarea de backfill data.

    1. Haga clic en el botón Running with Parameters para ejecutar la tarea directamente y verificarla. Al ejecutar con parámetros se reemplazan los parámetros del sistema de programación utilizados en la configuración de la tarea. Una vez finalizada la ejecución, revise los registros para comprobar si el índice sincronizado cumple con lo esperado.

      Nota

      Cuando ejecute con parámetros, introduzca los valores directamente para realizar la prueba de reemplazo.

    2. Si el paso anterior da el resultado esperado, la configuración de la tarea está completa. Haga clic en Save y luego en Commit para enviar la tarea de sincronización al entorno de producción.

      En un espacio de trabajo en modo estándar, haga clic en Deploy para ir a Deployment Center y desplegar la tarea de sincronización en el entorno de producción.

  4. Resultado: a continuación se muestra la configuración y el resultado real del índice durante la ejecución.

    Configuración del índice en el script: "index": "esstress_1_${var1}_${var2}".

    Índice resuelto durante la ejecución: esstress_1_20230106_20230105.

    ],
    "full":false,
    "gmtCreate":"2022-07-18 14:47:18",
    "gmtModified":"2022-07-18 14:47:18",
    "index":"esstress_1_20230106_20230105",
    "instanceId":"es-cn-2r42se1je001zwmt0",
    "ownerId":"1224800975333052",
    "pageSize":100,
    "password":"********",
    "privateNetworkIpWhiteList":[
        "0.0.0.0/0"
    ],

¿Cómo sincroniza Elasticsearch Reader las propiedades de campos Object o Nested? (Por ejemplo, sincronizar object.field1)

Para sincronizar las propiedades de un campo de objeto, utilice exclusivamente el modo script. En este modo, configure multi de la siguiente manera y especifique column con el formato atributo.subatributo.

"multi":{
   "multi":true 
 }

Consulte el siguiente ejemplo para la configuración:

#Example:
##Data in Elasticsearch
"hits": [
    {
        "_index": "mutiltest_1",
        "_type": "_doc",
        "_id": "7XAOOoMB4GR_1Dmrrust",
        "_score": 1.0,
        "_source": {
            "level1": {
                "level2": [
                    {
                        "level3": "testlevel3_1"
                    },
                    {
                        "level3": "testlevel3_2"
                    }
                ]
            }
        }
    }
]
##Reader configuration
"parameter": {
  "column": [
      "level1",
      "level1.level2",
      "level1.level2[0]"
  ],
  "multi":{
        "multi":true
    }
}
##Writer result: 1 row with 3 columns, column order matches reader configuration
COLUMN              VALUE
level1:             {"level2":[{"level3":"testlevel3_1"},{"level3":"testlevel3_2"}]}
level1.level2:      [{"level3":"testlevel3_1"},{"level3":"testlevel3_2"}]
level1.level2[0]:   {"level3":"testlevel3_1"}

Después de sincronizar datos de tipo string de ODPS a ES, las comillas parecen faltar en ambos extremos. ¿Cómo soluciono esto? ¿Es posible sincronizar una cadena de tipo JSON del origen como un objeto NESTED de ES?

  1. Las comillas dobles adicionales que aparecen antes y después de los caracteres son un problema de visualización en Kibana. Los datos reales no incluyen estas comillas dobles al inicio ni al final. Utilice el comando curl o Postman para consultar los datos reales. El comando curl para recuperar los datos es el siguiente:

    //es7
    curl -u username:password --request GET 'http://esxxx.elasticsearch.aliyuncs.com:9200/indexname/_mapping'
    //es6
    curl -u username:password --request GET 'http://esxxx.elasticsearch.aliyuncs.com:9200/indexname/typename/_mapping'
  2. Configure el tipo de la columna de escritura de ES como nested para sincronizar datos de cadena de tipo JSON de ODPS a ES en formato nested. En el siguiente ejemplo se sincroniza la columna name a ES en formato nested.

    • Configuración de la sincronización: establezca el tipo de name como nested.

    • Resultado de la sincronización: name es un tipo de objeto nested.

      "total": {
          "value": 1,
          "relation": "eq"
      },
      "max_score": 1.0,
      "hits": [
          {
              "_index": "test",
              "_type": "_doc",
              "_id": "bb5oqoUBlqHPyI16REEQ",
              "_score": 1.0,
              "_source": {
                  "name": [
                      {
                          "fields1": "value"
                      }
                  ]
              }
          }
      ]
      }

Los datos de origen son **string "[1,2,3,4,5]"**. ¿Cómo los sincronizo a ES como una matriz?

Existen dos métodos de configuración para escribir tipos de matriz en ES. Elija el método de sincronización adecuado según el formato de los datos de origen.

  • Escriba en ES como un tipo de matriz mediante el análisis sintáctico de los datos de origen como JSON. Por ejemplo, si los datos de origen son "[1,2,3,4,5]", configure json_array=true para analizarlos y escribirlos en la columna de ES como una matriz. Configure ColumnList con json_array=true.

    • Configuración en modo asistente.

    • Configuración en modo script:

      "column":[
        {
          "name":"docs",
          "type":"keyword",
          "json_array":true
        }
      ]
  • Escriba en ES como un tipo de matriz mediante el análisis sintáctico de los datos de origen con un delimitador. Por ejemplo, si los datos de origen son "1,2,3,4,5", configure un delimitador splitter="," para analizarlos y escribirlos en la columna de ES como una matriz.

    • Limitaciones:

      • Una tarea admite un solo delimitador. El parámetro splitter es único a nivel global y no permite usar delimitadores distintos para diferentes columnas de matriz. Por ejemplo, si las columnas de origen son col1="1,2,3,4,5" , col2="6-7-8-9-10", no es posible configurar un splitter independiente para cada columna.

      • El parámetro splitter se puede configurar como una expresión regular. Por ejemplo, si el valor de la columna de origen es "6-,-7-,-8+,*9-,-10", configure splitter:".,.". Esta opción es compatible con el modo asistente.

    • Configuración en modo asistente: splitter tiene el valor predeterminado "-,-".

    • Configuración en modo script:

      "parameter" : {
            "column": [
              {
                "name": "col1",
                "array": true,
                "type": "long"
              }
            ],
            "splitter":","
      }

Al escribir datos en ES, primero se envía una solicitud sin autenticación, pero el servicio exige autenticación y la solicitud falla. Como consecuencia, se registran todos los datos de las solicitudes enviadas y se genera un gran volumen de registros de auditoría diarios. ¿Cómo soluciono esto?

  • Análisis de la causa raíz:

    HttpClient establece que, cada vez que se crea una conexión, primero se envía una solicitud sin autenticación. Después de que el servidor devuelve el requisito de autenticación (donde especifica el método de autenticación según la respuesta), se envía una solicitud autenticada. Dado que cada escritura de datos en ES requiere establecer una conexión, cada operación genera una solicitud sin autenticación que queda registrada en los registros de auditoría.

  • Solución:

    Agregue la configuración "preemptiveAuth":true en el modo script.

¿Cómo sincronizo datos a ES como tipo Date?

Existen dos métodos para configurar la escritura de fechas. Elija el más adecuado según sus necesidades.

  • Escriba directamente en la columna Date de ES con base en el contenido leído por el Reader:

    • Configure origin:true para escribir el contenido leído directamente en ES.

    • Configure "format" para especificar el atributo de formato de la columna cuando se crea el mapping mediante la escritura de ES.

      "parameter" : {
          "column": [
              {
                  "name": "col_date",
                  "type": "date",
                  "format": "yyyy-MM-dd HH:mm:ss",
                  "origin": true
              }
                ]
      }
  • Conversión de zona horaria: si necesita que Data Integration convierta la zona horaria, agregue el parámetro Timezone.

    "parameter" : {
        "column": [
            {
                "name": "col_date",
                "type": "date",
                "format": "yyyy-MM-dd HH:mm:ss",
                "Timezone": "UTC"
            }
              ]
    }

Elasticsearch Writer falla al especificar una versión externa. ¿Cómo soluciono esto?

  • Se configuró type:version, pero ES no admite especificar una versión externa.

        "column":[
                                {
                                    "name":"id",
                                    "type":"version"
                                },
      ]
  • Solución:

    Elimine la configuración "type":"version". Elasticsearch Writer no admite la especificación de versiones externas.

La lectura de sincronización por lotes desde Elasticsearch falla con el error: ERROR ESReaderUtil - ES_MISSING_DATE_FORMAT, Unknown date value. please add "dataFormat". sample value:

  • Análisis de la causa raíz:

    Elasticsearch Reader no puede analizar el formato de fecha de una columna de tipo date porque el mapping de la columna de fecha correspondiente en ES no tiene un formato configurado.

  • Solución:

    • Configure el parámetro dateFormat con el mismo formato que la columna de fecha de ES y use "||" como separador. El formato debe incluir todos los formatos de tipo fecha. Por ejemplo:

      "parameter" : {
            "column": [
           			"dateCol1",
              	"dateCol2",
                "otherCol"
            ],
           "dateFormat" : "yyyy-MM-dd||yyyy-MM-dd HH:mm:ss",
      }
    • Establezca el formato de mapping para todas las columnas de fecha en la base de datos de ES.

La lectura de sincronización por lotes desde Elasticsearch falla con el error: com.alibaba.datax.common.exception.DataXException: Code:[Common-00].

  • Análisis de la causa raíz:

    Debido a las limitaciones de palabras clave de fastjson, el índice o las columnas pueden contener palabras clave como $ref.

  • Solución:

    Elasticsearch Reader no admite sincronizar índices que contienen la palabra clave $ref en los nombres de las columnas. Para obtener más información, consulte Elasticsearch Reader.

La escritura de sincronización por lotes en Elasticsearch falla con el error: version_conflict_engine_exception.

  • Análisis de la causa raíz:

    Esto activó el mecanismo de bloqueo optimista de ES. El número de versión actual debería tener un valor determinado, pero el número de versión que pasa el comando update es distinto, lo que provoca un conflicto de versiones. Durante la actualización, otro proceso estaba eliminando datos del índice.

  • Solución:

    1. Compruebe si hay operaciones de eliminación de datos en curso.

    2. Cambie el método de sincronización de la tarea de Update a Index.

La escritura de sincronización por lotes en Elasticsearch falla con el error: illegal_argument_exception.

  • Análisis de la causa raíz:

    Cuando configura atributos avanzados como similarity y properties para una columna, se requiere other_params para que el plugin los reconozca.

    "parameter":{
            "__datasource__type":"elasticsearch",
            "actionType":"index",
            "aliasMode":"append",
            "batchSize":1024,
            "cleanup":false,
            "column":[
                {
                    "name":"id",
                    "type":"long"
                },
                {
                    "name":"dim1_code",
                    "type":"keyword"
                },
                {
                    "analyzer":"china",
                    "name":"dim1_name",
                    "similarity":"len_similarity",
                    "type":"text"
                },
                {
                    "analyzer":"china",
                    "name":"dim1_val",
                    "similarity":"len_similarity",
                    "type":"text"
                },
                {
                    "name":"dim1_sort",
                    "type":"long"
                }
  • Solución:

    Configure other_params en la configuración de la columna y agregue similarity dentro de other_params, como se muestra a continuación:

    {"name":"dim2_name",...,"other_params":{"similarity":"len_similarity"}}

La sincronización por lotes de datos de una columna Array de ODPS a Elasticsearch falla con el error: dense_vector

  • Análisis de la causa raíz:

    Actualmente, la escritura de sincronización por lotes en Elasticsearch no admite el tipo dense_vector. Solo se admiten los siguientes tipos:

    ID,PARENT,ROUTING,VERSION,STRING,TEXT,KEYWORD,LONG,
    INTEGER,SHORT,BYTE,DOUBLE,FLOAT,DATE,BOOLEAN,BINARY,
    INTEGER_RANGE,FLOAT_RANGE,LONG_RANGE,DOUBLE_RANGE,DATE_RANGE,
    GEO_POINT,GEO_SHAPE,IP,IP_RANGE,COMPLETION,TOKEN_COUNT,OBJECT,NESTED;
  • Solución:

    Para los tipos que Elasticsearch Writer no admite, proceda de la siguiente manera:

    • No se recomienda usar Elasticsearch Writer para crear mappings de índices. Utilice un mapping personalizado.

    • Cambie el tipo correspondiente a NESTED.

    • Modifique la configuración a: dynamic = true, cleanup=false.

¿Por qué la configuración de Settings no surte efecto cuando Elasticsearch Writer crea un índice?

  • Causa:

    #Incorrect configuration
    "settings": {
      "index": {
        "number_of_shards": 1,
        "number_of_replicas": 0
      }
    }
    #Correct configuration
    "settings": {
      "number_of_shards": 1,
      "number_of_replicas": 0
    }
  • Solución:

    Settings solo surte efecto cuando se crea un índice, lo cual ocurre en dos casos: cuando el índice no existe o cuando cleanup=true. Cuando cleanup=true, la configuración de Settings no necesita incluir "index".

En un índice personalizado, el tipo de atributo nested es keyword, pero ¿por qué el tipo cambia a keyword después de la generación automática? (La generación automática se refiere a ejecutar una tarea de sincronización con **cleanup=true**)

#Original mappings
{
  "name":"box_label_ret",
  "properties":{
    "box_id":{
      "type":"keyword"
    }
}
#After rebuilding with cleanup=true, it becomes
{
    "box_label_ret": {
      "properties": {
        "box_id": {
          "type": "text",
          "fields": {
            "keyword": {
              "type": "keyword",
              "ignore_above": 256
            }}}}
}
  • Análisis de la causa raíz:

    Para los tipos nested, Elasticsearch Writer usa únicamente los mappings de nivel superior y permite que ES adapte automáticamente los tipos complejos anidados. El cambio del tipo de atributo a text con la adición de fields:keyword es un comportamiento de adaptación automática de ES y no afecta su uso. Si necesita un formato de mapping específico, consulte Elasticsearch Writer.

  • Solución:

    Cree los mappings de índice de ES esperados antes de la sincronización. Después, establezca cleanup en false en la tarea de sincronización de ES y ejecute la tarea.

Kafka

Se configuró endDateTime para definir el límite temporal de los datos que se sincronizan desde Kafka, pero en el destino se encuentran datos posteriores a esa hora.

Kafka Reader lee los datos en lotes. Si algún registro de un lote supera endDateTime, la sincronización se detiene. Sin embargo, los datos de ese lote que exceden endDateTime se escriben igualmente en el destino.

  • También puede usar la configuración skipExceedRecord para indicar si se sincronizan los datos excedentes. Para conocer los detalles de uso, consulte Kafka Reader. [No se recomienda deshabilitar esta sincronización, ya que podría provocar pérdida de datos.]

  • Configure el parámetro max.poll.records de Kafka para definir la cantidad de datos que se extraen en cada lote. Si combina este valor con la concurrencia, podrá controlar el volumen de datos que podría exceder el límite. El volumen excedente < max.poll.records × concurrencia.

¿Por qué la tarea sigue ejecutándose sin leer datos ni finalizar cuando hay pocos datos en Kafka?

  • Análisis de la causa raíz:

    Cuando el volumen de datos es pequeño o están distribuidos de manera desigual, algunas particiones de Kafka podrían no recibir datos nuevos o estos podrían no alcanzar el offset final especificado. Dado que la condición para salir de la tarea exige que todas las particiones alcancen el offset final indicado, estas particiones "inactivas" impiden cumplir la condición y bloquean la finalización normal de toda la tarea.

  • Solución:

    Establezca la política de fin de sincronización en 1 minuto sin leer datos nuevos (en modo script, configure stopWhenPollEmpty como true y stopWhenReachEndOffset como true). La tarea finaliza después de leer los datos del offset más reciente de todas las particiones, lo que evita que se mantenga inactiva. No obstante, los registros con marcas de tiempo anteriores al offset final configurado que se escriban después de que termine la tarea no se consumirán.

RestAPI

RestAPI Writer falla con el error: The JSON string found via path:[] is not in array format

RestAPI Writer ofrece dos modos de escritura. Cuando sincronice varios registros, establezca dataMode como multiData y agregue el parámetro dataPath:"data.list" en el script. Para obtener más información, consulte RestAPI Writer.Parameters
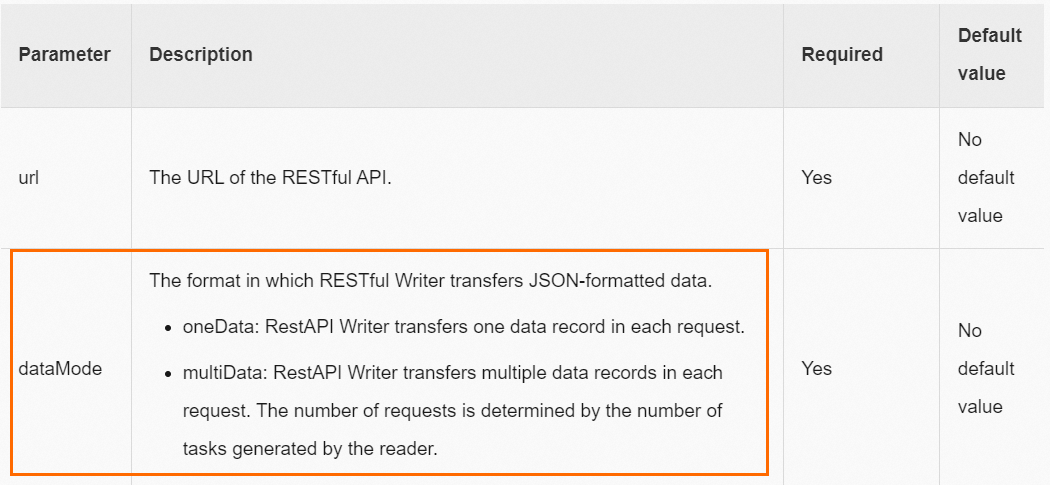
Importante

Al configurar las columnas, no agregue el prefijo "data.list".

Configuración de OTS Writer

¿Cómo configuro OTS Writer al escribir datos en una tabla de destino que contiene una columna de clave principal de incremento automático?

  1. La configuración de OTS Writer debe cumplir los dos requisitos siguientes:

    "newVersion": "true",
    "enableAutoIncrement": "true",
  2. No configure el nombre de la columna de clave principal de incremento automático en OTS Writer.

  3. La suma de las entradas de primaryKey y de column configuradas en OTS Writer debe ser igual al número de columnas de los datos de OTS Reader ascendente.

Configuración del modelo de series temporales

¿Cómo se interpretan las columnas **_tag y is_timeseries_tag** en la configuración del modelo de series temporales?

Ejemplo: un registro de datos tiene tres etiquetas: [phone=xiaomi, RAM=8G, camera=LEICA].Data
  • Ejemplo de exportación de datos (OTS Reader)

    • Si desea combinar las etiquetas anteriores en una sola columna para exportarlas, aplique la siguiente configuración:

      "column": [
            {
              "name": "_tags",
            }
          ],

      DataWorks exporta las etiquetas como una sola columna de datos con el siguiente formato:

      ["phone=xiaomi","camera=LEICA","RAM=8G"]
    • Si desea exportar la etiqueta phone y la etiqueta camera como columnas independientes, aplique la siguiente configuración:

      "column": [
            {
              "name": "phone",
              "is_timeseries_tag":"true",
            },
            {
              "name": "camera",
              "is_timeseries_tag":"true",
            }
          ],

      DataWorks exporta dos columnas de datos con el siguiente formato:

      xiaomi, LEICA
  • Ejemplo de importación de datos (OTS Writer)

    El origen de datos ascendente (Reader) tiene dos columnas de datos:

    • Una columna contiene: ["phone=xiaomi","camera=LEICA","RAM=8G"].

    • La otra columna contiene: 6499.

    Para agregar ambas columnas a las etiquetas, el formato esperado del campo de etiquetas después de la escritura es el siguiente:Format Aplique la siguiente configuración:

    "column": [
          {
            "name": "_tags",
          },
          {
            "name": "price",
            "is_timeseries_tag":"true",
          },
        ],
    • La configuración de la primera columna importa ["phone=xiaomi","camera=LEICA","RAM=8G"] de forma íntegra al campo de etiquetas.

    • La configuración de la segunda columna importa price=6499 de forma individual al campo de etiquetas.

Nombre de tabla personalizado

¿Cómo personalizo el nombre de la tabla para una tarea de sincronización por lotes?

Si los nombres de sus tablas siguen un patrón regular, como orders_20170310, orders_20170311 y orders_20170312, donde las tablas se distinguen por fecha y comparten la misma estructura, puede usar parámetros de programación (Configure synchronization tasks in script mode) para personalizar el nombre de la tabla. Así, cada madrugada se leen automáticamente los datos de la tabla del día anterior desde la base de datos de origen.

Por ejemplo, si hoy es 15 de marzo de 2017, el sistema importa automáticamente los datos de la tabla orders_20170314 de la base de datos de origen, y así sucesivamente.

En el modo script, cambie el nombre de la tabla de origen por una variable, como orders_${tablename}. Dado que las tablas se distinguen por fecha y necesita leer los datos del día anterior diariamente, asigne el valor de la variable en la configuración de parámetros de la tarea como tablename=${yyyymmdd}.

Nota

Para obtener más información sobre los parámetros de programación, consulte Configure scheduling parameters.

Agregar columnas a una tabla

¿Cómo gestiono las adiciones o modificaciones de columnas en la tabla de origen durante una sincronización por lotes?

Vaya a la página de configuración de la tarea de sincronización y modifique las asignaciones de columnas para actualizar las columnas modificadas en la configuración de la tarea. Luego, vuelva a enviar y ejecute la tarea para que los cambios surtan efecto.

Problemas de configuración de tareas

¿Qué hago si no puedo ver todas las tablas al configurar un nodo de sincronización por lotes?

Al configurar un nodo de sincronización por lotes, la sección Source muestra de forma predeterminada solo las primeras 25 tablas del origen de datos seleccionado. Si hay más tablas, introduzca el nombre de la tabla para buscarla o utilice el modo script para el desarrollo.

Palabras clave en nombres de tablas o columnas

¿Cómo soluciono los fallos de tareas de sincronización causados por conflictos con palabras clave en nombres de tablas o columnas?

  • Causa del error: la configuración de columnas contiene palabras clave reservadas o incluye columnas cuyo nombre comienza con un número.

  • Solución: cambie la tarea de sincronización de Data Integration al modo script y escape las columnas especiales en la configuración de columnas. Para obtener información sobre cómo configurar tareas en modo script, consulte Configure synchronization tasks in script mode.

    • El carácter de escape para MySQL es keyword.

    • El carácter de escape para Oracle y PostgreSQL es "keyword".

    • El carácter de escape para SQL Server es [keyword].

    Ejemplo de MySQL:

    {
        "stepType": "mysql",
        "parameter": {
            "envType": 0,
            "datasource": "wpw_test_mysql",
            "column": [
                "id",
                "`order`",
                "`add`"
            ],
            "connection": [
                {
                    "datasource": "wpw_test_mysql",
                    "table": [
                        "abc"
                    ]
                }
  • Si tomamos como ejemplo un origen de datos de MySQL:

    1. Ejecute la siguiente instrucción para crear una tabla llamada aliyun: create table aliyun (

    2. Ejecute la siguiente instrucción para crear una vista y asignar un alias a la columna de la tabla: create view v_aliyun as select

      Nota
      • table es una palabra clave de MySQL. Durante la sincronización de datos, el código concatenado genera un error. Cree una vista y asigne un alias a la columna de la tabla.

      • No se recomienda usar palabras clave como nombres de columnas de tabla.

    3. Después de ejecutar las instrucciones anteriores, utilice la vista v_aliyun en lugar de la tabla aliyun al configurar la tarea de sincronización.

Asignación de columnas

La tarea de sincronización por lotes falla con el error: plugin xx does not specify column

Este error puede deberse a que la asignación de columnas de la tarea de sincronización no está configurada correctamente o a que el plugin no tiene column bien configurado.

  1. Compruebe si la asignación de columnas está configurada.

  2. Compruebe si el plugin tiene column configurado correctamente.

Origen de datos no estructurado: ¿qué hago si no se pueden asignar las columnas después de hacer clic en la vista previa de datos?

  • Síntoma:

    Cuando hace clic en Preview Data, aparece un mensaje similar al siguiente, que indica que el tamaño en bytes de la columna supera el límite.

    El mensaje de error es "Maximum column length of 1,000 exceeded in column 6 in record 1. Set the SafetySwitch property to false if you're expecting column lengths greater than 100,000 characters to avoid this error."

  • Causa: para evitar errores OOM, el servicio del origen de datos comprueba la longitud de las columnas al procesar las solicitudes de vista previa de datos. Si una sola columna supera los 1000 bytes, aparece el mensaje anterior. Este mensaje no afecta la ejecución real de la tarea. Puede ignorar el error y ejecutar la tarea de sincronización por lotes directamente.

    Nota

    Si el archivo existe y la conectividad es normal, las siguientes situaciones también pueden provocar que la vista previa de datos falle:

    • Una sola fila del archivo supera el límite de tamaño de 10 MB. En este caso, no se muestran datos y aparece un mensaje similar al anterior.

    • Una sola fila del archivo supera el límite de 1000 columnas. En este caso, solo se muestran las primeras 1000 columnas y aparece un mensaje en la columna 1001.

Modificar el TTL

¿El TTL de una tabla sincronizada solo se puede modificar con la instrucción ALTER?

El TTL se establece a nivel de tabla. No existe ninguna opción de TTL en la configuración de la tarea de sincronización.

Agregación de funciones

Al sincronizar mediante API, ¿se admite el uso de funciones del lado del origen (como MaxCompute) para la agregación? Por ejemplo, la tabla de origen tiene las columnas a y b como claves principales de Lindorm.

La sincronización basada en API no admite el uso de funciones del lado del origen. Procese primero los datos con las funciones del lado del origen antes de importarlos.