Latency insight proporciona estadísticas de latencia con precisión de microsegundos para todos los comandos y eventos personalizados en una instancia de Tair (compatible con Redis OSS). Utilice esta función para identificar qué eventos provocaron un pico de latencia, cuándo ocurrió y cuál fue su gravedad. El análisis abarca las dimensiones de eventos, tiempo y latencia.
Requisitos previos
Antes de empezar, asegúrese de que su instancia de Tair (compatible con Redis OSS) cumple con a continuación requisitos de versión secundaria. Para actualizar la versión secundaria, consulte Actualizar la versión secundaria de una instancia.
|
Tipo de instancia |
Versión secundaria mínima |
Notas |
|
Instancia basada en DRAM de Tair (Enterprise Edition) |
1.6.9 |
Para recopilar estadísticas de los comandos del módulo Tair, actualice a la versión 1.7.28 o posterior |
|
Redis Open-Source Edition 5.0 |
5.1.4 |
|
|
Redis Open-Source Edition 6.0 |
0.1.15 |
|
|
Redis Open-Source Edition 7.0 |
7.0.0.6 |
Funcionamiento de Latency insight
Redis 2.8.13 introdujo el monitoreo nativo de latencia. Sin embargo, solo conserva los datos de los últimos 160 segundos y registra únicamente el evento de mayor latencia por segundo.
Latency insight amplía estas capacidades con lo siguiente:
Persistencia: conserva todas las estadísticas de latencia de los últimos tres días, lo que permite rastrear picos de latencia a lo largo del tiempo.
Alta precisión: mediciones exactas en microsegundos para todos los eventos.
Alto rendimiento: implementación asíncrona con una sobrecarga mínima.
Consultas en tiempo real: admite consultas y agregaciones de datos en vivo.
Estadísticas multidimensionales: analiza una instancia en hasta 27 eventos, intervalos de tiempo y distribuciones de latencia.
Facturación
Esta función es gratuita.
Consulta de estadísticas de latencia
Inicie sesión en la consola de DAS.
En el panel de navegación izquierdo, elija Intelligent O&M Center > Instance Monitoring.
Busque la instancia que desea analizar y haga clic en su ID para abrir la página de detalles de la instancia.
En el panel de navegación izquierdo, elija Request Analysis > Latency Insight.
En la página Latency Insight, seleccione un intervalo de tiempo para consultar las estadísticas de latencia de ese periodo.
Solo están disponibles los datos de los últimos tres días. Cada consulta debe abarcar un máximo de una hora.
Para instancias de clúster o instancias con división de lectura y escritura, puede consultar las estadísticas de Data Node y Proxy Node.
Solo se registran y muestran los comandos o eventos que superan el umbral configurado. Para obtener orientación sobre cómo resolver eventos de latencia comunes, consulte Recomendaciones para gestionar eventos de latencia comunes .
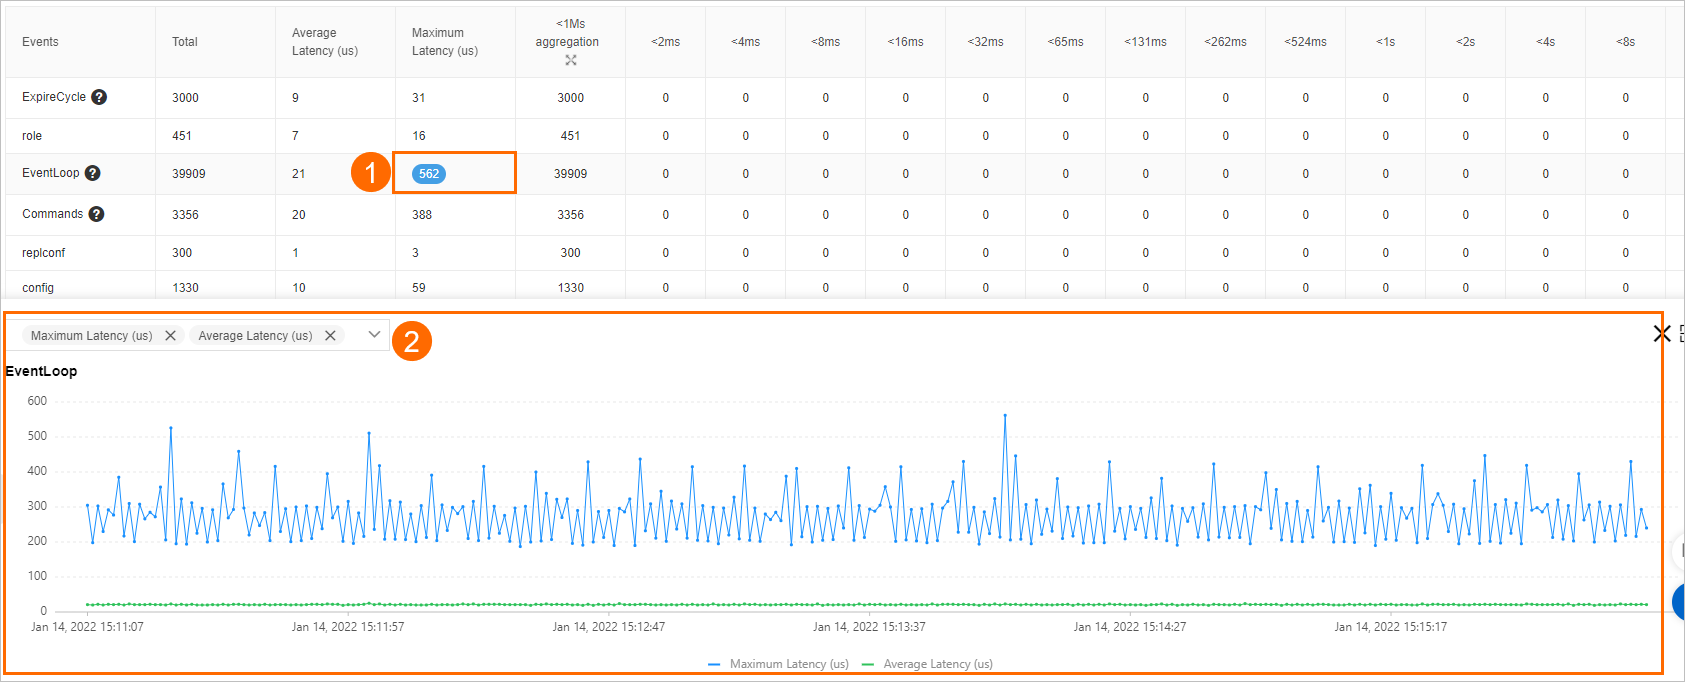
Referencia de métricas
|
Métrica |
Descripción |
|
Events |
Nombre del evento |
|
Total |
Número total de ocurrencias |
|
Ave. Latency (μs) |
Tiempo promedio de ejecución en el servidor, en microsegundos |
|
Max. Latency (μs) |
Tiempo máximo de ejecución en el servidor, en microsegundos |
|
Aggregation of instances (Latency < 1 ms) |
Número de ocurrencias con una latencia inferior a 1 ms. Haga clic en |
|
|
Número de ocurrencias dentro de cada intervalo de milisegundos. Método de conteo: el intervalo |
 para expandir los intervalos de submilisegundos:
Haga clic en un conteo de la tabla para abrir un gráfico de tendencias de ese evento. También puede especificar las métricas que desea ver en el gráfico si selecciona sus nombres en la lista desplegable situada encima del gráfico.
Eventos especiales comunes
A continuación se enumeran los eventos que monitorea Latency insight, agrupados por categoría. Cada evento se registra únicamente cuando su tiempo de ejecución supera el umbral indicado.
| Categoría | Evento | Umbral | Qué mide |
|---|---|---|---|
| Expulsión de memoria | EvictionDel | 30 ms | Tiempo para eliminar las claves expulsadas en un ciclo de expulsión |
| EvictionLazyFree | 30 ms | Tiempo que tardan los subprocesos en segundo plano en liberar memoria durante un ciclo de expulsión | |
| EvictionCycle | 30 ms | Tiempo total del ciclo de expulsión: selección y eliminación de claves, además de la espera de los subprocesos en segundo plano | |
| Desfragmentación de memoria | ActiveDefragCycle | 100 ms | Tiempo para completar un pase de desfragmentación de memoria |
| Rehash | Rehash | 100 ms | Tiempo para ejecutar un rehash de diccionario |
| Actualización de estructura de datos | ZipListConvertHash | 30 ms | Tiempo para convertir una ziplist en un diccionario mediante codificación hash |
| IntsetConvertSet | 30 ms | Tiempo para convertir un intset en un set mediante codificación set | |
| ZipListConvertZset | 30 ms | Tiempo para convertir una ziplist en una skiplist mediante codificación ziplist | |
| Archivo de solo anexión (AOF) | AofWriteAlone | 30 ms | Tiempo para escribir un AOF según lo esperado |
| AofWrite | 30 ms | Tiempo total de escritura del AOF. Cada escritura genera un evento AofWrite y exactamente uno de los siguientes: AofWriteAlone, AofWriteActiveChild o AofWritePendingFsync |
|
| AofFstat | 30 ms | Latencia de Fstat | |
| AofRename | 30 ms | Tiempo para cambiar el nombre del archivo AOF | |
| AofReWriteDiffWrite | 30 ms | Tiempo que tarda el proceso principal en escribir datos incrementales del AOF mientras un proceso secundario reescribe el AOF | |
| AofWriteActiveChild | 30 ms | Tiempo para escribir el AOF cuando otro proceso secundario también escribe en el disco | |
| AofWritePendingFsync | 30 ms | Tiempo para escribir el AOF cuando ya hay una operación fsync en segundo plano en curso | |
| Archivo de base de datos de Redis (RDB) | RdbUnlinkTempFile | 50 ms | Tiempo para eliminar el archivo RDB temporal después de que finaliza un proceso secundario bgsave |
| Otros | Commands | 30 ms | Tiempo de ejecución de comandos regulares no marcados como @fast |
| FastCommand | 30 ms | Tiempo de ejecución de comandos marcados como @fast (complejidad temporal O(1) u O(log N)) |
|
| EventLoop | 50 ms | Tiempo para completar una iteración del bucle de eventos principal | |
| Fork | 100 ms | Tiempo para invocar una operación fork |
|
| Transaction | 50 ms | Tiempo total de ejecución de una transacción | |
| PipeLine | 50 ms | Tiempo consumido por un pipeline multihilo | |
| ExpireCycle | 30 ms | Tiempo para ejecutar un pase de limpieza de claves expiradas | |
| ExpireDel | 30 ms | Tiempo para eliminar claves expiradas en un ciclo de limpieza | |
| SlotRdbsUnlinkTempFile | 30 ms | Tiempo para eliminar el archivo RDB temporal de un slot después de que finaliza un proceso secundario bgsave |
|
| LoadSlotRdb | 100 ms | Tiempo para cargar un archivo RDB desde un slot | |
| SlotreplTargetcron | 50 ms | Tiempo para cargar un archivo RDB desde un slot en una base de datos temporal y migrarlo a la base de datos de destino mediante un proceso secundario |
Pasos siguientes
Si observa una latencia constantemente alta en eventos específicos, consulte Recomendaciones para gestionar eventos de latencia comunes para obtener instrucciones de solución.