A medida que su negocio crece, aumenta el volumen de datos o se ponen en marcha nuevos servicios y funciones, el tráfico de la base de datos puede incrementarse y los recursos de cómputo pueden resultar insuficientes. Aumentar las especificaciones de su base de datos (CPU y memoria) es una solución eficaz. Database Autonomy Service (DAS) admite el escalado automático de rendimiento para aumentar las especificaciones de su instancia, lo que le permite manejar el tráfico pico de forma rápida y elástica. DAS también admite reducir las especificaciones cuando disminuye el tráfico para evitar el desperdicio de recursos.
Requisitos previos
-
Esta función es compatible con las siguientes instancias de base de datos:
Base de datos
Región
-
RDS for MySQL Instancias High-availability Edition con discos en la nube (General-purpose y Dedicated), instancias High-availability Edition con discos locales (General-purpose) e instancias Three-node Enterprise Edition (General-purpose)
-
PolarDB for MySQL Cluster Edition
La función de escalado automático de rendimiento depende de la detección de anomalías. Por lo tanto, la región donde reside su instancia de base de datos debe ser compatible con la detección de anomalías. Las regiones compatibles son:
China (Hangzhou), China (Shanghai), China (Shenzhen), China (Heyuan), China (Guangzhou), China (Qingdao), China (Beijing), China (Zhangjiakou), China (Hohhot), China (Ulanqab), China (Nanjing - Local Region) (Decommissioned), China (Fuzhou - Local Region) (Decommissioned), China (Chengdu), China (Zhengzhou), China (Hong Kong), Japan (Tokyo), South Korea (Seoul), Singapore, Malaysia (Kuala Lumpur), Indonesia (Jakarta), Philippines (Manila), Thailand (Bangkok), UAE (Dubai), Saudi Arabia (Riyadh), Germany (Frankfurt), US (Silicon Valley), US (Virginia) y UK (London)
NotaRDS for MySQL Las instancias que utilizan especificaciones descontinuadas no admiten el escalado automático de rendimiento. Para utilizar esta función, primero debe cambiar las especificaciones de la instancia. Para obtener más información, consulte Change instance specifications.
-
Debe tener un saldo suficiente en su cuenta para cubrir los costos de escalado ascendente.
-
Debe tener un DAS service-linked role.
NotaSi no ha creado un rol vinculado al servicio DAS, este crea uno automáticamente antes de ejecutar una operación de escalado.
Funcionamiento
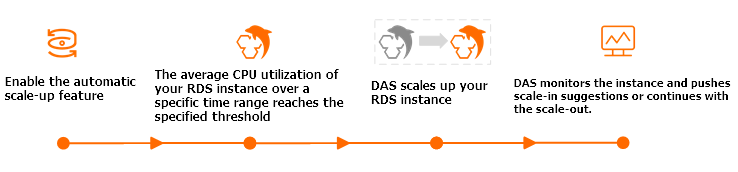
Escalado automático ascendente
Después de habilitar el escalado automático ascendente, cuando la Average CPU Utilization de su instancia de base de datos alcanza el umbral configurado dentro de una ventana de observación:
Durante un escalado ascendente, pueden ocurrir escenarios extremos como un cambio por alta disponibilidad (HA), escasez grave de recursos del host o recuperación de recursos debido a conflictos con procesos de control existentes. Para instancias críticas, se recomienda utilizar el escalado automático para una evaluación a corto plazo y determinar los requisitos pico de CPU. Para garantizar estabilidad a largo plazo, sugerimos actualizar las especificaciones de la instancia según las cargas de trabajo máximas del negocio.
-
Para instancias RDS for MySQL High-availability Edition con discos en la nube e instancias PolarDB for MySQL Cluster Edition:
DAS selecciona automáticamente las especificaciones adecuadas dentro del límite superior configurado y realiza una operación de escalado ascendente basada en la carga de trabajo actual de la instancia. Una vez completado el escalado, DAS continúa monitoreando la utilización de la CPU. Si se vuelven a cumplir las condiciones de escalado, DAS sigue aumentando la escala de la instancia hasta alcanzar las especificaciones máximas establecidas.
-
Para instancias RDS for MySQL High-availability Edition con discos locales (General-purpose) e instancias RDS for MySQL Three-node Enterprise Edition (General-purpose):
DAS duplica el número de núcleos de CPU basándose en las especificaciones originales. Por ejemplo, si una instancia tiene 4 núcleos de CPU, se escala a 8 núcleos. Las IOPS de la instancia también aumentan; por cada núcleo de CPU adicional, las IOPS incrementan en 1,000. La operación de escalado no procede si el host tiene recursos de CPU insuficientes.
NotaEl número de núcleos de CPU solo puede duplicarse respecto a las especificaciones originales. No puede volver a duplicarse desde el estado ya escalado. Por ejemplo, si el número de núcleos se aumenta a 8, no puede incrementarse posteriormente a 16.
Escalado automático descendente
Si ocurre un escalado ascendente mientras está habilitado el escalado automático descendente, el sistema reduce la instancia a su estado previo al escalado ascendente cuando se cumplen las condiciones de reducción. Sin embargo, los escalados ascendentes ocurridos antes de habilitar el escalado automático descendente no son elegibles para dicha reducción automática.
-
Para instancias RDS for MySQL High-availability Edition con discos en la nube e instancias PolarDB for MySQL Cluster Edition:
Después de habilitar Automatic Scale-down/in, si la instancia no se encuentra en un Quiescent Period y su utilización de CPU es inferior al 30% durante más del 99% de la ventana de observación de reducción, el sistema reduce automáticamente las especificaciones de la instancia paso a paso hasta regresar a las especificaciones previas al escalado ascendente.
ImportanteLa ventana de observación de reducción se calcula como la
observation window + 10 minutesconfigurada. Por ejemplo, si la Observation Window está establecida en 30 minutos, la ventana de observación de reducción será de 40 minutos.Para instancias RDS for MySQL High-availability Edition con discos en la nube, la función de escalado automático descendente es estable únicamente en la nueva arquitectura (kindcode=18). Puede consultar la versión de la arquitectura de la instancia mediante una operación de API. Para más detalles, consulte DescribeDBInstanceAttribute.
-
Para instancias RDS for MySQL High-availability Edition con discos locales (General-purpose) e instancias RDS for MySQL Three-node Enterprise Edition (General-purpose):
Durante la Scale-down Observation Window especificada, si la utilización de CPU es inferior al 30% durante más del 99% del tiempo, el sistema reduce automáticamente el número de núcleos de CPU y las IOPS a sus especificaciones previas al escalado.
Tras habilitar el escalado automático de rendimiento, el sistema monitorea la instancia de base de datos según los parámetros más recientes. Cuando se cumplen las condiciones para escalar hacia arriba o hacia abajo, el sistema ejecuta automáticamente la operación de escalado correspondiente.
Para obtener una explicación técnica detallada sobre el escalado automático de rendimiento, consulte DAS Auto Scaling.
Facturación
-
Para instancias de base de datos RDS for MySQL:
-
Instancias High-availability Edition con discos locales (General-purpose) e instancias Three-node Enterprise Edition (General-purpose): Estas instancias se facturan bajo el modelo pay-as-you-go, con cargos deducidos por hora.
Fórmula de facturación: (Precio por núcleo × Número de núcleos de CPU añadidos) × Duración del escalado ascendente (en horas)
Instancias High-availability Edition con discos en la nube: Se le cobra según las nuevas especificaciones tras un escalado ascendente. Las tarifas varían según la región, las nuevas especificaciones y otras configuraciones. Para más detalles, visite la página de compra.
-
-
Para instancias de base de datos PolarDB for MySQL:
Para obtener información detallada sobre facturación, consulte Configuration change fees.
Impactos
En instancias RDS for MySQL High-availability Edition con discos en la nube e instancias PolarDB for MySQL Cluster Edition, puede producirse una interrupción transitoria de la conexión de aproximadamente 30 segundos mientras se aplica la nueva configuración. Asegúrese de que su aplicación cuente con un mecanismo de reconexión automática.
Para instancias PolarDB for MySQL Cluster Edition, solo puede escalar las especificaciones de todo el clúster, no las de un solo nodo.
Para garantizar un mejor rendimiento y estabilidad, si su instancia no ejecuta la versión menor más reciente del motor, el sistema la actualiza automáticamente a la última versión durante un cambio de configuración.
-
Las operaciones de escalado ascendente se aplican únicamente a la instancia principal. Si se desencadena un Primary/Secondary Switchover después de escalar la instancia principal:
El sistema escala automáticamente la nueva instancia principal (la instancia secundaria original) hacia arriba o hacia abajo cuando se cumplen las condiciones de activación.
El sistema reduce automáticamente la nueva instancia secundaria (la instancia principal original) a sus especificaciones originales cuando se cumplen las condiciones de activación del escalado descendente.
Procedimiento
Inicie sesión en la consola de DAS.
En el panel de navegación izquierdo, haga clic en .
Localice la instancia objetivo y haga clic en el ID de la instancia para abrir la página de detalles.
En el panel de navegación izquierdo, haga clic en Autonomy Center.
En la página Autonomy Center, haga clic en Autonomy Service Settings en la esquina superior derecha.
En el panel , active el interruptor principal del servicio de autonomía.
-
En la pestaña Optimization and Throttling, configure los siguientes parámetros:
RDS for MySQL
Para instancias RDS for MySQL High-availability Edition con discos en la nube, seleccione Automatic Performance Scaling.
Para instancias RDS for MySQL High-availability Edition con discos locales (General-purpose) e instancias RDS for MySQL Three-node Enterprise Edition (General-purpose), seleccione Automatic Resource Elasticity.
Tipo de instancia
Parámetro
Descripción
Todos los tipos
Average CPU Utilization ≥
Umbral de activación para el escalado automático ascendente. Se desencadena una operación de escalado cuando la utilización promedio de CPU es mayor o igual a este valor.
Instancias High-availability Edition con discos en la nube
Observation Window
Periodo durante el cual se observa el rendimiento de la instancia.
El sistema comprueba periódicamente la utilización de CPU de la instancia durante esta ventana. Se activa un escalado automático ascendente cuando se cumple el umbral Average CPU Utilization ≥.
ImportanteLa ventana de observación de reducción se calcula como
Observation Window + 10 minutes.Por ejemplo, si la Observation Window está establecida en 30 minutos, la ventana de observación de reducción será de 40 minutos.
Observation Window
Límite superior para el escalado automático ascendente.
Si se alcanza el umbral de escalado automático, DAS incrementa gradualmente las especificaciones y continúa monitoreando la Maximum Specifications. Si se vuelve a alcanzar el umbral dentro de la Average CPU Utilization, DAS continúa escalando hasta que las especificaciones alcancen el límite superior establecido.
ImportanteSi una instancia con especificaciones de 1 núcleo y 2 GB de memoria activa un escalado automático ascendente, se escala directamente a 4 núcleos y 8 GB de memoria. En este caso, debe establecer las Maximum Specifications en al menos 4 núcleos y 8 GB de memoria. De lo contrario, el escalado automático ascendente fallará.
Observation Window
Después de habilitar Automatic Scale-down/in, si una instancia no se encuentra en el Automatic Scale-down/in y el porcentaje de tiempo en que su utilización de CPU es menor al 30% supera el 99% durante la ventana de observación de reducción (
observation window + 10 minutes), DAS reducirá automáticamente las especificaciones de la instancia paso a paso hasta alcanzar su especificación original.Quiescent Period
Intervalo mínimo de tiempo después de que se activa un Quiescent Period o Auto Scaling, antes de que pueda activarse otro Auto Scale-back o Auto Scaling.
Nota-
Durante el periodo de inactividad, DAS continúa monitoreando la instancia pero no activa ninguna operación de escalado.
-
Si el periodo de inactividad y la ventana de observación terminan al mismo tiempo, y se cumplió el umbral de utilización de CPU durante esa ventana, DAS activa una operación de escalado.
Instancias High-availability Edition con discos locales (General-purpose) e instancias Three-node Enterprise Edition (General-purpose)
Auto Scale-back
Periodo durante el cual se observa el rendimiento de la instancia. El sistema comprueba periódicamente la utilización promedio de CPU de la instancia durante esta ventana. Se activa un escalado automático ascendente cuando la utilización promedio de CPU alcanza el umbral especificado.
Scale-up Observation Window
Periodo durante el cual se observa el rendimiento de la instancia para un escalado descendente. Se activa un escalado automático descendente si la utilización de CPU es inferior al 30% durante más del 99% del tiempo en esta ventana.
PolarDB for MySQL
Seleccione Scale-back Observation Window y Auto Scaling, y luego configure los siguientes parámetros:
-
Auto Scale-back
Si la utilización promedio de CPU es mayor o igual al valor especificado dentro de la Auto Scaling, PolarDB escala el clúster según la carga de trabajo una vez finalizada la ventana de observación.
-
Al escalar un clúster, el sistema decide agregar nodos o actualizar especificaciones basándose en el tráfico de lectura y escritura en tiempo real:
Si predomina el tráfico de lectura, se prioriza la adición de nodos de solo lectura.
Si predomina el tráfico de escritura, se prioriza la actualización de las especificaciones del clúster.
En casos especiales, como una carga de trabajo elevada en el nodo principal, se prioriza la actualización de las especificaciones del clúster.
-
Observation Window
ImportantePara instancias PolarDB for MySQL Cluster Edition, solo puede escalar las especificaciones de todo el clúster, no las de un solo nodo.
Durante una ventana de observación de reducción, si la utilización promedio de CPU de un nodo agregado por Auto Scale-back es inferior al 30% durante más del 99% del tiempo, el sistema reduce automáticamente las especificaciones del clúster PolarDB for MySQL en decrementos hasta regresar a sus especificaciones originales.
Si se agregaron nodos de solo lectura durante un escalado ascendente, estos se eliminan uno por uno durante un escalado descendente.
Si se actualizaron las especificaciones del clúster durante un escalado ascendente, estas se reducen durante un escalado descendente.
Parámetro
Descripción
CPU Utilization ≥
Umbral de activación para el escalado automático ascendente. Se desencadena una operación de escalado cuando la utilización promedio de CPU es mayor o igual a este valor.
Maximum Specifications
Límite superior para el escalado automático ascendente. Después de activarse un escalado, las especificaciones del clúster PolarDB se incrementan progresivamente; por ejemplo, de 4 núcleos a 8, y luego a 16, hasta alcanzar el límite superior.
Max number of Read-Only nodes
Número máximo de nodos de solo lectura que pueden agregarse automáticamente. Tras activarse un escalado, el sistema agrega uno o dos nodos de solo lectura de PolarDB según las condiciones reales, hasta alcanzar el límite superior.
NotaLos nodos escalados automáticamente se agregan al endpoint predeterminado del clúster. Para endpoints personalizados, debe configurar la opción Auto Scaling. Para obtener más información sobre cómo configurar Automatically Associate New Nodes, consulte Configure Database Proxy.
Observation Window
Si la utilización promedio de CPU es mayor o igual al valor especificado durante toda la ventana de observación, DAS inicia un escalado agregando nodos o actualizando especificaciones según el tráfico de lectura/escritura en tiempo real del clúster una vez finalizada la ventana. Por ejemplo, si la ventana de observación es de 5 minutos y la operación de escalado toma 10 minutos, el efecto del escalado automático ascendente será visible después de aproximadamente 15 minutos.
ImportanteLa ventana de observación de reducción se calcula como la
observation window + 10 minutesconfigurada. Por ejemplo, si el Automatically Associate New Nodes está establecido en 30 minutos, la ventana de observación de reducción será de 40 minutos.Quiescent Period
Intervalo mínimo entre operaciones consecutivas de escalado automático. Durante el periodo de inactividad, DAS continúa monitoreando la instancia pero no activa ninguna operación de escalado. Si el periodo de inactividad y la ventana de observación terminan al mismo tiempo, y se cumplió el umbral de utilización de CPU durante esa ventana, DAS activa una operación de escalado.
Haga clic en Observation Period.
-
Configure una OK para suscribirse a alertas y mantenerse informado sobre el estado del escalado automático de rendimiento de su instancia de base de datos.
El sistema recomienda una plantilla de alerta y agrega reglas de alerta para los eventos de autonomía correspondientes. Puede seguir las indicaciones para completar la configuración.
NotaSi ya configuró una plantilla de alerta para la instancia, siga las indicaciones para agregar las reglas de alerta correspondientes a los eventos de autonomía en la plantilla.
Para configurar sus propias plantillas y reglas de alerta, consulte Configure alert templates y Configure alert rules.
-
Seleccione un Alert Template para recibir notificaciones.
Haga clic en Alert Contact Group para agregar un nuevo contacto de alerta.
Haga clic en Add Contact para agregar un nuevo grupo de contactos de alerta.
Haga clic en Create Contact Group o Modify junto a un contacto para editar o eliminar su información.
Para obtener instrucciones detalladas, consulte Manage alert contacts.
Haga clic en Remove y confirme la configuración de alertas en el cuadro de diálogo que aparece.
Preguntas frecuentes
P: ¿Qué debo hacer si mi instancia alcanzó las especificaciones máximas de su familia y no puede escalarse más?
R: Le recomendamos adquirir una instancia con especificaciones superiores de una familia diferente. Por ejemplo, una instancia RDS for MySQL High-availability Dedicated admite hasta 104 núcleos y 768 GB de memoria. Posteriormente, puede migrar sus datos a la nueva instancia. Para obtener más información sobre especificaciones de instancias y soluciones de migración, consulte los siguientes documentos:
RDS for MySQL: Tipos de instancia y Migrate data between RDS for MySQL instances.
PolarDB for MySQL: Instance types y Migrate data between PolarDB for MySQL clusters.
P: ¿El sistema monitorea continuamente la instancia durante una operación de escalado ascendente?
R: Sí.
Por ejemplo, si la Submit Configuration está establecida en 5 minutos y la operación de escalado toma 10 minutos, el tiempo total del evento de escalado es de 15 minutos.
Durante el periodo de escalado, el sistema monitorea continuamente el rendimiento de la instancia, pero no activará otra operación de escalado hasta que finalice la actual. Una vez terminado el escalado, si se cumple el umbral de utilización de CPU al final de la siguiente Observation Window, se activa otro escalado ascendente. Este proceso se repite hasta que la instancia alcanza las Observation Window especificadas.
P: ¿Es normal que se cree y pague un pedido en segundos después de activarse un escalado automático ascendente?
R: Sí, es normal. Cuando el escalado automático de rendimiento activa un escalado ascendente, el sistema crea y paga automáticamente el pedido. Todo este proceso está automatizado y puede completarse en segundos. Para confirmar si un pedido fue generado por un usuario o por el sistema, puede revisar los registros correspondientes en la auditoría de operaciones.
Documentos relacionados
Si el tráfico de su negocio tiene picos predecibles, puede utilizar scheduled automatic scaling. Esta función le permite escalar las especificaciones de su instancia según un horario predefinido. La instancia regresa automáticamente a sus especificaciones originales una vez finalizada la duración configurada.
-
Si su tipo de instancia no admite el escalado automático de rendimiento, puede cambiar manualmente las especificaciones para escalar la instancia hacia arriba o hacia abajo. Para obtener más información, consulte los siguientes documentos:
Para RDS for MySQL, consulte Change instance specifications.
Para PolarDB for MySQL, consulte Manually change cluster specifications.