Estas son las notas de la versión de la imagen de contenedor training-nv-pytorch 25.10.
Novedades
Funciones principales
Se añade compatibilidad con múltiples arquitecturas para amd64 y aarch64 .
Se actualiza megatron-core a la versión 0.14.0 y transformer_engine a la 2.4, e incorpora las funciones más recientes de la comunidad.
Se actualiza vLLM a la versión 0.11.0, e incorpora las funciones más recientes de la comunidad.
Correcciones de bugs
Esta versión no incluye correcciones de bugs.
Contenido
|
Arquitectura Aarch64 |
Arquitectura Amd64 |
|
|
Escenario de uso |
Entrenamiento / Inference |
Entrenamiento / Inference |
|
Framework |
PyTorch |
PyTorch |
|
Requisitos |
NVIDIA driver >= 575 |
NVIDIA driver >= 575 |
|
Componentes principales |
Ubuntu : 24.04 CUDA : 12.8 Python : 3.12.7+gc torch : 2.8.0.9+nv25.3 accelerate : 1.7.0+ali deepspeed : 0.16.9+ali diffusers : 0.34.0 flash_attn : 2.8.3 flash_attn_3 : 3.0.0b1 flashinfer-python : 0.2.5 gdb : 15.0.50.20240403-git grouped_gemm : 1.1.4 megatron-core : 0.14.0 mmcv : 2.1.0 mmdet : 3.3.0 mmengine : 0.10.3 opencv-python-headless : 4.11.0.86 peft : 0.16.0 pytorch-dynamic-profiler : 0.24.11 pytorch-triton : 3.4.0 ray : 2.50.1 timm : 1.0.20 transformer_engine : 2.4.0+3cd6870c transformers : 4.56.1+ali ultralytics : 8.3.96 vllm : 0.11.0 |
Ubuntu : 24.04 CUDA : 12.8 Python : 3.12.7+gc torch : 2.8.0.9+nv25.3 accelerate : 1.7.0+ali deepspeed : 0.16.9+ali diffusers : 0.34.0 flash_attn : 2.8.3 flash_attn_3 : 3.0.0b1 flashinfer-python : 0.2.5 gdb : 15.0.50.20240403-git grouped_gemm : 1.1.4 megatron-core : 0.14.0 mmcv : 2.1.0 mmdet : 3.3.0 mmengine : 0.10.3 opencv-python-headless : 4.11.0.86 peft : 0.16.0 perf : 5.4.30 pytorch-dynamic-profiler : 0.24.11 ray : 2.50.1 timm : 1.0.20 transformer_engine : 2.4.0+3cd6870c transformers : 4.56.1+ali triton : 3.4.0 ultralytics : 8.3.96 vllm : 0.11.0 |
Recursos
25.10
egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/training-nv-pytorch:25.10-serverless
Imagen VPC
acs-registry-vpc.{region-id}.cr.aliyuncs.com/egslingjun/{image:tag}Reemplace{region-id}por la region donde activó Alibaba Cloud Container Compute Service (ACS) (por ejemplo,cn-beijingocn-wulanchabu).
Reemplace {image:tag} por el nombre y la etiqueta de la imagen.
Las imágenes inference-nv-pytorch:25.03-vllm0.8.2-pytorch2.6-cu124-20250328-serverless y inference-nv-pytorch:25.03-sglang0.4.4.post1-pytorch2.5-cu124-20250327-serverless solo son compatibles con despliegues multitenant de ACS y Lingjun. No son compatibles con despliegues de un solo tenant de Lingjun.
La imagen egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/training-nv-pytorch:25.10-serverless aplica únicamente a los tipos de producto multitenant de Alibaba Cloud Container Compute Service (ACS) y Lingjun. Esta imagen no aplica al tipo de producto de un solo tenant de Lingjun. No utilice esta imagen en escenarios de un solo tenant de Lingjun.
Requisitos del controlador
La versión 25.10 se basa en CUDA 12.8.0 y requiere la versión 575 o posterior del controlador de NVIDIA. Sin embargo, si ejecuta la carga de trabajo en una GPU de centro de datos (como T4 o cualquier otra GPU de centro de datos), también puede usar controladores de las series R470 (470.57+), R525 (525.85+), R535 (535.86+) o R545 (545.23+).
Las series de controladores R418, R440, R450, R460, R510, R520, R530, R545, R555 y R560 no son compatibles con versiones posteriores de CUDA 12.8, por lo que debe actualizarlos. Para consultar la lista completa de controladores compatibles, consulte el tema Compatibilidad de aplicaciones de CUDA. Para obtener más información, consulte Compatibilidad y actualizaciones de CUDA.
Funciones y mejoras principales
Optimización de compilación de PyTorch
La función torch.compile(), introducida en PyTorch 2.0, suele ofrecer mejoras notables en cargas de trabajo de pequeña escala con una sola GPU. Sin embargo, el entrenamiento de LLM depende de la optimización de memoria de la GPU y de frameworks distribuidos como FSDP o DeepSpeed. Por ello, torch.compile() podría aportar beneficios limitados o incluso degradar el rendimiento.
Controle la granularidad de la comunicación en el framework DeepSpeed. Esto ayuda al compilador a capturar un grafo de cómputo más completo y aplicar optimizaciones de compilación más amplias.
-
Utilice una compilación optimizada de PyTorch:
El frontend del compilador de PyTorch se mejoró para garantizar que la compilación sea exitosa incluso si ocurre una interrupción de grafo en el grafo de cómputo.
Se reforzó la coincidencia de patrones y la compatibilidad con formas dinámicas para mejorar el rendimiento después de la compilación.
Con estas optimizaciones, el entrenamiento de LLM con 8 mil millones de parámetros logra normalmente una mejora de rendimiento integral de aproximadamente el 20 %.
Optimización de memoria de GPU para recálculo
Se construyó un modelo predictivo de sobrecarga de memoria de GPU basado en datos de rendimiento a gran escala. Estos datos incluyen distintos modelos, clústeres y configuraciones de parámetros de entrenamiento, así como métricas del sistema como la utilización de memoria de GPU recopilada durante las pruebas de referencia. Este modelo recomienda el número óptimo de capas de recálculo de activaciones. Este enfoque está integrado en PyTorch, lo que le permite lograr las mejoras de rendimiento de la optimización de memoria de GPU con un esfuerzo mínimo. Esta función ahora es compatible con el framework DeepSpeed.
Evaluación de rendimiento E2E
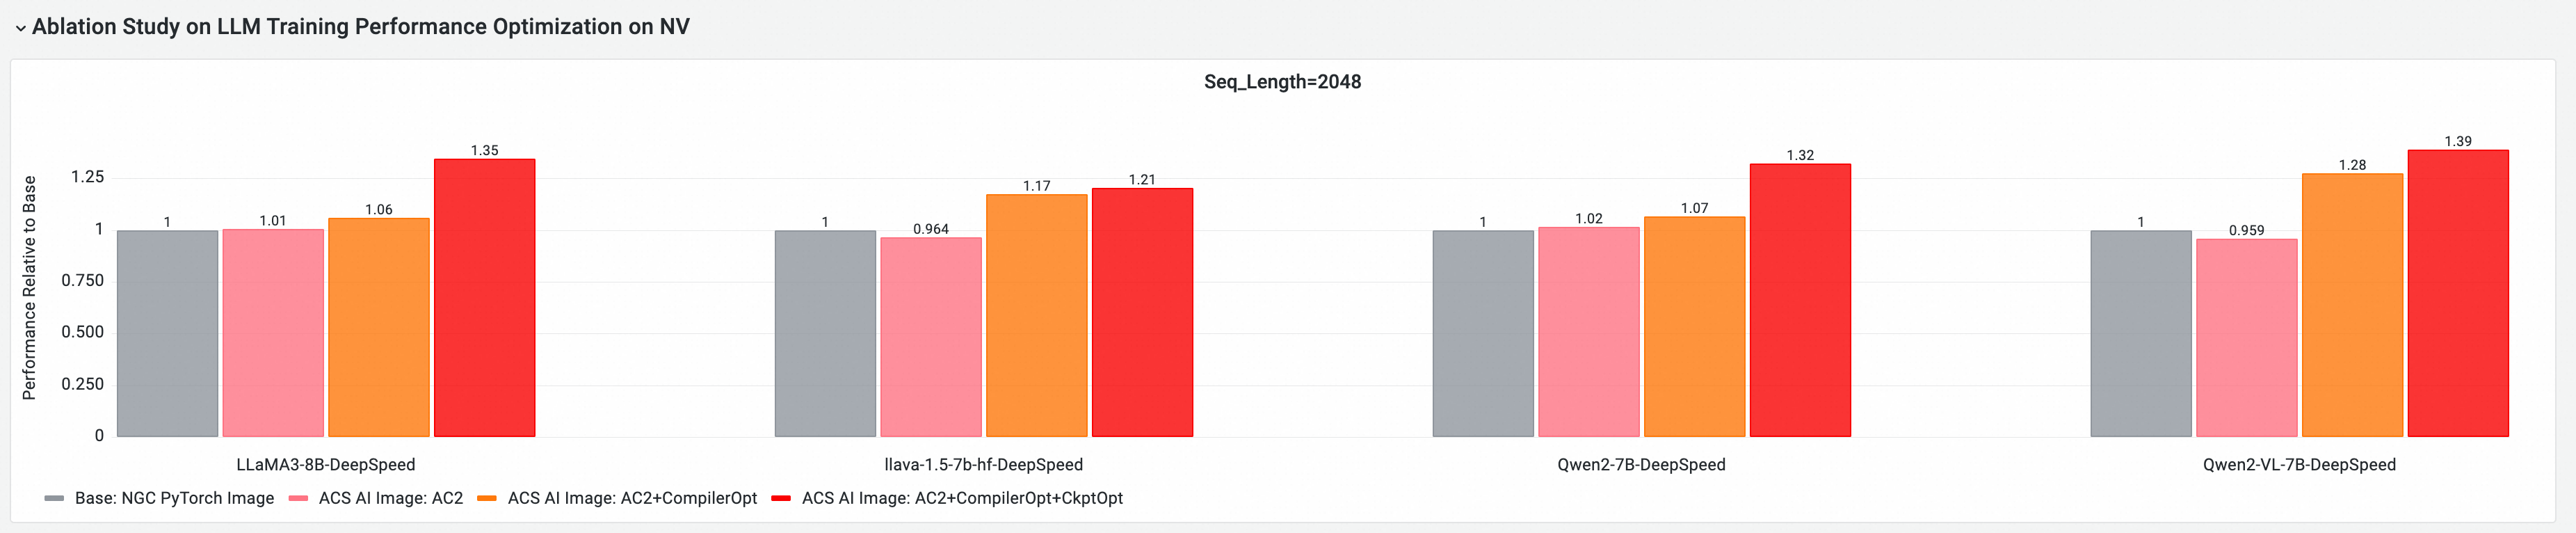
Mediante CNP, la herramienta nativa de la nube para pruebas de rendimiento de IA, comparamos de forma integral el rendimiento extremo a extremo entre esta imagen y una imagen base estándar. Para ello, utilizamos modelos de código abierto y configuraciones de framework de uso común. También llevamos a cabo un estudio de ablación para evaluar la contribución de rendimiento de cada componente de optimización.
Comparación de imágenes: imagen base y evaluación iterativa
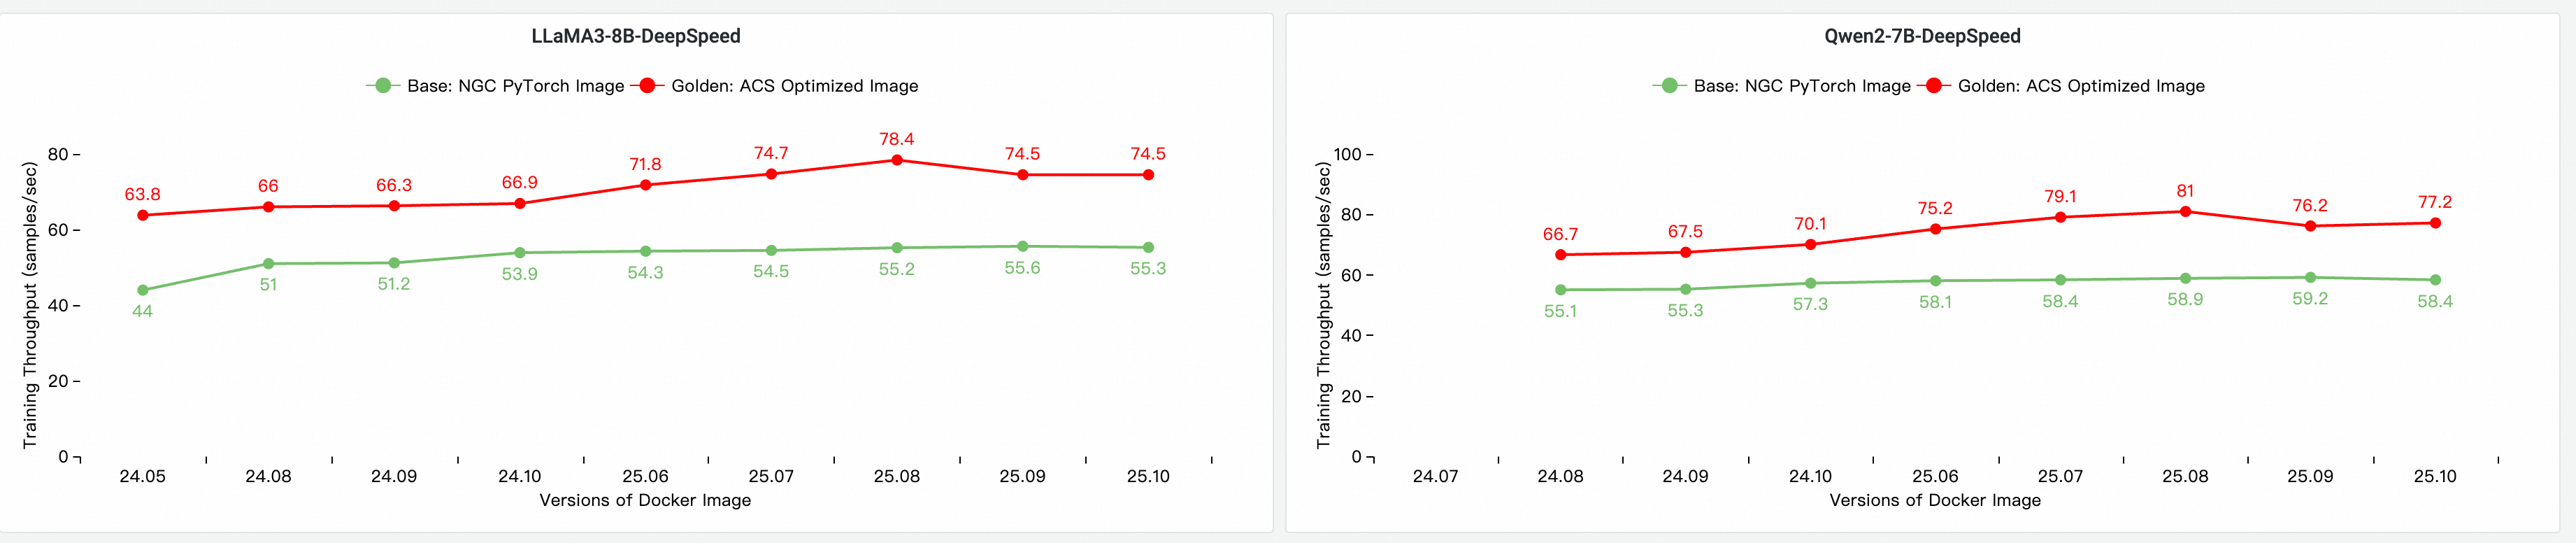
Contribución al rendimiento E2E de los componentes principales de GPU
Las siguientes pruebas se basan en la versión 25.10 y se ejecutaron en un clúster de GPU multinodo para evaluar y comparar el rendimiento de entrenamiento extremo a extremo. Las configuraciones comparadas son a continuación:
Base: una imagen estándar de NGC PyTorch.
Imagen de IA de ACS: AC2: esta imagen con AC2 BaseOS y sin optimizaciones habilitadas.
Imagen de IA de ACS: AC2+CompilerOpt: esta imagen con AC2 BaseOS y solo la optimización de compilación de torch habilitada.
Imagen de IA de ACS: AC2+CompilerOpt+CkptOpt: esta imagen con AC2 BaseOS y con las optimizaciones de compilación de torch y de puntos de control de gradiente selectivo habilitadas.
Inicio rápido
En el siguiente ejemplo se muestra cómo extraer la imagen training-nv-pytorch con Docker.
Para usar la imagen training-nv-pytorch en Alibaba Cloud Container Compute Service (ACS), selecciónela desde la página Artifact Center cuando cree una carga de trabajo en la consola, o especifique la referencia de la imagen en un archivo YAML.
1. Pull the image
docker pull egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/training-nv-pytorch:[tag]2. Enable optimizations
-
Habilite la optimización del compilador
Use the transformers Trainer API:
training_args = TrainingArguments( bf16=True, gradient_checkpointing=True, torch_compile=True ) -
Habilite la optimización de puntos de control de gradiente
export CHECKPOINT_OPTIMIZATION=true
3. Inicie el contenedor
La herramienta de entrenamiento de modelos ljperf viene integrada en la imagen. En este tema se utiliza para describir los pasos necesarios para iniciar un contenedor y ejecutar una tarea de entrenamiento.
Ejemplo de LLM
# Start and enter the container
docker run --rm -it --ipc=host --net=host  --privileged egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/training-nv-pytorch:[tag]
# Run the training demo
ljperf benchmark --model deepspeed/llama3-8b
4. Usage recommendations
La imagen contiene modificaciones personalizadas en bibliotecas como PyTorch y DeepSpeed. No reinstale estos paquetes, ya que sobrescribirá las optimizaciones.
En la configuración de DeepSpeed, deje vacío el parámetro
zero_optimization.stage3_prefetch_bucket_sizeo establézcalo enauto.-
La variable de entorno integrada
NCCL_SOCKET_IFNAMEde esta imagen debe ajustarse de forma dinámica según el escenario de uso:Cuando un solo Pod solicita 1, 2, 4 u 8 GPU para tareas de entrenamiento o inference, debe establecer
NCCL_SOCKET_IFNAME=eth0. Esta es la configuración predeterminada en esta imagen.Cuando un solo Pod solicita las 16 GPU de una máquina para tareas de entrenamiento o inference, establezca
NCCL_SOCKET_IFNAME=hpn0para usar la red de alto rendimiento (HPN).