Container Compute Service (ACS) asigna dispositivos GPU a los pods según la topología de GPU de cada modelo de nodo GPU-HPN. Los pods que se ejecutan en el mismo nodo intercambian datos mediante canales como NVLink, y las restricciones de partición mantienen la comunicación entre GPU eficiente y equitativa.
Requisitos previos
Esta función solo es compatible con los pods que usan la clase de cómputo gpu-hpn (compute-class) y los tipos de nodo GPU-HPN correspondientes.
Contexto
Dentro de un nodo GPU-HPN, los dispositivos GPU se conectan y se comunican mediante uno o más canales. Además, en un mismo nodo pueden ejecutarse pods que solicitan distintas cantidades de GPU. Para mantener una comunicación entre GPU eficiente y equitativa, y evitar que los pods interfieran entre sí, ACS programa los pods según la topología de GPU del nodo. El servicio divide los dispositivos GPU en particiones que coinciden con la cantidad de GPU solicitada por los pods y, después, asigna la partición óptima a cada pod.
A continuación se muestra un nodo con ocho GPU. Cada cuatro GPU forman un grupo. Las GPU dentro de un grupo están interconectadas directamente, mientras que los dos grupos se conectan mediante PCIe.
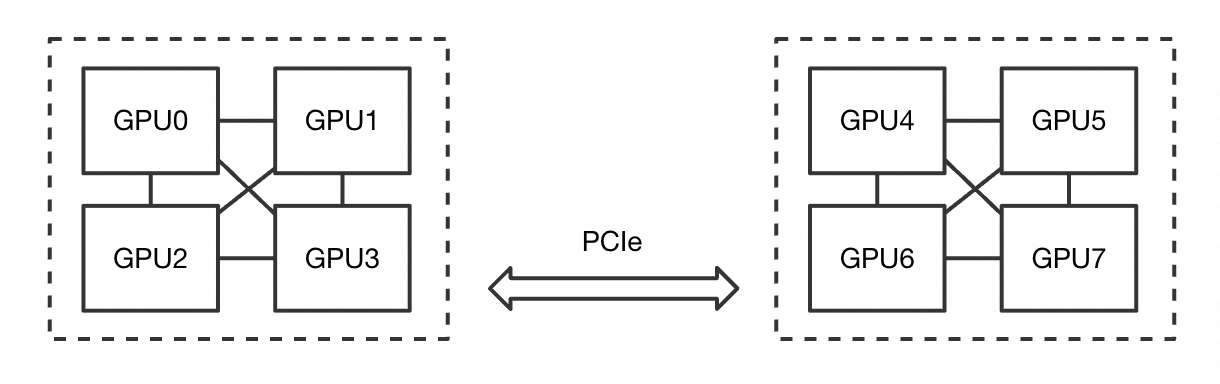
ACS divide los dispositivos de este nodo en las siguientes particiones:
|
GPU solicitadas por el pod |
Resultados de asignación de dispositivos disponibles |
|
8 |
[0,1,2,3,4,5,6,7] |
|
4 |
[0,1,2,3], [4,5,6,7] |
|
2 |
[0,1], [2,3], [4,5], [6,7] |
|
1 |
[0], [1], [2], [3], [4], [5], [6], [7] |
La creación y eliminación repetida de pods en un nodo puede provocar fragmentación de particiones. Esto impide programar nuevos pods y los deja en estado Pending. Para liberar los dispositivos que requiere un pod pendiente, consulte los resultados de asignación de dispositivos de los pods del nodo y desaloje algunos según las prioridades de su negocio. En la sección de preguntas frecuentes de este tema se explica cómo planificar los recursos del nodo para evitar la fragmentación de particiones, cómo elegir los pods que se van a desalojar y cómo el tipo, la versión y la configuración del programador afectan el grado en que se consideran las particiones durante la programación.
Particiones de los tipos de nodo GPU-HPN
Las particiones y los modelos de GPU varían según los tipos de nodo GPU-HPN que ofrece ACS. Para comprobar qué particiones están en uso en un nodo, consulte los resultados de asignación de dispositivos de los pods que se ejecutan en ese nodo.
gpu.p16en-16XL
Este tipo de nodo cuenta con 16 GPU del modelo P16EN. A continuación se muestran las particiones correspondientes a la cantidad de GPU que solicitan los pods.
|
GPU solicitadas por el pod |
Resultados de asignación de dispositivos disponibles |
|
16 |
[0,1,2,3,4,5,6,7,8,9,10,11,12,13,14,15] |
|
8 |
[0,1,2,3,4,5,6,7], [8,9,10,11,12,13,14,15] |
|
4 |
[0,1,2,3], [4,5,6,7], [8,9,10,11], [12,13,14,15] |
|
2 |
[0,3], [1,2], [4,7], [5,6], [8,11], [9,10], [12,15], [13,14] |
|
1 |
[0], [1], [2], [3], [4], [5], [6], [7], [8], [9], [10], [11], [12], [13], [14], [15] |
Consulte los resultados de programación de un pod
Resultado de asignación de dispositivos
En un pod GPU-HPN, el resultado de asignación de dispositivos se registra en las anotaciones del pod con el siguiente formato:
apiVersion: v1
kind: Pod
metadata:
  annotations:
    alibabacloud.com/device-allocation: '{"gpus": {"minor": [0,1,2,3]}}'
Mensaje de error de programación causado por fragmentación de particiones
Un pod que no se logra programar permanece en estado Pending. Ejecute el siguiente comando para consultar el mensaje de error de programación:
kubectl describe pod pod-demoSalida esperada, sin incluir otro contenido:
...
Events:
  Type     Reason            Age    From               Message
  ----     ------            ----   ----               -------
  Warning  FailedScheduling  26m    default-scheduler  0/5 nodes are available: 2 Node(s) Insufficient Partitioned GPU Devices, 1 Node(s) xxx, 2 Node(s) xxx.
En un mensaje similar a 0/5 nodes are available: xxx, Insufficient Partitioned GPU Devices indica que la programación falló debido a la fragmentación de particiones en el nodo.
Preguntas frecuentes
¿Cómo planifico los recursos y las políticas del nodo para evitar la fragmentación de particiones?
Planifique los recursos y las políticas del nodo de la siguiente manera:
Agrupe los nodos por cantidad de GPU solicitadas: establezca etiquetas distintas en sus nodos para gestionar los recursos según la cantidad de GPU que soliciten los pods. Por ejemplo, programe en nodos distintos los pods que solicitan 8 GPU y los que solicitan 1 GPU.
Libere dispositivos inactivos cuando ya haya pods en estado Pending: si la fragmentación de particiones deja pods en estado Pending en el clúster, utilice mecanismos como el desprogramamiento para desalojar algunos pods de baja prioridad. De esta forma, libera dispositivos inactivos para los pods pendientes.
Reserve capacidad cuando no sea posible planificar etiquetas de nodo: si tiene pocos nodos o no puede planificar etiquetas de nodo, y sus pods solicitan cantidades muy variadas de GPU, reserve capacidad para cubrir los requisitos de recursos de sus aplicaciones. Para obtener más información, consulte GPU pod capacity reservation.
¿Cómo elijo los pods que se van a desalojar al resolver la fragmentación de particiones?
Identifique la cantidad de GPU que solicita el pod pendiente; por ejemplo, 8 GPU.
En el nodo de destino, lea la anotación
alibabacloud.com/device-allocationde cada pod para determinar qué dispositivos ya están asignados. Para obtener más información, consulte device allocation result.Decida qué pods desalojar según los resultados de asignación. Asegúrese de que los dispositivos liberados cumplan tanto con la cantidad de GPU solicitada como con las restricciones de partición del pod pendiente. Por ejemplo, una solicitud de 8 GPU en P16EN requiere que los identificadores de dispositivo [0,1,2,3,4,5,6,7] o [8,9,10,11,12,13,14,15] estén completamente sin asignar.
Desaloje los pods mediante la ejecución de un comando como
evictodelete.
¿Qué debo saber sobre las particiones si utilizo un programador personalizado?
Una vez que un programador personalizado asigna un pod a un nodo, ACS asigna los dispositivos para ese pod en dicho nodo. Durante la asignación de dispositivos, ACS agrupa los dispositivos de la forma más compacta posible para evitar la fragmentación de particiones.
Un programador personalizado solo necesita considerar la capacidad total de GPU de un nodo. Para los recursos de GPU, se recomienda usar una política de empaquetamiento de nodos MostAllocated), ya que reduce la fragmentación de particiones.
¿Qué programadores detectan la topología de particiones de GPU-HPN?
Utilice la siguiente tabla para determinar si su programador detecta la topología de particiones de los nodos GPU-HPN.
Tipo de programador | Condiciones | Descripción |
Programador predeterminado de ACS | Se cumplen todas las condiciones siguientes:
y se cumple alguna de las siguientes condiciones de versión:
Para consultar las versiones compatibles, consulte kube-scheduler. | El programador detecta el estado de asignación de particiones del nodo actual y excluye los nodos cuyas particiones no pueden satisfacer la solicitud. El evento de error de programación del pod incluye el mensaje |
Programador predeterminado de ACK | Se cumplen todas las condiciones siguientes:
Las versiones compatibles se encuentran en kube-scheduler. | El programador detecta el estado de asignación de particiones del nodo actual y excluye los nodos cuyas particiones no pueden satisfacer la solicitud. El evento de error de programación del pod incluye el mensaje |
Otros tipos de programador | El tipo de programador, las condiciones o la configuración no cumplen los requisitos anteriores. | El programador no detecta la topología de particiones. El nodo GPU-HPN asigna los dispositivos de la forma más compacta posible. Si las particiones no pueden satisfacer la solicitud, el pod permanece en estado Pending en el nodo hasta que las particiones puedan cubrirla, y el evento de error de programación del pod incluye el mensaje |