Después de migrar datos de un clúster de ClickHouse autogestionado a la nube, es posible que encuentre problemas de compatibilidad y rendimiento. Para garantizar una migración sin contratiempos, se recomienda ejecutar este análisis en un entorno de pruebas antes de cambiar el tráfico de producción.
Contexto
Los clústeres de ClickHouse autogestionados que se migran a ApsaraDB for ClickHouse pueden presentar los siguientes problemas:
-
Problemas de compatibilidad de versiones:
Problemas de compatibilidad del motor MaterializedMySQL
Problemas de compatibilidad de SQL
Agotamiento de recursos de CPU y memoria insuficiente después de la migración a ApsaraDB for ClickHouse
Para resolver estos problemas, enfóquese en la compatibilidad y el rendimiento durante la migración.
Esta guía aborda:
Compatibilidad de parámetros: comparación y alineación de configuraciones entre clústeres
Compatibilidad de MaterializedMySQL: gestión de diferencias del motor tras la migración
Verificación de compatibilidad SQL: prueba por lotes de consultas existentes en el nuevo clúster
Análisis de cuellos de botella de rendimiento: localización de tablas y consultas que causan problemas de CPU o memoria
Optimización de SQL: aplicación de correcciones específicas tras identificar la causa raíz
Análisis de compatibilidad
Compatibilidad de parámetros
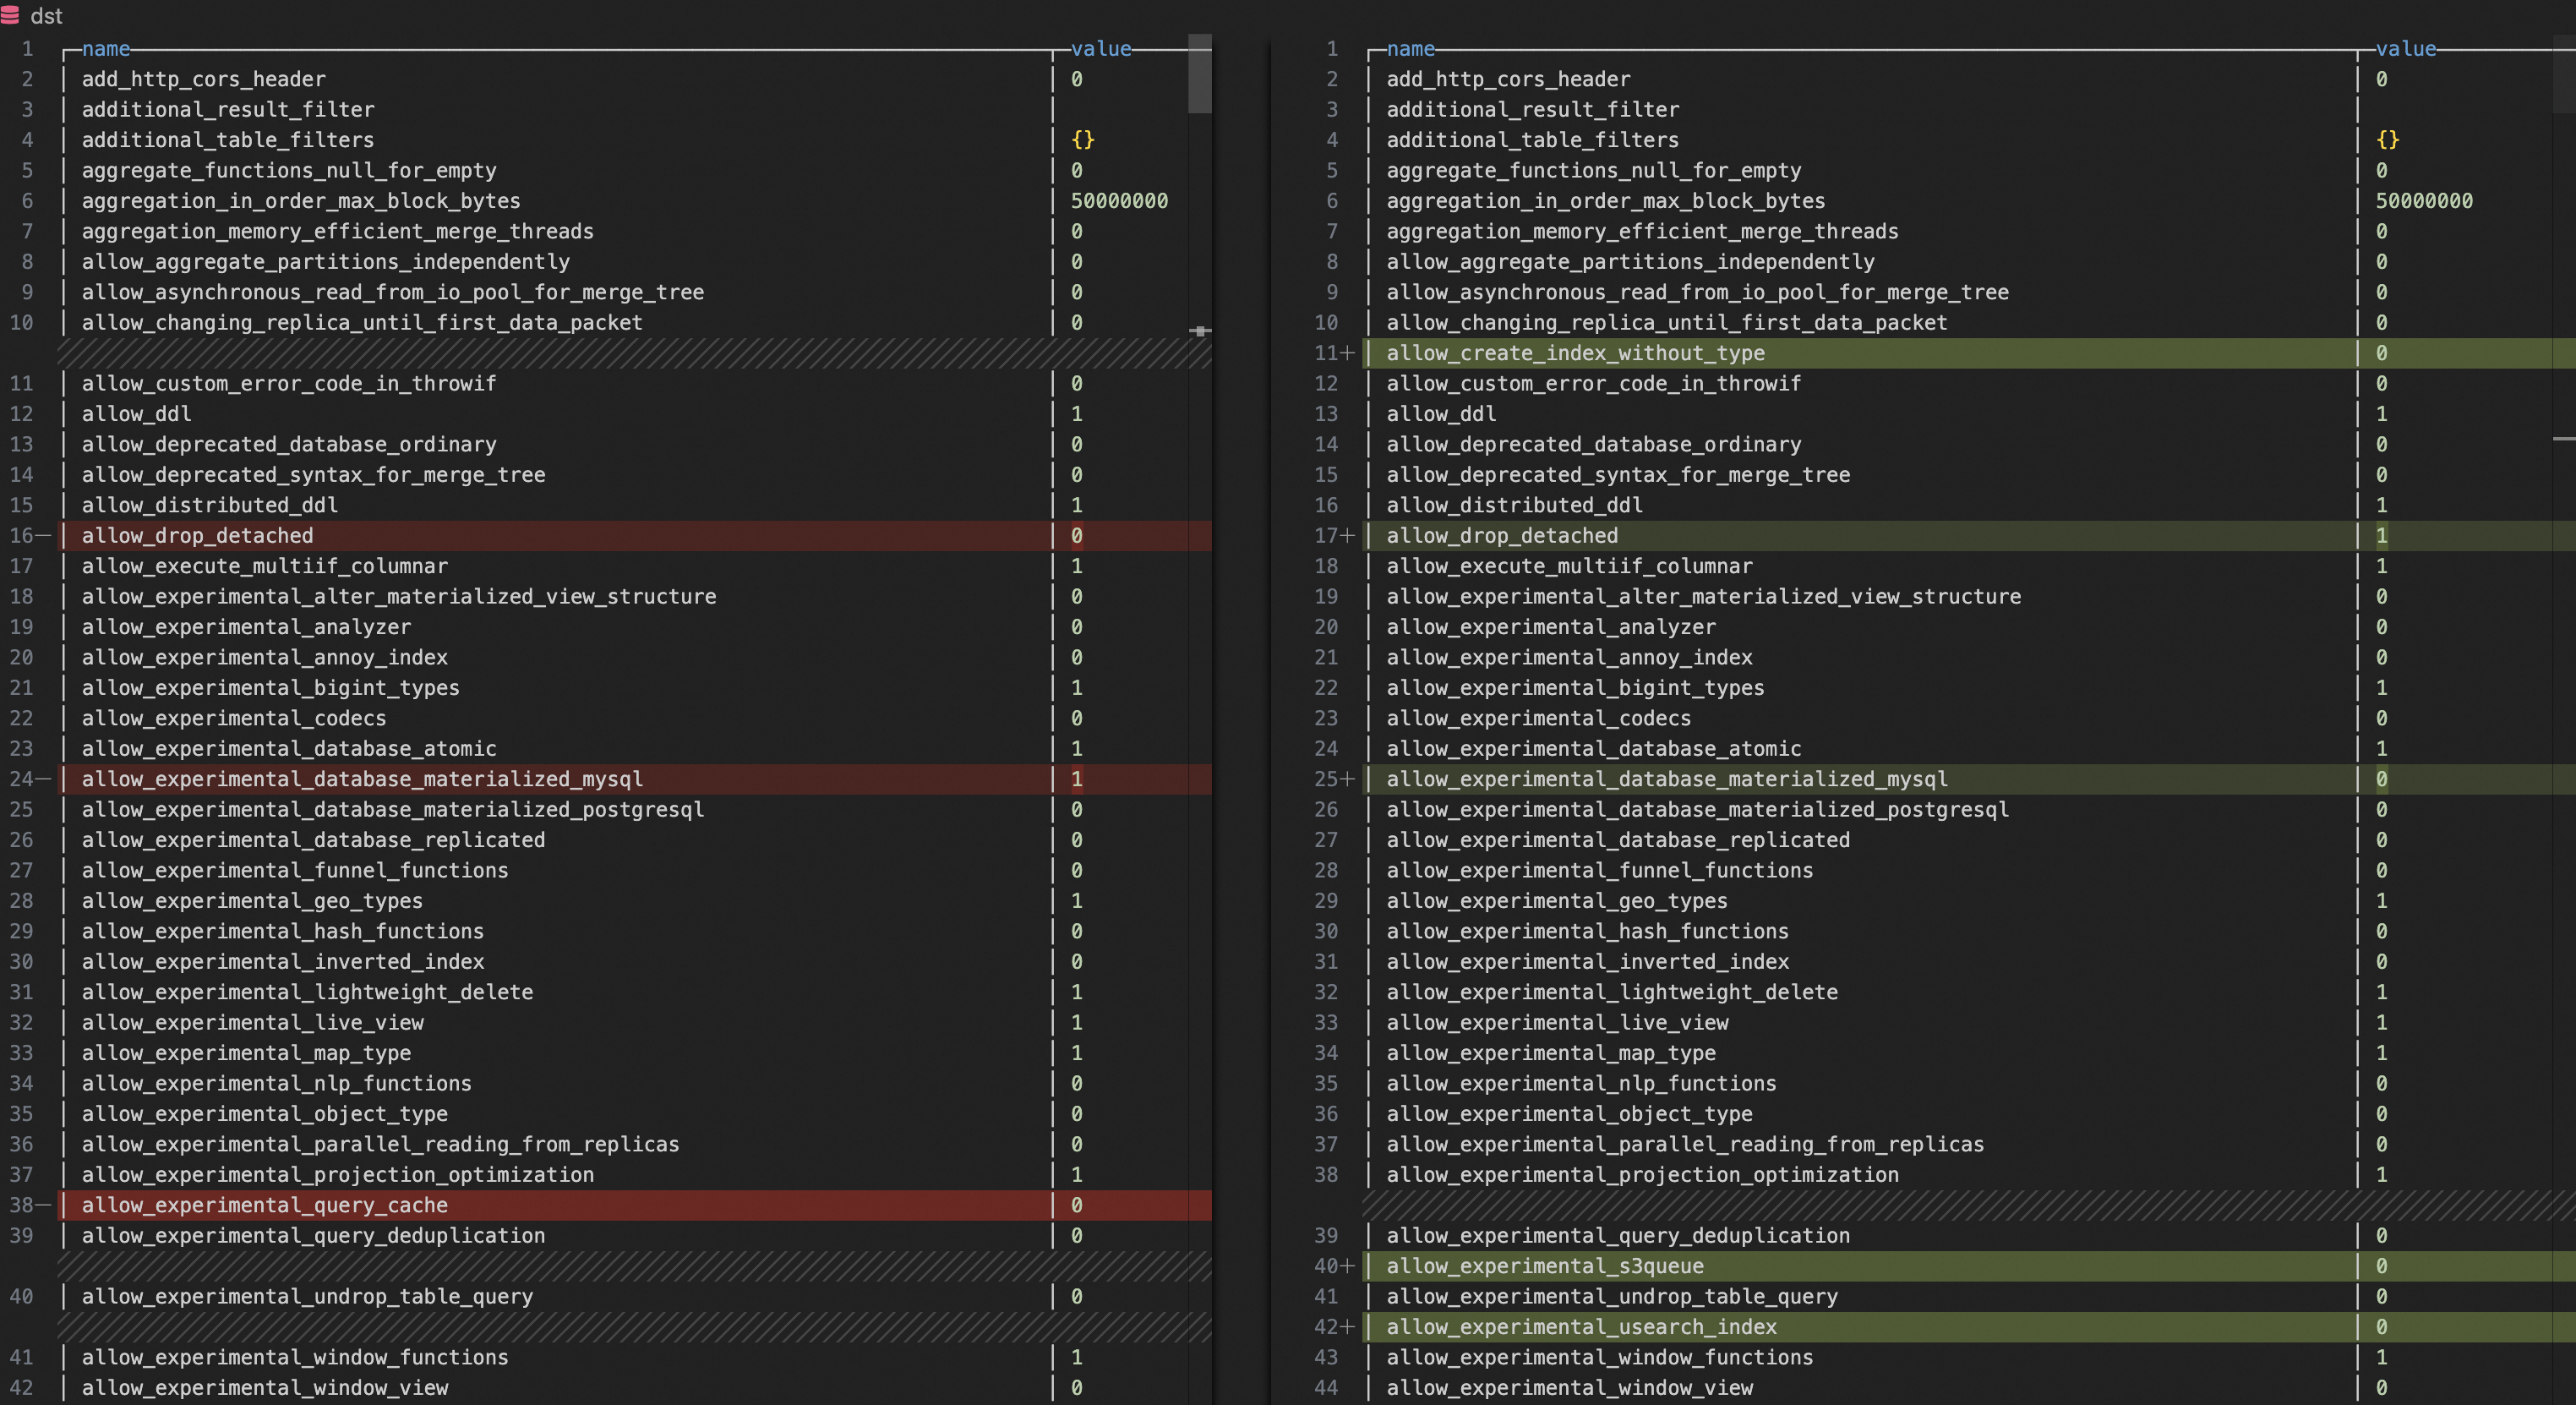
Ejecute esta consulta tanto en su clúster autogestionado como en su clúster de ApsaraDB for ClickHouse para exportar todos los parámetros de configuración:
SELECT
    name,
    groupArrayDistinct(value) AS value
FROM clusterAllReplicas(`default`, system.settings)
GROUP BY name
ORDER BY name ASC
A continuación, utilice una herramienta de comparación (como la comparación de archivos integrada de VS Code) para identificar discrepancias. Para cualquier parámetro que difiera, actualice el clúster de ApsaraDB for ClickHouse para que coincida con el valor del clúster autogestionado.
Parámetros que afectan la compatibilidad:
compatibilityprefer_global_in_and_joindistributed_product_mode
Parámetros que afectan el rendimiento:
max_threadsmax_bytes_to_merge_at_max_space_in_poolprefer_global_in_and_join
Compatibilidad de MaterializedMySQL
Si su clúster autogestionado sincroniza datos desde MySQL mediante el motor MaterializedMySQL, tenga en cuenta cómo gestiona esto ApsaraDB for ClickHouse después de la migración.
La versión comunitaria del motor MaterializedMySQL ya no recibe mantenimiento. ApsaraDB for ClickHouse utiliza Data Transmission Service (DTS) para sincronizar los datos de MySQL en su lugar. DTS crea una tabla local ReplacingMergeTree en cada nodo del clúster y una tabla distribuida que enruta las escrituras a esos nodos, lo cual reemplaza por completo la tabla MaterializedMySQL.
Este cambio arquitectónico provoca dos problemas comunes:
Problema 1: Fallos en consultas IN y JOIN sobre la tabla distribuida
En el clúster autogestionado, MaterializedMySQL replica los datos directamente a cada shard. Tras la migración, los datos fluyen a través de una tabla distribuida, lo que modifica la forma en que se resuelven las subconsultas IN y JOIN. Para obtener detalles y soluciones, consulte What do I do if an error occurs when I use a subquery on a distributed table?.
Problema 2: Datos duplicados en los resultados de las consultas
La tabla ReplacingMergeTree fusiona filas duplicadas de forma asíncrona en segundo plano. Si las fusiones se retrasan, las consultas devuelven más duplicados de los que generaba el clúster autogestionado. Existen dos soluciones disponibles:
Solución 1: Forzar la deduplicación al momento de la consulta
Ejecute el siguiente comando para habilitar el modificador final de manera global. Esto deduplica los resultados durante cada consulta, pero incrementa el uso de CPU y memoria:
SET global final = 1;Solución 2: Ajustar la frecuencia de fusión en la tabla destino
Incremente la frecuencia con la que ApsaraDB for ClickHouse fusiona partes en la tabla ReplacingMergeTree:
ALTER TABLE <AIM_TABLE>
    MODIFY SETTING
        min_age_to_force_merge_on_partition_only = 1,
min_age_to_force_merge_seconds = 60;|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Cuando se establece en |
|
|
|
Intervalo de tiempo entre fusiones forzadas de partes (en segundos) |
|
Verificación de compatibilidad SQL
Utilice un script de Python para extraer sentencias SELECT del registro de consultas de su clúster autogestionado y reproducirlas en ApsaraDB for ClickHouse. Las consultas con errores indican problemas de compatibilidad SQL que deben resolverse antes de la migración.
Requisitos previos
Antes de empezar, asegúrese de contar con:
Un entorno de Python 3 en el servidor de verificación. Una instancia de Alibaba Cloud Elastic Compute Service (ECS) con Linux ya incluye Python 3. Si no utiliza ECS, instale Python 3 desde el sitio web oficial de Python.
Conectividad de red desde el servidor de verificación hacia ambos clústeres. Para solucionar problemas de conectividad, consulte How do I resolve network connectivity issues between the target cluster and the data source?
Verificar la compatibilidad SQL
-
Instale la biblioteca cliente de Python para ClickHouse:
pip3 install clickhouse_driver -
Cree un archivo de Python con el siguiente script. Reemplace los valores de marcador de posición con sus detalles de conexión reales:
from clickhouse_driver import connect
import datetime
import logging
# pip3 install clickhouse_driver is required.

# Connection settings for the self-managed cluster
host_old = 'HOST_OLD'          # VPC endpoint
port_old = TCP_PORT_OLD        # TCP port
user_old = 'USER_OLD'          # Username
password_old = 'PASSWORD_OLD'  # Password

# Connection settings for ApsaraDB for ClickHouse
host_new = 'HOST_NEW'          # VPC endpoint
port_new = TCP_PORT_NEW        # TCP port
user_new = 'USER_NEW'          # Username
password_new = 'PASSWORD_NEW'  # Password

logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')

def create_connection(host, port, user, password):
    """Establish a connection to ClickHouse."""
    return connect(host=host, port=port, user=user, password=password)

def get_query_hashes(cursor):
    """Query the query_hash list of the last two days."""
    get_queryhash_sql = '''
    select distinct normalized_query_hash from system.query_log
    where type='QueryFinish'
      and `is_initial_query`=1
      and `user` not in ('default', 'aurora')
      and lower(`query`) not like 'select 1%'
      and lower(`query`) not like 'select timezone()%'
      and lower(`query`) not like '%dms-websql%'
      and lower(`query`) like 'select%'
      and `event_time` > now() - INTERVAL 2 DAY;
    '''
    cursor.execute(get_queryhash_sql)
    return cursor.fetchall()

def get_sql_info(cursor, queryhash):
    """Query the SQL information for the specified query_hash in the last 2 days (search range is 3 days)."""
    get_sqlinfo_sql = f'''
    select `event_time`, `query_duration_ms`, `read_rows`, `read_bytes`, `memory_usage`, `databases`, `tables`, `current_database`, `query`
    from system.query_log
    where `event_time` > now() - INTERVAL 3 DAY and `type`='QueryFinish' and `normalized_query_hash`='{queryhash}' limit 1
    '''
    cursor.execute(get_sqlinfo_sql)
    sql_info = cursor.fetchone()
    if sql_info:
        return [info.strftime('%Y-%m-%d %H:%M:%S') if isinstance(info, datetime.datetime) else info for info in sql_info[:-1]], sql_info[-1]
    return None

def execute_sql_on_new_db(cursor, current_database, query_sql, execute_failed_sql):
    """Execute the SQL query on the new cluster and record any failures."""
    try:
        cursor.execute(f"USE {current_database};")
        cursor.execute(query_sql)
    except Exception as error:
        logging.error(f'query_sql execute in new db failed: {query_sql}')
        execute_failed_sql[query_sql] = error

def main():
    conn_old = create_connection(host=host_old, port=port_old, user=user_old, password=password_old)
    conn_new = create_connection(host=host_new, port=port_new, user=user_new, password=password_new)

    cursor_old = conn_old.cursor()
    cursor_new = conn_new.cursor()

    # Extract query hashes and SQL from the self-managed cluster
    old_query_hashes = get_query_hashes(cursor_old)
    old_db_execute_dir = {}
    for queryhash in old_query_hashes:
        sql_info, query = get_sql_info(cursor_old, queryhash[0])
        if sql_info:
            old_db_execute_dir[query] = sql_info

    cursor_old.close()
    conn_old.close()

    # Replay queries against ApsaraDB for ClickHouse
    execute_failed_sql = {}
    keys_list = list(old_db_execute_dir.keys())
    for query_sql in old_db_execute_dir:
        position = keys_list.index(query_sql)
        current_database = old_db_execute_dir[query_sql][-1]
        logging.info(f"new db test the {position + 1}th/{len(old_db_execute_dir)}, running sql: {query_sql}\n")
        execute_sql_on_new_db(cursor_new, current_database, query_sql, execute_failed_sql)

    # Collect execution results from ApsaraDB for ClickHouse
    new_query_hashes = get_query_hashes(cursor_new)
    new_db_execute_dir = {}
    for queryhash in new_query_hashes:
        sql_info, query = get_sql_info(cursor_new, queryhash[0])
        if sql_info:
            new_db_execute_dir[query] = sql_info

    cursor_new.close()
    conn_new.close()

    # Log results
    for query_sql in new_db_execute_dir:
        if query_sql in old_db_execute_dir:
            logging.info(f'succeed sql: {query_sql}')
            logging.info(f'old sql info: {old_db_execute_dir[query_sql]}')
            logging.info(f'new sql info: {new_db_execute_dir[query_sql]}\n')

    for query_sql in execute_failed_sql:
        logging.error('\033[31m{}\033[0m'.format(f'failed sql: {query_sql}'))
        logging.error('\033[31m{}\033[0m'.format(f'failed error: {execute_failed_sql[query_sql]}\n'))

if __name__ == "__main__":
    main()
Ejecute el script y revise la salida. Cada consulta con errores se registra en rojo junto con su mensaje de error. Investigue y corrija los fallos según el error específico antes de proceder con la migración de producción.
Análisis y optimización del rendimiento
Después de cambiar el tráfico a ApsaraDB for ClickHouse, podría observar saturación de CPU o agotamiento de memoria. Los siguientes pasos le ayudarán a localizar sistemáticamente la causa raíz, desde la identificación de las tablas problemáticas hasta el aislamiento y análisis de consultas específicas para su corrección.
Si ya sabe qué tabla o consulta está causando el problema de rendimiento, vaya directamente a Step 3: Analyze SQL performance.
Paso 1: Identificar las tablas que causan el cuello de botella de rendimiento
Existen dos enfoques disponibles: gráficos de llama (flame graphs) y análisis de query_log. Los gráficos de llama requieren más configuración, pero ofrecen un desglose visual e intuitivo del uso de CPU. El análisis de query_log es más sencillo y no necesita herramientas externas, aunque requiere que usted mismo interprete los datos. Utilice ambos métodos conjuntamente para obtener una visión más completa.
Crear un gráfico de llama
Conéctese a ApsaraDB for ClickHouse mediante
clickhouse-client. Para instrucciones de conexión, consulte Connect to a ClickHouse cluster using the command-line interface.-
Exporte
trace_logcorrespondiente a la ventana de tiempo en la que ocurrió el problema de rendimiento. Reemplace<IP>,<port>y los valores deevent_timecon sus valores reales:Parámetro
Descripción
<IP>Endpoint de Virtual Private Cloud (VPC) de ApsaraDB for ClickHouse
<port>Puerto TCP de ApsaraDB for ClickHouse
# trace_type = 'CPU' collects CPU call stacks.
# trace_type = 'Real' collects wall-clock call stacks.
/clickhouse/bin/clickhouse-client -h <IP> --port <port> -q \
  "SELECT arrayStringConcat(arrayReverse(arrayMap(x -> concat( addressToLine(x), '#', demangle(addressToSymbol(x)) ), trace)), ';') AS stack, count() AS samples \
  FROM system.trace_log \
  WHERE trace_type = 'CPU' \
    AND event_time >= '2025-01-08 19:31:00' \
    AND event_time < '2025-01-08 19:33:00' \
  GROUP BY trace \
  ORDER BY samples DESC \
  FORMAT TabSeparated \
  SETTINGS allow_introspection_functions=1" > cpu_trace_log.txt
Instale
clickhouse-flamegraph. Para instrucciones de descarga e instalación, consulte clickhouse-flamegraph.-
Genere el gráfico de llama:
cat cpu_trace_log.txt | flamegraph.pl > cpu_trace_log.svgAbra el archivo SVG para identificar las funciones que consumen más CPU. Por ejemplo, si observa que
ReplacingSortedMergeaparece de forma destacada, centre su investigación en las consultas dirigidas a tablasReplacingMergeTree.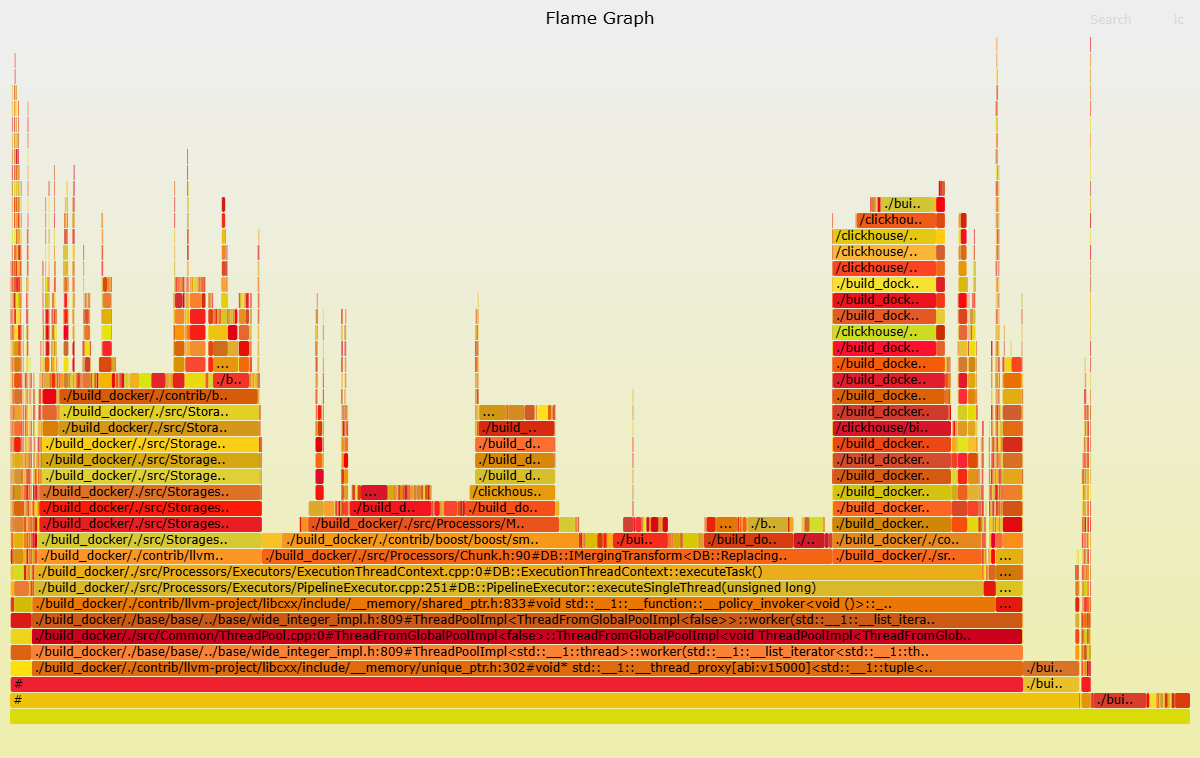
Analizar query_log
Ejecute estas consultas simultáneamente en ambos clústeres para realizar una comparación de los N principales. Busque tablas donde el uso de CPU o memoria sea significativamente mayor en ApsaraDB for ClickHouse que en el clúster autogestionado; esas son sus candidatas.
Un alto uso de CPU o memoria en una tabla no siempre provoca la degradación general del clúster. Solo indica que es más probable que dicha tabla sea el origen del problema. Compare los resultados entre ambos clústeres para confirmarlo.
Localizar tablas con problemas de CPU
SELECT
    tables,
    first_value(query),
    count() AS cnt,
    groupArrayDistinct(normalizedQueryHash(query)) AS normalized_query_hash,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS sum_user_cpu,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS sum_system_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS avg_user_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS avg_system_cpu,
    sum(memory_usage) AS sum_memory_usage,
    avg(memory_usage) AS avg_memory_usage
FROM clusterAllReplicas(default, system.query_log)
WHERE (event_time > '2025-01-08 19:30:00') AND (event_time < '2025-01-08 20:30:00') AND (query_kind = 'Select')
GROUP BY tables
ORDER BY sum_user_cpu DESC
LIMIT 5
Localizar tablas con problemas de memoria
SELECT
    tables,
    first_value(query),
    count() AS cnt,
    groupArrayDistinct(normalizedQueryHash(query)) AS normalized_query_hash,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS sum_user_cpu,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS sum_system_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS avg_user_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS avg_system_cpu,
    sum(memory_usage) AS sum_memory_usage,
    avg(memory_usage) AS avg_memory_usage
FROM clusterAllReplicas(default, system.query_log)
WHERE (event_time > '2025-01-08 19:30:00') AND (event_time < '2025-01-08 20:30:00') AND (query_kind = 'Select')
GROUP BY tables
ORDER BY sum_memory_usage
LIMIT 5
Reemplace los valores de event_time con la ventana de tiempo en la que ocurrió el problema de rendimiento.
Paso 2: Identificar las consultas que causan el cuello de botella de rendimiento
Tras identificar la tabla problemática en el Paso 1, ejecute las siguientes consultas para aislar las sentencias SQL específicas que causan el problema. Reemplace <AIM_TABLE> con el nombre de la tabla obtenida en el Paso 1 y actualice event_time para que coincida con su ventana de tiempo objetivo.
Localizar consultas SQL que causan problemas de CPU
SELECT
    tables,
    first_value(query),
    count() AS cnt,
    normalizedQueryHash(query) AS normalized_query_hash,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS sum_user_cpu,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS sum_system_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS avg_user_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS avg_system_cpu,
    sum(memory_usage) AS sum_memory_usage,
    avg(memory_usage) AS avg_memory_usage
FROM clusterAllReplicas(default, system.query_log)
WHERE (event_time > '2025-01-08 19:30:00') AND (event_time < '2025-01-08 20:30:00') AND (query_kind = 'Select') AND has(tables, '<AIM_TABLE>')
GROUP BY
    tables,
    normalized_query_hash
ORDER BY sum_user_cpu DESC
LIMIT 5
Localizar consultas SQL que causan problemas de memoria
SELECT
    tables,
    first_value(query),
    count() AS cnt,
    normalizedQueryHash(query) AS normalized_query_hash,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS sum_user_cpu,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS sum_system_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS avg_user_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS avg_system_cpu,
    sum(memory_usage) AS sum_memory_usage,
    avg(memory_usage) AS avg_memory_usage
FROM clusterAllReplicas(default, system.query_log)
WHERE (event_time > '2025-01-08 19:30:00') AND (event_time < '2025-01-08 20:30:00') AND (query_kind = 'Select') AND has(tables, 'AIM_TABLE')
GROUP BY
    tables,
    normalized_query_hash
ORDER BY sum_memory_usage
LIMIT 5
Paso 3: Analizar el rendimiento de SQL
Utilice EXPLAIN PIPELINE y system.query_log para comprender por qué una consulta específica es lenta.
Analizar el plan de ejecución:
EXPLAIN PIPELINE <SQL with performance issues>Para obtener detalles sobre cómo interpretar la salida de EXPLAIN, consulte la documentación de EXPLAIN de ClickHouse.
Analizar métricas de ejecución desde query_log:
SELECT
    hostname() AS host,
    *
FROM clusterAllReplicas(`default`, system.query_log)
WHERE
    event_time > '2025-01-18 00:00:00'
    AND event_time < '2025-01-18 03:00:00'
    AND initial_query_id = '<INITIAL_QUERY_ID>'
    AND type = 'QueryFinish'
ORDER BY query_start_time_microseconds
Reemplace <INITIAL_QUERY_ID> con el ID de la consulta que desea investigar y actualice event_time para cubrir la ventana de tiempo relevante.
Preste atención a estos campos en la salida:
|
Campo |
Qué buscar |
|
|
Contadores detallados de tiempo de CPU, E/S de disco, asignación de memoria y red. Permite comparar el uso de recursos entre nodos. Consulte la referencia de eventos del sistema. |
|
|
Parámetros de configuración activos durante la consulta. Ayuda a identificar ajustes que podrían causar comportamientos inesperados. Consulte la referencia de configuración. |
|
|
Tiempo total de ejecución de la consulta. Si una subconsulta es inusualmente lenta, utilice su |
Si las métricas por sí solas no explican la degradación del rendimiento, obtenga la información de ejecución de la misma consulta desde el clúster autogestionado y compárela lado a lado con los resultados de ApsaraDB for ClickHouse. Las diferencias en los valores de ProfileEvents suelen revelar la causa raíz.
Paso 4: Optimizar SQL
Una vez identificada la consulta lenta, aplique las optimizaciones relevantes que se describen a continuación. La mayoría de las regresiones de rendimiento tras la migración tienen una causa raíz específica; enfóquese en la técnica que coincida con sus hallazgos en lugar de aplicar todas a la vez.
|
Optimización |
Descripción |
|
Optimización de índices |
Identifique las columnas utilizadas frecuentemente en cláusulas WHERE y cree un índice para ellas. |
|
Tipos de datos |
Utilice los tipos de datos más adecuados para reducir la sobrecarga de almacenamiento y acelerar las lecturas. |
|
**Evitar |
Seleccione solo las columnas necesarias para reducir la E/S y la transferencia de red. |
|
Usar clave primaria y columnas indexadas en WHERE |
Filtre por columnas indexadas para habilitar la poda de datos. |
|
Usar PREWHERE |
Mueva las condiciones de filtro selectivas a |
|
Usar GLOBAL JOIN para tablas distribuidas |
Reemplace |
|
Ajustar |
Incrementar |
|
Crear vistas materializadas |
Para consultas complejas ejecutadas frecuentemente con resultados estables, preagregue los datos con una vista materializada. |
|
Ajustar la compresión de datos |
ClickHouse comprime los datos de forma predeterminada. Ajustar el algoritmo y el nivel de compresión puede mejorar la eficiencia del almacenamiento y la velocidad de consulta. |
|
Ampliar la caché de consultas |
Para consultas estables y repetidas frecuentemente, incremente |