Un fallo a nivel de zona de disponibilidad es un evento extremo, pero posible, en los servicios en la nube. Si una zona de disponibilidad falla, las cargas de trabajo alojadas en ella pueden dejar de estar disponibles, volverse inaccesibles o devolver errores de datos. Este tema explica cómo utilizar Alibaba Cloud Container Service for Kubernetes (ACK) junto con Alibaba Cloud Service Mesh (ASM) para implementar la recuperación ante desastres en este tipo de situaciones.
Contexto
Alta disponibilidad de los componentes gestionados
Todos los componentes gestionados de los clústeres de ACK y las instancias de ASM se despliegan con múltiples réplicas distribuidas uniformemente en varias zonas de disponibilidad. Esto garantiza que el plano de control del clúster y del service mesh permanezca operativo incluso si falla una sola zona de disponibilidad. De igual manera, los nodos worker y las instancias de contenedores elásticos dentro del clúster también se distribuyen en distintas zonas de disponibilidad. Ante un fallo a nivel de zona de disponibilidad, como un corte de energía o de red, las zonas de disponibilidad sanas continúan operando con normalidad.
Configuraciones de alta disponibilidad y service mesh para fallos en zonas de disponibilidad
Para gestionar fallos a nivel de zona de disponibilidad, el primer paso consiste en desplegar las cargas de trabajo de su aplicación de manera uniforme en las diferentes zonas de disponibilidad.
ACK admite node pools multizona (AZ). Al crear y gestionar un node pool, se recomienda seleccionar vSwitches de distintas AZ y elegir una política de distribución equilibrada al configurar una política de autoescalado. Esto permite que las instancias ECS se distribuyan uniformemente entre las múltiples AZ especificadas para el grupo de escalado. Además, puede utilizar funciones como el autoescalado de nodos, los conjuntos de despliegue y la distribución multi-AZ, combinados con las restricciones de dispersión de topología de Kubernetes, para desplegar las cargas de trabajo de forma equilibrada en las diferentes AZ. Para más detalles, consulte Recommended configurations for a highly available cluster architecture.
Una vez que su aplicación esté desplegada en múltiples zonas de disponibilidad, deberá monitorear el estado de sus aplicaciones de Kubernetes y del clúster en tiempo real para detectar fallos en las zonas de disponibilidad y responder rápidamente para restaurar los servicios.
La tecnología de service mesh mejora la observability de red de su sistema. Los proxies del plano de datos en el service mesh exponen métricas clave relacionadas con las solicitudes de red y las interacciones entre servicios de la aplicación. Estas métricas, que incluyen datos específicos por zona de disponibilidad, pueden indicar diversos problemas y ayudarle a detectar fallos en dichas zonas.
Ante un fallo a nivel de zona de disponibilidad, ASM ofrece recuperación ante desastres al combinar sus capacidades de cambio de tráfico con las de su load balancer. Cuando una zona de disponibilidad deja de estar disponible, puede responder a las alertas configurando un cambio de tráfico para redirigir temporalmente el tráfico de red interno del clúster fuera de la zona afectada. Una vez que la zona de disponibilidad recupere su estado saludable, podrá reanudar el envío de tráfico hacia ella.
Arquitectura de recuperación ante desastres
La gestión de fallos a nivel de zona de disponibilidad implica varios pasos:
Desplegar las cargas de trabajo de manera uniforme en múltiples zonas de disponibilidad y aprovisionar capacidad en cada una de ellas.
Monitorear las métricas de servicio para detectar fallos.
-
Cuando falla una zona de disponibilidad, cambiar rápidamente el tráfico fuera de la zona afectada (manual o automáticamente) para recuperarse del fallo. Esto implica principalmente:
Cambio de tráfico de entrada: Asegúrese de que el load balancer que actúa como punto de entrada del tráfico deje de enviar solicitudes a la zona de disponibilidad afectada.
Cambio de tráfico interno del clúster: Asegúrese de que las llamadas entre servicios dentro del clúster ya no envíen tráfico a la zona de disponibilidad afectada.
Como se muestra en la siguiente figura, para gestionar fallos en múltiples zonas de disponibilidad, cree un clúster de ACK con nodos worker en varias zonas de disponibilidad y despliegue sus cargas de trabajo de manera uniforme entre ellas. También puede recopilar registros del plano de control y eventos del clúster desde su clúster de ACK e instancias de ASM hacia Log Service (SLS). ACK y ASM pueden recopilar métricas relacionadas con nodos, contenedores y servicios en Alibaba Cloud Managed Service for Prometheus. Esta configuración le permite observar oportunamente eventos de fallo en diferentes niveles y consultar el estado de los servicios dentro del clúster mediante registros y paneles de Grafana. Para la entrada al clúster, utilice un load balancer que admita una arquitectura multi-zona de disponibilidad activo-activo, como un Network Load Balancer (NLB) o un Application Load Balancer (ALB).

ASM reporta continuamente registros de acceso y métricas de solicitudes para todo el tráfico entrante y saliente de los servicios en el clúster. Agrega métricas como códigos de respuesta, latencia y tamaños de solicitud. Cuando ocurre un fallo parcial en una zona de disponibilidad, las métricas de solicitudes y las configuraciones de alerta proporcionadas por el service mesh son valiosas para determinar el alcance y los síntomas del fallo. Este ejemplo describe cómo consultar las métricas de tráfico de servicio reportadas por el service mesh. Para obtener información sobre las métricas de carga de trabajo del clúster y las configuraciones de alerta, consulte Connect to and configure Managed Service for Prometheus, Alarm management for Container Service y Event monitoring.
Configuración de recuperación ante desastres
Este ejemplo demuestra cómo realizar la recuperación ante desastres para un fallo a nivel de zona de disponibilidad mediante un clúster que abarca múltiples zonas de disponibilidad.
Paso 1: Preparar el entorno
Cree un clúster administrado de ACK. Al crear el clúster, seleccione vSwitches de dos zonas de disponibilidad para habilitar el soporte multi-AZ. Puede mantener los valores predeterminados para el resto de las configuraciones. El node pool utiliza la política de escalado de distribución equilibrada de forma predeterminada. Para más información, consulte Create an ACK managed cluster.
Cree una instancia de ASM con la misma configuración de zonas de disponibilidad que el clúster de ACK. Para más información, consulte Create an ASM instance.
-
Despliegue la puerta de enlace y una aplicación de ejemplo.
-
En la instancia de ASM, cree un ASM Gateway y asócielo con un Network Load Balancer (NLB). Seleccione las mismas dos zonas de disponibilidad para el NLB que para la instancia de ASM y el clúster de ACK (en este ejemplo,
cn-hangzhou-kycn-hangzhou-h). Para más información, consulte Use an NLB instance at an ASM ingress gateway.NotaEste ejemplo utiliza un ASM Gateway asociado con un NLB como entrada de tráfico. También puede usar un Application Load Balancer (ALB) como entrada para su aplicación. Los ALB también proporcionan capacidades de recuperación ante desastres multi-zona de disponibilidad y eliminación de registros DNS.
Deshabilite la función de reenvío entre zonas para el NLB. Esto asegura que el NLB en cada zona de disponibilidad reenvíe tráfico únicamente a los backends dentro de la misma zona de disponibilidad.
Habilite la inyección automática de sidecar para el namespace
default. Para más información, consulte Manage the global namespace.-
Despliegue la aplicación de ejemplo.
El comando anterior despliega una aplicación compuesta por los servicios
mocka,mockbymockc. Cada servicio incluye dos despliegues sin estado, cada uno con una sola réplica. Los despliegues se distribuyen en nodos de diferentes zonas de disponibilidad mediante distintos camposnodeSelectory se configuran con variables de entorno para devolver la zona de disponibilidad donde se encuentran.NotaPara ofrecer una demostración clara, este ejemplo utiliza el campo
nodeSelectorde un pod para seleccionar manualmente la zona de disponibilidad del pod. En un entorno de producción de alta disponibilidad, debe configurar restricciones de dispersión de topología para asegurar que los pods se distribuyan en diferentes zonas de disponibilidad tanto como sea posible. Para más información, consulte Workload high-availability configuration.
-
Paso 2: Monitorear métricas de servicio
Cuando ocurre un fallo, los registros de carga de trabajo, las métricas y las alertas le ayudan a detectar rápidamente el problema, determinar su alcance y comprender su impacto o causa raíz.
-
Agregue una dimensión de zona de disponibilidad a las métricas de solicitud.
El proxy de la malla puede detectar automáticamente la zona de disponibilidad donde se despliega una carga de trabajo y almacenar esta información en los metadatos del proxy. Puede editar las dimensiones de las métricas para agregar la dimensión
localitya las métricas del service mesh y establecer su valor enxds.node.locality.zone, que representa la zona de disponibilidad de la carga de trabajo. Para más información, consulte Observability configurations. -
Envíe solicitudes a la aplicación de ejemplo para generar métricas de solicitud.
watch -n 0.1 curl nlb-xxxxxxxxxxxxx.cn-xxxxxxx.nlb.aliyuncsslb.com/mock -vSalida esperada:
> GET /mock HTTP/1.1
> Host: nlb-85h289ly4hz9qhaz58.cn-hangzhou.nlb.aliyuncsslb.com
> User-Agent: curl/8.7.1
> Accept: */*
>
* Request completely sent off
< HTTP/1.1 200 OK
< date: Sun, 08 Dec 2024 11:53:26 GMT
< content-length: 150
< content-type: text/plain; charset=utf-8
< x-envoy-upstream-service-time: 5
< server: istio-envoy
<
* Connection #0 to host nlb-85h289ly4hz9qhaz58.cn-hangzhou.nlb.aliyuncsslb.com left intact
-> mocka(version: cn-hangzhou-h, ip: 192.168.122.66)-> mockb(version: cn-hangzhou-k, ip: 192.168.0.47)-> mockc(version: cn-hangzhou-h, ip: 192.168.122.44)%
La salida muestra que las solicitudes se enrutan aleatoriamente a las dos zonas de disponibilidad diferentes, lo cual indica que las cargas de trabajo en ambas zonas están disponibles.
-
Después de enviar solicitudes durante un periodo de tiempo, explore las métricas en Managed Service for Prometheus. Para más información, consulte Metric Explorer.
-
Consulte la información de códigos de estado de solicitud para las cargas de trabajo en diferentes zonas de disponibilidad.
Para comprobar la tasa de solicitudes de las cargas de trabajo en una zona de disponibilidad específica (agrupada por nombre de servicio y código de respuesta), utilice la siguiente consulta PromQL en su instancia de Prometheus:
sum by(app, response_code) (rate(istio_requests_total{locality="cn-hangzhou-h", reporter="destination"}[$__rate_interval]))Resultado esperado:
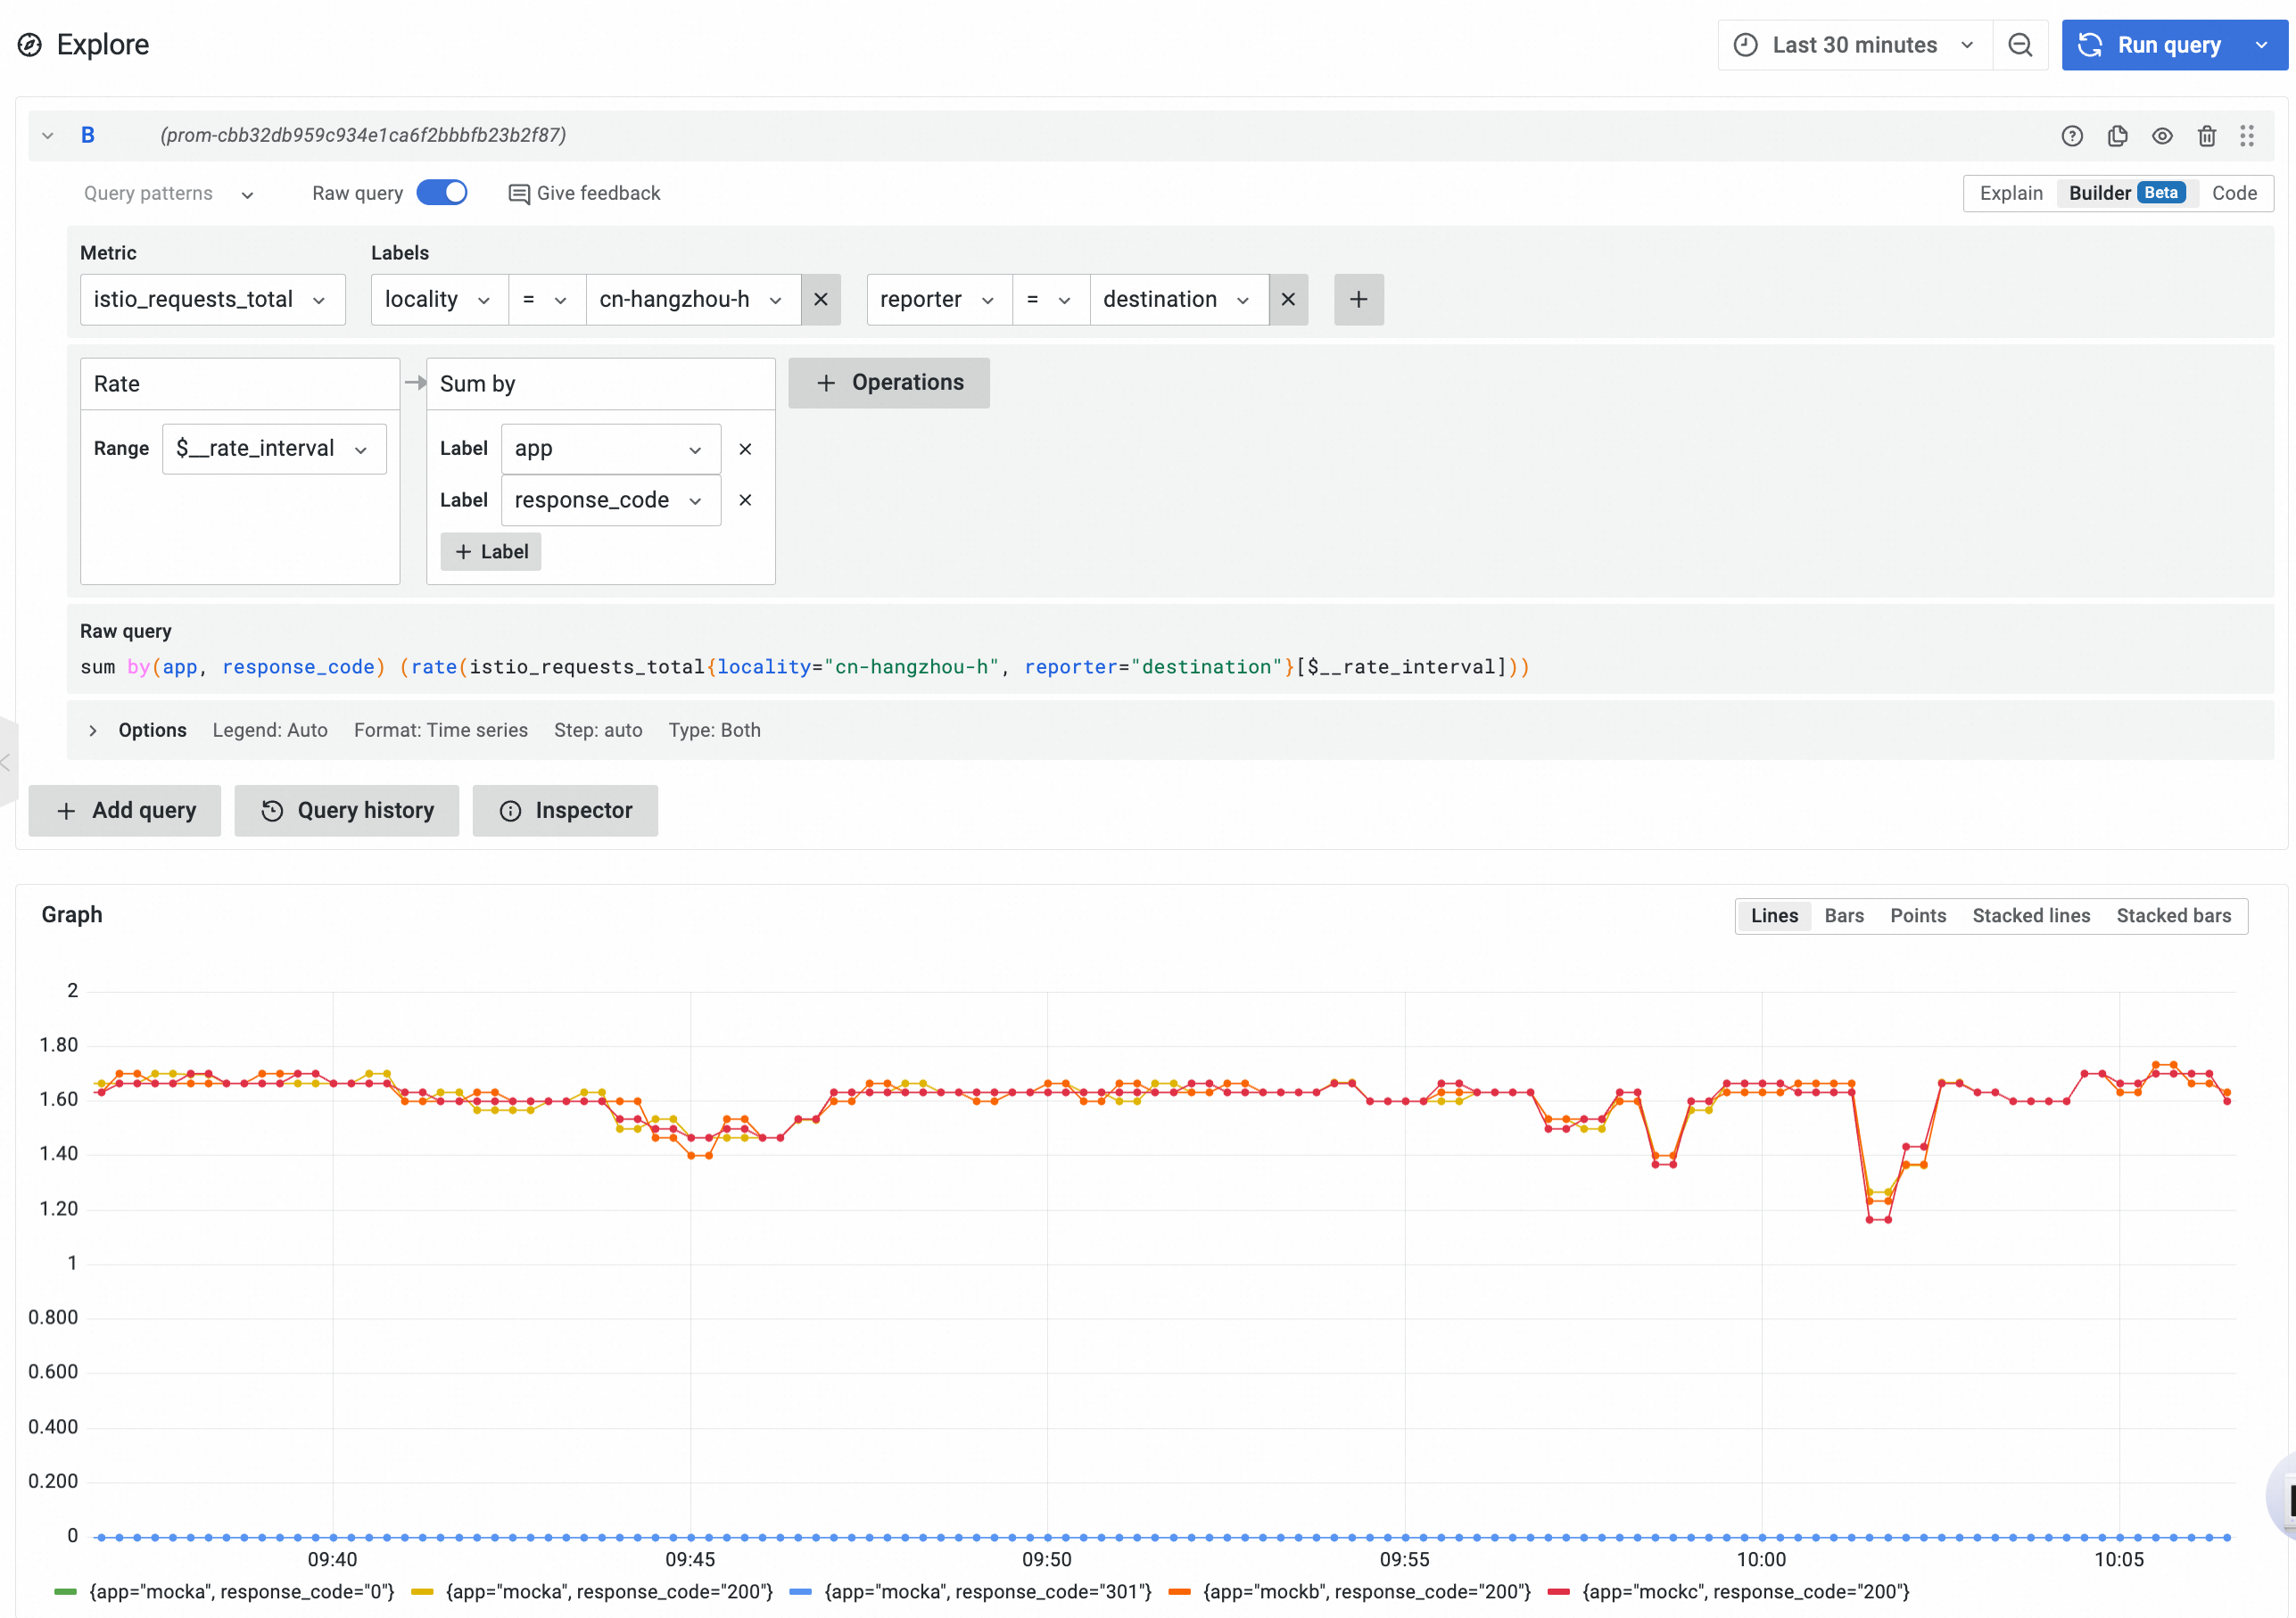
Con un despliegue equilibrado, las tasas de solicitudes recibidas por las dos zonas de disponibilidad son casi idénticas. Puede cambiar la condición de filtro a
locality="cn-hangzhou-k"para consultar la tasa de solicitudes y la información de códigos de estado de la zona de disponibilidadcn-hangzhou-k. -
Consulte la información de latencia de solicitudes para las cargas de trabajo en diferentes zonas de disponibilidad.
Para comprobar la latencia promedio de solicitudes de las cargas de trabajo en una zona de disponibilidad específica (agrupada por nombre de servicio y código de respuesta), utilice la siguiente consulta PromQL en su instancia de Prometheus:
sum by(app, response_code) (rate(istio_request_duration_milliseconds_sum{locality="cn-hangzhou-h", reporter="destination"}[$__rate_interval]))Puede cambiar la condición de filtro a
locality="cn-hangzhou-k"para consultar la información de latencia promedio de la zona de disponibilidadcn-hangzhou-k.
-
-
Configure reglas de alerta basadas en las métricas.
Puede configurar alertas mediante consultas PromQL personalizadas. Cuando la latencia del servicio o la tasa de códigos de estado distintos de 200 supera un umbral, Prometheus envía una alerta al contacto especificado. Para más información, consulte Create a Prometheus alert rule.
-
Cree una regla de alerta basada en la latencia de la aplicación.
Utilice la siguiente consulta PromQL para crear una alerta para el servicio
mockb.sum by(response_code, locality) (rate(istio_request_duration_milliseconds_sum{app="mockb",reporter= "destination"}[1m])) > 3La consulta anterior activa una alerta si la latencia promedio del servicio
mockbdurante un intervalo de un minuto supera los 3 ms. Las alertas se agrupan por código de estado y zona de disponibilidad. -
Cree una regla de alerta basada en el código de estado de respuesta del servicio.
Utilice la siguiente consulta PromQL para crear una alerta para el servicio
mocka.sum by (locality, response_code) (rate(istio_requests_total{app="mocka",reporter="destination",response_code!="200"}[1m])) >= 0
Puede crear reglas de alerta para otras aplicaciones cambiando la configuración
app="mockb"en las reglas de alerta anteriores. -
Paso 3: Realizar un simulacro de recuperación ante desastres
Después de recibir una alerta que indique que una zona de disponibilidad en su clúster de ACK no está sana o presenta problemas, puede aislar las cargas de trabajo de servicio desplegadas en esa zona respecto a las demás. Esto le permite investigar la causa del fallo mientras mantiene su negocio en funcionamiento. Una vez resuelto el fallo, podrá restaurar el tráfico hacia la zona de disponibilidad.
-
Aísle los nodos en la zona de disponibilidad afectada.
Aplique un taint a los nodos para evitar que se programen nuevos pods en ellos. Después de aplicar el taint, los nodos dejan de ser programables. Los pods existentes permanecen en los nodos, pero no se programan nuevos pods en esa zona de disponibilidad. Para más información, consulte Set the scheduling status for a node. El siguiente ejemplo muestra cómo aislar la zona de disponibilidad
cn-hangzhou-hmarcando todos sus nodos como no programables. -
Cambie el tráfico de entrada norte-sur.
Dado que el NLB está configurado para reenvío dentro de la misma zona, debe utilizar la función de eliminación de registros DNS del NLB (o ALB) para cambiar rápidamente el tráfico norte-sur en la capa de entrada cuando ocurra un fallo. Esto evita que el tráfico externo continúe fluyendo hacia la zona de disponibilidad fallida.
Inicie sesión en la consola de NLB y haga clic en la instancia de NLB asociada con el ASM Gateway.
En la página de detalles de la instancia del NLB, en la pestaña Zone, localice la zona de disponibilidad afectada. En la columna Actions, haga clic en Remove DNS y luego haga clic en OK en el cuadro de diálogo que aparece. Una vez eliminado el registro DNS, la dirección IP pública del NLB en la zona de disponibilidad afectada ya no se incluirá en los registros de resolución DNS.
-
Cambie el tráfico este-oeste.
Puede utilizar la función de cambio de tráfico por zona de disponibilidad de Alibaba Cloud Service Mesh (ASM) para redirigir rápidamente el tráfico este-oeste dentro del clúster, evitando que llegue a los endpoints en una zona de disponibilidad específica.
Inicie sesión en la consola de Service Mesh y haga clic en la instancia de ASM que gestiona el clúster.
En la página de detalles de la malla, haga clic en Service Discovery Selectors. Haga clic en Show Advanced Settings, introduzca la información de región y zona de disponibilidad donde se encuentran los pods y luego haga clic en OK.
Tras esta operación, la instancia entra brevemente en estado de actualización. Cuando finaliza la actualización, los endpoints en la zona de disponibilidad especificada quedan excluidos del ámbito de descubrimiento de servicios.
-
Observe el efecto del aislamiento.
Continúe accediendo a la aplicación de ejemplo. Notará que todas las respuestas provienen de servicios en la zona de disponibilidad
cn-hangzhou-k. Esto indica que el tráfico se ha desviado completamente de la zona de disponibilidadcn-hangzhou-h. Salida esperada:> Host: nlb-xxxxxxxxxxxxxxxxxxx8.cn-hangzhou.nlb.aliyuncsslb.com > User-Agent: curl/8.7.1q > Accept: */* > A * Request completely sent off < HTTP/1.1 200 OKe < date: Tue, 10 Dec 2024 04:03:26 GMT < content-length: 1500 < content-type: text/plain; charset=utf-8 < x-envoy-upstream-service-time: 30 < server: istio-envoyr < s { [150 bytes data] {100 150 100 150 0 0 2262 0 --:--:-- --:--:-- --:--:-- 2238 * Connection #0 to host nlb-xxxxxxxxxxxxxxxxxxx8.cn-hangzhou.nlb.aliyuncsslb.com left intact -> mocka(version: cn-hangzhou-k, ip: 192.168.0.44)-> mockb(version: cn-hangzhou-k, ip: 192.168.0.47)-> mockc(version: cn-hangzhou-k, ip: 192.168.0.46)