Un fallo a nivel de región es una interrupción extrema que puede afectar sus servicios en la nube. Cuando esto ocurre, los servicios en cualquiera de sus zonas de disponibilidad corren el riesgo de sufrir fallos de conexión, pérdida de datos e indisponibilidad de cargas de trabajo.Service Mesh (ASM) le permite desplegar una puerta de enlace de entrada de ASM en un clúster de Kubernetes o en una Elastic Container Instance (ECI) como punto de entrada de tráfico unificado para sus aplicaciones. Cada clúster tiene una dirección IP independiente para su puerta de enlace de entrada. Cuando una región falla, se elimina la dirección IP defectuosa y todo el tráfico se redirige a la región sana para lograr la recuperación ante desastres a nivel de región.
Arquitectura de recuperación ante desastres
Esta sección describe una arquitectura de recuperación ante desastres de doble región y doble clúster para demostrar cómo manejar fallos a nivel de región:
-
Configure una arquitectura de plano de control multi-maestro mediante el despliegue de un clúster de Kubernetes en cada una de las dos regiones. Despliegue servicios nativos de la nube idénticos en ambos clústeres. Los servicios se comunican entre sí mediante nombres de dominio del clúster de Kubernetes.
NotaUn plano de control multi-maestro garantiza que la latencia de推送 de los proxies de malla en cada región sea predecible y apta para producción. También proporciona alta disponibilidad del plano de control para la recuperación ante desastres durante un fallo a nivel de región.
Despliegue una puerta de enlace de ASM en cada clúster y configúrela para exponer una dirección IP de entrada pública o un nombre de dominio a través de un Classic Load Balancer (CLB) o un Network Load Balancer (NLB). Luego, utilice Alibaba Cloud DNS y Global Traffic Manager (GTM) para resolver un nombre de dominio a ambas direcciones IP.
Cuando ocurre un fallo a nivel de región, los servicios en la región sana no se ven afectados. Global Traffic Manager (GTM) elimina automáticamente la dirección IP de la región defectuosa del pool de resolución de DNS y enruta todo el tráfico a la puerta de enlace de ASM en la región sana.
Durante un pico de tráfico, configure las siguientes funciones para optimizar aún más la redirección del tráfico tras un fallo regional.
-
Habilite HPA para la puerta de enlace de ASM con el fin de escalar horizontalmente las instancias automáticamente y gestionar los picos de tráfico.
NotaLa función HPA solo está disponible en las ediciones Enterprise y Ultimate de ASM.
Configure el limitador de tasa para la puerta de enlace de ASM o los servicios críticos del clúster. La función de limitación local de ASM evita que los picos de tráfico saturen los servicios del clúster, lo que previene caídas del servicio en la región sana debido a un cambio masivo de tráfico.
(Opcional) Configure el monitoreo de métricas y alertas para la función de limitación de ASM. Esto le permite observar eventos en tiempo real, detectar fallos rápidamente y escalar las cargas de trabajo en la región sana con agilidad.
Flujo de trabajo de recuperación ante desastres
La recuperación ante desastres entre regiones es compatible con todos los tipos de clúster. Este tutorial utiliza un clúster administrado ACK para demostrar el proceso de creación de clústeres e instancias de ASM, completar la configuración de recuperación ante desastres y ejecutar un simulacro de fallo.
Configuración de recuperación ante desastres
Este tutorial utiliza una puerta de enlace de entrada de tipo CLB como ejemplo. Para obtener más información sobre cómo integrar una puerta de enlace de entrada de tipo NLB con GTM, consulte Connect a business domain name to GTM.
Paso 1: Configurar un plano de control multi-maestro
En dos regiones diferentes, cree dos clústeres llamados cluster-1 y cluster-2, y habilite Expose API server with EIP. Para obtener más información, consulte Create an ACK managed cluster.
En las mismas regiones que los clústeres, cree dos instancias de Service Mesh, mesh-1 y mesh-2. Agregue cluster-1 y cluster-2 a las instancias de ASM correspondientes para construir una malla de servicios con plano de control multi-maestro. Para obtener más información, consulte el Paso 1 y el Paso 2 en Implement multi-cluster disaster recovery by using an ASM multi-master control plane architecture.
Paso 2: Desplegar la puerta de enlace de entrada y la aplicación
En ambas instancias de ASM, cree una puerta de enlace de entrada de ASM llamada ingressgateway. Para obtener más información, consulte Create an ingress gateway.
En los clústeres cluster-1 y cluster-2, despliegue la aplicación de muestra Bookinfo. Para obtener más información, consulte Deploy an application in a cluster associated with an ASM instance.
En ambas instancias de ASM, cree un recurso Gateway y un servicio virtual para utilizar la puerta de enlace de ASM como punto de entrada de tráfico para la aplicación Bookinfo. Para obtener más información, consulte Use Istio resources to route traffic based on versions.
-
Habilite globalmente la retención de tráfico local del clúster para ambas instancias de ASM. Para obtener más información, consulte Enable the cluster-local traffic retention feature at the global level.
NotaEn un escenario de recuperación ante desastres a nivel de región, el tráfico debe permanecer dentro de un solo clúster. De forma predeterminada, si se agregan dos o más clústeres de Kubernetes a la misma instancia de malla de servicios, el mecanismo de balanceo de carga de la malla podría enrutar llamadas a servicios en el clúster par. Habilitar la retención de tráfico local del clúster mantiene las solicitudes de un servicio dentro de su propio clúster y evita llamadas entre clústeres.
(Opcional) Paso 3: Verificar el estado del servicio
Obtenga las direcciones IP públicas de las dos puertas de enlace de ASM. Las utilizará para verificar el estado del servicio y configurar GTM posteriormente. Para obtener más información, consulte Obtain the address of the ingress gateway.
-
Utilice los archivos kubeconfig de los clústeres cluster-1 y cluster-2 para consultar los nombres de los pods del servicio reviews.
kubectl get pod| grep reviewsSalida esperada:
reviews-v1-5d99dxxxxx-xxxxx 2/2 Running 0 3d17h reviews-v2-69fbbxxxxx-xxxxx 2/2 Running 0 3d17h reviews-v3-8c44xxxxx-xxxxx 2/2 Running 0 3d17h -
En la barra de direcciones de su navegador, introduzca
http://{IP_address_of_mesh-1_ingress_gateway}/productpageyhttp://{IP_address_of_mesh-2_ingress_gateway}/productpageen secuencia. Actualice la página 10 veces para acceder a la aplicación Bookinfo.Cada vez que actualiza la página, se muestra una versión diferente del servicio reviews (v1, v2 o v3). Las tres versiones del servicio reviews en ambos clústeres coinciden con los nombres de los pods en la salida del paso anterior. Esto indica que los servicios se ejecutan según lo esperado y que la función de retención de tráfico local del clúster opera correctamente.
Las versiones del servicio son visualmente distintas: la versión reviews-v1 no muestra calificaciones con estrellas, la versión reviews-v2 muestra calificaciones con estrellas negras y la versión reviews-v3 muestra calificaciones con estrellas rojas.
Paso 4: Configurar GTM
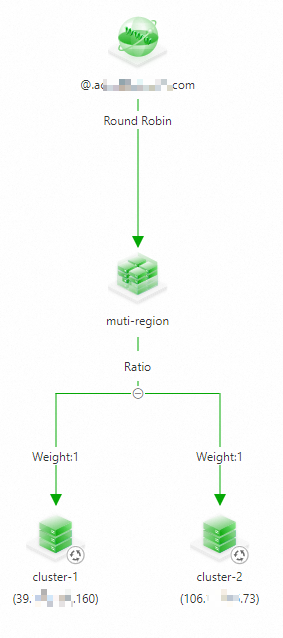
Utilice las dos direcciones IP públicas que obtuvo como direcciones IP de entrada de tráfico para la aplicación y configure el balanceo de carga activo-activo y la recuperación ante desastres en GTM. Para obtener más información, consulte How GTM implements active-active load balancing and disaster recovery.
Una vez completada la configuración, el resultado es similar a la siguiente figura:
(Opcional) Paso 5: Configurar la limitación local y observability
-
Utilice el siguiente contenido YAML para configurar reglas de limitación local para mesh-1 y mesh-2. Para obtener más información, consulte Configure local throttling for an ingress gateway.
apiVersion: istio.alibabacloud.com/v1beta1
kind: ASMLocalRateLimiter
metadata:
  name: ingressgateway
  namespace: istio-system
spec:
  configs:
    - limit:
        fill_interval:
          seconds: 1
        quota: 100
      match:
        vhost:
          name: '*'
          port: 80
          route:
            name_match: gw-to-productage
  isGateway: true
  workloadSelector:
    labels:
      istio: ingressgateway
Configure la recopilación de métricas y alertas para la limitación local en ambas instancias de ASM. Para obtener más información, consulte Configure metric collection and alerts for local throttling.
Simulacro de fallo
Este simulacro utiliza la herramienta fortio para ejecutar una prueba de carga en la aplicación de muestra, lo que simula el acceso de usuarios externos. Durante la prueba de carga, elimine manualmente la carga de trabajo de la puerta de enlace de entrada para simular un fallo regional y observe el failover de recuperación ante desastres.
-
Ejecute el siguiente comando para iniciar una prueba de carga de cinco minutos en la aplicación de muestra. Reemplace el nombre de dominio en el comando por el que configuró en GTM.
fortio load -jitter=False -c 1 -qps 100 -t 300s -keepalive=False -a http://{your_domain_name}/productpage -
Mientras se ejecuta la prueba de carga, simule un fallo regional en cluster-2.
Inicie sesión en la ACK console. En el panel de navegación izquierdo, haga clic en Clusters.
En la página Clusters, haga clic en el nombre de su clúster. En el panel de navegación izquierdo, haga clic en .
En la lista desplegable Namespace, seleccione istio-system.
En la lista de cargas de trabajo, busque istio-ingressgateway. En la columna Actions, haga clic en .
-
Espere a que finalice la prueba de carga. La salida esperada es la siguiente:
# range, mid point, percentile, count
>= -261.054 <= -0.0693516 , -130.561 , 100.00, 3899
# target 50% -130.595
WARNING 100.00% of sleep were falling behind
Aggregated Function Time : count 3899 avg 0.076910055 +/- 0.02867 min 0.062074583 max 1.079674 sum 299.872304
# range, mid point, percentile, count
>= 0.0620746 <= 0.07 , 0.0660373 , 19.34, 754
> 0.07 <= 0.08 , 0.075 , 71.94, 2051
> 0.08 <= 0.09 , 0.085 , 96.08, 941
> 0.09 <= 0.1 , 0.095 , 99.23, 123
> 0.1 <= 0.12 , 0.11 , 99.62, 15
> 0.12 <= 0.14 , 0.13 , 99.82, 8
> 0.14 <= 0.16 , 0.15 , 99.92, 4
> 1 <= 1.07967 , 1.03984 , 100.00, 3
# target 50% 0.0758289
# target 75% 0.0812673
# target 90% 0.0874825
# target 99% 0.0992691
# target 99.9% 0.155505
Error cases : count 527 avg 0.074144883 +/- 0.07572 min 0.062074583 max 1.079674 sum 39.0743532
# range, mid point, percentile, count
>= 0.0620746 <= 0.07 , 0.0660373 , 82.54, 435
> 0.07 <= 0.08 , 0.075 , 96.58, 74
> 0.08 <= 0.09 , 0.085 , 99.05, 13
> 0.09 <= 0.1 , 0.095 , 99.24, 1
> 0.12 <= 0.14 , 0.13 , 99.43, 1
> 1 <= 1.07967 , 1.03984 , 100.00, 3
# target 50% 0.0668682
# target 75% 0.0692741
# target 90% 0.0753108
# target 99% 0.0897923
# target 99.9% 1.06568
# Socket and IP used for each connection:
[0] 3900 socket used, resolved to [39.XXX.XXX.160:80 (3373), 106.XXX.XXX.73:80 (527)], connection timing : count 3900 avg 0.038202153 +/- 0.03097 min 0.027057 max 1.07747175 sum 148.988395
Connection time histogram (s) : count 3900 avg 0.038202153 +/- 0.03097 min 0.027057 max 1.07747175 sum 148.988395
# range, mid point, percentile, count
>= 0.027057 <= 0.03 , 0.0285285 , 13.28, 518
> 0.03 <= 0.035 , 0.0325 , 62.79, 1931
> 0.035 <= 0.04 , 0.0375 , 83.95, 825
> 0.04 <= 0.045 , 0.0425 , 86.13, 85
> 0.045 <= 0.05 , 0.0475 , 86.18, 2
> 0.05 <= 0.06 , 0.055 , 86.28, 4
> 0.06 <= 0.07 , 0.065 , 98.03, 458
> 0.07 <= 0.08 , 0.075 , 99.77, 68
> 0.08 <= 0.09 , 0.085 , 99.92, 6
> 1 <= 1.07747 , 1.03874 , 100.00, 3
# target 50% 0.0337079
# target 75% 0.0378848
# target 90% 0.0631659
# target 99% 0.0755882
# target 99.9% 0.0885
Sockets used: 3900 (for perfect keepalive, would be 1)
Uniform: false, Jitter: false, Catchup allowed: true
IP addresses distribution:
39.XXX.XXX.160:80: 3373
106.XXX.XXX.73:80: 527
Code  -1 : 527 (13.5 %)
Code 200 : 3372 (86.5 %)
Response Header Sizes : count 3899 avg 178.19851 +/- 70.45 min 0 max 207 sum 694796
Response Body/Total Sizes : count 3899 avg 4477.7081 +/- 1822 min 0 max 5501 sum 17458584
All done 3899 calls (plus 1 warmup) 76.910 ms avg, 13.0 qps
La salida muestra que, aunque algunas solicitudes fallaron durante el fallo regional simulado, la mayoría se completó correctamente. Esto demuestra que la combinación de ASM y GTM proporciona eficazmente recuperación ante desastres para el fallo regional.
-
En la consola de GTM, compruebe el estado del nombre de dominio de acceso. La dirección IP de cluster-2 aparece como no disponible.
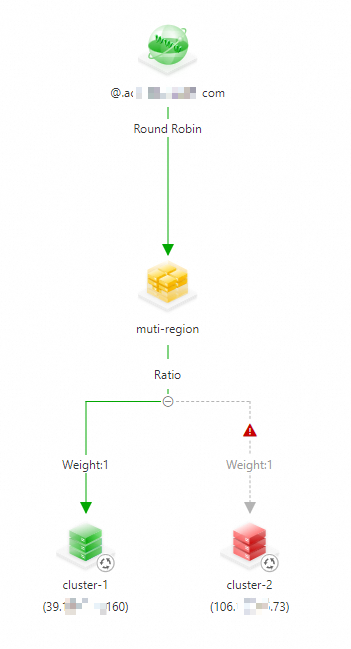
También puede configurar alertas para recibir notificaciones cuando una dirección IP deje de estar disponible, lo que le permite eliminarla manualmente. Para obtener más información, consulte Configure alerts.