La versión más reciente de ARMS Prometheus es Helm v1.1.17, que corresponde al agente v4.0.0. Esta versión incluye varias mejoras para aumentar la estabilidad de la recolección, corregir errores conocidos y optimizar el consumo de recursos.
Si su clúster ejecuta un agente de ARMS Prometheus de la serie v3.x.x, se recomienda actualizar a la versión más reciente. Las versiones anteriores pueden contener componentes sin optimizar y representan un riesgo de desconexión de datos.
Novedades en v4.0.0
|
Tipo de cambio |
Descripción |
|
Nuevo |
Se agregó un trabajo de recolección para eventos del clúster con el fin de admitir el panel de Kubernetes Deployment. |
|
Nuevo |
Se agregaron métricas de automonitoreo basadas en acuerdos de nivel de servicio (SLA) para proporcionar datos al panel de estabilidad de SLA. |
|
Nuevo |
Se añadió compatibilidad con la autenticación BasicAuth en ServiceMonitor. El Secret debe estar en el mismo namespace que el ServiceMonitor. |
|
Nuevo |
Se incorporó una función de metadatos de métricas que muestra el significado de métricas específicas. |
|
Nuevo |
El agente ahora transmite su versión de chart al servidor. Este utiliza el número de versión para inicializar o actualizar los paneles. |
|
Nuevo |
Se agregaron métricas de automonitoreo de RemoteWrite para rastrear la duración de envío de cada lote de datos. |
|
Nuevo |
Se añadieron métricas de automonitoreo para errores y latencia en la recolección de métricas básicas. |
|
Nuevo |
Se añadieron métricas de automonitoreo para errores y latencia en la recolección de métricas de negocio. |
|
Mejorado |
Se mejoró la configuración predeterminada de |
|
Mejorado |
Se mejoró el método de detección de servicios para los trabajos de recolección de CSI, principalmente en la recolección de PersistentVolume (PV). |
|
Mejorado |
Se optimizó la frecuencia de |
|
Mejorado |
Se simplificaron algunas entradas de registro y se mejoraron otras para ofrecer información de tiempos más detallada sobre la canalización de extracción. |
|
Mejorado |
Se mejoraron los trabajos de recolección de métricas básicas para usar un intervalo de extracción y un tiempo de espera fijos. Esto los desacopla de la configuración global y reduce interferencias. |
|
Mejorado |
Se optimizó la lógica de interacción en el modo de múltiples réplicas maestro-trabajador. Las réplicas maestras y trabajadoras ya no interfieren entre sí, lo que aumenta la estabilidad general. |
|
Mejorado |
Se mejoró la estrategia de distribución de destinos desde la réplica maestra. El consumo de CPU se redujo aproximadamente un 30 % y el de memoria un 40 %, lo que mejora el rendimiento de la recolección. |
|
Mejorado |
Se optimizó el procesamiento de |
|
Mejorado |
Se optimizó la lógica del listener de Informer para escenarios multiinquilino. El consumo de CPU disminuyó alrededor de un 20 %. |
|
Mejorado |
Se mejoró el manejo de fallas intermitentes en la resolución de CoreDNS. Ahora el agente recurre a una dirección IP almacenada en caché, lo que reduce la dependencia de la resolución DNS en tiempo real y aumenta la estabilidad de la transmisión de datos. |
|
Mejorado |
Se optimizó la lógica de distribución de configuraciones de extracción mediante |
|
Mejorado |
Se optimizó la estrategia de preextracción en la réplica maestra para reducir el consumo de recursos y mejorar sus capacidades de detección de servicios y programación de destinos. |
|
Mejorado |
Se añadió un manejo adaptativo para lotes de datos individuales mayores a 1 MB. Esto reduce la pérdida de datos causada por limitaciones del backend. |
|
Corregido |
Se corrigió un problema en |
|
Corregido |
Se corrigió un problema en escenarios multiinquilino donde las actualizaciones retrasadas de la caché de etiquetas de Pod dividían una sola serie temporal en dos. |
|
Corregido |
Se corrigió un problema donde la réplica maestra ocasionalmente no distribuía destinos a una réplica reiniciada o con un error de falta de memoria (OOM), lo que provocaba destinos de extracción omitidos. |
|
Corregido |
Se corrigieron problemas con el análisis sintáctico del tipo Secret y la transmisión de encabezados en RemoteWrite. |
|
Corregido |
Se corrigió un problema donde la acción de deshabilitar |
|
Corregido |
Se corrigió un problema donde los parámetros globales predeterminados y |
Riesgos de la actualización
Riesgo de la actualización: esta actualización a Helm v1.1.17 y al agente v4.0.0 es disruptiva. Dependiendo de la carga de recolección de métricas de su clúster (cantidad de destinos y series temporales), podría experimentar una breve interrupción de datos. Se espera que dure entre 0 y 5 minutos, aunque este tiempo varía entre clústeres.
Antes de la actualización: debe ejecutar las comprobaciones previas descritas en Step 1: Pre-upgrade checks (Required) para minimizar el impacto en los datos de monitoreo de su clúster.
Después de la actualización: si detecta problemas con los datos, siga los pasos descritos en Step 3: Post-upgrade checks (Optional). Si el problema persiste, consulte Post-upgrade FAQ. Para obtener más ayuda, comuníquese con nuestros expertos técnicos en DingTalk (ID: aliprometheus).
Procedimiento de actualización
Paso 1: Comprobaciones previas a la actualización (obligatorio)
Cuando actualiza de una versión de Helm anterior a la 1.1.16 hacia la 1.1.17, la actualización no conserva la configuración personalizada de parámetros. Debe revisar cualquier configuración personalizada antes de continuar. Si desea conservar estos ajustes, vuelva a aplicarlos manualmente una vez finalizada la actualización.
Las actualizaciones desde la versión 1.1.16 de Helm o posteriores heredan automáticamente los parámetros personalizados, por lo que no necesita volver a aplicarlos en actualizaciones subsecuentes. Siga estos pasos para revisar sus parámetros antes de la actualización:
Inicie sesión en la consola de Container Service for Kubernetes (ACK).
Haga clic en el nombre de su clúster de destino. En el panel de navegación izquierdo, elija Workload > Stateless. Seleccione el namespace
arms-prom. Busque la carga de trabajoarms-prometheus-ack-arms-prometheusy, en la columna Operation, elija More > View YAML para consultar la configuración YAML completa.-
Revise los siguientes parámetros y anote los valores personalizados que desee conservar:
spec.replicas: el valor predeterminado después de la actualización es 1. Si su valor actual es distinto, anótelo.-
spec.containers.args: son los parámetros de inicio del agente para el modo multiinquilino. Si este modo no está habilitado, es posible que el campo no exista. Si personalizó estos parámetros, anote sus valores:tenant_useridtenant_clusteridtenant_token
-
spec.containers.resources: los límites predeterminados son 3 núcleos y 4 GiB de memoria. Las solicitudes predeterminadas son 1 núcleo y 1 GiB de memoria.Si su configuración es distinta, anote los valores para volver a aplicarlos después de la actualización.
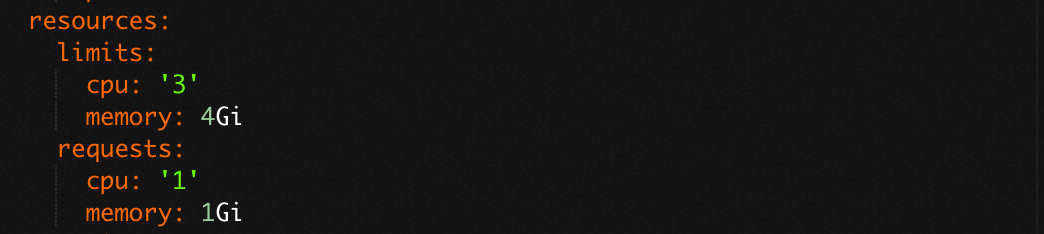
Una vez completada la actualización, use el mismo método para consultar la configuración YAML. Edite el archivo para volver a aplicar sus valores personalizados y luego haga clic en Update para guardar los cambios.

Paso 2: Procedimiento de actualización
Se recomienda actualizar la versión de Helm del componente ARMS Prometheus desde la consola de ACK. Siga estos pasos:
Inicie sesión en la consola de Container Service for Kubernetes (ACK).
Haga clic en el nombre de su clúster de destino. En el panel de navegación izquierdo, elija Operations > Component Management. Haga clic en la pestaña Logs and Monitoring, busque la tarjeta ack-arms-prometheus y haga clic en Upgrade.
-
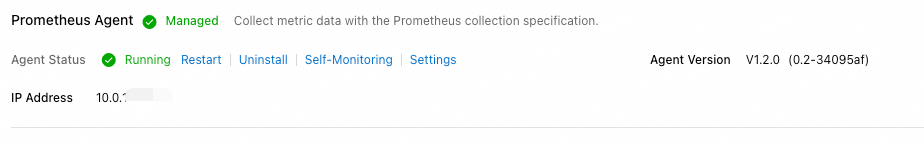
Cuando finalice la actualización, elija Operations > Managed Service for Prometheus en el panel de navegación izquierdo. En la esquina superior derecha, haga clic en Go to ARMS Prometheus. El sistema lo redirigirá a la página de lista de instancias de Prometheus en la consola de Managed Service for Prometheus, donde podrá consultar el estado del agente y los detalles de la recolección de métricas.
Para comprobar la actualización, también puede hacer clic en Settings en el panel de navegación izquierdo y revisar la versión del componente en la pestaña Settings.
Paso 3: Comprobaciones posteriores a la actualización (opcional)
Inicie sesión en la consola de ARMS.
En el panel de navegación izquierdo, elija .
Inicie sesión en la consola de Cloud Monitor.
En el panel de navegación izquierdo, elija para abrir la lista de instancias de Managed Service for Prometheus.
Haga clic en el nombre de su instancia de Prometheus de destino. En el panel de navegación izquierdo, haga clic en Service Discovery. Haga clic en la pestaña Targets para revisar el estado de sus trabajos de recolección.
En el panel de navegación izquierdo, haga clic en Settings. En la pestaña Self-Monitoring, haga clic en View Grafana Dashboard en la esquina superior derecha. Después de la actualización, supervise el estado operativo del agente. Asegúrese de que la cantidad de réplicas sea correcta y de que no haya anomalías en las tasas de envío de datos, el consumo de recursos ni la cantidad de errores.
-
En la página Self-Monitoring, haga clic en la pestaña Agent Self-monitoring para consultar el panel de automonitoreo del agente de Prometheus.
Después de la actualización, revise los cuatro trabajos de recolección de métricas básicas:
_arms/kubelet/cadvisor,_arms/kubelet/metric,_kube-state-metricsynode-exporter. Use el selector de rango de tiempo en la esquina superior derecha para comparar los datos anteriores y posteriores a la actualización, y así detectar posibles problemas de recolección.
Preguntas frecuentes posteriores a la actualización
Discrepancia en la cantidad de réplicas después de la actualización
Compruebe si alguna réplica del agente se encuentra en estado Pending. El agente de ARMS Prometheus requiere que todas las réplicas estén en estado Running para funcionar correctamente. Puede consultar el estado de todas las réplicas en la página Workload > Stateless de su clúster de destino en la consola de ACK, dentro del namespace arms-prom.
Alto consumo de recursos después de la actualización
Revise si existen errores de transmisión de datos. Estos errores pueden provocar que los datos se acumulen en la memoria del agente, lo que incrementa el consumo de recursos. Puede consultar el uso de memoria y CPU del agente de Prometheus en la consola de ACK. Vaya a la página Operations > Managed Service for Prometheus de su clúster de destino, haga clic en la pestaña Others y busque la sección Prometheus Agent para consultar el uso de recursos.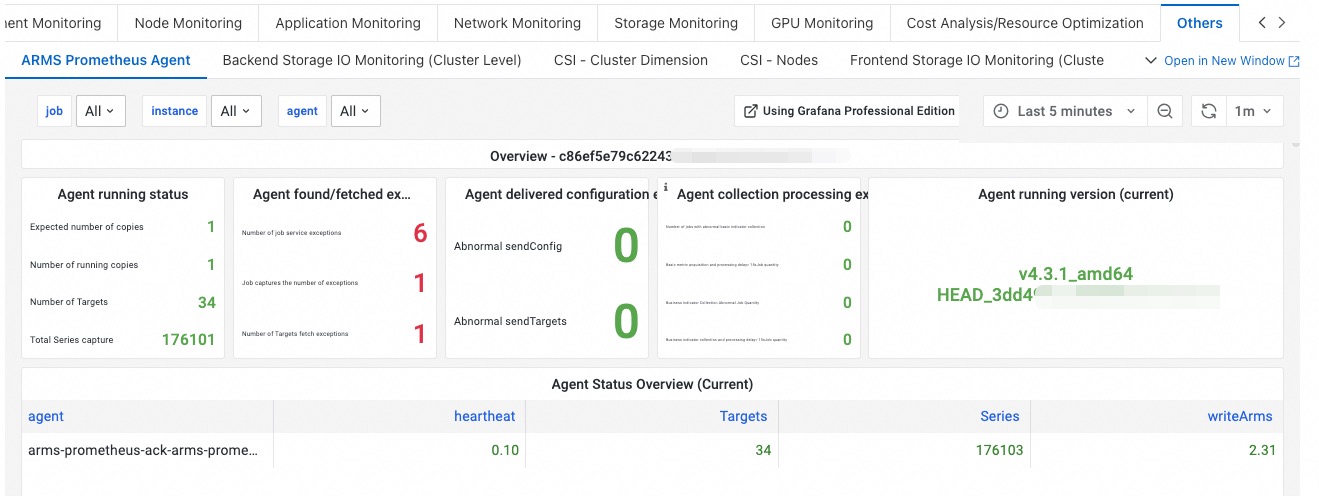
Métricas básicas faltantes o discontinuas
Si detecta problemas con métricas básicas como node_*** (ícono ①), container_*** (ícono ②), kubelet_*** (ícono ③) o kube_*** (ícono ④), compruebe si los trabajos de recolección correspondientes reportan errores. Puede verificar el estado de estos trabajos en la pestaña Service Discovery > Targets de la consola de Managed Service for Prometheus. Si encuentra errores, comuníquese con nuestros expertos técnicos en DingTalk (ID: aliprometheus) para obtener asistencia.
Caída de tráfico o pérdida de datos en RemoteWrite
Si no ha configurado RemoteWrite, puede ignorar este problema.
Si configuró RemoteWrite, tenga en cuenta que en el agente v4.0.0 la opción
write_relabel_configsahora está habilitada de forma predeterminada, a diferencia de las versiones anteriores. Si su configuración incluye acciones comodropokeep, es posible que observe una caída en el tráfico. Modifique esta configuración según sus necesidades. Para ello, vaya a la página Settings en la consola de Managed Service for Prometheus. En la pestaña Settings, haga clic en Edit Prometheus.yaml y modifique la configuración.