ARMS Application Monitoring recopila métricas de memoria de la JVM para ayudarle a identificar fugas de memoria, ajustar la recolección de basura y dimensionar correctamente las asignaciones de heap y non-heap. Este tema explica las áreas de memoria que monitorea ARMS, cómo se recopilan los datos y cómo solucionar problemas comunes de memoria.
El agente de ARMS recopila datos de memoria mediante MemoryMXBean en el Java Development Kit (JDK). Debido a las limitaciones de MemoryMXBean, ARMS no puede monitorear todas las áreas de memoria de un proceso de Java; las pilas de hilos de la VM y la memoria de Java Native Interface (JNI) quedan excluidas. Para más detalles, consulte Interface MemoryMXBean.
Estructura de memoria del proceso de Java
A continuación se muestra un diagrama con las principales áreas de memoria de un proceso de Java.

Este diagrama solo abarca las áreas principales de memoria. La estructura real de memoria de la JVM es más compleja.
Memoria heap
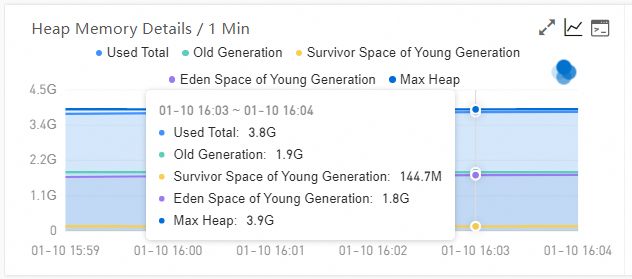
El heap es el área principal de memoria donde la JVM asigna objetos y ejecuta la recolección de basura (GC). ARMS reporta el uso del heap mediante MemoryMXBean, pero el valor máximo reportado puede ser ligeramente inferior al configurado con -Xmx, dependiendo del recolector de basura en uso.
Por qué el máximo reportado difiere de -Xmx
MemoryMXBean excluye las áreas de supervivencia From Space y To Space de su cálculo del heap. Esto provoca una discrepancia en ciertos recolectores:
|
Recolector de basura |
**Máximo reportado vs. |
|
Garbage-First (G1) Garbage Collector |
Coincide con |
|
Parallel Garbage Collector (ParallelGC) |
Ligeramente inferior a |
|
Concurrent Mark Sweep (CMS) Collector |
Ligeramente inferior a |
|
Serial Garbage Collector |
Ligeramente inferior a |
Ejemplo: Con -XX:+UseParallelGC -Xms4096m -Xmx4096m, ARMS reporta un máximo aproximado de 3.8 GB en lugar de 4 GB.
Memoria non-heap
La memoria non-heap que reporta ARMS es la suma de tres áreas:
Non-heap memory = Metaspace + Compressed class space + Code cache

Las pilas de hilos de la VM y la memoria JNI no se incluyen en el total de non-heap porque MemoryMXBean no las rastrea.
Metaspace
Almacena metadatos de clases, como estructuras de clase, métodos y campos. Su uso suele estabilizarse después del inicio de la aplicación.
|
Parámetro de la JVM |
Propósito |
|
|
Tamaño inicial del metaspace (JDK 8+) |
|
|
Tamaño máximo del metaspace (JDK 8+) |
Compressed class space
Almacena los metadatos de las clases cargadas en formato comprimido. Al limitar el tamaño de los punteros, el compressed class space reduce la huella de memoria de las aplicaciones de Java. El tamaño predeterminado en JDK 11 es de 1 GB.
|
Parámetro de la JVM |
Propósito |
|
|
Establezca el tamaño del compressed class space |
Caché de código
Almacena código nativo generado por la JVM, incluidos bucles del intérprete, stubs de JNI, métodos compilados just-in-time (JIT) y métodos de Java. La salida del JIT representa la mayor parte del uso de la caché de código.
|
Parámetro de la JVM |
Propósito |
|
|
Tamaño inicial de la caché de código |
|
|
Tamaño máximo de la caché de código |
Búfer directo
Los búferes directos asignan memoria en el sistema operativo en lugar de en el heap de la JVM. Dado que evitan la copia entre la memoria de la JVM y la del sistema operativo, ofrecen un rendimiento de E/S más rápido y procesan grandes volúmenes de datos de manera eficiente; sin embargo, las operaciones intensivas de E/S incrementan proporcionalmente el consumo de memoria del búfer directo.
Solución de fugas de memoria
Fugas de memoria heap
Si la memoria heap crece de forma constante con el tiempo, es posible que exista una fuga. ARMS ofrece dos funciones para analizar fugas en la memoria heap:
Memory snapshot: capture una instantánea del heap para inspeccionar la asignación de objetos.
Continuous profiling: rastree las asignaciones a lo largo del tiempo para identificar el origen de la fuga.
Comience por revisar el gráfico de memoria heap de la JVM en Application Monitoring. Si el heap utilizado muestra una tendencia ascendente durante varios ciclos de GC, tome una instantánea de memoria o habilite el perfilado continuo.
Fugas de memoria non-heap
Si la memoria heap se mantiene estable pero la memoria total del proceso sigue creciendo, es probable que haya una fuga en non-heap. ARMS no analiza directamente la memoria non-heap. Utilice la herramienta Native Memory Tracking (NMT) proporcionada por el JDK para monitorear las asignaciones de memoria non-heap.
Para más detalles, consulte Native Memory Tracking en la documentación de Oracle.
NMT requiere conocimientos técnicos y añade una sobrecarga de rendimiento del 5 % al 10 %. Evalúe el impacto antes de habilitarla en producción.
Preguntas frecuentes
¿Por qué la memoria en Application Monitoring difiere de la salida de top?
Application Monitoring recopila datos mediante Java Management Extensions (JMX), que solo cubre las áreas de heap y non-heap administradas por la JVM. El Resident Memory Size en KiB (RES) que reporta top incluye memoria adicional (pilas de hilos de la VM, pilas de hilos locales y asignaciones fuera de la JVM) que JMX no rastrea.
¿Por qué la memoria en Application Monitoring difiere de Managed Service for Prometheus o Managed Service for Grafana?
Los dos sistemas utilizan fuentes de datos distintas. Application Monitoring lee métricas JMX desde el interior de la JVM. Managed Service for Grafana consulta métricas a nivel de contenedor mediante Prometheus Query Language (PromQL), generalmente container_memory_working_set_bytes, que representa la suma del Resident Set Size (RSS) y la caché activa de los cgroups de memoria. Este alcance es más amplio que el de JMX.
Un pod se reinicia debido al out-of-memory (OOM) killer. ¿Cómo soluciono esto con Application Monitoring?
Application Monitoring ayuda a resolver problemas de planificación de capacidad de la memoria heap y del búfer directo, pero no captura detalles completos del RSS del proceso. Para investigar el OOM killer, utilice el ecosistema de monitoreo de Prometheus en Kubernetes y así rastrear la memoria a nivel de contenedor.
Compruebe dos cosas:
Otros procesos en el pod: compruebe que el pod ejecute un único proceso de Java. Los procesos sidecar o auxiliares adicionales pueden consumir memoria fuera del alcance del monitoreo de la JVM.
Fugas fuera de la JVM: bibliotecas como glibc pueden provocar fugas de memoria nativa invisibles para JMX. Utilice NMT o herramientas a nivel del sistema operativo para investigar.