ApsaraMQ for RocketMQ distribuye los mensajes en varias colas para evitar puntos críticos y cuellos de botella en el rendimiento. El tipo de mensaje determina la política de balanceo de carga aplicable: los mensajes no ordenados utilizan round robin, mientras que los mensajes ordenados emplean MessageGroupHash.
Comprender estas políticas le permite:
Planificar la recuperación ante desastres: Conocer cómo se redirigen los mensajes cuando falla un nodo.
Garantizar el orden de los mensajes: Entender cómo ApsaraMQ for RocketMQ mantiene una entrega FIFO estricta para los mensajes ordenados.
Escalar el rendimiento: Diseñar estrategias eficaces de distribución de tráfico y escalado de colas.
Comparación de políticas
|
**Política** |
**Tipo de mensaje** |
**Algoritmo** |
**Garantía de orden** |
**Compatibilidad de versiones** |
|
Round robin |
No ordenado (normal, programado, transaccional) |
Distribución cíclica en todas las colas |
Ninguna |
5.x, 4.x, 3.x |
|
MessageGroupHash |
Ordenado |
Hash basado en SipHash sobre el grupo de mensajes |
FIFO dentro del mismo grupo de mensajes |
Solo 5.x |
Round robin
Round robin es la política de balanceo de carga predeterminada y única para mensajes no ordenados, incluidos los mensajes normales, programados y transaccionales.
Funcionamiento
El productor recorre cíclicamente todas las colas de un tema y distribuye un mensaje por cola antes de pasar a la siguiente. Esto mantiene la carga equilibrada entre las colas y maximiza el rendimiento del tema.
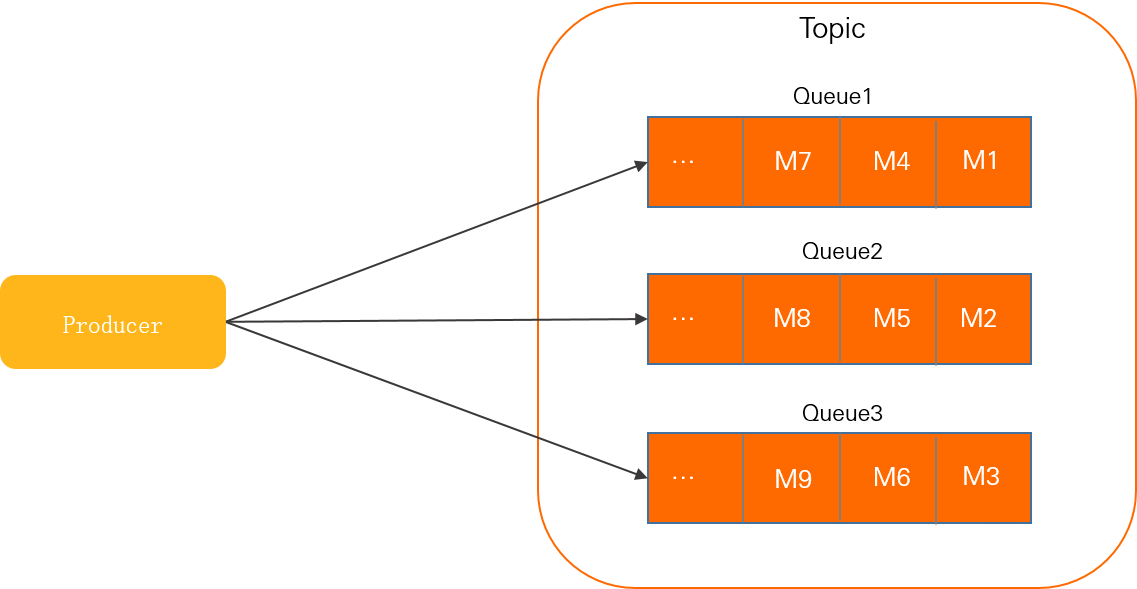
En este diagrama, Queue 1, Queue 2 y Queue 3 son colas del tema. El productor envía M1 a Queue 1, M2 a Queue 2 y M3 a Queue 3; luego reinicia el ciclo para los siguientes mensajes.
Aislamiento de fallos
Si falla el envío de un mensaje, ApsaraMQ for RocketMQ evalúa la causa del fallo y puede omitir temporalmente el nodo afectado al seleccionar la siguiente cola de destino. Este aislamiento automático de fallos redirige los mensajes posteriores a colas sanas sin intervención manual.
Ejemplo de código
Round robin está habilitado de forma predeterminada para mensajes no ordenados. No se requiere configuración adicional.
// Round robin is the default policy for normal messages.
// The SDK automatically distributes messages across all queues.
MessageBuilder messageBuilder = null;
for (int i = 0; i < 10; i++) {
    Message message = messageBuilder.setTopic("normalTopic")
            // Set the message index key for accurate message lookup.
            .setKeys("messageKey")
            // Set the message tag for consumer-side filtering.
            .setTag("messageTag")
            // Set the message body.
            .setBody("messageBody".getBytes())
            .build();
    try {
        SendReceipt sendReceipt = producer.send(message);
        System.out.println(sendReceipt.getMessageId());
    } catch (ClientException e) {
        e.printStackTrace();
    }
}
MessageGroupHash
MessageGroupHash es la política de balanceo de carga predeterminada y única para mensajes ordenados. Garantiza la entrega FIFO (primero en entrar, primero en salir) dentro de cada grupo de mensajes.
Funcionamiento
El productor calcula el hash del identificador de grupo de cada mensaje mediante el algoritmo SipHash y asigna el resultado a una cola específica. Todos los mensajes del mismo grupo se enrutan a la misma cola y se almacenan en el orden de envío.
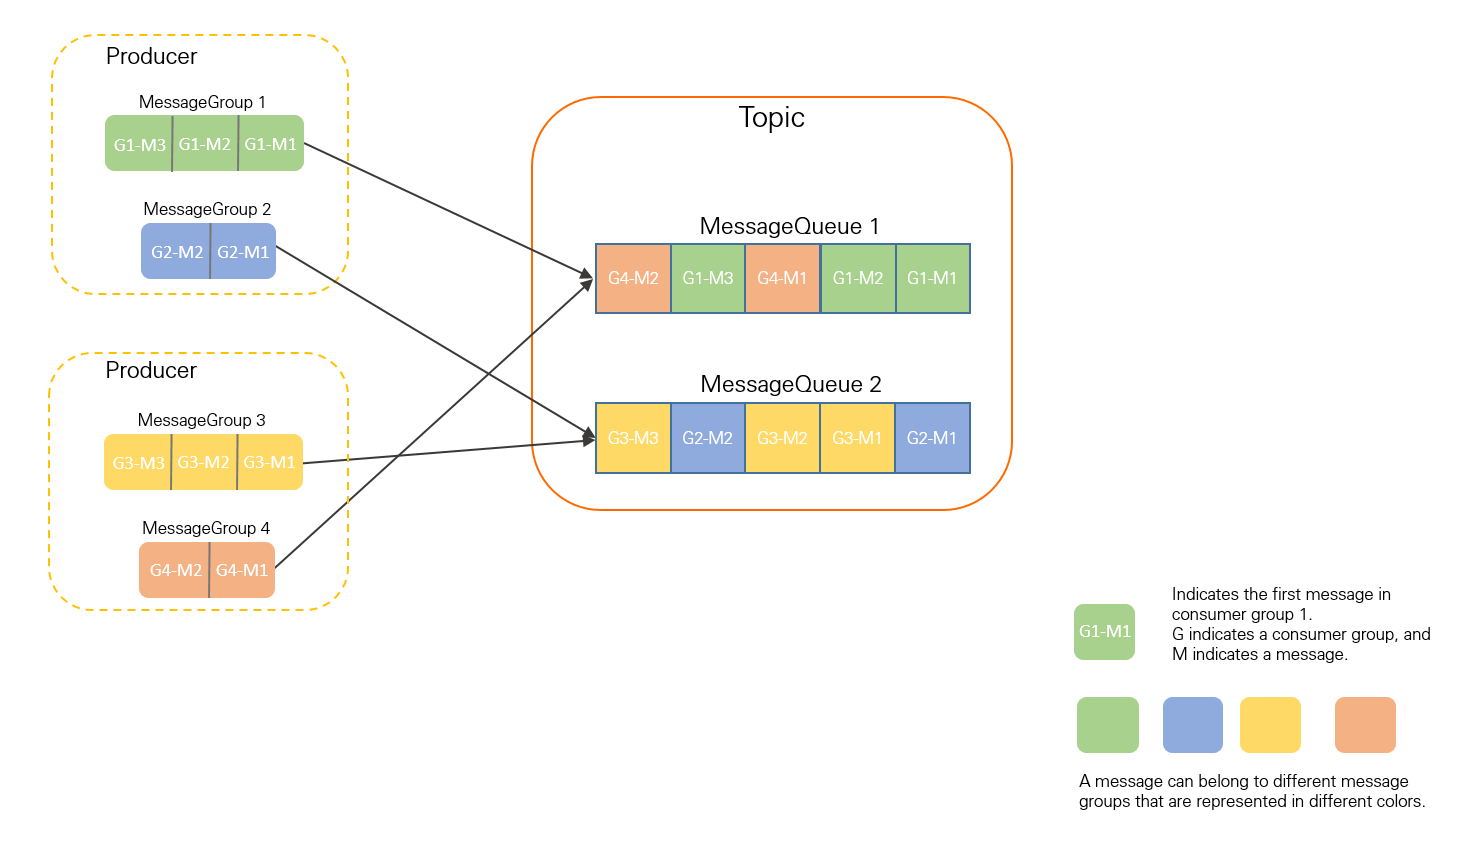
En este diagrama, G1-M1, G1-M2 y G1-M3 pertenecen a MessageGroup 1. El algoritmo SipHash los asigna a MessageQueue 1, donde se almacenan en el orden en que se enviaron.
Riesgo de distribución desigual
Dado que MessageGroupHash asigna cada grupo a una cola fija, los volúmenes desiguales de mensajes entre grupos pueden concentrar la carga en pocas colas. Si la mayoría de los mensajes pertenece a unos pocos grupos, esas colas se convierten en puntos críticos, lo que aumenta la presión sobre el almacenamiento y limita la capacidad de escalado.
Para mitigar esto, diseñe los grupos de mensajes con granularidad fina. Por ejemplo, en un sistema de comercio electrónico, utilice identificadores de pedido o de usuario como claves de grupo de mensajes. Esto distribuye los mensajes en muchos grupos y conserva el orden por pedido o por usuario.
Ejemplo de código
MessageGroupHash está habilitado de forma predeterminada para mensajes ordenados. Especifique el grupo de mensajes con setMessageGroup().
// MessageGroupHash is the default policy for ordered messages.
// Messages in the same group go to the same queue, in send order.
for (int i = 0; i < 10; i++) {
    Message message = messageBuilder.setTopic("fifoTopic")
            // Set the message index key for accurate message lookup.
            .setKeys("messageKey")
            // Set the message tag for consumer-side filtering.
            .setTag("messageTag")
            // Set the message group. Messages with the same group
            // are routed to the same queue via the SipHash algorithm.
            .setMessageGroup("fifoGroupA")
            // Set the message body.
            .setBody("messageBody".getBytes())
            .build();
    try {
        SendReceipt sendReceipt = producer.send(message);
        System.out.println(sendReceipt.getMessageId());
    } catch (ClientException e) {
        e.printStackTrace();
    }
}
Compatibilidad de versiones
|
**Política** |
**5.x** |
**4.x** |
**3.x** |
|
Round robin |
Compatible |
Compatible |
Compatible |
|
MessageGroupHash |
Compatible |
No compatible |
No compatible |
Si actualiza de la versión 4.x o 3.x del servidor a la 5.x, el mecanismo de entrega de mensajes ordenados cambia del método heredado a MessageGroupHash. Para evitar que se reordenen los mensajes durante la transición, consuma todos los mensajes existentes en el tema antes de cambiar a la versión 5.x.
Round robin es compatible con todas las versiones del servidor y no requiere pasos de migración.
Mejores prácticas
Distribuir mensajes en varios grupos
En el modo MessageGroupHash, todos los mensajes del mismo grupo van a la misma cola. Si su lógica de negocio concentra los mensajes en pocos grupos, esas colas se sobrecargan.
Elija claves de grupo granulares que distribuyan los mensajes de manera uniforme. Por ejemplo:
|
**Escenario** |
**Clave de grupo recomendada** |
**Ventaja** |
|
Procesamiento de pedidos |
ID de pedido |
Una cola por pedido; los pedidos se distribuyen entre las colas |
|
Seguimiento de actividad de usuarios |
ID de usuario |
Orden por usuario con distribución uniforme entre usuarios |
|
Telemetría de dispositivos |
ID de dispositivo |
Orden por dispositivo sin puntos críticos |
Usar más de una cola por tema
Independientemente de la política de balanceo de carga, un tema con una sola cola no puede distribuir la carga. Todos los mensajes van a esa única cola, lo que crea un cuello de botella en el rendimiento y elimina la capacidad de recuperación ante desastres.
Configure siempre varias colas por tema para habilitar la distribución de carga y la conmutación por error.