Cuando los productores envían mensajes más rápido de lo que los consumidores los procesan, los mensajes sin procesar se acumulan en el broker de ApsaraMQ for RocketMQ. Este rezago, conocido como acumulación de mensajes, aumenta directamente la latencia de los mensajes: es decir, el tiempo que transcurre entre la producción y el consumo de un mensaje. Una planificación adecuada de la capacidad y el ajuste del consumo evitan que esta acumulación afecte su negocio.
Este tema aborda el mecanismo de consumo del cliente TCP (SDK de Java), las causas principales de la acumulación y cómo prevenirla y resolverla.
Cuándo prestar atención a la acumulación
Existen dos escenarios que requieren especial atención:
Rezago sostenido sin recuperación automática. El sistema descendente consume los mensajes más lento de lo que el sistema ascendente los produce, y la diferencia no se reduce por sí sola.
Requisitos estrictos de tiempo real. Cualquier retraso breve en el consumo resulta inaceptable para el negocio.
Cómo consume mensajes el cliente
Un cliente TCP de ApsaraMQ for RocketMQ en modo push procesa los mensajes en dos fases:
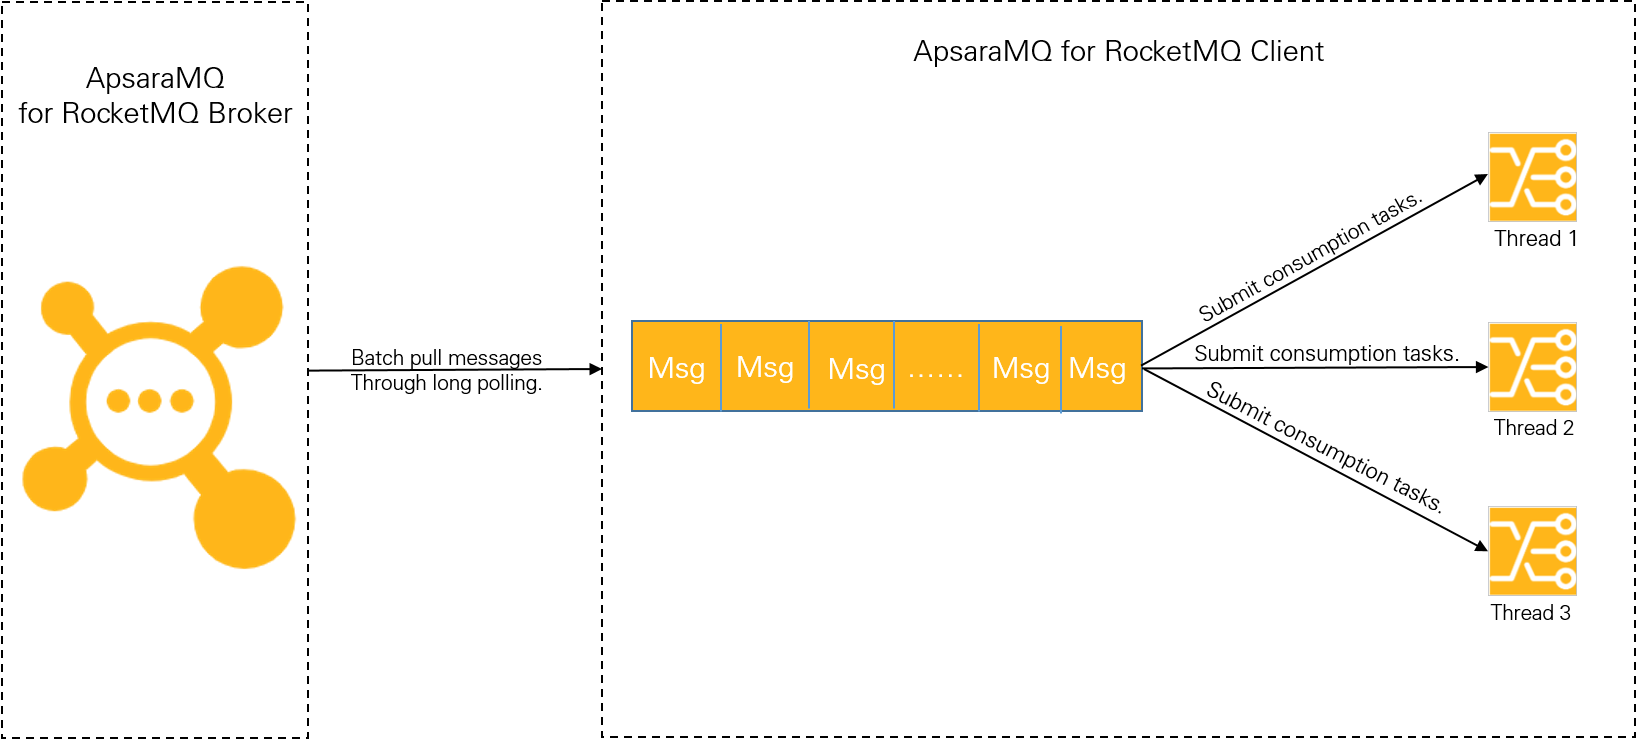
Fase 1: extraer mensajes del broker
El cliente utiliza long polling para extraer mensajes en lotes y los almacena en una cola de búfer local. Esta fase es rápida: incluso un servidor con especificaciones bajas (4 vCPU, 8 GB de memoria), con un solo hilo y una sola partición, alcanza decenas de miles de transacciones por segundo (TPS). Con varias particiones, el throughput escala hasta cientos de miles de TPS. Los cuellos de botella por acumulación no ocurren en esta fase.
Fase 2: procesar mensajes en el hilo de consumo
El cliente envía los mensajes almacenados en caché al hilo de consumo, el cual ejecuta la lógica de negocio. La velocidad de procesamiento depende de dos factores:
Duración del consumo: el tiempo que toma procesar un solo mensaje.
Concurrencia del consumo: la cantidad de mensajes que se procesan en paralelo.
Cuando la cola de búfer local se llena, el cliente deja de extraer nuevos mensajes del broker. El cuello de botella siempre se encuentra en la fase 2 y está determinado por la duración y la concurrencia del consumo. Entre ambos factores, la duración del consumo tiene mayor impacto.
Causas principales de la acumulación
La acumulación de mensajes se origina por un procesamiento lento de cada mensaje (duración del consumo) o por un paralelismo insuficiente (concurrencia del consumo). Identifique cuál de estos factores representa el cuello de botella antes de ajustar la configuración.
|
Causa principal |
Síntomas |
Solución principal |
|
Aumento repentino en la duración del consumo |
La latencia aumenta de forma repentina; la cantidad de hilos es adecuada |
Investigue las dependencias descendentes |
|
Concurrencia insuficiente |
El uso de CPU es bajo; los hilos permanecen inactivos mientras esperan mensajes |
Aumente los hilos por nodo o agregue nodos |
Duración del consumo
El procesamiento interno de la CPU suele ser insignificante en comparación con las operaciones de E/S externas. Las operaciones limitadas por E/S más comunes en la lógica de consumo son:
Lecturas y escrituras en bases de datos (por ejemplo, MySQL)
Lecturas y escrituras en caché (por ejemplo, Redis)
Llamadas a servicios descendentes (por ejemplo, llamadas RPC de Dubbo, llamadas a API HTTP)
Analice y mida el rendimiento de cada llamada externa para establecer una línea base. Por lo general, la acumulación comienza cuando una dependencia descendente se vuelve más lenta o alcanza su límite de capacidad.
Ejemplo. Un consumidor escribe cada mensaje en una base de datos en 1 ms bajo carga normal. Durante un pico de tráfico, la base de datos alcanza su límite de capacidad y la latencia de escritura aumenta a 100 ms por mensaje, lo que reduce la tasa de consumo 100 veces. Aumentar la cantidad de hilos del cliente no resuelve el problema. La solución consiste en escalar la base de datos.
Concurrencia del consumo
La concurrencia determina cuántos mensajes procesa el cliente en paralelo:
|
Tipo de mensaje |
Concurrencia efectiva |
|
Mensajes normales |
Hilos por nodo x Cantidad de nodos |
|
Mensajes programados y diferidos |
Hilos por nodo x Cantidad de nodos |
|
Mensajes transaccionales |
Hilos por nodo x Cantidad de nodos |
|
Mensajes ordenados |
min(Hilos por nodo x Cantidad de nodos, Cantidad de particiones) |
La concurrencia de los mensajes ordenados tiene como límite la cantidad de particiones del topic. Para evaluar la cantidad de particiones, comuníquese con el servicio de atención al cliente de Alibaba Cloud.
Prioridad de ajuste: primero escale los hilos en un solo nodo. Agregue más nodos únicamente después de utilizar por completo los recursos de hardware del nodo.
Calcule la cantidad óptima de hilos
Para un nodo con C vCPU, donde cada mensaje requiere T1 de tiempo de CPU y T2 de tiempo de espera de E/S:
|
Métrica |
Fórmula |
|
TPS de un solo hilo |
1 / (T1 + T2) |
|
Cantidad óptima de hilos (uso de CPU al 100 %) |
C x (T1 + T2) / T1 |
|
Throughput máximo del nodo |
Cantidad óptima de hilos / (T1 + T2) |
Ejemplo. En un nodo de 4 vCPU donde T1 = 5 ms y T2 = 45 ms:
Cantidad óptima de hilos = 4 x (5 + 45) / 5 = 40 hilos
Throughput máximo = 40 / (5 + 45) = 800 TPS
Esta fórmula asume condiciones ideales: sin sobrecarga por cambio de contexto de hilos, operaciones de E/S que no consumen CPU y memoria suficiente. En producción, aumente los hilos de forma gradual y supervise el uso de CPU, la memoria y el throughput antes de definir un valor definitivo.
Prevención de la acumulación
Mida el rendimiento del consumo y planifique la capacidad antes del despliegue. Contar con una línea base bien definida facilita la detección de anomalías en producción.
Mida la duración del consumo
Determine la duración base del consumo mediante pruebas de estrés y análisis de código. Preste atención a lo siguiente:
Elimine problemas en el código. Compruebe que no exista complejidad computacional excesiva, bucles infinitos ni recursividad profunda en la lógica de consumo.
Minimice las operaciones de E/S externas. Evalúe si cada llamada externa (consulta a la base de datos, búsqueda en caché, API descendente) es estrictamente necesaria. Utilice caché local siempre que sea posible para eliminar llamadas redundantes.
Descargue las operaciones pesadas. Traslade las operaciones complejas y prolongadas a un procesamiento asíncrono. Asegúrese de que el diseño asíncrono no genere condiciones de carrera; por ejemplo, marcar el consumo como completado antes de que finalice la operación asíncrona.
Establezca la concurrencia del consumo
Determine la cantidad óptima de hilos. Aumente gradualmente los hilos en un solo nodo mientras supervisa la CPU, la memoria y el throughput. Identifique el punto de rendimientos decrecientes.
-
Calcule la cantidad de nodos necesarios. Considere el throughput de un solo nodo y el tráfico máximo ascendente:
Number of nodes = Peak traffic / Single-node throughput
Manejo de la acumulación cuando ocurre
Paso 1: configure alertas
Configure alertas de acumulación de mensajes mediante la función de monitoreo y alertas de ApsaraMQ for RocketMQ. Para obtener más información, consulte Configure message accumulation alerts.
Paso 2: diagnostique y resuelva
Cuando se active una alerta, determine si la causa principal es la duración o la concurrencia del consumo:
|
Diagnóstico |
Comprobación |
Acción |
|
Aumento repentino en la duración del consumo |
Consulte la métrica de duración del consumo. Revise la latencia de la base de datos, las tasas de aciertos de la caché y el estado de los servicios descendentes. |
Corrija el cuello de botella de la dependencia descendente. Consulte Query the consumption duration. |
|
Concurrencia de consumo insuficiente |
El uso de CPU es bajo y los hilos no están saturados. |
Aumente los hilos por nodo o agregue más nodos. |
Para consultar la guía completa de resolución, revise Handle accumulated messages.