Puede sincronizar los datos de una base de datos PostgreSQL autogestionada hacia una instancia de AnalyticDB for PostgreSQL. Esto le permite centralizar la información del negocio para su análisis.
Requisitos previos
Cada tabla de origen que se sincronice debe tener una clave primaria.
Debe contar con una instancia de destino de AnalyticDB for PostgreSQL creada. Para obtener más información, consulte Create an instance.
Notas de uso
Para sincronizar datos de varias bases de datos, cree una tarea de sincronización independiente por cada una.
-
Si crea una tabla nueva en la base de datos de origen durante la sincronización y desea incluirla, ejecute el siguiente comando en dicha tabla para mantener la consistencia de los datos:
ALTER TABLE schema.table REPLICA IDENTITY FULL; -
Para garantizar que la tarea se ejecute correctamente, el cambio entre nodo principal y secundario solo es compatible con instancias de ApsaraDB RDS for PostgreSQL 11. Además, establezca el parámetro
rds_failover_slot_modeensync. Para obtener más información, consulte Logical Replication Slot Failover.AvisoSi ejecuta un cambio entre nodo principal y secundario en una base de datos PostgreSQL autogestionada o en una instancia de ApsaraDB RDS for PostgreSQL de otra versión, la tarea de sincronización de datos fallará.
Si existen transacciones de larga duración en la base de datos de origen y la tarea incluye sincronización incremental, los registros de escritura anticipada (WAL) generados antes de confirmar esas transacciones pueden acumularse y llenar el espacio en disco de la base de datos de origen.
Facturación
|
Tipo de sincronización |
Precio |
|
Sincronización de esquemas y sincronización completa de datos |
Sin costo. |
|
Sincronización incremental de datos |
Con costo. Para obtener más información, consulte Billing overview. |
Limitaciones
La sincronización de esquemas no es compatible. DTS no sincroniza las definiciones de objetos, como los esquemas de tablas, desde la base de datos de origen hacia la de destino.
Solo se pueden sincronizar tablas de datos. Las tablas optimizadas para anexión (AO) no son compatibles como tablas de destino.
No se pueden sincronizar datos de los siguientes tipos: BIT, VARBIT, GEOMETRY, UUID, TSQUERY, TSVECTOR y TXID_SNAPSHOT.
Si ejecuta una sentencia DDL sobre un objeto sincronizado en la base de datos de origen, ejecute manualmente la misma sentencia en la base de datos de destino y luego reinicie la tarea.
Operaciones SQL compatibles
INSERT, UPDATE y DELETE.
Antes de empezar
Cree bases de datos, esquemas y tablas en la instancia de destino de AnalyticDB for PostgreSQL que coincidan con los objetos de origen a sincronizar. Para obtener más información, consulte SQL syntax.
Procedimiento
-
Adquiera una instancia de sincronización de datos. Para obtener más información, consulte Purchase a DTS instance.
NotaAl adquirir la instancia, establezca Source Database en PostgreSQL, Destination Database en AnalyticDB for PostgreSQL y Synchronization Topology en One-way Synchronization.
-
Inicie sesión en la consola de Data Transmission Service.
NotaSi el sistema lo redirige automáticamente a la consola de Data Management (DMS), haga clic en el icono
 en la esquina inferior derecha y luego haga clic en
 para volver a la consola clásica de DTS.
En el panel de navegación izquierdo, haga clic en Data Synchronization.
En la parte superior de la página Data Synchronization, seleccione la región de su instancia de sincronización.
Busque la instancia de sincronización de datos adquirida y haga clic en Configure Synchronization Channel.
-
Configure las instancias de origen y de destino.
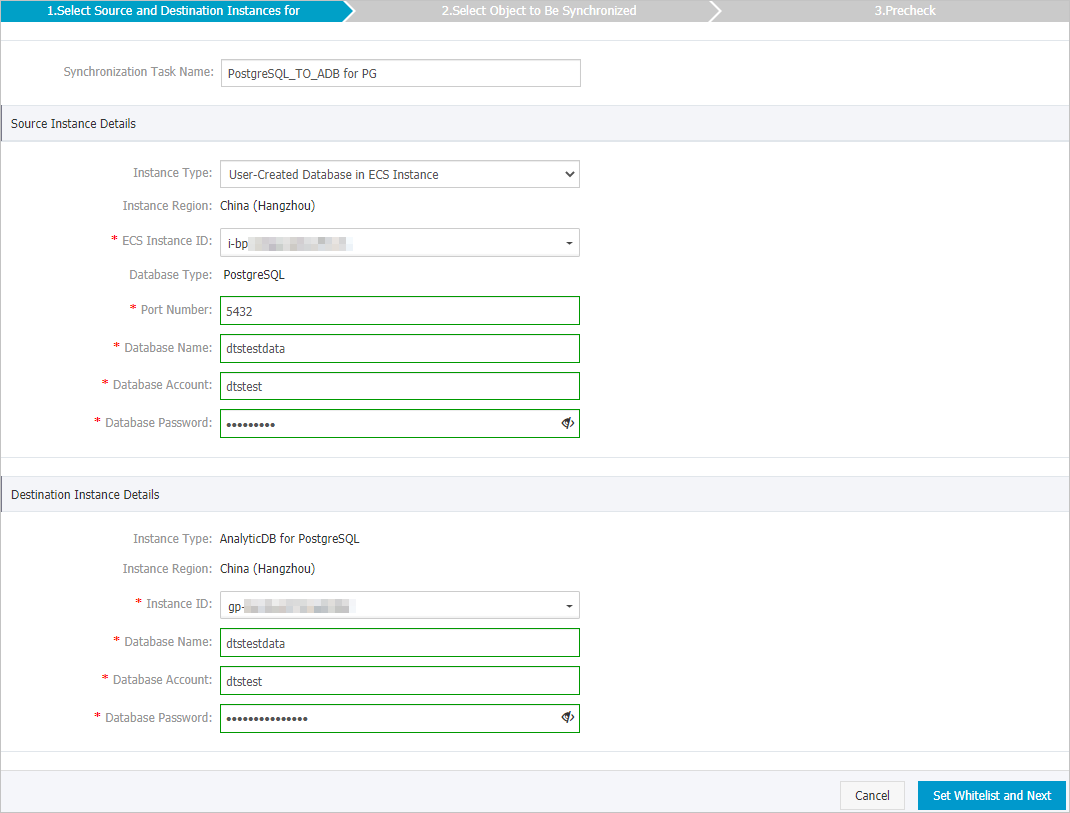
Sección
Parámetro
Descripción
N/A
Synchronization task name
DTS genera automáticamente un nombre para la tarea. Especifique un nombre descriptivo si lo prefiere. No es obligatorio que sea único.
Source instance details
Instance type
Este ejemplo utiliza self-managed database on ECS.
NotaOtros tipos de instancia requieren preparaciones adicionales. Preparation overview.
A continuación se utilizan los pasos correspondientes a self-managed database on ECS.
Instance region
La región que seleccionó al adquirir la instancia de sincronización. Este valor no se puede modificar.
ECS instance ID
Seleccione el identificador de la instancia de ECS que aloja su base de datos PostgreSQL autogestionada.
Database type
Este parámetro tiene el valor fijo PostgreSQL.
Port
El puerto de servicio de la base de datos PostgreSQL autogestionada.
Database name
El nombre de la base de datos que contiene las tablas a sincronizar.
Database account
La cuenta de la base de datos PostgreSQL autogestionada.
NotaLa cuenta de la base de datos debe tener permisos de propiedad sobre el esquema.
Database password
La contraseña de la cuenta de la base de datos.
Destination instance details
Instance type
Tiene el valor fijo AnalyticDB for PostgreSQL. No requiere configuración.
Instance region
La región que seleccionó al adquirir la instancia de sincronización de datos. Este valor no se puede modificar.
Instance ID
Seleccione el identificador de la instancia de destino de AnalyticDB for PostgreSQL.
Database name
El nombre de la base de datos de destino.
Database account
La cuenta inicial de la instancia de AnalyticDB for PostgreSQL. Para obtener más información, consulte Create and manage users.
NotaTambién puede utilizar una cuenta con permisos RDS_SUPERUSER. Manage user permissions.
Database password
La contraseña de la cuenta de la base de datos.
-
En la esquina inferior derecha de la página, haga clic en Set Whitelist and Next.
Si la base de datos de origen o de destino es una instancia de Alibaba Cloud, como una de ApsaraDB RDS for MySQL o de ApsaraDB for MongoDB, DTS agrega automáticamente los bloques CIDR de sus servidores a la lista de permitidos de direcciones IP de la instancia. Si se trata de una base de datos autogestionada alojada en una instancia de Elastic Compute Service (ECS), DTS agrega automáticamente dichos bloques CIDR a las reglas del security group de la instancia de ECS. En este caso, asegúrese de que la instancia de ECS pueda acceder a la base de datos. Cuando la base de datos autogestionada está distribuida en varias instancias de ECS, agregue manualmente los bloques CIDR de los servidores de DTS a las reglas del security group de cada instancia. Por otro lado, si la base de datos de origen o de destino está autogestionada en un centro de datos o la proporciona un proveedor de nube externo, agregue manualmente los bloques CIDR de los servidores de DTS a la lista de permitidos de direcciones IP de la base de datos para permitir el acceso de DTS. Para obtener más información, consulte Whitelist DTS server IP addresses.
AvisoAgregar los bloques CIDR de direcciones IP públicas de los servidores de DTS, ya sea de forma automática o manual, puede representar riesgos de seguridad. Al usar este producto, usted reconoce y acepta estos riesgos potenciales. Implemente medidas básicas de protección de seguridad, tales como fortalecer la seguridad de las contraseñas, restringir los puertos abiertos para los bloques CIDR, utilizar autenticación en la comunicación interna mediante API y revisar periódicamente los bloques CIDR innecesarios para eliminarlos. Como alternativa, conéctese a la base de datos a través de una red interna, como una línea dedicada, VPN Gateway o Smart Access Gateway.
-
Establezca la directiva de sincronización y seleccione los objetos a sincronizar.
Sección
Parámetro
Descripción
Synchronization Policy
Initialize Synchronization
De manera predeterminada, se selecciona Initial Full Data Synchronization. Después de la comprobación previa, DTS sincroniza los datos existentes desde el origen hacia la instancia de destino. Estos datos sirven como línea base para la sincronización incremental posterior.
Processing Mode for Existing Tables
-
Clear Data
Omite la comprobación "Destination table is empty" durante la fase de comprobación previa. Elimina los datos de las tablas de destino antes de la sincronización completa. Esta opción es adecuada para la sincronización en producción una vez finalizadas las pruebas.
-
Ignore Errors and Proceed
Omite la comprobación "Destination table is empty" durante la fase de comprobación previa. Anexa los datos directamente durante la sincronización completa. Más indicada para escenarios donde se consolidan datos de varias tablas en una sola.
Synchronization Operation Type
Seleccione los tipos de operación a sincronizar según las necesidades de su negocio:
NotaAlterTable no es compatible.
-
Insert
-
Update
-
Delete
-
AlterTable
Select Objects to Synchronize
N/A
En el cuadro Source Objects, seleccione las tablas a sincronizar y haga clic en el icono
 para moverlas al cuadro Selected Objects.Nota
-
Solo puede seleccionar objetos a nivel de tabla.
-
Si necesita que los nombres de columna en la tabla de destino difieran de los de origen, utilice la función de asignación de columnas de DTS. Para obtener más información, consulte Set object names in the destination instance.
Map Object Names
N/A
Modifique los nombres de los objetos sincronizados en la instancia de destino. Para obtener más información, consulte Map databases, tables, and columns.
ImportanteSi utiliza la asignación de columnas sin sincronizar la tabla completa, o si los esquemas de origen y destino no coinciden, se perderán los datos de las columnas que existan únicamente en la tabla de origen.
Connection Retry Duration
N/A
Si DTS no logra conectarse a la instancia de origen o de destino, reintenta la conexión durante 720 minutos (12 horas) de manera predeterminada. También puede especificar una duración de reintento personalizada. Si DTS restablece la conexión dentro del tiempo indicado, la tarea de sincronización se reanuda automáticamente. De lo contrario, la tarea falla.
NotaEl tiempo de ejecución de la tarea durante los reintentos de conexión genera cargos de facturación. Personalice la duración de reintento según las necesidades de su negocio o libere la instancia de DTS tan pronto como libere las instancias de origen y de destino.
-
-
Una vez completadas las configuraciones anteriores, haga clic en Precheck and Start en la esquina inferior derecha de la página.
NotaAntes de iniciar formalmente la tarea de sincronización, se ejecuta una comprobación previa. La tarea solo comienza cuando esta comprobación se aprueba.
-
Si la comprobación previa falla, haga clic en el icono
 junto al elemento específico para consultar los detalles del error.
Siga las indicaciones para corregir el problema y vuelva a ejecutar la comprobación previa.
Si no necesita corregir los elementos con advertencias, también puede seleccionar Ignore y Ignore Warning Items and Rerun Precheck para omitir dichas advertencias y ejecutar la comprobación previa nuevamente.
Cuando aparezca Precheck Passed en el cuadro de diálogo Precheck, cierre el cuadro de diálogo. La tarea de sincronización comenzará automáticamente.
-
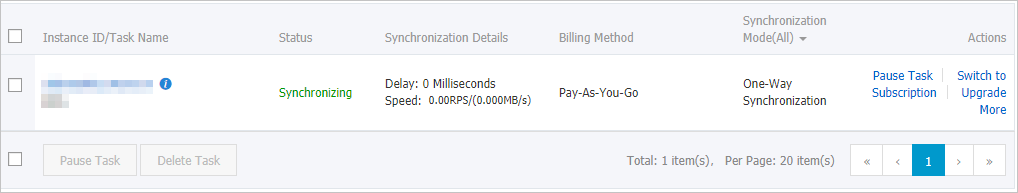
Espere a que el canal de sincronización se inicialice y la tarea pase al estado Synchronizing.
La página
Data Synchronization
muestra el estado de los trabajos de sincronización de datos.