Despliegue Dify en ACK para crear un asistente de preguntas y respuestas de IA escalable respaldado por la base de conocimiento de su empresa.
Descripción general de la solución
|
Ejemplo de aplicación de IA personalizada en Dify
|
Ejemplo de aplicación de IA integrada en la web
|
Configure un asistente de preguntas y respuestas de IA dedicado en tres pasos:
Instale el componente ack-dify: Cree un clúster de ACK e instale el componente ack-dify.
Agregue un asistente de preguntas y respuestas de IA: Acceda al servicio Dify para agregar un asistente de preguntas y respuestas de IA a su sitio web.
Personalice el asistente de preguntas y respuestas de IA: Agregue una base de conocimiento dedicada para mejorar la precisión en preguntas específicas del dominio.
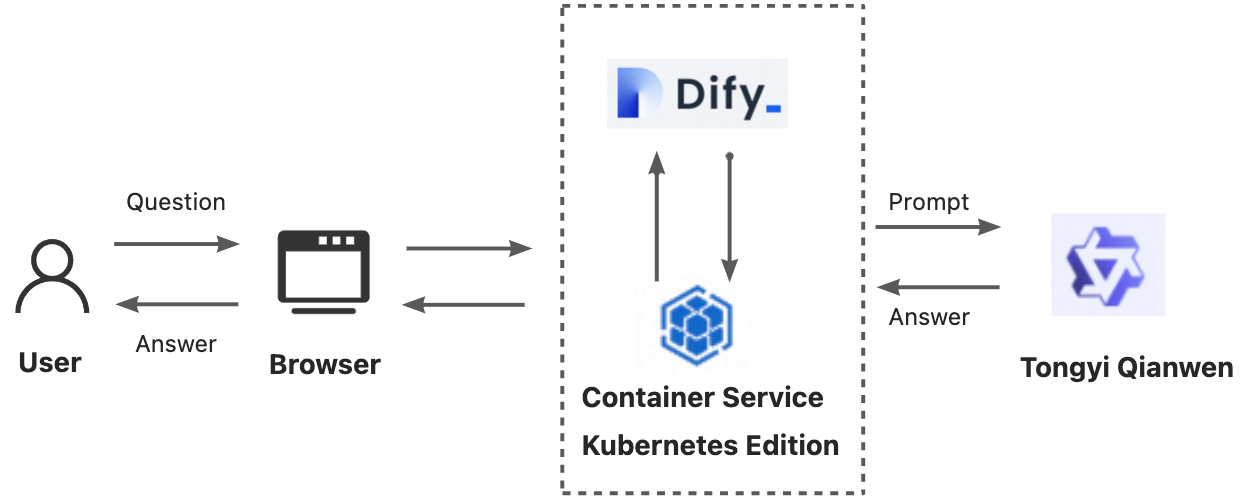
Interacción entre el servicio Dify y el clúster de ACK:

Introducción a Dify
Dify es una plataforma de código abierto para desarrollar aplicaciones de modelos de lenguaje grandes (LLM). Combina Backend-as-a-Service (BaaS) y LLMOps. Permite que tanto desarrolladores como usuarios sin perfil técnico construyan aplicaciones de IA generativa listas para producción, sin necesidad de reinventar los componentes principales.
Componentes clave de la arquitectura de Dify:
Componentes tecnológicos principales: Dify integra los elementos esenciales para crear aplicaciones LLM. Entre ellos destacan la compatibilidad con numerosos modelos, una interfaz intuitiva para diseñar prompts, un sistema de generación aumentada por recuperación (RAG) de alto rendimiento y una arquitectura de agente personalizable.
Orquestación visual y operaciones: La interfaz intuitiva de Dify permite orquestar prompts de forma visual, simplificar los flujos de trabajo operativos y gestionar conjuntos de datos de manera eficiente. Esto acelera significativamente el desarrollo de aplicaciones de IA. Los desarrolladores pueden desplegar rápidamente o integrar LLM en sistemas existentes, además de optimizar las operaciones de forma continua.
Plantillas de aplicación y framework de orquestación: Dify ofrece plantillas de aplicación listas para usar y un framework de orquestación. Gracias a esto, los desarrolladores crean aplicaciones de IA generativa basadas en modelos de lenguaje grandes con rapidez. La plataforma también admite escalamiento instantáneo y fluido para adaptarse a los cambios del negocio e impulsar su crecimiento.
En conjunto, estos componentes conforman una plataforma integral para desarrollar y desplegar aplicaciones de IA generativa con rapidez.
1. Instale el componente ack-dify
Despliegue con un clic
Si apenas comienza a trabajar con clústeres de ACK y no conoce el proceso de creación, haga clic en despliegue con un clic para crear el entorno de ejecución de Dify. Esta opción despliega una aplicación Dify de una sola instancia mediante la plantilla Helm ack-dify del ACK App Marketplace. Es ideal para entornos de desarrollo y pruebas.
Antes de usar el despliegue con un clic, asegúrese de que ACK esté activado y autorizado. Para obtener más información, consulte Create an ACK managed cluster.
Esta solución utiliza a continuación recursos en la nube. Para obtener información sobre la facturación, consulte Billing.
|
Recursos en la nube |
Descripción |
|
1 Virtual Private Cloud (VPC) |
Proporciona una red privada para recursos en la nube, como instancias de Elastic Compute Service (ECS) y clústeres de ACK. |
|
2 vSwitches |
Conecta recursos como instancias de ECS y clústeres de ACK para permitir la comunicación y el aislamiento de red. |
|
1 security group |
Define las reglas de red de entrada y salida para las instancias de ECS dentro de la VPC. |
|
1 instancia de Classic Load Balancer (CLB) |
Proporciona acceso a internet para la plataforma Dify. |
|
1 sistema de archivos NAS |
Almacena los datos de los servicios internos de Dify (api y worker). |
|
1 clúster administrado de ACK |
Despliega Dify. Seleccione como mínimo un nodo con 8 vCPU y 16 GiB de memoria (por ejemplo, ecs.u1-c1m2.2xlarge) para evitar la falta de recursos. |
Procedimiento
Haga clic en despliegue con un clic. En ROS, seleccione su región, por ejemplo, China (Hangzhou). Siga la plantilla de ROS para configurar los identificadores de zona de los vSwitch, el tipo de instancia del node pool, la contraseña, la confirmación de seguridad y otros parámetros. Mantenga los valores predeterminados para el resto y luego haga clic en Next: Check and Confirm.
La creación del clúster tarda aproximadamente 10 minutos. Una vez creado, inicie sesión en la consola de Container Service for Kubernetes. En el panel de navegación izquierdo, elija Clusters. Haga clic en el clúster de destino. Elija Workloads > Pods, establezca el namespace en dify-system y compruebe que el componente ack-dify esté instalado en el clúster.
(Opcional) Si un pod se encuentra en estado Pending, es posible que al clúster le falte la dependencia PVC para ack-dify. Cree un sistema de archivos CNFS y un StorageClass de NAS para el clúster. Para obtener más información, consulte Manage NAS file systems by using CNFS. Para conocer cómo solucionar excepciones en pods, consulte Troubleshoot pod exceptions.
Una vez instalado el componente ack-dify, continúe con el siguiente paso.
Si ya utilizó el despliegue con un clic de ROS para instalar el componente ack-dify, el acceso público ya está habilitado para el servicio ack-dify. Puede omitir los pasos descritos en Access the Dify service.
Despliegue manual
Si ya conoce el proceso de creación de clústeres de ACK, siga estos pasos para crear un clúster adaptado a sus necesidades.
1.1 Requisitos previos
-
Se creó un clúster ACK Pro, versión 1.22 o posterior. Para obtener más información, consulte Create an ACK managed cluster y Upgrade a cluster.
Reserve como mínimo 2 vCPU y 4 GB de memoria. Asegúrese de que el plugin de almacenamiento CSI y el sistema de archivos CNFS estén configurados.
kubectl está conectado al clúster. Consulte Connect to an ACK cluster by using kubectl.
1.2 Despliegue el componente
Despliegue el componente ack-dify en su clúster para el servicio Dify.
-
Inicie sesión en la consola de Container Service for Kubernetes. En el panel de navegación izquierdo, elija Clusters. Haga clic en el clúster de destino. Siga los pasos a continuación para instalar el componente ack-dify.
No es necesario configurar el Application Name ni el Namespace del componente. Haga clic en Next. En el cuadro de diálogo Confirm que aparece, haga clic en Yes para aceptar los valores predeterminados (ack-dify / dify-system). Luego, seleccione la Chart Version más reciente y haga clic en OK para instalar el componente ack-dify.
-
Espere aproximadamente un minuto y compruebe que todos los pods del namespace
dify-systemse encuentren en estadoRunning.kubectl get pod -n dify-systemSi algún pod se encuentra en estado Pending, es posible que al clúster le falte la dependencia PVC para ack-dify. Cree un sistema de archivos CNFS y un StorageClass de NAS. Para obtener más información, consulte Manage NAS file systems by using CNFS. Para conocer cómo solucionar excepciones en pods, consulte Troubleshoot pod exceptions.
2. Agregue un asistente de preguntas y respuestas de IA
2.1 Acceda al servicio Dify
-
Habilite el acceso público para el servicio ack-dify.
NotaEl acceso público tiene fines de demostración. Para garantizar la seguridad de los datos en un entorno de producción, habilite la función Access Control.
En la consola de ACK, elija Network > Services en el panel de navegación izquierdo. En el selector de namespace de la parte superior, seleccione dify-system, busque el Service ack-dify y haga clic en Update. En el cuadro de diálogo Update Service que aparece, configure a continuación los parámetros:
Tipo de servicio: seleccione Load Balancer (LoadBalancer).
Tipo de load balancer: Classic Load Balancer (CLB).
Selección de recursos: New Resource.
Método de acceso: seleccione public network access.
Método de facturación: pay-as-you-go billing method (PayByCLCU).
TrafficPolicy: Local.
Asignación de puertos: Nombre http-dify, puerto de servicio 80, puerto del contenedor dify, protocolo TCP.
Una vez completada la configuración, haga clic en OK.
Después de configurar los parámetros, elija Network > Services > ack-dify y establezca el namespace en dify-system. Verá la External IP del servicio ack-dify. Abra esta dirección IP en su navegador para acceder a Dify.
-
Registre una cuenta.
Acceda a la External IP y siga las indicaciones para crear una cuenta de administrador (correo electrónico, nombre de usuario y contraseña).
2.2 Cree un asistente de preguntas y respuestas de IA
Introduzca la External IP en su navegador e inicie sesión en la plataforma Dify.
-
Agregue un modelo de IA (Qwen en este ejemplo) y establezca la clave de API desde Alibaba Cloud Model Studio.
Una vez que agote la cuota gratuita de Qwen, los cargos se basarán en el uso de tokens. Esto reduce los costos iniciales en comparación con alojar un modelo por su cuenta.
Obtenga la clave de API: Elija Username > Settings > Model Provider > Instale y configure el plugin Qwen > Get API Key From Alibaba Cloud.
Introduzca la clave de API y luego haga clic en Save.
-
Cree un asistente de preguntas y respuestas de IA de propósito general.
Elija Studio > Create from Blank e introduzca un Name y una Description para el asistente. Mantenga los demás parámetros con sus valores predeterminados.
2.3 Compruebe el asistente de preguntas y respuestas de IA
Pruebe el asistente haciéndole preguntas. El chatbot de propósito general maneja conversaciones sencillas, pero aún no puede responder preguntas específicas sobre Dify.
3. Personalice el asistente de IA
3.1 Cree una base de conocimiento
Para responder con precisión preguntas técnicas relacionadas con Dify, configure una base de conocimiento dedicada para el asistente.
Este ejemplo proporciona un archivo de corpus dify_doc.md. Cree y cargue la base de conocimiento de la siguiente manera.
-
Cargue el archivo de corpus preparado dify_doc.md en la base de conocimiento.
Elija Knowledge > Create Knowledge > Import from file > Select File > Next.
-
Haga clic en Next. Realice la segmentación y limpieza de texto, y luego guarde los cambios.
Mantenga los valores predeterminados. La base de conocimiento limpia, segmenta e indexa automáticamente el documento para su recuperación.
Para conocer cómo se organizaron los archivos de corpus anteriores en un solo archivo .md, expanda la sección colapsable a continuación y consulte los detalles.
3.2 Orqueste y publique el asistente
Configure un prompt y agregue la base de conocimiento al contexto del asistente.
-
Configure el prompt: Copie a continuación el contenido en el campo Instructions. Los prompts mejoran la precisión de las respuestas mediante instrucciones y restricciones.
You will act as Dify's AI assistant, dedicated to answering customers' questions about Dify products and their features. Your responses should be based on the existing knowledge base to ensure accuracy. If a question is beyond your knowledge, please honestly inform them that you do not know the answer, in order to maintain the integrity of the information. Please communicate in a friendly and warm tone, and feel free to use emoticons appropriately to enhance the interactive experience. Agregue la base de conocimiento al contexto: Haga clic en Add en el área Context para agregar la base de conocimiento. Esto permite obtener respuestas precisas y profesionales.
Haga clic en Releases > Update para guardar y aplicar la configuración.
3.3 Compruebe los resultados
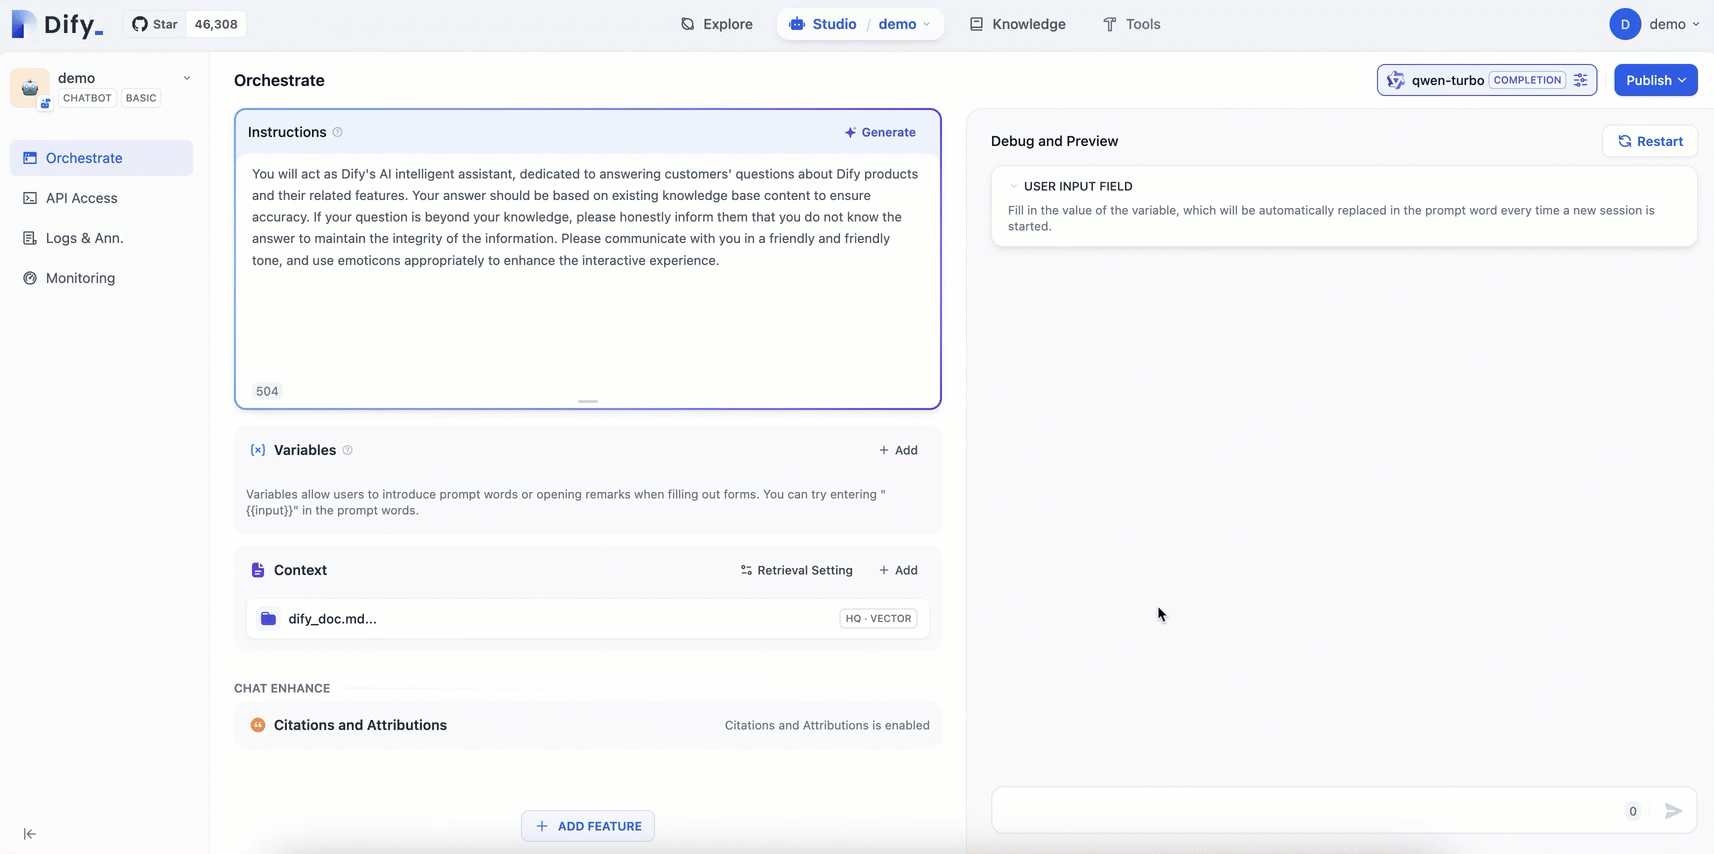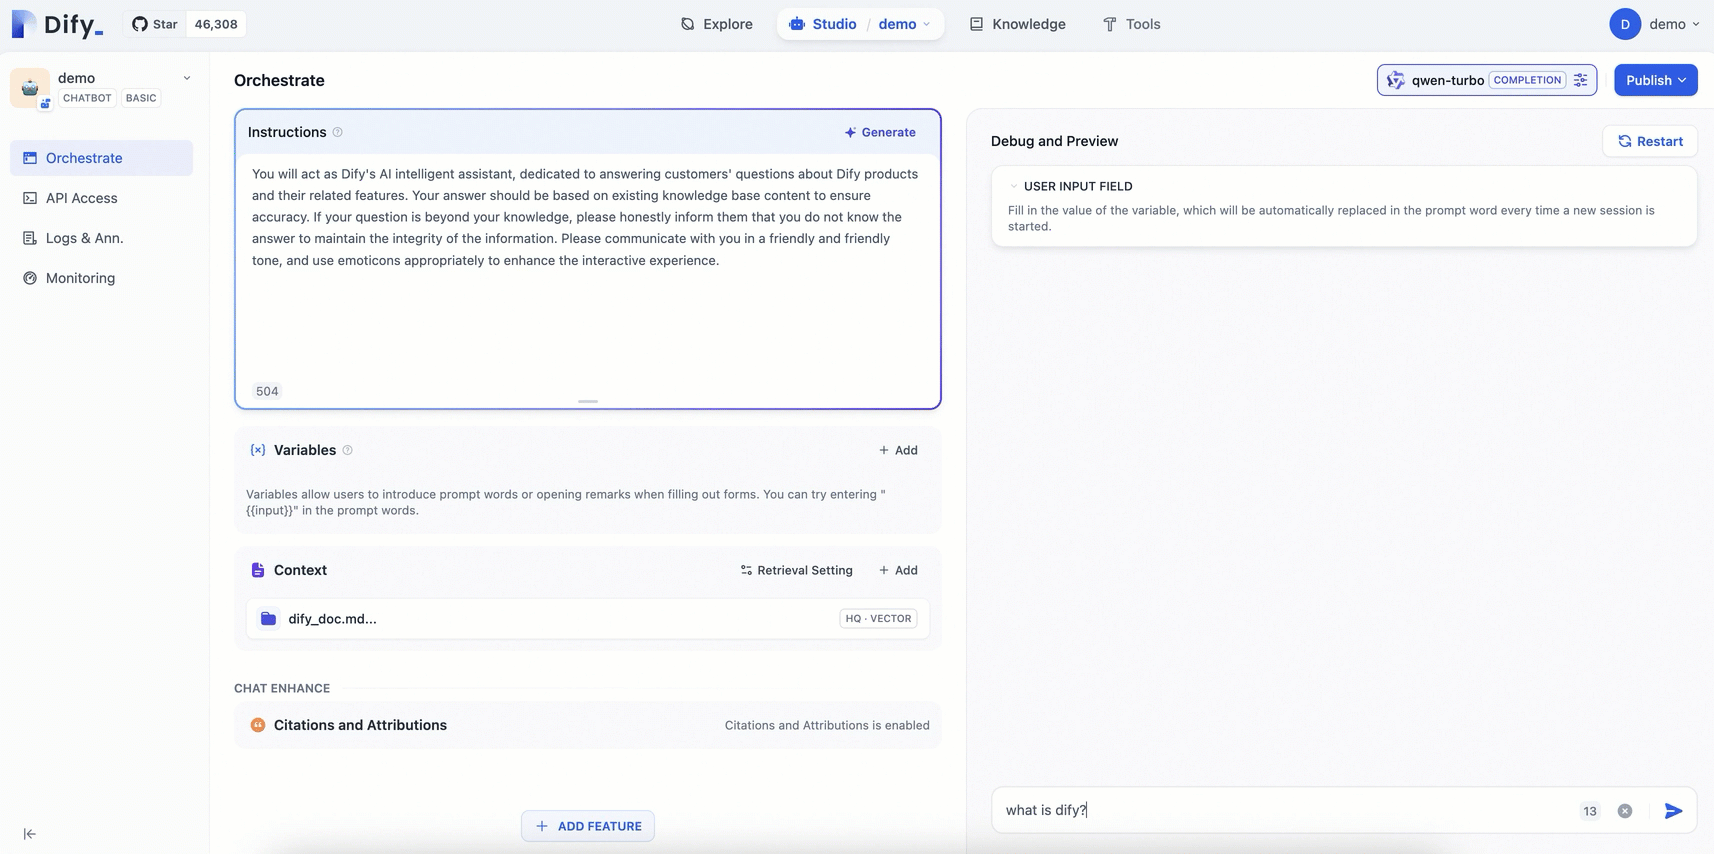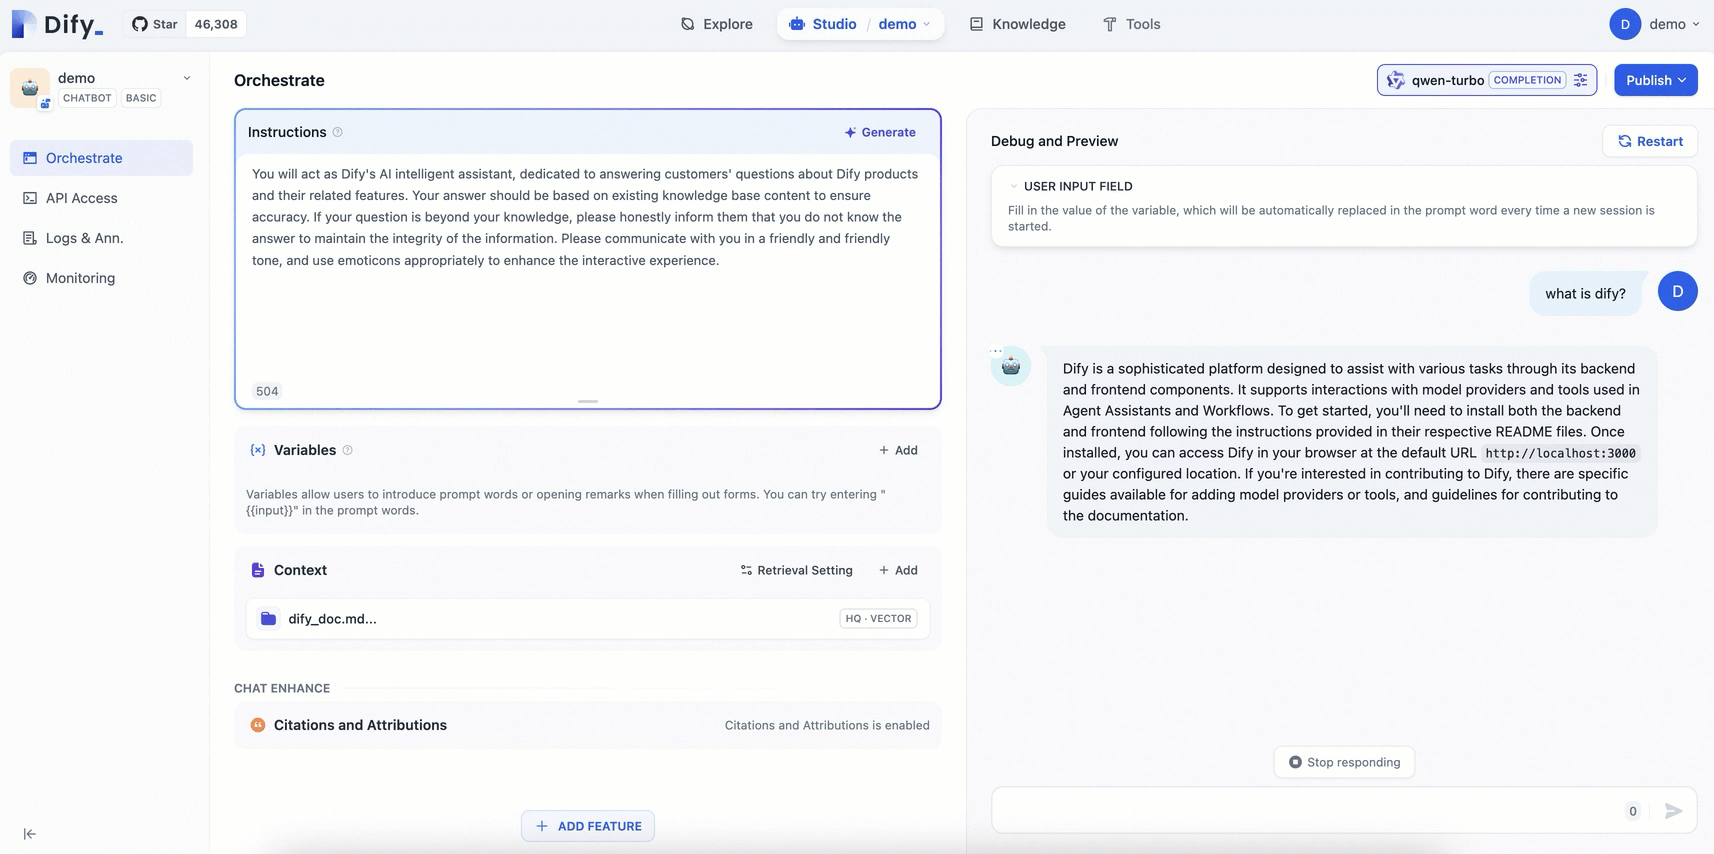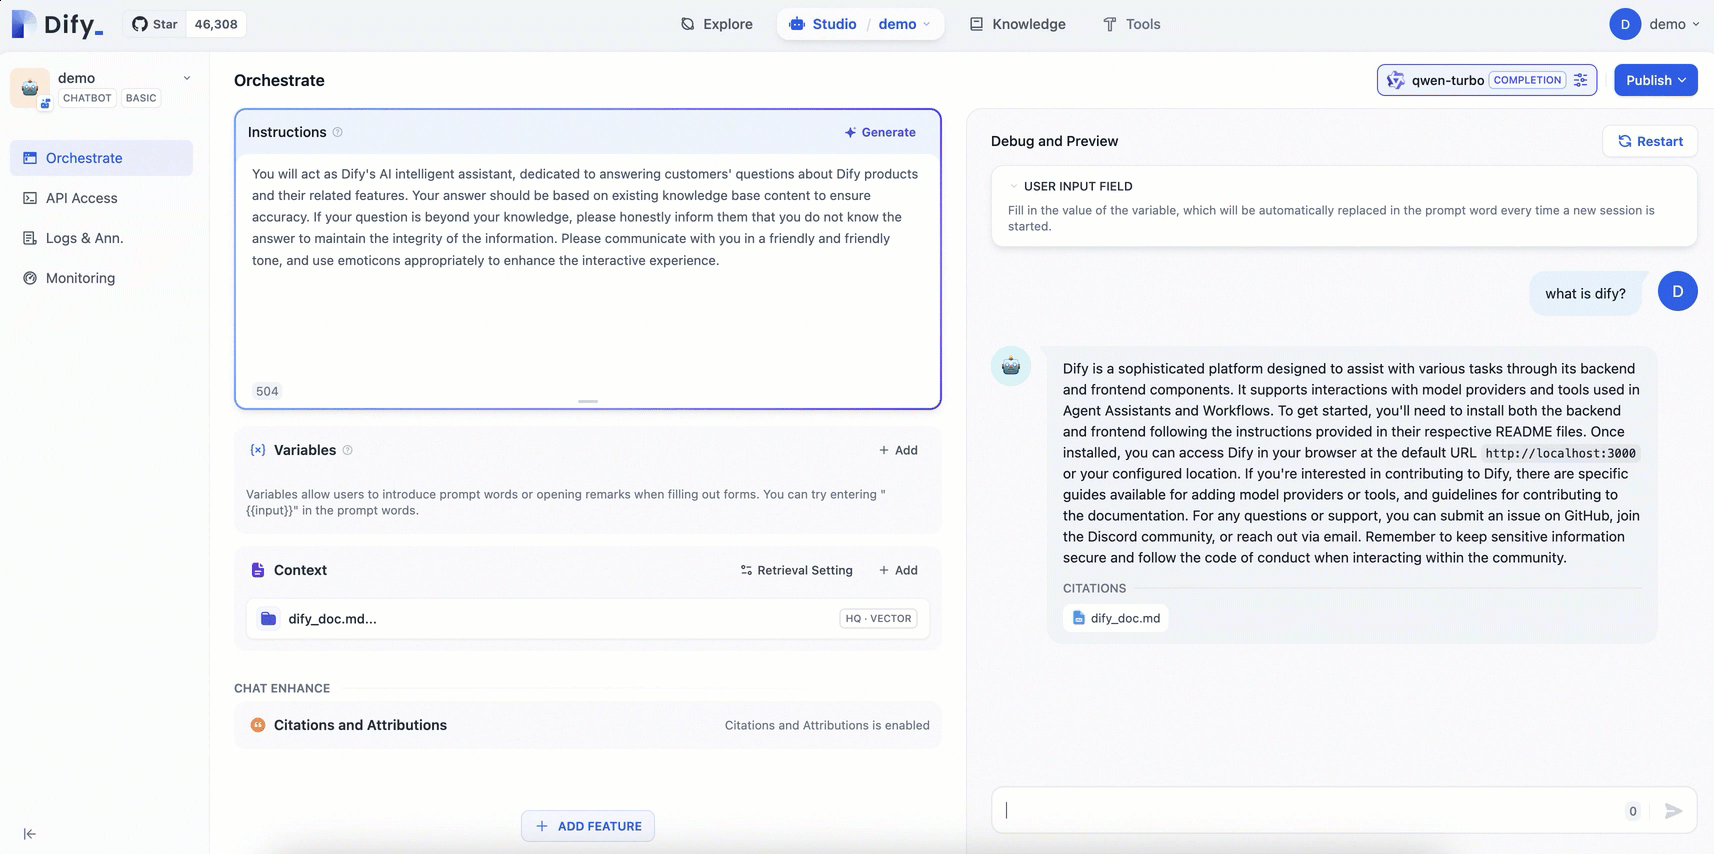
Con una base de conocimiento dedicada, el asistente de IA proporciona respuestas más precisas y específicas del dominio que el chatbot de propósito general.
Antes de configurar la base de conocimiento, la respuesta a la pregunta "¿Qué es Dify?" es genérica e imprecisa: la IA enumera varias suposiciones sin relación sobre el significado de DIFY. Después de configurar la base de conocimiento, el modelo qwen-turbo ofrece una respuesta precisa que describe las funciones principales de la plataforma Dify. Por ejemplo, menciona la definición declarativa de aplicaciones de IA y la descripción de prompts y contexto mediante un archivo YAML. La respuesta cita el documento de la base de conocimiento dify_doc.md en el área Citations de la parte inferior.
Resumen
Funciones principales de Dify:
|
Función |
Descripción |
|
LLMOps integral |
Monitoreo en tiempo real de los registros y las métricas de la aplicación, con optimización continua de prompts, conjuntos de datos y modelos a partir de los datos de producción. |
|
Motor RAG |
Flujo de trabajo RAG de extremo a extremo, desde la ingesta de documentos hasta la recuperación. Procesa directamente formatos comunes como PDF y PPT. |
|
Agente |
Defina agentes mediante llamadas a funciones del LLM o el paradigma ReAct. Incluye más de 50 herramientas integradas y es compatible con herramientas personalizadas. |
|
Orquestación de flujos de trabajo |
Lienzo visual para construir flujos de trabajo de IA al arrastrar y conectar componentes, con una cantidad mínima de código. |
|
observability |
Seguimiento y evaluación de la calidad y el costo de las aplicaciones LLM mediante un panel de monitoreo. |
|
Funciones empresariales (SSO/control de acceso) |
Las organizaciones reducen el riesgo de fugas de información y daños a los datos, lo que garantiza la seguridad de la información y la continuidad del negocio. |
Puesta en producción
Existen cuatro opciones para desplegar el asistente de preguntas y respuestas de IA en producción:
-
Sitio web compartido públicamente.
La aplicación de IA que cree con Dify se publica como una aplicación web accesible en internet. Esta funciona según su prompt y la configuración de orquestación. Para obtener más información, consulte Publicar como una aplicación web pública.
-
Llamadas basadas en API.
Dify proporciona API para todas las aplicaciones bajo el concepto "Backend-as-a-Service". Esto permite a los desarrolladores aprovechar la potencia de los modelos de lenguaje grandes en sus aplicaciones de frontend sin preocuparse por arquitecturas ni despliegues complejos de backend. Para obtener más información, consulte Desarrollar con API.
-
Redesarrollo basado en componentes de frontend.
Si desarrolla un producto nuevo desde cero o se encuentra en la fase de diseño del prototipo, use Dify para publicar rápidamente un sitio de IA. Para obtener más información, consulte Redesarrollar con base en componentes de frontend.
-
Integración en su sitio web empresarial o personal.
Dify admite integrar su aplicación de IA en el sitio web de su empresa. Utilice esta capacidad para crear en minutos un servicio oficial de atención al cliente con IA, un sistema de preguntas y respuestas del negocio y otras aplicaciones con sus datos comerciales. Para obtener más información, consulte Integrar en un sitio web.
Ejemplo: integración en un sitio web
Integre su aplicación LLM en un sitio web empresarial o personal.
Este ejemplo tiene fines demostrativos. Para garantizar la seguridad de los datos en un entorno de producción, habilite también la función Access Control.
Habilite el acceso público para el servicio ack-dify y abra la IP externa en su navegador. Para obtener más información, consulte Access the Dify service.
-
Construya rápidamente una aplicación web sencilla en su clúster ACK para depurar su asistente de preguntas y respuestas de IA.
Esto despliega una aplicación web en su clúster ACK para alojar la aplicación LLM de Dify integrada.
-
Obtenga el código del servicio Dify.
Elija un método para integrar el código de la aplicación de chat en su sitio web.
-
En el clúster, cree un Deployment para ejecutar su aplicación web y un Service para exponerla.
A continuación se muestra un ejemplo sencillo en YAML que indica cómo desplegar un servidor Nginx con HTML estático.
-
Inicie sesión en la consola de Container Service for Kubernetes (ACK). En la página ConfigMaps, establezca el namespace en default y luego haga clic en Create from YAML. Copie el siguiente contenido YAML en la plantilla y modifique los parámetros
window.difyChatbotConfig,srceidsegún el código del servicio Dify que obtuvo.Consulte el siguiente ejemplo.
Compruebe el estado del despliegue. Este finaliza correctamente cuando ambos pods se encuentran en el estado
Running.-
Habilite el acceso público para el servicio desplegado.
Para garantizar la seguridad de los datos en un entorno de producción, se recomienda habilitar también la función Access Control.
En el panel de navegación izquierdo, elija Network > Services. Busque
web-servicey haga clic en Update. En el cuadro de diálogo que aparece, configure los siguientes parámetros:Tipo de servicio: Load Balancer (LoadBalancer).
Tipo de load balancer: Classic Load Balancer (CLB); seleccione New Resource.
Método de acceso: public network access.
Método de facturación: pay-as-you-go billing method (PayByCLCU).
Control de acceso: seleccione Enable de forma opcional según sus necesidades.
TrafficPolicy:
Cluster.Asignación de puertos: puerto de servicio 80, puerto de contenedor 80, protocolo TCP.
Una vez completada la configuración, haga clic en OK.
Después de configurar estos parámetros, verá la External IP del servicio web-service. Abra esta IP en su navegador.
ImportanteSi necesita que otros dispositivos accedan al servicio, asegúrese de que el firewall o el security group de su clúster permita el tráfico en el puerto 80. Para obtener más información, consulte Add a security group rule.
Asegúrese de que su código y el de terceros sean seguros para evitar posibles ataques XSS o la inserción de código malicioso. Este es un ejemplo básico con fines exclusivamente demostrativos; expándalo y modifíquelo según sus necesidades.
-
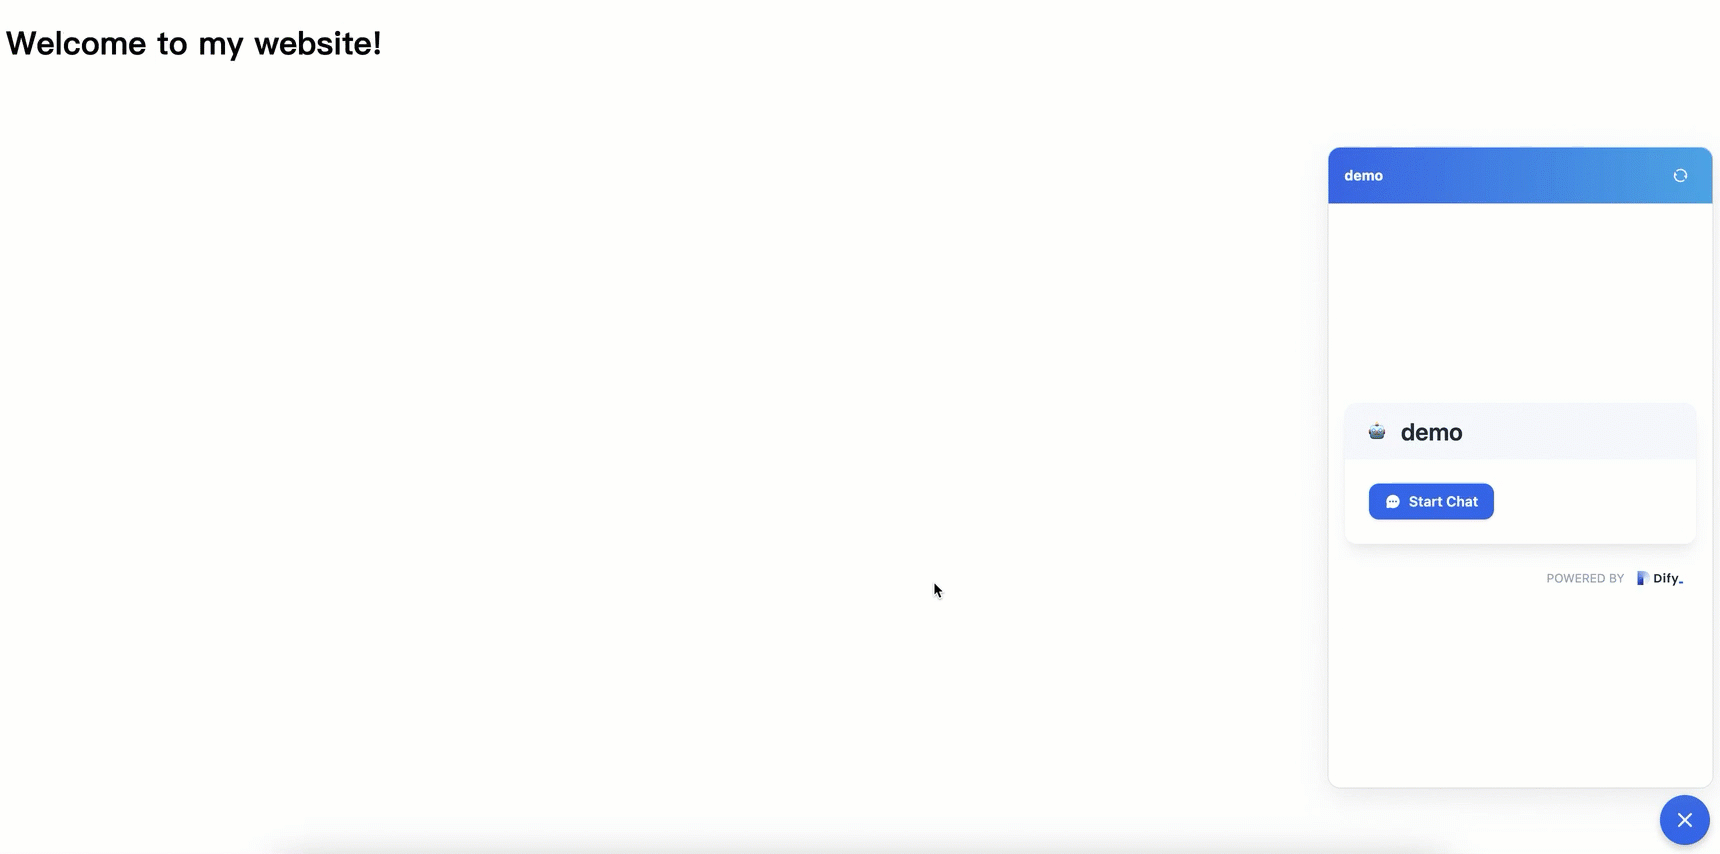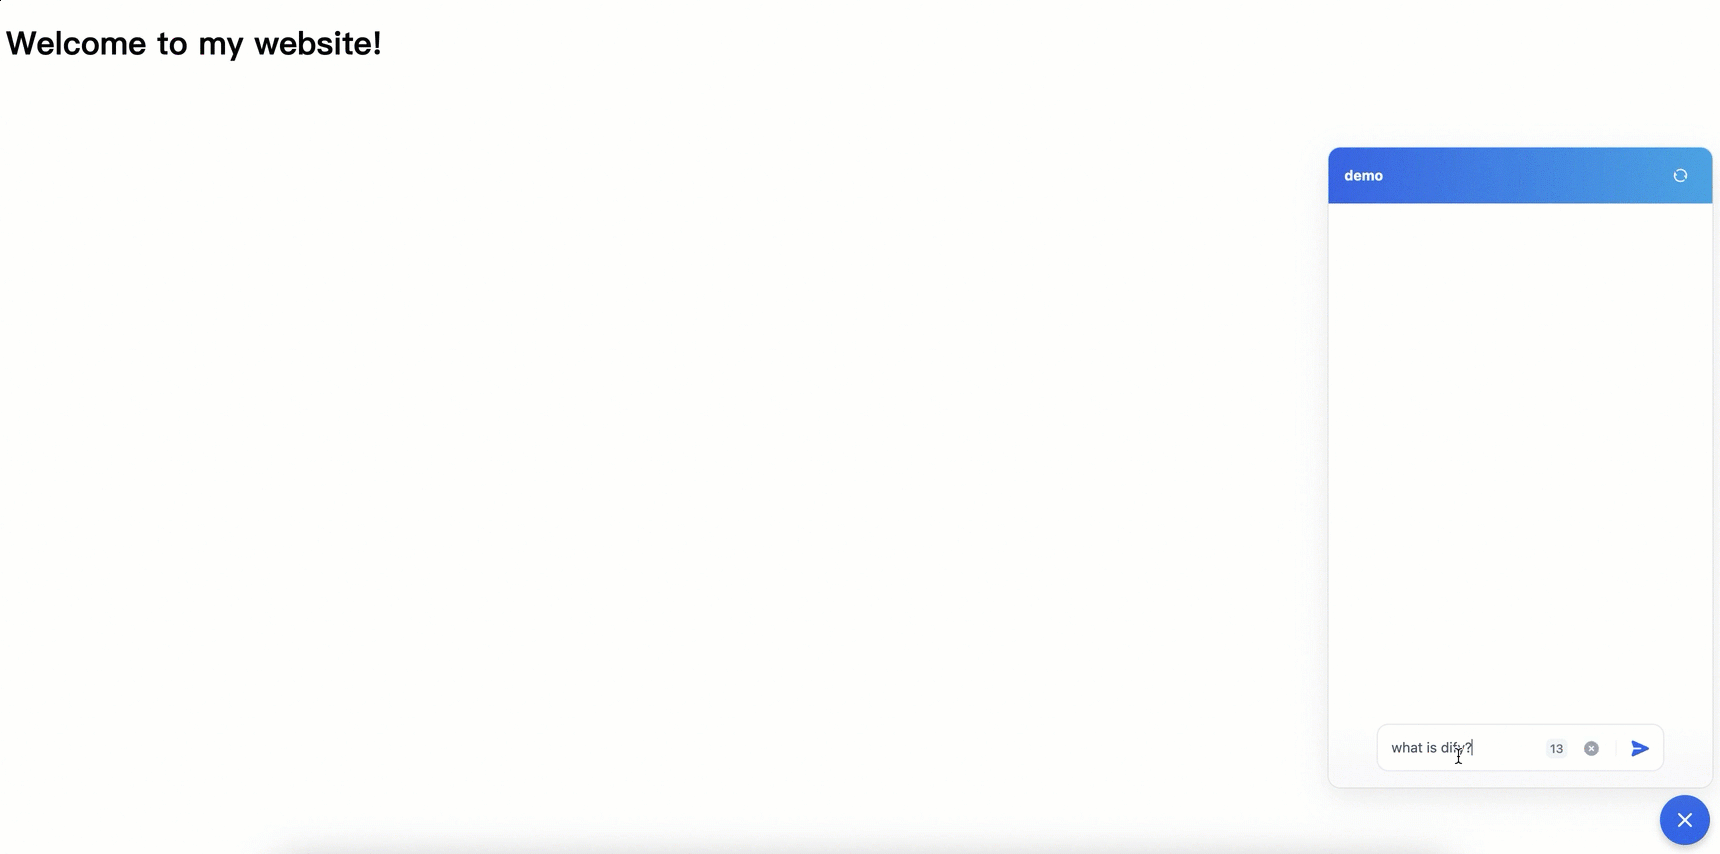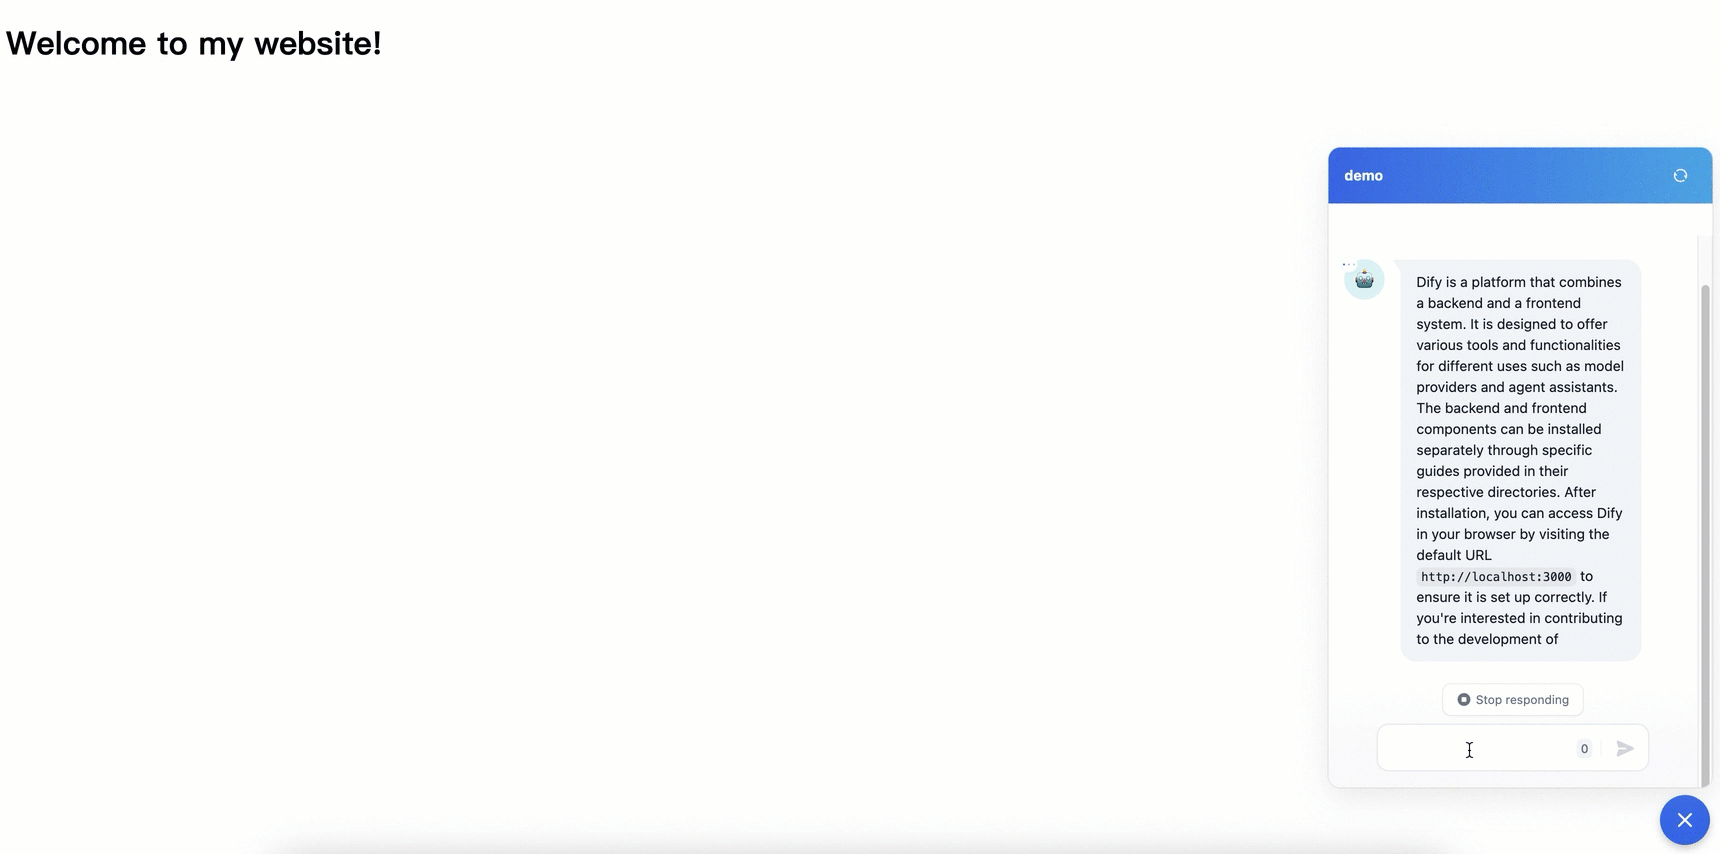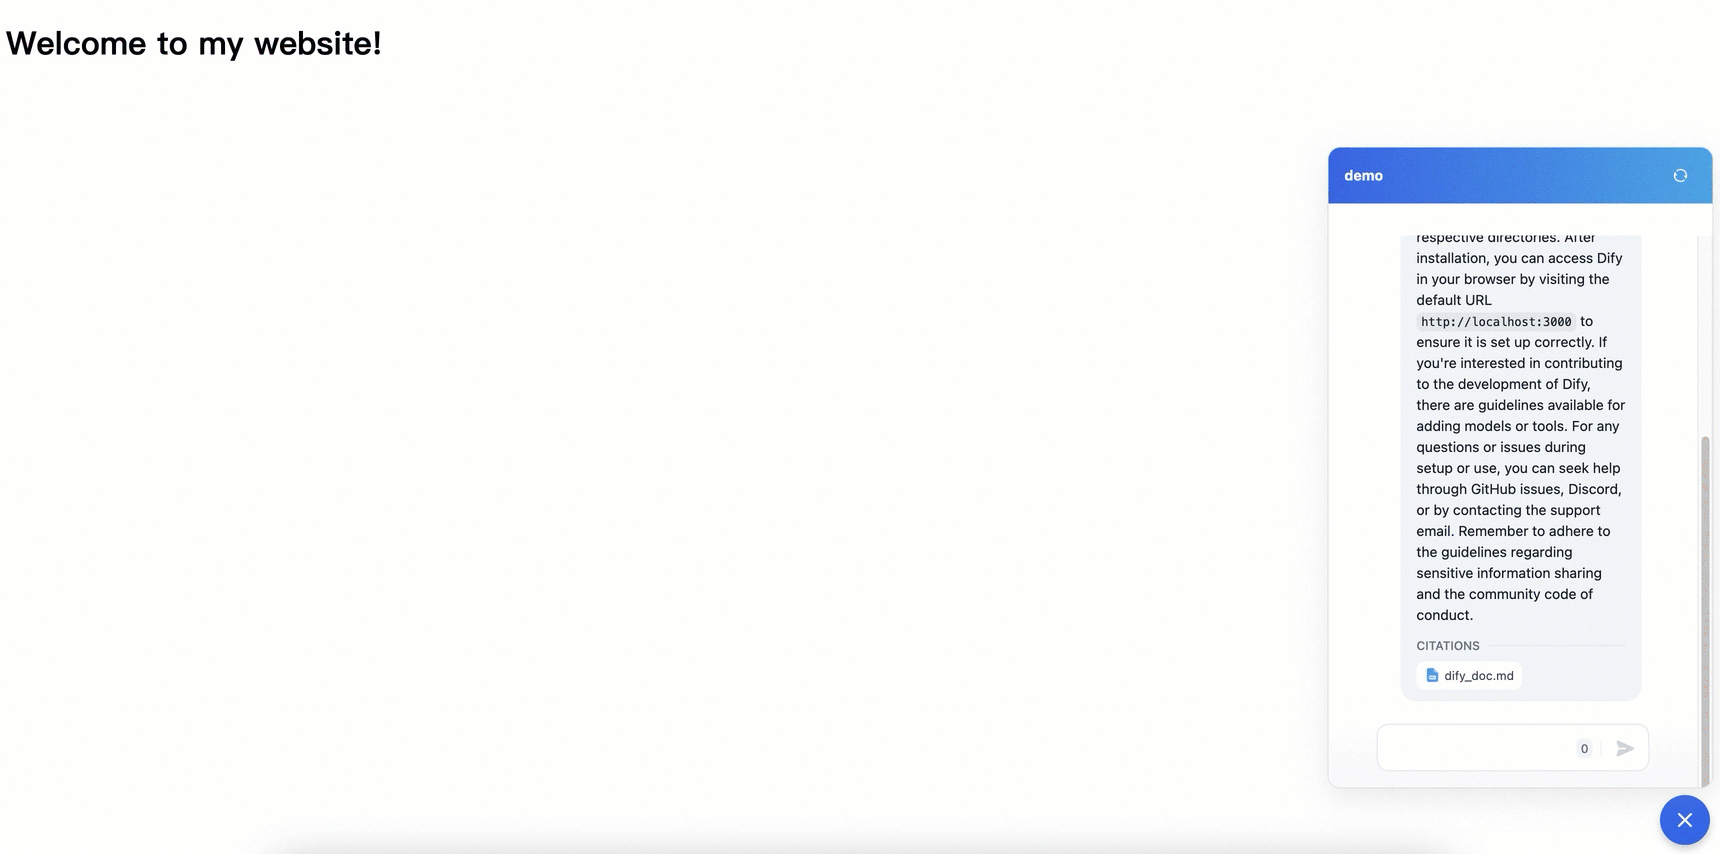
Resultado del ejemplo.
La página muestra el encabezado Welcome to my website!, lo cual indica que la aplicación de IA se integró correctamente en el sitio web.
-
-
Facturación
El uso de esta función genera cargos por la gestión del clúster ACK Pro y por el consumo de recursos de Alibaba Cloud. Los productos de Alibaba Cloud involucrados incluyen Elastic Compute Service (ECS), Classic Load Balancer (CLB), dirección IP elástica (EIP) y Apsara File Storage NAS. Se le facturará por los recursos que utilice conforme a las reglas de precios de cada producto. Para obtener más información sobre los cargos por gestión de clústeres y por recursos de productos en la nube, consulte Billing overview.
Aviso legal
Dify on ACK es una solución de despliegue Helm que adapta el proyecto de código abierto Dify al entorno ACK de Alibaba Cloud para permitir un despliegue rápido. ACK no garantiza el rendimiento de la aplicación Dify ni su compatibilidad con otros componentes del ecosistema, como complementos y bases de datos. ACK no ofrece servicios comerciales, como compensaciones o indemnizaciones, por pérdidas comerciales derivadas de defectos en Dify o en los componentes de su ecosistema. Para garantizar la estabilidad y la seguridad de Dify, siga las actualizaciones de la comunidad de código abierto y corrija de manera proactiva los problemas del software de código abierto.