El Descheduler de ack-koordinator detecta los nodos sobrecargados mediante el uso real de recursos y expulsa los Pods para reequilibrar el clúster.
Este tema describe cómo instalar el desprogramador, habilitar el desprogramado con detección de puntos críticos y configurar sus parámetros avanzados.
Límites
Solo se admiten ACK managed Pro clusters.
-
Versiones de componentes obligatorias:
Component
Version
ACK Scheduler
v1.22.15-ack-4.0 o posterior, v1.24.6-ack-4.0 o posterior
ack-koordinator
v1.1.1-ack.1 o posterior
Helm
v3.0 o posterior
El Koordinator Descheduler solo expulsa Pods; el ACK Scheduler se encarga de la reprogramación. Utilice el desprogramado junto con load-aware scheduling para evitar que los Pods expulsados vuelvan a ubicarse en nodos con puntos críticos.
Durante el desprogramado, los Pods antiguos se expulsan antes de crear los nuevos. Asegúrese de que su aplicación cuente con suficientes réplicas redundantes para mantener la disponibilidad.
El desprogramado utiliza la API de expulsión estándar de Kubernetes. Asegúrese de que sus Pods sean reentrantes para que los reinicios posteriores a la expulsión no interrumpan el servicio.
Facturación
La instalación y el uso de ack-koordinator son gratuitos. Sin embargo, pueden generarse cargos adicionales en los siguientes escenarios:
Recursos de nodos worker: ack-koordinator es un componente autogestionado que consume recursos de los nodos worker. Configure las solicitudes de recursos para cada módulo durante la instalación.
Métricas personalizadas de Prometheus: si habilita Enable Prometheus Monitoring for ACK-Koordinator y utiliza Managed Service for Prometheus, las métricas expuestas se contabilizan como métricas personalizadas y generan costos. Estos dependen del tamaño del clúster y de la cantidad de aplicaciones. Revise la facturación de instancias de Prometheus antes de habilitar esta función. Para monitorear el consumo de recursos, consulte los datos de uso.
Funcionamiento
Ciclo de ejecución
El Koordinator Descheduler se ejecuta de forma periódica. Cada ciclo de ejecución consta de tres etapas:
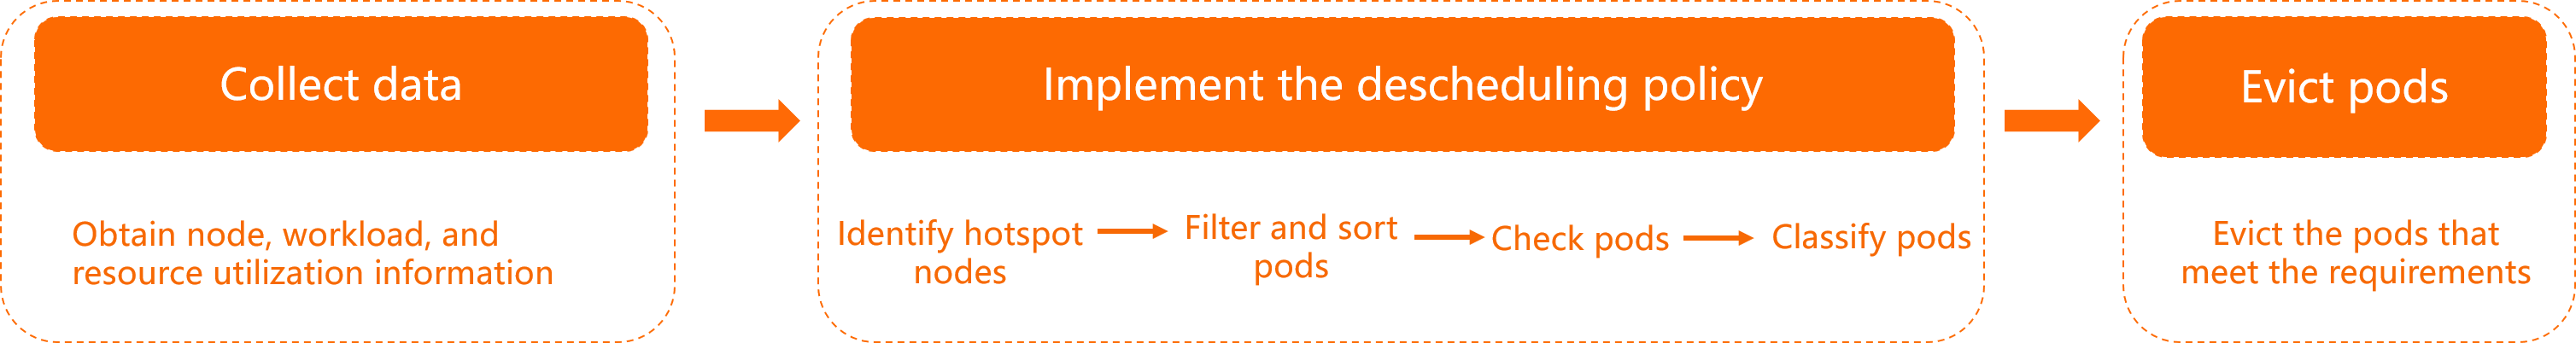
Recolección de datos: obtiene la información de nodos y cargas de trabajo, así como los datos de uso de recursos.
-
Ejecución de plugins (ejemplo con LowNodeLoad):
Identifica los nodos con puntos críticos según
highThresholdsylowThresholds.Recorre todos los nodos con puntos críticos, asigna una puntuación a los Pods elegibles y los ordena para su expulsión. Consulte Pod scoring policy.
Valida cada Pod candidato frente a las restricciones de migración: capacidad del clúster, uso de recursos y límites de proporción de réplicas. Consulte Load-aware hot spot descheduling policies.
Marca como candidatos a migración los Pods que cumplen los requisitos y omite el resto.
Expulsión y migración de Pods: expulsa los candidatos a migración mediante la API de expulsión.
Clasificación de nodos
El plugin LowNodeLoad clasifica los nodos en tres categorías a partir de dos umbrales: lowThresholds (umbral de inactividad) y highThresholds (umbral de punto crítico).
A continuación se muestra un ejemplo con lowThresholds = 45 % y highThresholds = 70 %:

Nodo inactivo: el uso de recursos está por debajo de
lowThresholds(< 45 %).Nodo normal: el uso de recursos se encuentra entre
lowThresholdsyhighThresholds(45 %–70 %). Este es el rango objetivo.Nodo con punto crítico: el uso de recursos supera
highThresholds(> 70 %). Los Pods se expulsan hasta que la carga del nodo disminuya al 70 % o menos.
Los datos de uso de recursos se actualizan cada minuto y reflejan el promedio de los últimos cinco minutos.
Si todos los nodos superanlowThresholds, se considera que la carga del clúster es alta y el desprogramado se suspende, incluso si algunos nodos superanhighThresholds.
Directivas de desprogramado de puntos críticos con detección de carga
|
Policy |
Description |
|
|
Reintento de verificación de puntos críticos |
Un nodo se clasifica como punto crítico solo después de superar |
|
|
Ordenamiento de nodos |
El desprogramado comienza por el nodo con punto crítico que presenta el mayor uso de recursos. La CPU y la memoria se comparan en ese orden. |
|
|
Puntuación de Pods |
En cada nodo con punto crítico, los Pods reciben una puntuación y se ordenan antes de la expulsión: (1) primero los de clase Priority más baja (el valor predeterminado es 0, el más bajo); (2) luego los de clase QoS más baja; (3) si la prioridad y la QoS coinciden, se clasifican por uso de recursos y tiempo de inicio. Configure las clases Priority o QoS para controlar el orden de expulsión. |
|
|
Filtro |
Limita el desprogramado a namespaces, Pods o nodos específicos mediante selectores de etiquetas. Consulte |
|
|
Verificación previa |
Antes de la expulsión, el desprogramador comprueba lo siguiente: (1) que existan nodos compatibles con Node Affinity, Node Selector, Tolerations y los requisitos de recursos; (2) que el nodo destino tenga capacidad suficiente sin superar |
|
|
Limitación de migraciones |
Restringe las migraciones simultáneas de Pods por nodo, namespace y carga de trabajo. Una ventana de tiempo impide que los Pods de una misma carga de trabajo migren con demasiada frecuencia. Es compatible con Pod Disruption Budget (PDB) de Kubernetes para un control detallado de la disponibilidad. |
|
|
Observability |
Se emiten eventos de migración para cada Pod, donde se indica el motivo y el estado. Ejecute |
grep |
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
ACK Scheduler v1.22.15-ack-4.0 o posterior, ack-koordinator v1.1.1-ack.1 o posterior y Helm v3.0 o posterior
Paso 1: Habilitar el desprogramado en ack-koordinator
Instalación nueva: siga el procedimiento de Install ack-koordinator y seleccione Enable ACK-Koordinator Descheduling Module en la página de configuración.
Instalación existente: en la página de configuración, seleccione Enable ACK-Koordinator Descheduling Module. Consulte Modify ack-koordinator.
Paso 2: Habilitar el plugin LowNodeLoad
-
Cree un ConfigMap llamado
koord-descheduler-config.yamlpara habilitar el plugin LowNodeLoad.# koord-descheduler-config.yaml apiVersion: v1 kind: ConfigMap metadata: name: koord-descheduler-config namespace: kube-system data: koord-descheduler-config: | # System configuration for koord-descheduler. Do not modify this section. apiVersion: descheduler/v1alpha2 kind: DeschedulerConfiguration leaderElection: resourceLock: leases resourceName: koord-descheduler resourceNamespace: kube-system deschedulingInterval: 120s # Execution interval. The descheduler runs every 120s. # Must not exceed detectorCacheTimeout (default: 5m). dryRun: false # Set to true to run in read-only mode (no evictions). # End of system configuration. profiles: - name: koord-descheduler plugins: balance: enabled: - name: LowNodeLoad # Enable the LowNodeLoad plugin for hot spot descheduling. evict: enabled: - name: MigrationController # Enable the eviction and migration controller. pluginConfig: - name: MigrationController args: apiVersion: descheduler/v1alpha2 kind: MigrationControllerArgs defaultJobMode: EvictDirectly - name: LowNodeLoad args: apiVersion: descheduler/v1alpha2 kind: LowNodeLoadArgs # A node is idle if usage of ALL resources is below lowThresholds. lowThresholds: cpu: 20 # 20% CPU utilization memory: 30 # 30% memory utilization # A node is a hot spot if usage of ANY resource exceeds highThresholds. highThresholds: cpu: 50 # 50% CPU utilization memory: 60 # 60% memory utilization # Scopes descheduling to specific namespaces. # include and exclude are mutually exclusive—configure only one. evictableNamespaces: include: - default # exclude: # - "kube-system" # - "koordinator-system" -
Aplique el ConfigMap al clúster.
kubectl apply -f koord-descheduler-config.yaml -
Reinicie el Koordinator Descheduler para cargar la nueva configuración.
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 0
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 1
Paso 3 (opcional): Habilitar la programación con detección de carga
Para lograr un equilibrio de carga óptimo, siga el procedimiento de enable load-aware scheduling. De este modo, el ACK Scheduler evitará colocar Pods en nodos con puntos críticos después de la expulsión.
Establezca loadAwareThreshold con el mismo valor que highThresholds. Si los valores no coinciden, los Pods expulsados podrían reprogramarse en nodos con puntos críticos, sobre todo cuando hay pocos nodos con un uso similar.
Paso 4: Comprobar el desprogramado
En este ejemplo se utiliza un clúster de tres nodos, cada uno con 104 núcleos y 396 GiB de memoria.
-
Cree un archivo
stress-demo.yamlcon a continuación contenido.apiVersion: apps/v1 kind: Deployment metadata: name: stress-demo namespace: default labels: app: stress-demo spec: replicas: 6 selector: matchLabels: app: stress-demo template: metadata: name: stress-demo labels: app: stress-demo spec: containers: - args: - '--vm' - '2' - '--vm-bytes' - '1600M' - '-c' - '2' - '--vm-hang' - '2' command: - stress image: polinux/stress imagePullPolicy: Always name: stress resources: limits: cpu: '2' memory: 4Gi requests: cpu: '2' memory: 4Gi restartPolicy: Always -
Despliegue la carga de trabajo de prueba de estrés.
kubectl create -f stress-demo.yamlResultado esperado:
deployment.apps/stress-demo created -
Compruebe que los Pods estén en ejecución y anote el nodo asignado a cada uno.
kubectl get pod -o wideResultado esperado:
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES stress-demo-588f9646cf-s**** 1/1 Running 0 82s 10.XX.XX.53 cn-beijing.10.XX.XX.53 <none> <none> -
Aumente la carga en
cn-beijing.10.XX.XX.53y consulte el uso del nodo.kubectl top nodeResultado esperado:
NAME                      CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
cn-beijing.10.XX.XX.215   17611m       17%    24358Mi         6%
cn-beijing.10.XX.XX.53    63472m       63%    11969Mi         3%
El nodo
cn-beijing.10.XX.XX.53tiene un 63 % de uso de CPU, lo cual supera el umbral de punto crítico del 50 %. El nodocn-beijing.10.XX.XX.215registra un 17 % de CPU, por debajo del umbral de inactividad del 20 %. Habilite el plugin LowNodeLoad tal como se describe en Step 2: Enable the LowNodeLoad plugin.
-
Supervise los cambios en los Pods.
De forma predeterminada, un nodo debe superar
highThresholdsdurante cinco comprobaciones consecutivas (unos 10 minutos con el intervalo predeterminado de 120 segundos) para clasificarse como punto crítico.kubectl get pod -wResultado esperado:
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES stress-demo-588f9646cf-s**** 1/1 Terminating 0 59s 10.XX.XX.53 cn-beijing.10.XX.XX.53 <none> <none> stress-demo-588f9646cf-7**** 1/1 ContainerCreating 0 10s 10.XX.XX.215 cn-beijing.10.XX.XX.215 <none> <none> -
Consulte el evento de expulsión.
kubectl get event | grep stress-demo-588f9646cf-s****Resultado esperado:
2m14s   Normal   Evicting        podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" evicted from node "cn-beijing.10.XX.XX.53" by the reason "node is overutilized, cpu usage(68.53%)>threshold(50.00%)"
101s    Normal   EvictComplete   podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" has been evicted
2m14s   Normal   Descheduled     pod/stress-demo-588f9646cf-s****   Pod evicted from node "cn-beijing.10.XX.XX.53" by the reason "node is overutilized, cpu usage(68.53%)>threshold(50.00%)"
2m14s   Normal   Killing         pod/stress-demo-588f9646cf-s****   Stopping container stress
El Pod ubicado en el nodo con punto crítico se expulsó y migró a
cn-beijing.10.XX.XX.215.
Configuración avanzada
Todos los parámetros del Koordinator Descheduler se configuran en el ConfigMap creado en el paso 2.
# koord-descheduler-config.yaml
apiVersion: v1
kind: ConfigMap
metadata:
  name: koord-descheduler-config
  namespace: kube-system
data:
  koord-descheduler-config: |
    # System configuration. Do not modify this section.
    apiVersion: descheduler/v1alpha2
    kind: DeschedulerConfiguration
    leaderElection:
      resourceLock: leases
      resourceName: koord-descheduler
      resourceNamespace: kube-system
    deschedulingInterval: 120s  # Execution interval. Must not exceed detectorCacheTimeout.
    dryRun: false               # Set to true for read-only mode (no evictions).
    # End of system configuration.

    profiles:
    - name: koord-descheduler
      plugins:
        deschedule:
          disabled:
            - name: "*"  # All plugins disabled by default (shown for reference only).
        balance:
          enabled:
            - name: LowNodeLoad
        evict:
          disabled:
            - name: "*"  # All plugins disabled by default (shown for reference only).
          enabled:
            - name: MigrationController

      pluginConfig:
      - name: MigrationController
        args:
          apiVersion: descheduler/v1alpha2
          kind: MigrationControllerArgs
          defaultJobMode: EvictDirectly
          maxMigratingPerNode: 1       # Max Pods migrating simultaneously per node. 0 = unlimited.
          maxMigratingPerNamespace: 1  # Max Pods migrating simultaneously per namespace.
          maxMigratingPerWorkload: 1   # Max Pods migrating simultaneously per workload (e.g., Deployment).
          maxUnavailablePerWorkload: 2 # Max unavailable replicas per workload during migration.
          evictLocalStoragePods: false # Whether to evict Pods using HostPath or emptyDir volumes.
          objectLimiters:
            workload:               # At most 1 replica migrated per workload within 5 minutes.
              duration: 5m
              maxMigrating: 1

      - name: LowNodeLoad
        args:
          apiVersion: descheduler/v1alpha2
          kind: LowNodeLoadArgs

          lowThresholds:
            cpu: 20
            memory: 30
          highThresholds:
            cpu: 50
            memory: 60

          anomalyCondition:
            consecutiveAbnormalities: 5  # Number of consecutive checks above highThresholds
                                          # before a node is classified as a hot spot.
                                          # Counter resets after eviction.

          detectorCacheTimeout: "5m"  # Cache duration for hot spot checks.
                                      # Must be >= deschedulingInterval.

          evictableNamespaces:
            include:
              - default
            # exclude:
            #   - "kube-system"
            #   - "koordinator-system"

          nodeSelector:  # Process only the specified nodes.
            matchLabels:
              alibabacloud.com/nodepool-id: np77f520e1108f47559e63809713ce****

          podSelectors:  # Process only the specified Pods.
          - name: lsPods
            selector:
              matchLabels:
                koordinator.sh/qosClass: "LS"
Configuración del sistema de Koordinator Descheduler
|
Parameter |
Type |
Value |
Description |
Example |
|
|
boolean |
|
Interruptor del modo de solo lectura. Cuando está habilitado, no se inicia ninguna migración de Pods. |
|
|
|
time.Duration |
> 0s |
Intervalo de ejecución. No debe superar |
|
Configuración de control de expulsión y migración
|
Parameter |
Type |
Value |
Description |
Example |
|
|
int64 |
≥ 0 (predeterminado: 2) |
Número máximo de Pods en migración simultánea por nodo. |
|
|
|
int64 |
≥ 0 (predeterminado: sin límite) |
Número máximo de Pods en migración simultánea por namespace. |
|
|
|
intOrString |
≥ 0 (predeterminado: 10 %) |
Cantidad o porcentaje máximo de Pods en migración por carga de trabajo (por ejemplo, un Deployment). |
|
|
|
intOrString |
≥ 0 (predeterminado: 10 %), menor que el total de réplicas |
Cantidad o porcentaje máximo de réplicas no disponibles por carga de trabajo. |
|
|
|
boolean |
|
Indica si se expulsan los Pods con volúmenes HostPath o emptyDir. Se deshabilita de forma predeterminada para proteger los datos. |
|
|
|
struct |
Duration > 0s (predeterminado: |
Limitación de migraciones a nivel de carga de trabajo. |
|
Configuración del plugin LowNodeLoad
|
Parameter |
Type |
Value |
Description |
Example |
|
|
map[string]float64 |
[0, 100] (CPU y memoria, en porcentajes) |
Umbral de punto crítico. Los Pods ubicados en nodos que superan este valor son candidatos a expulsión. Si todos los nodos superan |
|
|
|
map[string]float64 |
[0, 100] (CPU y memoria, en porcentajes) |
Umbral de inactividad. Si todos los nodos lo superan, se considera que la carga general del clúster es alta y el desprogramado se suspende. |
|
|
|
int64 |
> 0 (predeterminado: 5) |
Ciclos consecutivos durante los cuales un nodo debe superar |
|
|
|
\*metav1.Duration |
Consulte el formato Duration (predeterminado: |
Duración de la caché para las comprobaciones de puntos críticos. Debe ser ≥ |
|
|
|
include: string / exclude: string |
Namespaces del clúster |
Limita el desprogramado a namespaces específicos. Déjelo vacío para procesar todos los Pods. |
|
|
|
metav1.LabelSelector |
Consulte Labels and selectors |
Limita el desprogramado a nodos específicos mediante un selector de etiquetas. Admite un solo node pool ( |
|
|
|
list of PodSelector |
Consulte Etiquetas y selectores |
Limita el desprogramado a Pods específicos mediante selectores de etiquetas. Se admiten varios grupos de selectores. |
|
Preguntas frecuentes
El uso del nodo supera el umbral, pero los Pods no se expulsan
La causa más común es que la configuración del desprogramador no esté activa. Revise los siguientes puntos en orden:
Alcance no configurado: el desprogramador solo procesa los namespaces y nodos incluidos explícitamente (o no excluidos). Compruebe
evictableNamespacesynodeSelector.No se reinició el desprogramador tras cambiar la configuración: los cambios de configuración requieren un reinicio. Consulte Step 2 para ver las instrucciones.
Intervalo mayor que el tiempo de espera de la caché:
deschedulingInterval(predeterminado: 2 min) no debe superardetectorCacheTimeout(predeterminado: 5 min); de lo contrario, la detección de puntos críticos falla. Ajuste los valores y reinicie.El nodo no supera el umbral de manera constante: el desprogramador utiliza un promedio suavizado. Un nodo se clasifica como punto crítico solo después de superar
highThresholdsduranteconsecutiveAbnormalitiesciclos consecutivos (valor predeterminado: 5, unos 10 minutos).kubectl top noderefleja únicamente el último minuto; supervise durante un periodo más largo para confirmar que el uso se mantiene elevado.Capacidad insuficiente del clúster: antes de expulsar un Pod, el desprogramador comprueba que otro nodo tenga capacidad libre suficiente. Si ninguno la tiene, se omite la expulsión. Agregue nodos para aumentar la capacidad.
Carga de trabajo con una sola réplica: de forma predeterminada, los Pods de una sola réplica no se expulsan. Para modificarlo, agregue la anotación
descheduler.alpha.kubernetes.io/evict: "true"al Pod o aspec.template.metadatade la carga de trabajo. Esta opción no es compatible con ack-koordinator v1.3.0-ack1.6 a v1.3.0-ack1.8. Siga el procedimiento de Upgrade to the latest version para utilizarla.El Pod usa HostPath o emptyDir: estos Pods se excluyen del desprogramado de forma predeterminada. Establezca
evictLocalStoragePods: trueen MigrationController para habilitar su expulsión. Consulte Eviction and migration control configuration.Demasiadas réplicas no disponibles o en migración: si las réplicas no disponibles o en migración alcanzan
maxUnavailablePerWorkloadomaxMigratingPerWorkload, se bloquean las expulsiones adicionales. Espere a que finalicen las expulsiones en curso o aumente estos límites.Cantidad de réplicas ≤ límite de migración: si el total de réplicas es ≤
maxMigratingPerWorkloadomaxUnavailablePerWorkload, se omite la carga de trabajo. Reduzca estos valores o utilice porcentajes.
El desprogramador se reinicia con frecuencia
Un ConfigMap no válido o ausente provoca bucles de reinicio. Compruebe el formato del ConfigMap con base en Advanced configuration y luego reinícielo tal como se indica en Step 2.
Cómo funcionan en conjunto la programación con detección de carga y el desprogramado de puntos críticos
Habilite ambas funciones para obtener un equilibrio de carga óptimo. El desprogramado expulsa los Pods de los nodos sobrecargados, mientras que la programación con detección de carga ubica los Pods reprogramados en nodos con menor uso de recursos.
Establezca loadAwareThreshold con el mismo valor que highThresholds. Consulte Use load-aware scheduling y Scheduling policies.
¿Qué datos de uso emplea el desprogramador?
El desprogramador calcula un promedio suavizado a lo largo de varios ciclos. La expulsión se activa solo cuando el uso promedio se mantiene por encima de highThresholds durante los ciclos consecutivos configurados (valor predeterminado: unos 10 minutos).
El desprogramador excluye la caché de páginas de los cálculos de memoria, ya que el sistema operativo puede recuperarla. kubectl top node sí incluye la caché de páginas; utilice Managed Service for Prometheus para consultar la métrica real.