Puede agregar instancias de Elastic Compute Service (ECS) de la familia de instancias empresariales de octava generación g8i a clústeres de Container Service for Kubernetes (ACK) como nodos worker. Además, puede adoptar la tecnología Intel® Extension for PyTorch (IPEX) para acelerar la inference de texto a imagen. También es posible crear un node pool compatible con máquinas virtuales confidenciales Trust Domain Extensions (TDX) y migrar su servicio de inference a dicho node pool para mejorar la seguridad del servicio. Este tema toma como ejemplo un modelo Stable Diffusion XL Turbo para describir cómo usar una política de aceleración por CPU y la familia de instancias g8i. Así obtendrá una experiencia de inference de modelos acelerada equivalente a la que ofrecen las instancias ECS con aceleración por GPU. Esto le permite desarrollar servicios de inference de texto a imagen estables, de alto rendimiento, rentables y seguros.
Contexto
Familia de instancias empresariales de octava generación g8i
La familia de instancias ECS de uso general de octava generación g8i se apoya en Cloud Infrastructure Processing Units (CIPUs) y Apsara Stack. Utiliza procesadores escalables Intel® Xeon® de quinta generación (nombre en código Emerald Rapids) para impulsar el rendimiento. Además, la familia de instancias g8i adopta Advanced Matrix Extensions (AMX), lo que ofrece mayor rendimiento y seguridad en IA. Todas las instancias ECS de la familia g8i admiten Intel® TDX. Esta tecnología le permite desplegar sus cargas de trabajo en un Trusted Execution Environment (TEE) sin modificar las aplicaciones. Elimina la barrera tecnológica para principiantes y mejora la confidencialidad de aplicaciones de IA, como los modelos de lenguaje grandes, con una pérdida mínima de rendimiento. Para obtener más información, consulte g8i general-purpose instance family.
Intel® TDX
Intel® TDX es una tecnología de protección basada en hardware para instancias ECS. En una instancia TDX, los registros de CPU, los datos de memoria, el manejo de interrupciones y otros estados de ejecución se protegen de forma confidencial mediante el hardware de la CPU. Ni los proveedores de nube ni los atacantes externos pueden monitorear o alterar el estado interno de ejecución de una instancia TDX, como los procesos en ejecución y los datos sensibles durante el cómputo. Consulte Intel® Trusted Domain Extension (Intel® TDX).
Intel® TDX protege las instancias y las aplicaciones de forma predeterminada. Las aplicaciones existentes pueden migrar a instancias TDX sin necesidad de redesarrollo.
IPEX
Intel® Extension for PyTorch (IPEX) es una extensión de código abierto de PyTorch mantenida por Intel. Mejora considerablemente el rendimiento de las aplicaciones de IA que usan PyTorch y se ejecutan en procesadores Intel. Intel optimizará IPEX de manera continua con tecnologías de hardware y software de vanguardia para impulsar a la comunidad de PyTorch. Para obtener más información, consulte IPEX.
Alibaba Cloud no garantiza la legitimidad, seguridad ni exactitud de los modelos de terceros "Stable Diffusion" y "stabilityai/sdxl-turbo". Alibaba Cloud no se hace responsable de ninguna pérdida o daño derivado del uso de estos modelos.
Debe cumplir con los acuerdos de usuario, las especificaciones de uso y las leyes y normativas aplicables de los modelos de terceros. Usted acepta que el uso de los modelos de terceros corre bajo su propio riesgo.
El servicio de ejemplo de este tema es únicamente para aprendizaje, pruebas y prueba de concepto (POC). Las estadísticas son solo de referencia y pueden variar según su entorno.
Requisitos previos
Se creó un clúster ACK Pro en la región China (Beijing). Para obtener más información, consulte Create an ACK managed cluster.
-
Se creó un node pool.
-
Node pool regular: cree un node pool que contenga instancias ECS de la familia g8i y cumpla con los siguientes requisitos:
Región y zona: el node pool debe residir en una región y zona admitidas por ECS. Para obtener más información, consulte Instance Types Available for Each Region.
Tipos de instancia: seleccione un tipo de instancia que ofrezca como mínimo 16 vCPU. Se recomienda elegir
ecs.g8i.4xlarge, ecs.g8i.8xlarge oecs.g8i.12xlarge.Espacio en disco: el espacio en disco de cada nodo del node pool debe ser de como mínimo 200 GiB. Puede usar un disco de sistema o un disco de datos superior a 200 GiB.
Node pool compatible con máquinas virtuales confidenciales TDX: también puede migrar su aplicación sin interrupciones a un node pool compatible con máquinas virtuales confidenciales TDX para mejorar la seguridad de su servicio de inference. Para ello, asegúrese de cumplir con Prerequisites.
-
Un cliente kubectl está conectado al clúster ACK. Para obtener más información, consulte Obtain a kubeconfig file and connect to a cluster by using kubectl.
Paso 1: Preparar un modelo Stable Diffusion XL Turbo
En este ejemplo se utiliza el modelo Stable Diffusion XL Turbo stabilityai/sdxl-turbo.
Procedimiento
Usar el modelo oficial stabilityai/sdxl-turbo
Cree un archivo llamado values.yaml y agregue el siguiente contenido. Puede modificar la configuración de recursos según el tipo de instancia del node pool.
resources:
   limits:
     cpu: "16"
     memory: 32Gi
   requests:
     cpu: "14"
     memory: 24Gi
Usar un modelo stabilityai/sdxl-turbo personalizado
También puede usar un modelo stabilityai/sdxl-turbo personalizado almacenado en Object Storage Service (OSS). Cree un usuario de Resource Access Management (RAM) con permisos de acceso a OSS y obtenga el par de accesskey de dicho usuario.
Procedimiento
-
Cree un archivo llamado models-oss-secret.yaml y agregue el siguiente contenido.
apiVersion: v1 kind: Secret metadata: name: models-oss-secret namespace: default stringData: akId: <yourAccessKeyID> # Replace with the AccessKey ID of the RAM user. akSecret: <yourAccessKeySecret> # Replace with the AccessKey secret of the RAM user. -
Ejecute el siguiente comando para crear un Secret:
kubectl create -f models-oss-secret.yamlResultado esperado:
secret/models-oss-secret created -
Cree un archivo llamado models-oss-pv.yaml y agregue el siguiente contenido.
apiVersion: v1
kind: PersistentVolume
metadata:
  name: models-oss-pv
  labels:
    alicloud-pvname: models-oss-pv
spec:
  capacity:
    storage: 50Gi
  accessModes:
    - ReadOnlyMany
  persistentVolumeReclaimPolicy: Retain
  csi:
   driver: ossplugin.csi.alibabacloud.com
   volumeHandle: models-oss-pv
   nodePublishSecretRef:
     name: models-oss-secret
     namespace: default
   volumeAttributes:
     bucket: "<yourBucketName>"  # Replace with the name of the OSS bucket to be mounted.
     url: "<yourOssEndpoint>"  # Replace with the endpoint of the OSS bucket to be mounted. We recommend that you use an internal endpoint. In this example, the endpoint is oss-cn-beijing-internal.aliyuncs.com.
     otherOpts: "-o umask=022 -o max_stat_cache_size=0 -o allow_other"
     path: "/models"  # The path of the model. Make sure that the stabilityai/sdxl-turbo directory can be found in this path.
Para obtener más información sobre los parámetros de OSS, consulte Use an ossfs 1.0 static volume.
-
Ejecute el siguiente comando para crear un volumen persistente (PV) aprovisionado de forma estática:
kubectl create -f models-oss-pv.yamlResultado esperado:
persistentvolume/models-oss-pv created -
Cree un archivo llamado models-oss-pvc.yaml y agregue el siguiente contenido:
apiVersion: v1 kind: PersistentVolumeClaim metadata: name: models-oss-pvc spec: accessModes: - ReadOnlyMany resources: requests: storage: 50Gi selector: matchLabels: alicloud-pvname: models-oss-pv -
Ejecute el siguiente comando para crear una solicitud de volumen persistente (PVC):
kubectl create -f models-oss-pvc.yamlResultado esperado:
persistentvolumeclaim/models-oss-pvc created -
Cree un archivo llamado values.yaml y agregue el siguiente contenido.
Puede modificar la configuración de recursos según el tipo de instancia del node pool.
resources:
   limits:
     cpu: "16"
     memory: 32Gi
   requests:
     cpu: "14"
     memory: 24Gi

useCustomModels: true
volumes:
  models:
    name: data-volume
    persistentVolumeClaim:
      claimName: models-oss-pvc
Configuración de despliegue del servicio en values.yaml
Paso 2: Desplegar el servicio de ejemplo
-
Ejecute el siguiente comando para desplegar un modelo Stable Diffusion XL Turbo acelerado con IPEX:
helm install stable-diffusion-ipex https://aliacs-app-catalog.oss-cn-hangzhou.aliyuncs.com/pre/charts-incubator/stable-diffusion-ipex-0.1.7.tgz -f values.yamlResultado esperado:
NAME: stable-diffusion-ipex LAST DEPLOYED: Mon Jan 22 20:42:35 2024 NAMESPACE: default STATUS: deployed REVISION: 1 TEST SUITE: None -
Espere 10 minutos y ejecute el siguiente comando para consultar el estado del pod. Compruebe que el pod esté en ejecución.
kubectl get pod |grep stable-diffusion-ipexResultado esperado:
stable-diffusion-ipex-65d98cc78-vmj49 1/1 Running 0 1m44s
Una vez desplegado el servicio, se generará una API de texto a imagen accesible públicamente. Para obtener más información sobre la API, consulte API parameters.
Paso 3: Probar el servicio de ejemplo
Procedimiento
-
Ejecute el siguiente comando para asignar el puerto del servicio del modelo Stable Diffusion XL Turbo a un puerto local:
kubectl port-forward svc/stable-diffusion-ipex 5000:5000Resultado esperado:
Forwarding from 127.0.0.1:5000 -> 5000 Forwarding from [::1]:5000 -> 5000 -
Use indicaciones de texto para solicitar al servicio que genere una imagen.
En este ejemplo, el servicio genera imágenes de
512x512o1024x1024.Imagen de 512x512
Ejecute el siguiente comando para solicitar al servicio que genere una imagen a partir de la indicación de texto
A panda listening to music with headphones. highly detailed, 8k.:curl -X POST http://127.0.0.1:5000/api/text2image \ -d '{"prompt": "A panda listening to music with headphones. highly detailed, 8k.", "number": 1}'Resultado esperado:
{
  "averageImageGenerationTimeSeconds": 2.0333826541900635,
  "generationTimeSeconds": 2.0333826541900635,
  "id": "9ae43577-170b-45c9-ab80-69c783b41a70",
  "meta": {
    "input": {
      "batch": 1,
      "model": "stabilityai/sdxl-turbo",
      "number": 1,
      "prompt": "A panda listening to music with headphones. highly detailed, 8k.",
      "size": "512x512",
      "step": 4
    }
  },
  "output": [
    {
      "latencySeconds": 2.0333826541900635,
      "url": "http://127.0.0.1:5000/images/9ae43577-170b-45c9-ab80-69c783b41a70/0_0.png"
    }
  ],
  "status": "success"
}
Introduzca la URL devuelta en la barra de direcciones de su navegador para consultar la imagen.
Imagen de 1024x1024
Ejecute el siguiente comando para solicitar al servicio que genere una imagen a partir de la indicación de texto
A panda listening to music with headphones. highly detailed, 8k.:curl -X POST http://127.0.0.1:5000/api/text2image \ -d '{"prompt": "A panda listening to music with headphones. highly detailed, 8k.", "number": 1, "size": "1024x1024"}'Resultado esperado:
{
  "averageImageGenerationTimeSeconds": 8.635204315185547,
  "generationTimeSeconds": 8.635204315185547,
  "id": "ac341ced-430d-4952-b9f9-efa57b4eeb60",
  "meta": {
    "input": {
      "batch": 1,
      "model": "stabilityai/sdxl-turbo",
      "number": 1,
      "prompt": "A panda listening to music with headphones. highly detailed, 8k.",
      "size": "1024x1024",
      "step": 4
    }
  },
  "output": [
    {
      "latencySeconds": 8.635204315185547,
      "url": "http://127.0.0.1:5000/images/ac341ced-430d-4952-b9f9-efa57b4eeb60/0_0.png"
    }
  ],
  "status": "success"
}
Introduzca la URL devuelta en la barra de direcciones de su navegador para consultar la imagen.
Datos de prueba
A continuación se muestra una tabla con las estadísticas de duración del modelo Stable Diffusion XL Turbo al generar imágenes de 512x512 y 1024x1024 en distintos tipos de instancia ECS de la familia g8i. Estos datos son solo de referencia y pueden variar según su entorno.
|
Tipo de instancia |
Solicitud/límite del pod |
Parámetro |
Duración promedio por ejecución (512x512) |
Duración promedio por ejecución (1024x1024) |
|
ecs.g8i.4xlarge (16 vCPU, 64 GiB) |
14/16 |
batch: 1 step: 4 |
2.2 s |
8.8 s |
|
ecs.g8i.8xlarge (32 vCPU, 128 GiB) |
24/32 |
batch: 1 step: 4 |
1.3 s |
4.7 s |
|
ecs.g8i.12xlarge (48 vCPU, 192 GiB) |
32/32 |
batch: 1 step: 4 |
1.1 s |
3.9 s |
(Opcional) Paso 4: Migrar el servicio a un node pool compatible con máquinas virtuales confidenciales TDX
Después de desplegar el servicio de ejemplo, puede migrarlo sin interrupciones a un node pool compatible con máquinas virtuales confidenciales TDX para mejorar la seguridad del servicio de inference.
Requisitos previos
-
Se creó un node pool compatible con máquinas virtuales confidenciales TDX en el clúster ACK y dicho node pool cumple con los requisitos. Para obtener más información, consulte Create a TDX confidential VM node pool.
Además, el node pool debe cumplir con los siguientes requisitos:
Tipo de instancia: seleccione un tipo de instancia que ofrezca como mínimo 16 vCPU. Se recomienda elegir ecs.g8i.4xlarge.
Espacio en disco: el espacio en disco de cada nodo del node pool debe ser de como mínimo 200 GiB. Puede usar un disco de sistema o un disco de datos superior a 200 GiB.
Etiqueta de nodo: agregue la etiqueta
nodepool-label=tdx-vm-poolal node pool.
Procedimiento
-
Cree un archivo llamado tdx_values.yaml y agregue el siguiente contenido.
Para obtener más información sobre el archivo values.yaml, consulte Service deployment configuration in values.yaml.
NotaEn este ejemplo se agrega la etiqueta
nodepool-label=tdx-vm-poolal node pool. Si desea agregar otras etiquetas, reemplace el valor denodepool-labelen la secciónnodeSelector.nodeSelector: nodepool-label: tdx-vm-pool -
Ejecute el siguiente comando para migrar el modelo Stable Diffusion al node pool:
helm upgrade stable-diffusion-ipex https://aliacs-app-catalog.oss-cn-hangzhou.aliyuncs.com/pre/charts-incubator/stable-diffusion-ipex-0.1.7.tgz -f tdx_values.yamlResultado esperado:
Release "stable-diffusion-ipex" has been upgraded. Happy Helming! NAME: stable-diffusion-ipex LAST DEPLOYED: Wed Jan 24 16:38:04 2024 NAMESPACE: default STATUS: deployed REVISION: 2 TEST SUITE: None -
Espere 10 minutos y consulte el estado del pod. Compruebe que el pod esté en ejecución.
kubectl get pod |grep stable-diffusion-ipexResultado esperado:
stable-diffusion-ipex-7f8c4f88f5-r478t 1/1 Running 0 1m44s Repita Step 3: Test the sample service para probar el modelo Stable Diffusion en el node pool.
Información de la API
Parámetros de la API
Cuando despliega un servicio Stable Diffusion XL Turbo a partir del modelo stabilityai/sdxl-turbo, el servicio genera una API de texto a imagen accesible públicamente. A continuación se describen los parámetros de dicha API.
Sintaxis de la solicitud
POST /api/text2imageParámetros de la solicitud
Ejemplo de solicitud
Parámetros de la respuesta
Ejemplo de respuesta
Comparación de rendimiento
El node pool compatible con máquinas virtuales confidenciales TDX contiene instancias ECS de la familia g8i potenciadas por AMX e IPEX. Estas instancias aceleran eficientemente la inference de texto a imagen y permiten habilitar TEE para mejorar la seguridad. En este ejemplo se utilizan instancias ECS del tipo ecs.g8i.4xlarge equipadas con procesadores escalables Intel® Xeon® de quinta generación para ejecutar y aplicar fine-tune al modelo stabilityai/sdxl-turbo. De esta forma se demuestra cómo desarrollar un servicio de inference de texto a imagen rentable y seguro.
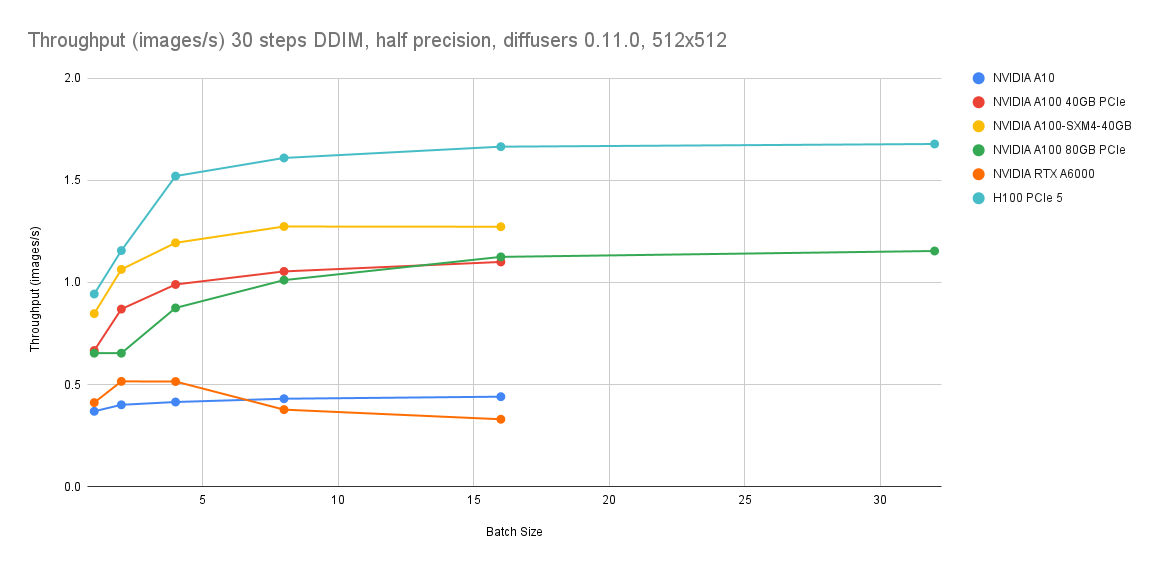
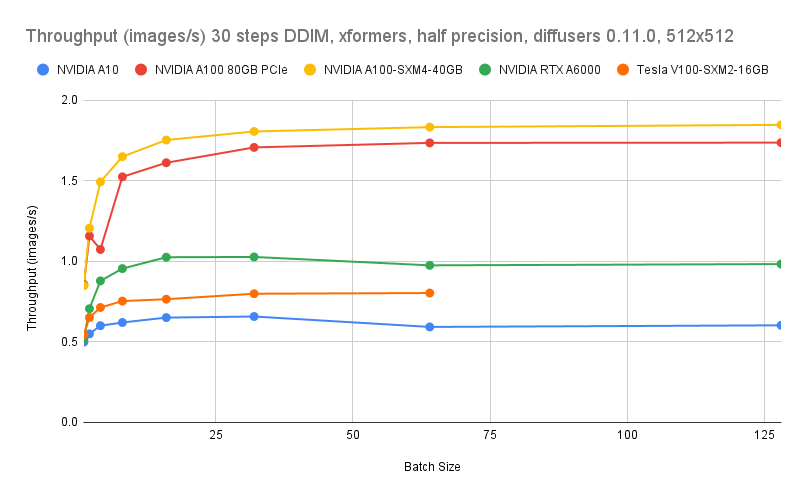
En cuanto a la velocidad de generación de imágenes, la aceleración por GPU (A10) sigue superando a la aceleración por CPU. Cuando el tipo de instancia es ecs.g8i.8xlarge, step es 30 y el tamaño del lote es 16, las imágenes se generan a una tasa de 0.14 imágenes/s. Si el tipo de instancia es una instancia acelerada por GPU A10, step es 30 y el tamaño del lote es 16, las imágenes se generan a una tasa de 0.4 imágenes/s. Sin embargo, si se busca la mejor calidad de imagen con el tipo de instancia ecs.g8i.8xlarge, step en 4 y un tamaño de lote de 16, las imágenes se generan a una tasa de 1.2 imágenes/s. Esto significa que aún es posible generar una imagen por segundo sin comprometer la calidad.
Por lo tanto, esta solución representa una alternativa a la aceleración por GPU que le ayuda a desarrollar servicios de inference de texto a imagen estables, de alto rendimiento, rentables y seguros.
Si necesita rentabilidad, cómputo confidencial TEE y un suministro de recursos a gran escala, se recomienda usar el tipo de instancia ecs.g8i.4xlarge para ejecutar y aplicar fine-tune al modelo stabilityai/sdxl-turbo.
Usar ecs.g8i.8xlarge en lugar de ecs.gn7i-c8g1.2xlarge reduce el costo en un 9 % y mantiene una tasa de generación de 1.2 imágenes/s.
Usar ecs.g8i.4xlarge en lugar de ecs.gn7i-c8g1.2xlarge disminuye la generación de imágenes a 0.5 imágenes/s, pero reduce el costo en más de un 53 %.
Los precios reales de las instancias ECS en distintas regiones se muestran en la pestaña Pricing de la página de destino de Elastic Compute Service. Dichos precios son los definitivos.
Aceleración por CPU
Los datos de benchmarking de distintos modelos de inference se generaron con el tipo de instancia ecs.g8i.8xlarge. A continuación se describen dichos datos. Para obtener más información, consulte Benchmark Tools: lambda-diffusers.
Estos datos de benchmarking son solo de referencia y pueden variar según su entorno.
|
Tipo de instancia |
Alibaba Cloud ecs.g8i.8xlarge 32vCPUs, 128 GiB VM, EMR |
Alibaba Cloud ecs.g8i.8xlarge 32vCPUs, 128 GiB VM, EMR |
|
step |
4 |
30 |
|
Modelo |
sdxl-turbo |
stable-diffusion-2-1-base |
|
Comando |
python sd_pipe_sdxl_turbo.py --bf16 --batch 1 --height 512 --width 512 --repeat 5 --step 4 --prompt "A panda listening to music with headphones. highly detailed, 8k" |
python sd_pipe_infer.py --model /data/models/stable-diffusion-2-1-base --bf16 --batch 1 --height 512 --width 512 --repeat 5 --step 30 --prompt "A panda listening to music with headphones. highly detailed, 8k" |
|
Rendimiento |
|
|
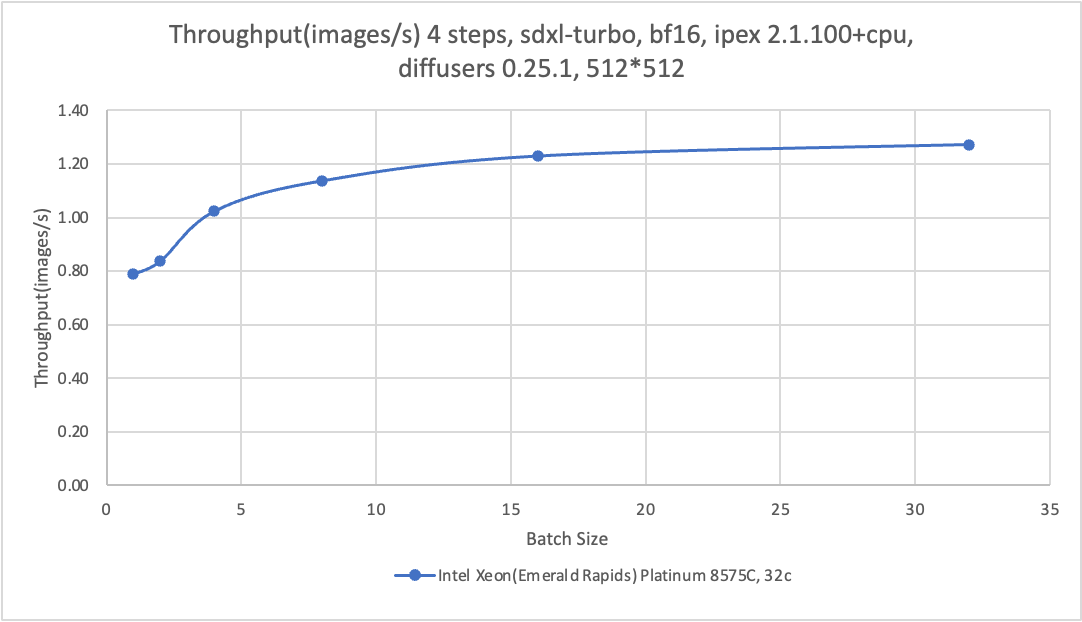
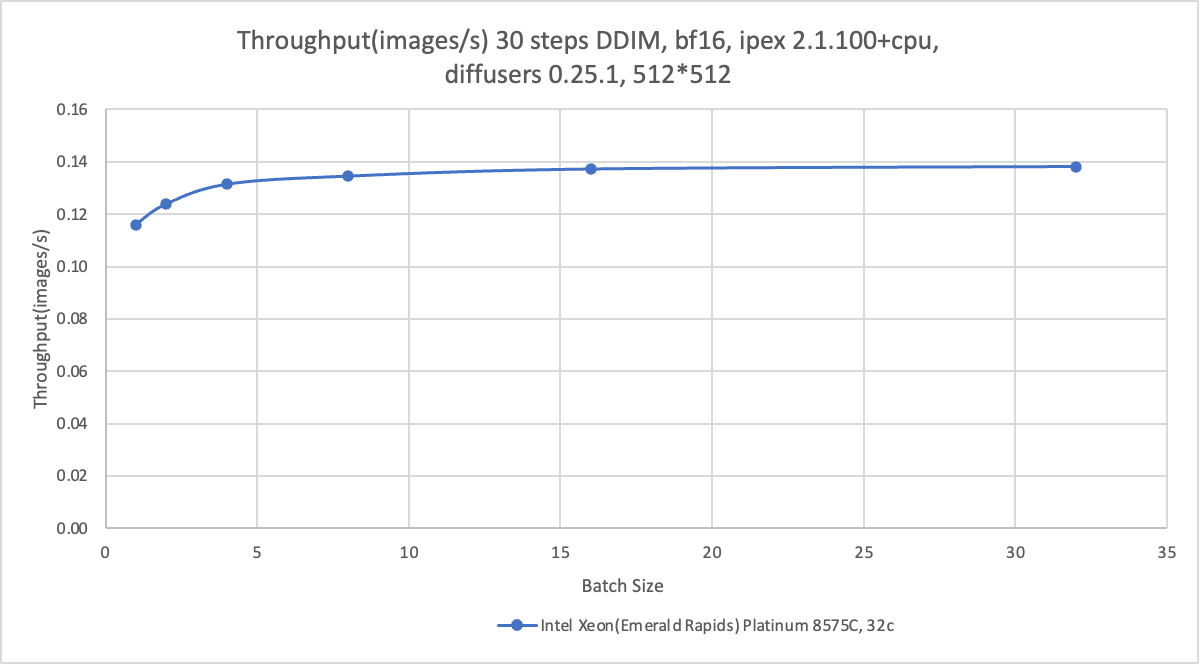
Aceleración por GPU
Los datos de benchmarking utilizados en este ejemplo provienen de Lambda Diffusers. Los datos reales pueden variar. Para obtener más información, consulte Lambda Diffusers Benchmarking inference.