System Observer Monitoring (SysOM) ofrece observability de contenedores a nivel de kernel, y admite el despliegue, la migración y el monitoreo en entornos contenedorizados. Este tema explica cómo habilitar y usar ack-sysom-monitor, además de describir las métricas relacionadas.
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
Un clúster administrado ACK o un clúster ACK Serverless creado después de octubre de 2021, con Kubernetes 1.18.8 o posterior. Consulte Create an ACK managed cluster o Create an ACK Serverless cluster. Para actualizar, consulte Manually update ACK clusters
Managed Service for Prometheus habilitado. Consulte Enable Managed Service for Prometheus
Qué recopila ack-sysom-monitor
ack-sysom-monitor es un componente de System Observer Monitoring (SysOM) que utiliza extended Berkeley Packet Filter (eBPF) para recopilar y mejorar las métricas a nivel de kernel de nodos y contenedores. Además de las métricas estándar del sistema, proporciona métricas mejoradas para el monitoreo a nivel de kernel de pods y nodos, lo cual ayuda a identificar problemas como inestabilidad del sistema, retrasos, fugas de recursos y excepciones de memoria en los pods.
Facturación
Una vez habilitado ack-sysom-monitor, los componentes relacionados envían automáticamente métricas de monitoreo a Managed Service for Prometheus. Estas métricas se facturan como custom metrics.
Antes de habilitar esta función, lea la Descripción general de facturación para comprender cómo se cobran las métricas personalizadas. Los costos varían según el tamaño del clúster y la cantidad de aplicaciones en ejecución. Para monitorear y controlar el uso de recursos, consulte Ver uso de recursos.
Habilitar ack-sysom-monitor
Inicie sesión en la consola de ARMS.
En el panel de navegación izquierdo, haga clic en Integration Center.
En la sección Infrastructure de la página Integration Center, haga clic en SysOM System Observation.
En el paso Start Integration del panel SysOM System Observation, seleccione el clúster ACK y haga clic en OK.
Consultar datos de monitoreo
Inicie sesión en la consola de ACK. En el panel de navegación izquierdo, haga clic en Clusters.
En la página Clusters, haga clic en el nombre de su clúster. En el panel izquierdo, elija Operations > Prometheus Monitoring.
-
En la página Prometheus Monitoring, haga clic en la pestaña SysOM.
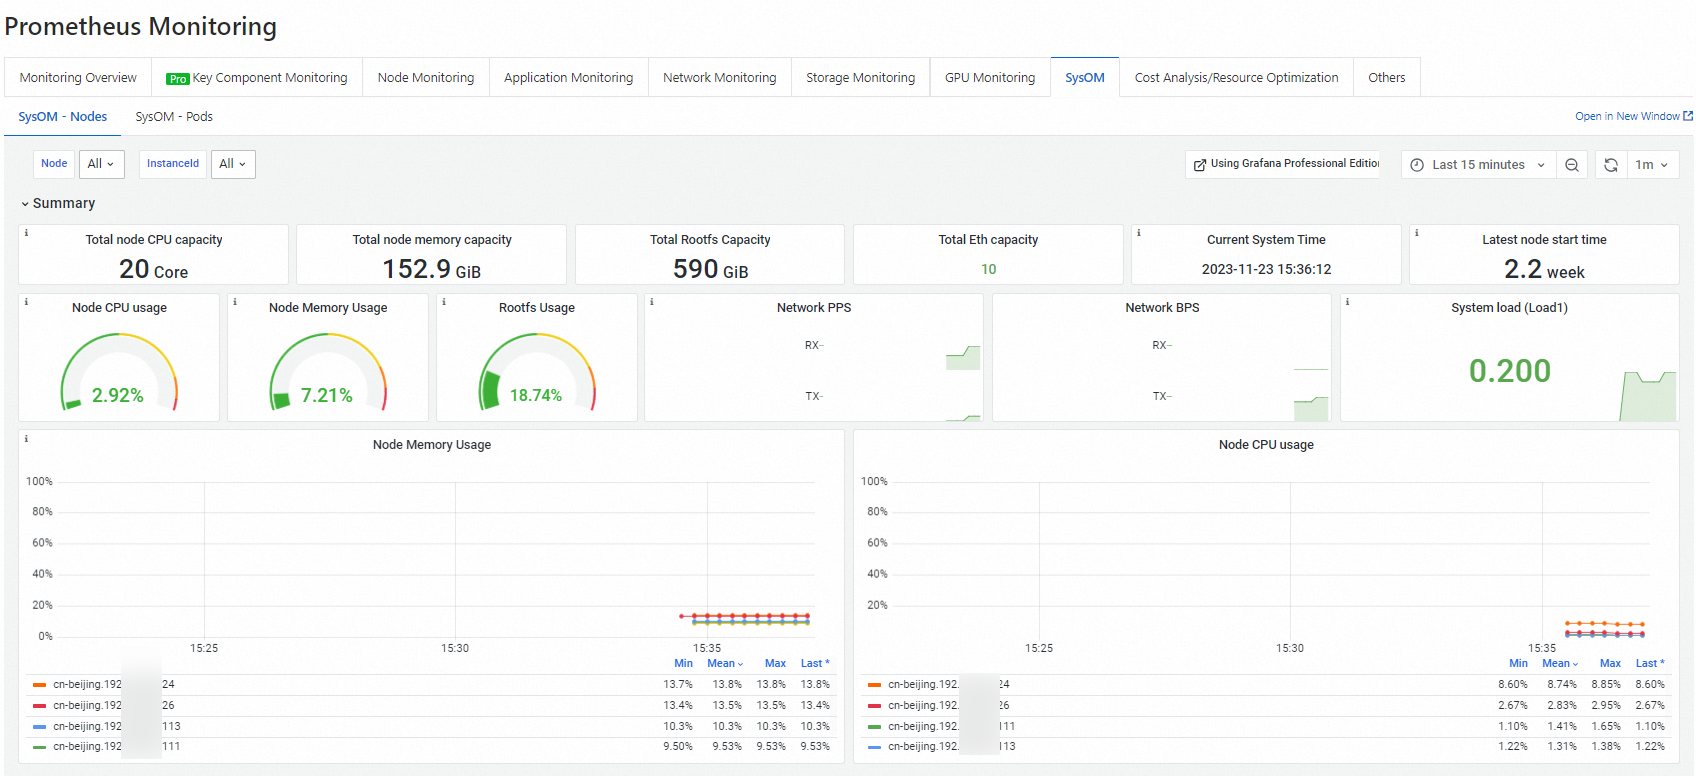
ack-sysom-monitoradmite dos vistas de monitoreo:Monitoreo de nodos a nivel de kernel: en la pestaña SysOM - Nodes, consulte las métricas de CPU, memoria, programación, almacenamiento y red de cada nodo.
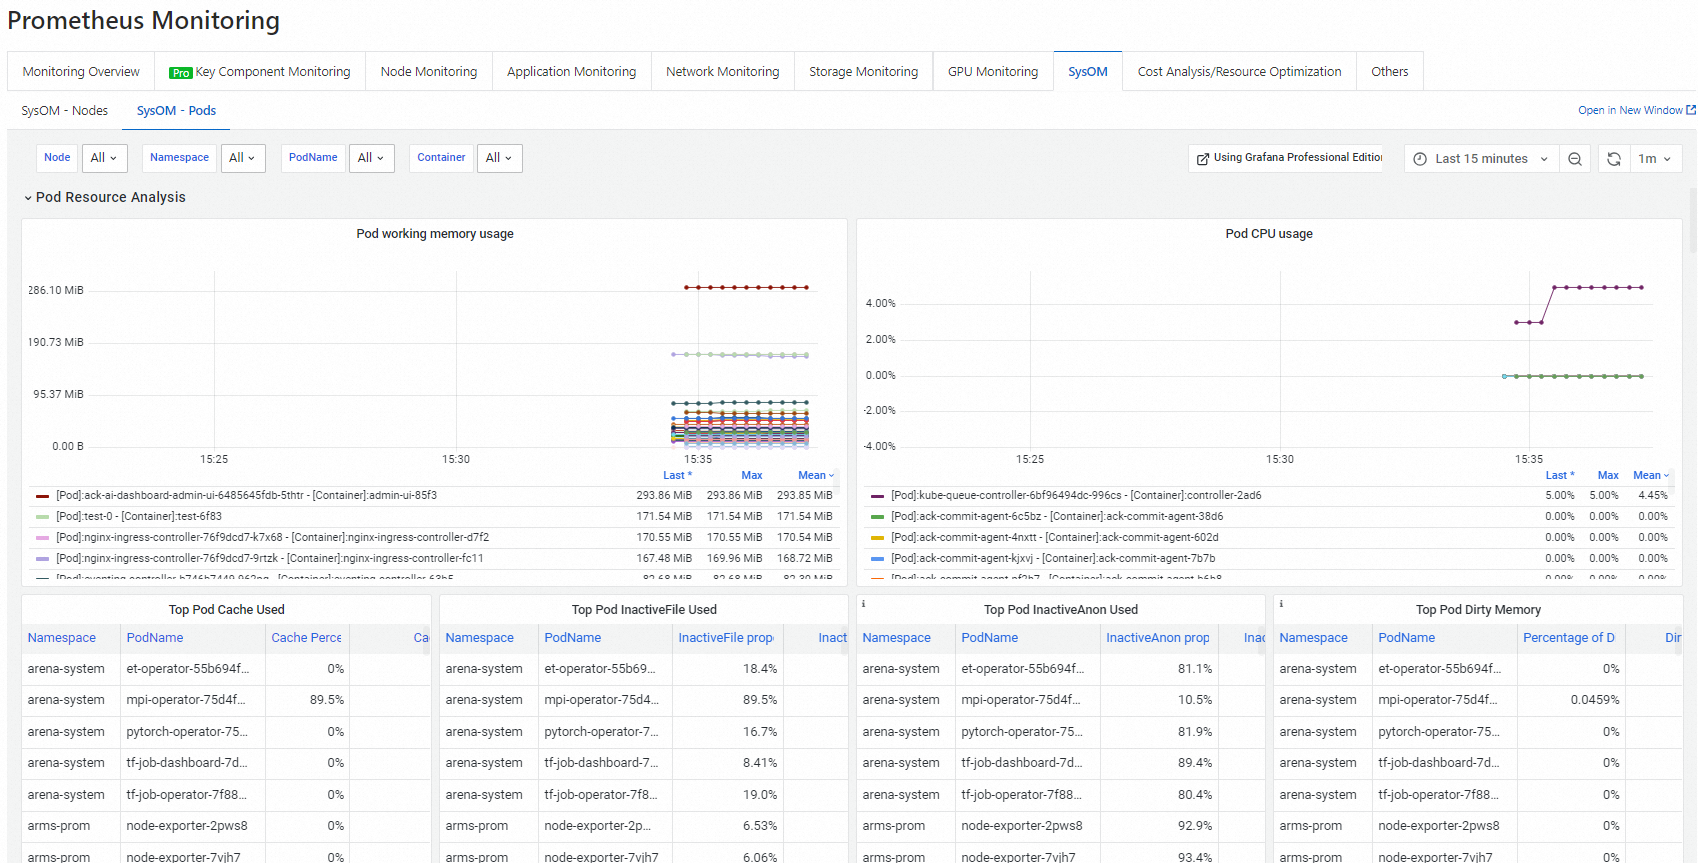
Monitoreo de pods a nivel de kernel: en la pestaña SysOM - Pods, consulte en tiempo real las métricas de memoria, CPU, red y E/S de cada pod.
Siguientes pasos
Para dejar de generar cargos, desinstale el componente ack-sysom-monitor. Consulte Manage components.
Métricas
Todas las métricas proporcionadas por ack-sysom-monitor siguen el modelo de datos de Prometheus.
Todos los tipos de métricas listados a continuación son de tipo gauge .
Escenarios de diagnóstico
Utilice la siguiente tabla para relacionar un síntoma con su métrica correspondiente.
|
Síntoma |
Métricas relevantes |
|
Limitación de CPU o retrasos en la programación |
|
|
Carga alta o exceso de procesos en estado D |
|
|
Presión de memoria o eventos OOM |
|
|
Caché de páginas que causa inestabilidad de memoria |
|
|
Fugas de cgroups |
|
|
Problemas de latencia o rendimiento de E/S de disco |
|
|
Pérdida o retransmisión de paquetes de red |
|
|
RTT de TCP alto o anomalías de conexión |
|
|
Agotamiento de sockets o búferes |
|
Métricas de nodo
Las métricas de nodo incluyen CPU y programación, memoria, almacenamiento, red y otras métricas del sistema.
CPU y programación
|
Métrica |
Tipo |
Unidad |
Descripción |
|
sysom_proc_cpu_total |
gauge |
% |
Desglose del tiempo de actividad de CPU para todo el nodo, por estado: modo usuario, modo kernel, softirq, hardirq, inactividad e iowait. Identifica qué estado consume tiempo de CPU. |
|
sysom_proc_cpus |
gauge |
% |
Desglose del tiempo de actividad de CPU por núcleo, por estado: modo usuario, modo kernel, softirq, hardirq, inactividad e iowait. Detecta desequilibrios entre núcleos. |
|
sysom_proc_sirq |
gauge |
% |
Ocurrencias por tipo de softirq: HI, TIMER, NET_TX, NET_RX, BLOCK, IRQ_POLL, TASKLET, SCHED, HRTIMER y RCU. Un pico en NET_RX o NET_TX puede indicar saturación de la red. |
|
sysom_proc_stat_counters |
gauge |
- |
Número de procesos en estado Running o D, tiempo de arranque del sistema y conteo de cambios de contexto. Un conteo alto de procesos en estado D indica contención de E/S o bloqueos. |
|
sysom_proc_loadavg |
gauge |
- |
Promedios de carga en intervalos de 1, 5 y 15 minutos, además de la longitud de la cola de ejecución y el conteo total de procesos. Evalúa tendencias de carga sostenida. |
|
sysom_proc_schedstat |
gauge |
ns (nanosegundos) |
Latencia de programación de CPU: tiempo de espera en la cola de ejecución y duración del segmento de tiempo de CPU. Un tiempo de espera elevado indica presión en la programación. |
|
sysom_cpu_dist |
gauge |
- |
Distribución de intervalos de programación de CPU: tiempo transcurrido desde que se libera la CPU hasta que se reprograma. Agrupada en 1 µs, 10 µs, 100 µs, 1 ms, 10 ms, 100 ms y 1 s. Las latencias de cola larga indican inestabilidad en la programación. |
Memoria
|
Métrica |
Tipo |
Unidad |
Descripción |
|
sysom_proc_meminfo |
gauge |
KiB |
Uso de memoria a nivel de nodo: Total, Free, Available, Cache, Buffers, SReclaimable y SUnreclaim. Evalúa la presión general de memoria. |
|
sysom_proc_vmstat |
gauge |
- |
Estadísticas de páginas de memoria: páginas libres, páginas sucias, páginas leídas/escritas, páginas recuperadas de la lista inactiva e invocaciones del OOM killer. La actividad del OOM killer señala un agotamiento crítico de memoria. |
|
sysom_proc_buddyinfo |
gauge |
- |
Estado del asignador buddy system: bloques disponibles en distintos tamaños dentro de cada zona de memoria y nodo. Detecta fragmentación de memoria que puede causar fallos de asignación. |
Almacenamiento
|
Métrica |
Tipo |
Unidad |
Descripción |
|
sysom_proc_disks |
gauge |
- |
Estadísticas de E/S por disco y partición: conteo y bytes de solicitudes de lectura/escritura, conteo de fusiones, solicitudes en curso y tiempo total para completar solicitudes. Diagnostica problemas de rendimiento y latencia de disco. |
|
sysom_fs_stat |
gauge |
- |
Uso del sistema de archivos por punto de montaje: tamaño de bloque, bloques usados y disponibles, e inodos usados y disponibles. Detecta el agotamiento de disco o inodos antes de que provoque fallos. |
Red
|
Métrica |
Tipo |
Unidad |
Descripción |
|
sysom_proc_networks |
gauge |
- |
Estadísticas de transferencia de datos por NIC: paquetes y bytes recibidos y enviados, descartes a nivel de controlador y errores de envío/recepción. Detecta pérdida de paquetes a nivel de NIC. |
|
sysom_proc_pkt_status |
gauge |
- |
Eventos de la pila de protocolos de red: descartes de paquetes, desbordamientos de búfer y fallos de aserción. Identifica dónde se pierden los paquetes dentro de la pila. |
|
sysom_sock_stat |
gauge |
- |
Uso de sockets y búferes: conteo total de sockets raw, TCP y UDP, sockets TCP en estado TIME_WAIT u orphan, y uso de memoria de sockets TCP/UDP. Conteos altos de TIME_WAIT u orphan pueden indicar problemas en el manejo de conexiones causados por la lógica de la aplicación o parámetros del sistema. |
|
sysom_softnets |
gauge |
- |
Estadísticas de softirq de NIC por CPU: paquetes recibidos y enviados por softirq, y conteo de invocaciones de |
|
sysom_net_health_hist |
gauge |
- |
Distribución del tiempo de ida y vuelta (RTT) en todas las conexiones TCP del nodo, agrupada en 10 ms, 100 ms y 1 s. Detecta degradación de la latencia TCP. |
|
sysom_net_health_count |
gauge |
- |
RTT promedio de las conexiones TCP en el nodo. Similar a |
|
sysom_net_retrans_count |
gauge |
- |
Estadísticas de retransmisión TCP: conteo de paquetes retransmitidos por tipo (SYN, SYN-ACK, RESET), incluidas las retransmisiones por tiempo de espera agotado. El aumento de estos conteos indica inestabilidad o congestión de la red. |
|
sysom_net_tcp_count |
gauge |
- |
Estadísticas de conexión TCP: conteo de conexiones activas, segmentos recibidos y enviados, segmentos retransmitidos y fallos de recepción. |
|
sysom_net_udp_count |
gauge |
- |
Estadísticas UDP: paquetes recibidos y enviados, errores de búfer de envío/recepción y paquetes descartados por falta de puertos disponibles. |
|
sysom_net_ip_count |
gauge |
- |
Estadísticas de la capa IP: paquetes reenviados, recibidos y enviados. |
|
sysom_net_icmp_count |
gauge |
- |
Estadísticas ICMP: paquetes recibidos y enviados, y fallos de envío/recepción. |
Otras métricas del sistema
|
Métrica |
Tipo |
Unidad |
Descripción |
|
sysom_cgroups |
gauge |
- |
Número de cgroups en uso en los subsistemas: CPU, Cpuacct, Memory, Pids, Blkio y Devices. Un conteo que aumenta constantemente sin disminuir puede indicar fugas de cgroups. |
|
sysom_uptime |
gauge |
s (segundos) |
Tiempo de actividad del sistema desde el último arranque y tiempo de inactividad. |
Métricas de contenedor
Las métricas de contenedor incluyen CPU y programación, memoria, E/S y red.
CPU y programación
|
Métrica |
Tipo |
Unidad |
Descripción |
|
sysom_container_cpu_stat |
gauge |
- |
Estadísticas de limitación de CPU por cgroup: número de veces que se aplicaron límites de CPU, conteo total de aplicaciones y duración total de la limitación. Determina si es necesario ajustar las cuotas de recursos. |
|
sysom_container_cpu_acctstat |
gauge |
% |
Utilización de CPU para tareas del contenedor, desglosada por modo: usuario, kernel y total. Muestra cómo consumen CPU los contenedores en el espacio de kernel y de usuario. |
|
sysom_container_cpu_cfsquota |
gauge |
- |
Configuración del Completely Fair Scheduler (CFS) para el cgroup del contenedor: |
Memoria
|
Métrica |
Tipo |
Unidad |
Descripción |
|
sysom_container_memory_stat |
gauge |
KiB |
Uso de memoria del contenedor por categoría: Total, Free, Available, Cache, Buffers, SReclaimable y SUnreclaim. Evalúa el consumo de memoria por contenedor. |
|
sysom_container_memory_filecache |
gauge |
KiB |
Uso de caché de páginas por contenedor: los 10 archivos que más caché de páginas consumen, tamaños de archivo y caché de páginas total ocupada. Identifica contenedores donde el uso excesivo de caché de páginas causa presión de memoria, latencia o inestabilidad. |
|
sysom_container_memory_gdrcm_latency |
gauge |
Veces |
Retrasos causados por la recuperación de memoria debido a recursos de memoria insuficientes. Cuenta retrasos en seis rangos: 1–5 ms, 5–10 ms, 10–100 ms, 100–500 ms, 500–1,000 ms y más de 1,000 ms. Detecta presión de memoria a nivel de nodo que afecta el rendimiento del contenedor. |
|
sysom_container_memory_cdrcm_latency |
gauge |
Veces |
Retrasos causados por la recuperación de memoria debido a cgroups de memoria insuficientes. Cuenta retrasos en los mismos seis rangos que ** Nota Esta métrica solo es válida si los cgroups de memoria actuales no son cgroups raíz o si se han configurado límites de memoria para los cgroups de memoria actuales. |
|
sysom_container_memory_cpt_latency |
gauge |
Veces |
Retrasos causados por el ajuste de memoria del kernel, que se activa cuando un proceso en el contenedor solicita memoria pero el nodo tiene memoria insuficiente o existe un número excesivo de fragmentos de memoria. Cuenta retrasos en los mismos seis rangos. Detecta fragmentación de memoria que impacta la asignación del contenedor. |
E/S
|
Métrica |
Tipo |
Unidad |
Descripción |
|
sysom_container_blkio_stat |
gauge |
- |
Estadísticas de E/S de bloque para el disco del contenedor: conteo y bytes de solicitudes de lectura/escritura, conteo y bytes de solicitudes en cola, y tiempo de espera de solicitudes. Diagnostica cuellos de botella de E/S a nivel de contenedor. |
Red
|
Métrica |
Tipo |
Unidad |
Descripción |
|
sysom_container_network_stat |
gauge |
- |
Estadísticas de transferencia de datos de la NIC virtual por contenedor: paquetes y bytes recibidos y enviados, y descartes a nivel de dispositivo. No incluye paquetes descartados por la pila de protocolos de red. |