Identifique y resuelva problemas en los nodos mediante comprobaciones de diagnóstico y análisis de causa raíz asistido por IA.
Cuando se ejecuta el diagnóstico de nodos, ACK recopila la versión del sistema, el estado de las cargas de trabajo, Docker y kubelet, así como los errores clave de los registros del sistema de cada nodo.
El diagnóstico de nodos consta de dos componentes:
Elementos de diagnóstico: diagnostican los nodos, sus componentes, los componentes del clúster, el controlador ECS (Elastic Compute Service) manager y los nodos acelerados por GPU.
Causas raíz: localizan las causas raíz y sugieren soluciones a partir de la recopilación de datos del clúster y los nodos, la identificación de anomalías y un análisis detallado.
Funcionamiento
El diagnóstico de nodos se basa en un sistema de diagnóstico de fallas fundamentado en la experiencia de expertos y en un modelo de diagnóstico de fallas con IA entrenado con grandes volúmenes de datos. Combina ambos enfoques para localizar las causas raíz de manera profunda.
Los resultados del diagnóstico pasan por cuatro etapas:
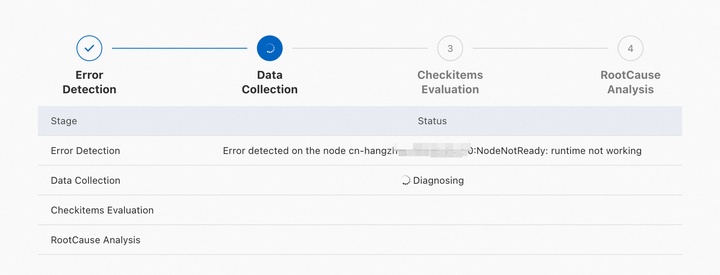
Anomaly identification: recopila señales básicas, como el estado del nodo, el estado de los pods y los flujos de eventos del clúster, e identifica anomalías.
Data collection: reúne datos específicos según las anomalías detectadas. Incluye información de los nodos de Kubernetes, detalles de las instancias ECS y el estado de los procesos de Docker y kubelet.
Diagnostic item check: comprueba si las métricas clave están dentro de los rangos normales. Los elementos se agrupan por categoría y cada uno incluye una descripción.
Root cause analysis: para algunos problemas, determina automáticamente la causa raíz con base en los datos recopilados y los resultados de las comprobaciones.
Resultados del diagnóstico
Los resultados se dividen en dos tipos:
Root cause analysis results: incluyen las anomalías detectadas, la causa raíz identificada y sugerencias de solución.
Diagnostic item check results: incluyen los resultados de cada elemento. Estos pueden revelar causas que el análisis de causa raíz pasa por alto.
Los elementos de diagnóstico varían según la configuración del clúster y reflejan su configuración real.
Casos de uso
El diagnóstico de nodos y el diagnóstico asistido por IA abarcan los siguientes escenarios.
Categoría | Escenario |
Diagnóstico de nodos | Node NotReady: red no lista, identificadores de proceso (PID) insuficientes, memoria insuficiente, espacio en disco insuficiente, excepciones de tiempo de ejecución o ausencia de latidos (heartbeat) |
Inodos insuficientes | |
PID insuficientes | |
Hora incorrecta en el nodo | |
Sistema de archivos del nodo en modo de solo lectura | |
Interbloqueos en el kernel del nodo | |
Diagnóstico asistido por IA | Estado anómalo del nodo |
Estado anómalo de la instancia ECS | |
Errores de kubelet en los nodos | |
Excepciones de tiempo de ejecución en los nodos | |
Espacio en disco insuficiente | |
Uso elevado de CPU en los nodos |
Elementos de diagnóstico
|
Category |
What it checks |
|
Estado del nodo, estado de la red, registros del kernel, procesos principales y disponibilidad de servicios |
|
|
Estado de los componentes clave del nodo, incluidos los componentes de red y almacenamiento |
|
|
Disponibilidad de API Service, disponibilidad de DNS y estado de la puerta de enlace NAT |
|
|
Estado de la instancia ECS, conexiones de red, estado del sistema operativo y E/S de disco |
|
|
Estado del módulo NVIDIA y configuraciones del entorno de ejecución de contenedores en nodos acelerados por GPU |
Nodo
Si el problema persiste después de aplicar la solución sugerida, recopile los registros del nodo y envíe un ticket.
|
Diagnostic item |
What it detects |
Fix |
|
Errores de conectividad con el servidor de API de Kubernetes |
Si el nodo puede comunicarse con el servidor de API del clúster. |
Compruebe la configuración del clúster. Consulte Solución de problemas de clústeres de ACK. |
|
Bloqueos en el montaje de AUFS |
Si existen bloqueos en el montaje de AUFS en el nodo. |
|
|
Errores BufferIOError |
Si hay errores BufferIOError en el kernel del nodo. |
|
|
Fugas de cgroup |
Si se producen fugas de cgroup. |
Las fugas de cgroup pueden interrumpir la recopilación de datos de monitoreo y provocar errores al iniciar contenedores. Inicie sesión en el nodo y elimine los directorios de cgroup afectados. |
|
Estado anómalo del proceso chronyd |
Si el proceso chronyd se ejecuta correctamente. Un proceso chronyd anómalo puede afectar la sincronización del reloj del sistema. |
Ejecute |
|
Descarga de imágenes con containerd |
Si el entorno de ejecución containerd descarga imágenes correctamente. |
Compruebe la configuración de red del nodo y los ajustes de imagen. |
|
Estado de containerd |
Si el entorno de ejecución containerd está en ejecución. |
|
|
Disponibilidad del pod de CoreDNS |
Si el nodo puede comunicarse con la dirección IP del pod de CoreDNS. |
Compruebe si el nodo puede acceder a la dirección IP del pod de CoreDNS. Consulte What do I do if the DNS query load is not balanced among CoreDNS pods?. |
|
Estado de las imágenes |
Si las imágenes están intactas. |
|
|
Estado overlay2 de las imágenes |
Si el sistema de archivos overlay2 de las imágenes está dañado. |
|
|
Hora del sistema |
Si el reloj del sistema es preciso. |
Ninguna. |
|
Inicio de contenedores de Docker |
Si los contenedores de Docker presentan errores al iniciarse. |
|
|
Descarga de imágenes de Docker |
Si el nodo descarga imágenes de Docker correctamente. |
Compruebe la configuración de red del nodo y los ajustes de imagen. |
|
Estado de Docker |
Si el entorno de ejecución de Docker está en ejecución. |
|
|
Tiempo de inicio de Docker |
El tiempo de inicio de Dockerd. |
Ninguna. |
|
Errores de bloqueo de Docker |
Si se producen errores de bloqueo de Docker en el nodo. |
Ejecute |
|
Existencia de la instancia ECS |
Si la instancia ECS subyacente existe. |
Compruebe el estado de la instancia ECS. Consulte FAQ about nodes and node pools. |
|
Estado de la instancia ECS |
Si la instancia ECS se encuentra en un estado correcto. |
Compruebe el estado de la instancia ECS. Consulte FAQ about nodes and node pools. |
|
Errores Ext4FsError |
Si hay errores Ext4FsError en el kernel del nodo. |
|
|
Sistema de archivos del nodo en modo de solo lectura |
Si el sistema de archivos del nodo pasó a modo de solo lectura. Esto suele indicar una falla de disco y bloquea todas las operaciones de escritura, lo que afecta las cargas de trabajo. |
Ejecute |
|
Hora del hardware |
Si el reloj de hardware y el reloj del sistema están sincronizados. Una diferencia mayor a 2 minutos puede causar errores en los componentes. |
Ejecute |
|
DNS del nodo |
Si los nombres de dominio se resuelven en el nodo. |
Consulte DNS troubleshooting. |
|
Errores oops del kernel |
Si hay errores oops en el kernel del nodo. |
|
|
Versiones del kernel |
Si la versión del kernel está desactualizada. Los kernels desactualizados pueden tener problemas de estabilidad conocidos. |
Actualice el kernel del nodo. Consulte FAQ about nodes and node pools. |
|
Disponibilidad del DNS del clúster |
Si el nodo puede comunicarse con la IP del clúster del servicio kube-dns para usar el servicio DNS del clúster. |
Compruebe el estado y los registros de los pods de CoreDNS. Consulte DNS troubleshooting. |
|
Estado de kubelet |
Si kubelet se ejecuta correctamente. |
Revise los registros de kubelet. Consulte Solución de problemas de clústeres de ACK. |
|
Tiempo de inicio de kubelet |
El tiempo de inicio de kubelet. |
Ninguna. |
|
Uso de CPU |
Si el uso de CPU del nodo es excesivamente alto. |
Ninguna. |
|
Uso de memoria |
Si el uso de memoria del nodo es excesivamente alto. |
Ninguna. |
|
Fragmentación de memoria |
Si existe fragmentación de memoria en el nodo. |
Inicie sesión en el nodo y ejecute |
|
Memoria swap |
Si la memoria swap está habilitada. |
Inicie sesión en el nodo y deshabilite la memoria swap. |
|
Carga de controladores de dispositivos de red |
Si los controladores VirtIO de los dispositivos de red se cargan correctamente. |
|
|
Uso de CPU excesivamente alto en el nodo |
Si el uso de CPU fue alto durante la última semana. Si se programan muchos pods en un nodo con uso constante y elevado de CPU, la contención de recursos puede provocar interrupciones del servicio. |
Establezca solicitudes y límites de recursos adecuados para evitar sobrecargar el nodo. |
|
Existencia de IP privada del nodo |
Si el nodo tiene asignada una dirección IP privada. |
Quite el nodo del clúster y vuelva a agregarlo. No libere la instancia ECS al quitarlo. Consulte Remove a node y Add existing ECS instances. |
|
Uso de memoria excesivamente alto en el nodo |
Si el uso de memoria fue alto durante la última semana. Un uso elevado de memoria combinado con una programación intensiva de pods puede causar errores de falta de memoria (OOM) e interrupciones del servicio. |
Establezca solicitudes y límites de recursos adecuados para evitar sobrecargar el nodo. |
|
Estado del nodo |
Si el nodo se encuentra en estado Ready. |
Reinicie el nodo. Consulte FAQ about nodes and node pools. |
|
Programabilidad del nodo |
Si el nodo está marcado como no programable. |
Compruebe la configuración de programación del nodo. Consulte Node draining and scheduling status. |
|
Errores OOM |
Si se producen errores de falta de memoria (OOM) en el nodo. |
|
|
Comprobación del entorno de ejecución |
Si el entorno de ejecución de contenedores del nodo coincide con el configurado en el clúster. |
Consulte Can I change the container runtime of a cluster from containerd to Docker?. |
|
Versiones de SO desactualizadas |
Si la versión del SO del nodo tiene errores o problemas de estabilidad conocidos. Las versiones de SO desactualizadas pueden provocar fallas en los entornos de ejecución Docker y containerd. |
Actualice la versión del SO. |
|
Acceso a Internet |
Si el nodo puede acceder a Internet. |
Compruebe si SNAT está habilitado para el clúster. Consulte Enable an existing ACK cluster to access the internet. |
|
Errores RCUStallError |
Si hay errores RCUStallError en el kernel del nodo. |
|
|
Versiones de SO |
La versión de SO que usa el nodo. Las versiones de SO desactualizadas pueden impedir que el clúster funcione correctamente. |
Ninguna. |
|
Fugas de procesos runc |
Si se producen fugas de procesos runc. Estas fugas pueden hacer que el nodo entre periódicamente en estado NotReady. |
Identifique los procesos runc con fugas y finalícelos manualmente. |
|
Errores SoftLockupError |
Si hay errores SoftLockupError en el kernel del nodo. |
|
|
Bloqueos de systemd |
Si se producen bloqueos de systemd. |
Inicie sesión en el nodo y ejecute |
|
Versiones de systemd desactualizadas |
Si la versión de systemd tiene errores conocidos. Las versiones desactualizadas pueden provocar fallas en Docker y containerd. |
Actualice la versión de systemd. Consulte systemd. |
|
Procesos bloqueados |
Si existen procesos bloqueados en el nodo. |
|
|
Errores unregister_netdevice |
Si hay errores unregister_netdevice en el kernel del nodo. |
NodeComponent
|
Diagnostic item |
What it detects |
Fix |
|
Estado del componente CNI |
Si el plugin Container Network Interface (CNI) se ejecuta correctamente. |
Compruebe el estado del componente de red del clúster. Consulte FAQ about network management. |
|
Estado del componente CSI |
Si el plugin Container Storage Interface (CSI) se ejecuta correctamente. |
Compruebe el estado del componente de almacenamiento del clúster. Consulte FAQ about CSI. |
ClusterComponent
|
Diagnostic item |
What it detects |
Fix |
|
Versión de aliyun-acr-credential-helper |
Si la versión del componente aliyun-acr-credential-helper está desactualizada. |
Actualice aliyun-acr-credential-helper. Consulte Use the aliyun-acr-credential-helper component to pull images without using a secret. |
|
Disponibilidad de API Service |
Si API Service del clúster está disponible. |
Ejecute |
|
Bloques CIDR de pods disponibles insuficientes |
Si quedan menos de cinco bloques CIDR de pods en un clúster Flannel. Cada nodo usa un bloque, por lo que, al agotarse, los nodos nuevos no funcionan correctamente. |
|
|
Endpoints de CoreDNS |
El número de endpoints activos de CoreDNS. |
Compruebe el estado y los registros de los pods de CoreDNS. Consulte DNS troubleshooting. |
|
Direcciones IP del clúster de CoreDNS |
Si el servicio DNS del clúster tiene una ClusterIP asignada. Sin ella, el DNS del clúster falla y las cargas de trabajo se ven afectadas. |
Compruebe el estado y los registros de los pods de CoreDNS. Consulte DNS troubleshooting. |
|
Estado de la puerta de enlace NAT |
Si la puerta de enlace NAT del clúster funciona correctamente. |
Inicie sesión en la consola de NAT Gateway y compruebe si la puerta de enlace está bloqueada por pagos pendientes. |
|
Tasa excesivamente alta de caídas de conexiones simultáneas en la puerta de enlace NAT |
Si la puerta de enlace NAT presenta una tasa anormalmente alta de caídas de conexiones simultáneas. |
Actualice la puerta de enlace NAT. Consulte Preguntas frecuentes sobre la actualización de puertas de enlace NAT de Internet estándar a puertas de enlace NAT de Internet mejoradas. |
ECSControllerManager
Elemento de diagnóstico | Qué detecta | Solución |
Pagos pendientes relacionados con componentes de la instancia ECS | Si el disco o el ancho de banda de red de la instancia están restringidos por pagos pendientes. | Recargue saldo en su cuenta para restaurar el acceso. |
Pagos pendientes relacionados con la instancia ECS | Si la instancia ECS pay-as-you-go se suspendió por pagos pendientes. | Recargue saldo en su cuenta y luego reinicie la instancia. |
Estado de la NIC de la instancia ECS | Si la tarjeta de interfaz de red (NIC) de la instancia funciona correctamente. | Reinicie la instancia. |
Estado de inicio de la instancia ECS | Si la instancia arranca correctamente. | Si el arranque falla, cree una nueva instancia. |
Estado del sistema de administración de backend de la instancia ECS | Si el sistema de administración de backend de la instancia opera correctamente. | Reinicie la instancia. |
Estado de las CPU de la instancia ECS | Si existe contención de CPU o fallas de vinculación de CPU en la capa subyacente de la instancia. | La contención de CPU puede impedir que la instancia obtenga recursos de CPU. Reinicie la instancia. |
Split locks en las CPU de la instancia ECS | Si se producen split locks en las CPU de la instancia ECS. | Se están produciendo split locks en las CPU de la instancia ECS. |
Estado de la mitigación de DDoS para la instancia ECS | Si la dirección IP pública de la instancia está bajo un ataque DDoS. | Adquiera un servicio anti-DDoS. Consulte Comparison of Alibaba Cloud Anti-DDoS solutions. |
Capacidades de lectura y escritura limitadas del disco en la nube | Si el rendimiento de lectura y escritura del disco en la nube está limitado. | Reduzca la frecuencia de lectura y escritura del disco o actualice a un tipo de disco en la nube de mayor rendimiento. Para obtener más información sobre las métricas de rendimiento de lectura y escritura de los discos en la nube, consulte Block storage performance. |
Carga del disco de la instancia ECS | Si el disco en la nube se puede montar cuando se inicia la instancia. | Detenga la instancia y vuelva a iniciarla. |
Vencimiento de la instancia ECS | Si la instancia de suscripción venció. | Renueve la instancia. Consulte Renovación de una instancia de suscripción. |
Bloqueos del SO de la instancia ECS | Si ocurrieron bloqueos del SO en las últimas 48 horas. | Revise los registros del sistema para identificar la causa. Consulte View system logs and screenshots. |
Estado del host de la instancia ECS | Si el servidor físico que aloja la instancia presenta fallas. | Las fallas del host pueden degradar el rendimiento de la instancia. Reinicie la instancia. |
Carga de la imagen de la instancia ECS | Si la instancia puede cargar su imagen durante la inicialización. | Reinicie la instancia. |
Bloqueos de E/S en el disco de la instancia ECS | Si se producen bloqueos de E/S en el disco del sistema. | Compruebe las métricas del disco. Consulte View the monitoring data of a cloud disk. Para Alibaba Cloud Linux 2, consulte Detect I/O hangs of file systems and block layers. |
Límite máximo de ancho de banda de la instancia ECS | Si el ancho de banda total de la instancia alcanzó el máximo permitido para su tipo de instancia. | Actualice a un tipo de instancia con mayor ancho de banda. Consulte Overview of instance configuration changes. |
Límite máximo del ancho de banda ráfaga de la instancia ECS | Si el ancho de banda ráfaga de la instancia superó el máximo permitido para su tipo de instancia. | Actualice a un tipo de instancia con mayor ancho de banda. Consulte Overview of instance configuration changes. |
Carga de la NIC de la instancia ECS | Si la NIC se puede cargar en la instancia. | Si la NIC no se carga, la instancia pierde conectividad de red. Reinicie la instancia. |
Establecimiento de sesiones de la NIC en la instancia ECS | Si se pueden establecer sesiones con la NIC. | Si la NIC no puede establecer sesiones o alcanzó su límite de sesiones, la conectividad o el rendimiento de la red se ven afectados. Reinicie la instancia. |
Operaciones clave en la instancia ECS | Si las operaciones recientes en la instancia, como iniciar, detener o actualizar, se completaron correctamente. | Vuelva a intentar la operación que falló. |
Pérdida de paquetes en la NIC de la instancia ECS | Si se produce pérdida de paquetes entrantes o salientes en la NIC. | Reinicie la instancia. |
Degradación del rendimiento de la instancia ECS | Si el rendimiento de la instancia se degradó temporalmente por problemas de software o hardware. | Consulte los eventos históricos o los registros del sistema de la instancia para identificar la causa. Consulte View historical system events. |
Rendimiento comprometido de la instancia ECS | Si el rendimiento de la instancia está reducido. | La instancia ECS solo proporciona el rendimiento base debido a créditos de CPU disponibles insuficientes. |
Cambio de tamaño del disco de la instancia ECS | Si se cambió el tamaño del disco pero el SO aún no expandió el sistema de archivos. | El SO no pudo cambiar el tamaño del sistema de archivos después de modificar el disco, por lo que el espacio adicional no está disponible. Vuelva a cambiar el tamaño del disco. |
Solicitud de recursos de la instancia ECS | Si hay suficientes recursos físicos de CPU y memoria disponibles para la instancia. | La falta de recursos físicos impide que la instancia se inicie. Espere unos minutos y vuelva a intentar iniciarla. Si el problema persiste, cree una instancia en otra región o zona. |
Estado del SO de la instancia ECS | Si ocurrieron kernel panics, errores OOM o fallas internas en el SO de la instancia. | Estas fallas suelen deberse a configuraciones incorrectas de la instancia o a programas del usuario. Reinicie la instancia. |
Estado de virtualización de la instancia ECS | Si existen excepciones en la capa de virtualización subyacente. | Estas excepciones pueden hacer que la instancia deje de responder o se suspenda de forma inesperada. Reinicie la instancia. |
GPUNode
Elemento de diagnóstico | Qué detecta | Solución |
Entorno de ejecución de contenedores | Si el entorno de ejecución de contenedores del nodo acelerado por GPU es válido. ACK solo admite Docker y containerd para nodos acelerados por GPU. | Compruebe el estado del entorno de ejecución Docker o containerd en el nodo. |
Versión de NVIDIA-Container-Runtime | Si la versión de NVIDIA-Container-Runtime es compatible con el clúster. |
|
Estado del módulo cGPU | Si el módulo cGPU se ejecuta correctamente en nodos con uso compartido de GPU habilitado. |
|
Configuraciones del entorno de ejecución de contenedores | Si el entorno de ejecución de contenedores del nodo acelerado por GPU está configurado correctamente. Una configuración incorrecta impide que los contenedores de GPU se ejecuten. | Compruebe si el campo |
Estado de NVIDIA-Container-Runtime | Si NVIDIA-Container-Runtime se ejecuta correctamente. | Recopile los datos de diagnóstico y envíe un ticket. Consulte Collect diagnostic data from GPU-accelerated nodes. |
Estado del módulo NVIDIA | Si el módulo del kernel de NVIDIA se ejecuta correctamente en el nodo acelerado por GPU. Un módulo NVIDIA con errores impide que se ejecuten todas las cargas de trabajo de GPU. |
|