Configure Knative Pod Autoscaler (KPA) para escalar los pods de Knative Serving por concurrencia o RPS en ACK.
Requisitos previos
Antes de empezar, asegúrese de que:
Se ha creado un ACK managed cluster o ACK Serverless cluster con Kubernetes 1.20 o posterior.
Knative está desplegado en el clúster.
Funcionamiento
Knative Serving inyecta un contenedor sidecar queue-proxy en cada pod. Este sidecar reporta métricas de concurrencia a KPA, que ajusta la cantidad de pods según dichas métricas y el algoritmo configurado.

Algoritmo de escalado
KPA calcula la cantidad objetivo de pods con esta fórmula:
Number of pods = Number of concurrent requests / (Pod maximum concurrency × Target utilization)Ejemplo: Con containerConcurrency establecido en 10 y una utilización objetivo del 70 %, 100 solicitudes concurrentes producen: 100 / (10 × 0.7) = 15 pods (redondeado hacia arriba).
Modos estable y de pánico
KPA utiliza dos modos para responder a los patrones de tráfico:
Modo estable: es el modo predeterminado. KPA promedia la concurrencia entre los pods durante la ventana estable (predeterminado: 60 s) y ajusta la cantidad de pods para coincidir con dicho promedio.
Modo de pánico: se activa durante picos de tráfico. KPA usa una ventana de pánico más corta (predeterminado: 6 s; stable window × panic-window-percentage) para detectar aumentos repentinos. Cuando la cantidad de pods en modo de pánico ≥ panic-threshold-percentage / 100 × pods listos (predeterminado: 2×), KPA utiliza la cuenta de pánico en lugar de la cuenta estable.
Configurar el ConfigMap config-autoscaler
Los valores globales predeterminados de KPA se encuentran en el ConfigMap config-autoscaler dentro del namespace knative-serving. Las anotaciones por revisión anulan estos valores predeterminados.
Inspeccione la configuración actual:
kubectl -n knative-serving describe cm config-autoscalerLa siguiente tabla enumera los parámetros clave. Todos los valores son los predeterminados.
|
Parámetro |
Valor predeterminado |
Descripción |
|
|
|
Máximo de solicitudes concurrentes por pod (límite flexible, global) |
|
|
|
Porcentaje de utilización objetivo para el escalado basado en concurrencia |
|
|
|
RPS objetivo por pod |
|
|
|
Capacidad de ráfaga antes de que Activator almacene las solicitudes en búfer. |
|
|
|
Ventana de tiempo para el promedio en modo estable |
|
|
|
Ventana de pánico como porcentaje de la ventana estable (predeterminado: 6 s) |
|
|
|
El modo de pánico se activa cuando los pods deseados ≥ |
|
|
|
Proporción máxima de pods deseados por evento de escalado horizontal: |
|
|
|
Los pods se reducen como máximo a la mitad de la cantidad actual por actividad |
|
|
|
Indica si se deben escalar a cero los servicios inactivos |
|
|
|
Tiempo máximo para la reconfiguración de red durante el escalado a cero |
|
|
|
Tiempo mínimo que se mantiene el último pod después de que cesa el tráfico |
|
|
|
Tipo de autoescalador. Valores compatibles: |
|
|
|
Capacidad de solicitudes del servicio Activator |
|
|
|
Cantidad inicial de pods por revisión |
|
|
|
Indica si una revisión puede iniciar con cero pods |
|
|
|
Mínimo de pods por revisión (0 = sin límite inferior) |
|
|
|
Máximo de pods por revisión (0 = ilimitado) |
|
|
|
Tiempo con concurrencia reducida antes de reducir la escala. A diferencia de |
scale-to-zero-grace-period limita cuánto tiempo puede tardar la programación de red durante el escalado a cero. Ajústelo solo si observa solicitudes descartadas durante este proceso; este parámetro no controla cuánto tiempo permanece activo el último pod. Para mantener el último pod después de que finalice el tráfico, utilice scale-to-zero-pod-retention-period en su lugar.
Configurar métricas de escalado
Establezca la métrica de escalado por revisión mediante la anotación autoscaling.knative.dev/metric. Valor predeterminado: concurrency.
|
Métrica |
Clase de autoescalador obligatoria |
Descripción |
|
|
|
Solicitudes simultáneas en curso por pod |
|
|
|
Solicitudes por segundo por pod |
|
|
|
Utilización de CPU |
|
|
|
Utilización de memoria |
|
Métricas personalizadas |
Variable |
Métricas personalizadas según los requisitos de la aplicación |
Métrica de concurrencia (predeterminada)
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/metric: "concurrency"
Métrica de RPS
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/metric: "rps"
Métrica de CPU
El escalado basado en CPU requiere la clase de autoescalador HPA.
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/class: "hpa.autoscaling.knative.dev"
        autoscaling.knative.dev/metric: "cpu"
Métrica de memoria
El escalado basado en memoria también requiere la clase de autoescalador HPA.
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/class: "hpa.autoscaling.knative.dev"
        autoscaling.knative.dev/metric: "memory"
Configurar objetivos de escalado
Los objetivos de escalado definen el valor de la métrica que KPA mantiene por pod. Puede configurarlos por revisión o de forma global.
Objetivo de concurrencia
Por revisión: use autoscaling.knative.dev/target:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
autoscaling.knative.dev/target: "50"Global: actualice el ConfigMap config-autoscaler:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  container-concurrency-target-default: "200"
Objetivo de RPS
Por revisión:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "150"
        autoscaling.knative.dev/metric: "rps"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Global:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  requests-per-second-target-default: "150"
Configurar límites de concurrencia
Los límites de concurrencia restringen las solicitudes simultáneas por pod. KPA admite dos tipos.
Límite de concurrencia flexible
Un límite flexible es el objetivo hacia el cual escala KPA. No se aplica de forma estricta; las ráfagas pueden superarlo momentáneamente.
Por revisión:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "200"
Global:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  container-concurrency-target-default: "200"
Límite de concurrencia estricto
Un límite estricto se aplica rigurosamente; las solicitudes excedentes se almacenan en búfer. Establezca un límite estricto solo cuando su aplicación tenga un límite superior firme de concurrencia; valores bajos reducen el throughput y aumentan la latencia.
Por revisión: use el campo de especificación containerConcurrency (no una anotación):
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    spec:
      containerConcurrency: 50
Utilización objetivo
La utilización objetivo controla qué tan ocupados operan los pods antes de que KPA escale horizontalmente. Con una utilización del 70 % y containerConcurrency: 10, KPA crea un nuevo pod cuando la concurrencia promedio entre los pods existentes alcanza 7. Valores más bajos hacen que KPA escale antes, lo que reduce la latencia de inicio en frío.
Por revisión:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target-utilization-percentage: "70"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Global:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  container-concurrency-target-percentage: "70"
Configurar el escalado a cero
Habilitar o deshabilitar el escalado a cero globalmente
Establezca enable-scale-to-zero en "false" para mantener al menos un pod en ejecución cuando un servicio esté inactivo:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  enable-scale-to-zero: "false"
Configurar el periodo de gracia de escalado a cero
scale-to-zero-grace-period limita cuánto tiempo puede tardar la programación de red durante el escalado a cero.
Auméntelo solo si observa solicitudes descartadas durante el escalado a cero. Este parámetro no controla cuánto tiempo permanece activo el último pod. Para mantener el último pod, utilice scale-to-zero-pod-retention-period en su lugar.
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  scale-to-zero-grace-period: "40s"
Configurar el periodo de retención de pods
scale-to-zero-pod-retention-period mantiene el último pod durante una duración mínima después de que cesa el tráfico, lo que evita inicios en frío en servicios con tráfico intermitente.
Por revisión:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/scale-to-zero-pod-retention-period: "1m5s"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Global:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  scale-to-zero-pod-retention-period: "42s"
Configurar límites de escalado
Los límites de escalado establecen las cantidades mínima y máxima de réplicas para una revisión.
|
Anotación |
Parámetro (global) |
Propósito |
|
|
|
Límite inferior: KPA nunca escala por debajo de esta cantidad |
|
|
|
Límite superior: KPA nunca escala por encima de esta cantidad (0 = ilimitado) |
min-scalemantiene un mínimo permanente de pods. Para retrasar la reducción de escala sin un mínimo permanente, utilicescale-down-delayenconfig-autoscaleren su lugar; los pods se reducirán igualmente después del retraso.
Ejemplos
Ejemplo 1: Escalar por objetivo de concurrencia
Despliegue una aplicación con escalado automático y un objetivo de concurrencia de 10, y pruébela con 50 solicitudes concurrentes.
Deploy Knative in an ACK cluster o an ACK Serverless cluster.
-
Cree el archivo
autoscale-go.yamlcon el siguiente contenido:apiVersion: serving.knative.dev/v1 kind: Service metadata: name: autoscale-go namespace: default spec: template: metadata: labels: app: autoscale-go annotations: autoscaling.knative.dev/target: "10" # Concurrency target: 10 requests per pod spec: containers: - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/autoscale-go:0.1 -
Aplique el manifiesto:
kubectl apply -f autoscale-go.yaml -
Obtenga la dirección de la puerta de enlace Ingress. ALB:
kubectl get albconfig knative-internetSalida esperada:
NAME               ALBID                    DNSNAME                                              PORT&PROTOCOL   CERTID   AGE
knative-internet   alb-hvd8nngl0lsdra15g0   alb-hvd8nng******.cn-beijing.alb.aliyuncs.com                            2
MSE:
kubectl -n knative-serving get ing stats-ingressSalida esperada:
NAME            CLASS                  HOSTS   ADDRESS                         PORTS   AGE
stats-ingress   knative-ingressclass   *       101.201.XX.XX,192.168.XX.XX   80      15d
ASM:
kubectl get svc istio-ingressgateway --namespace istio-system --output jsonpath="{.status.loadBalancer.ingress[*]['ip']}"Salida esperada:
121.XX.XX.XXKourier:
kubectl -n knative-serving get svc kourierSalida esperada:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kourier LoadBalancer 10.0.XX.XX 39.104.XX.XX 80:31133/TCP,443:32515/TCP 49m -
Envíe 50 solicitudes concurrentes durante 30 segundos con hey:
hey -z 30s -c 50 \
  -host "autoscale-go.default.example.com" \
  "http://121.199.XXX.XXX"  # Replace with your Ingress gateway address
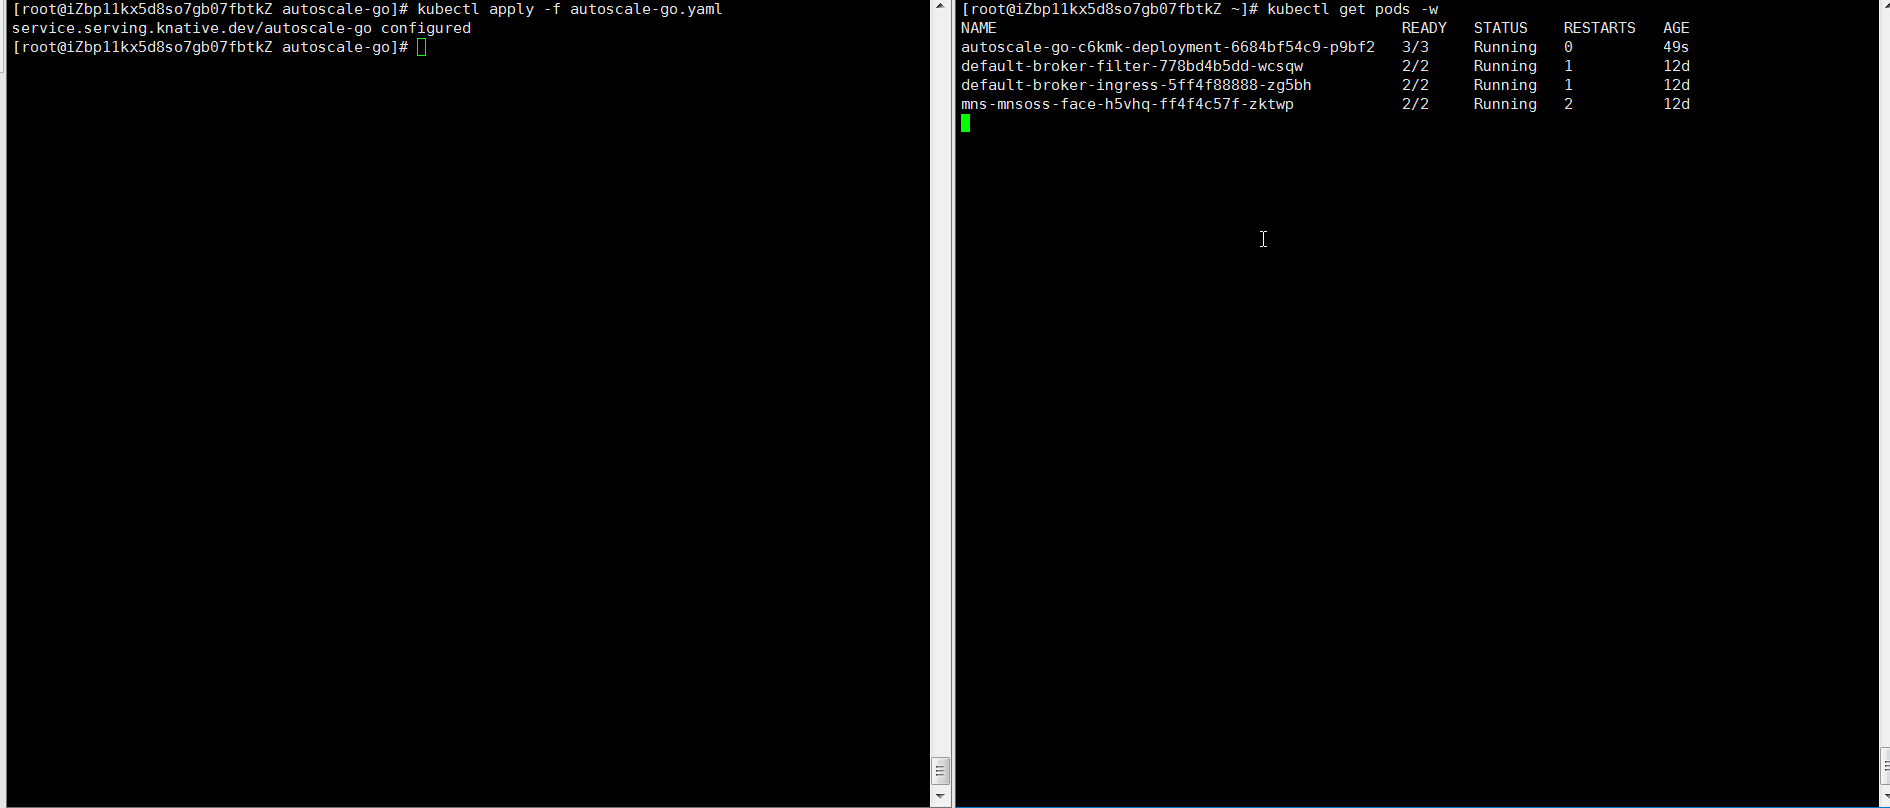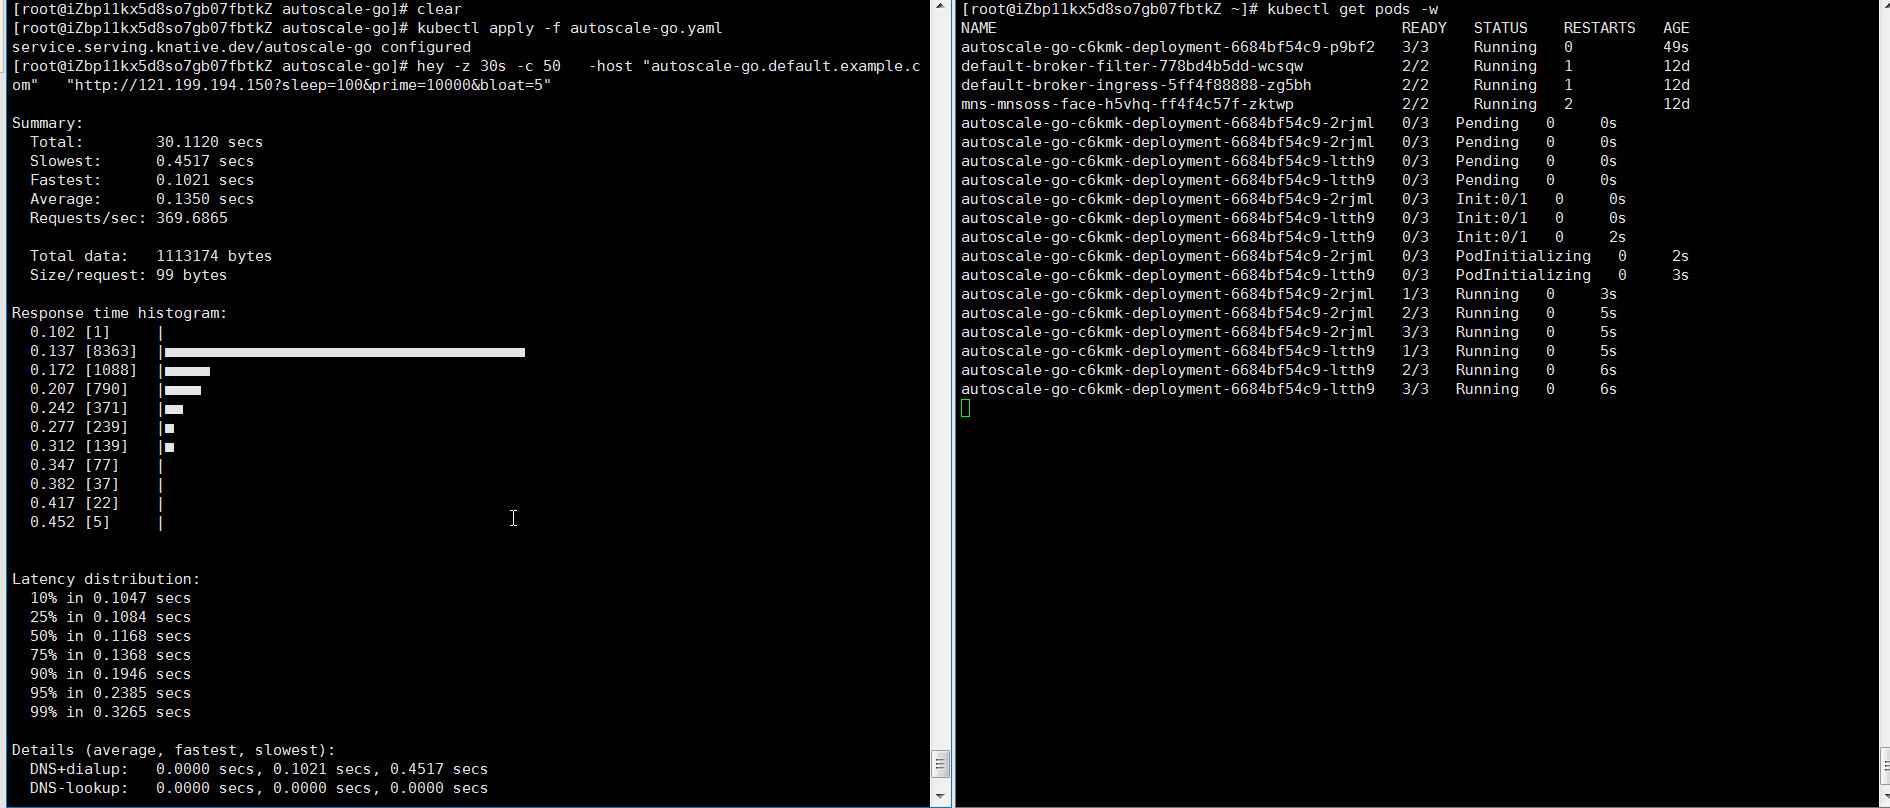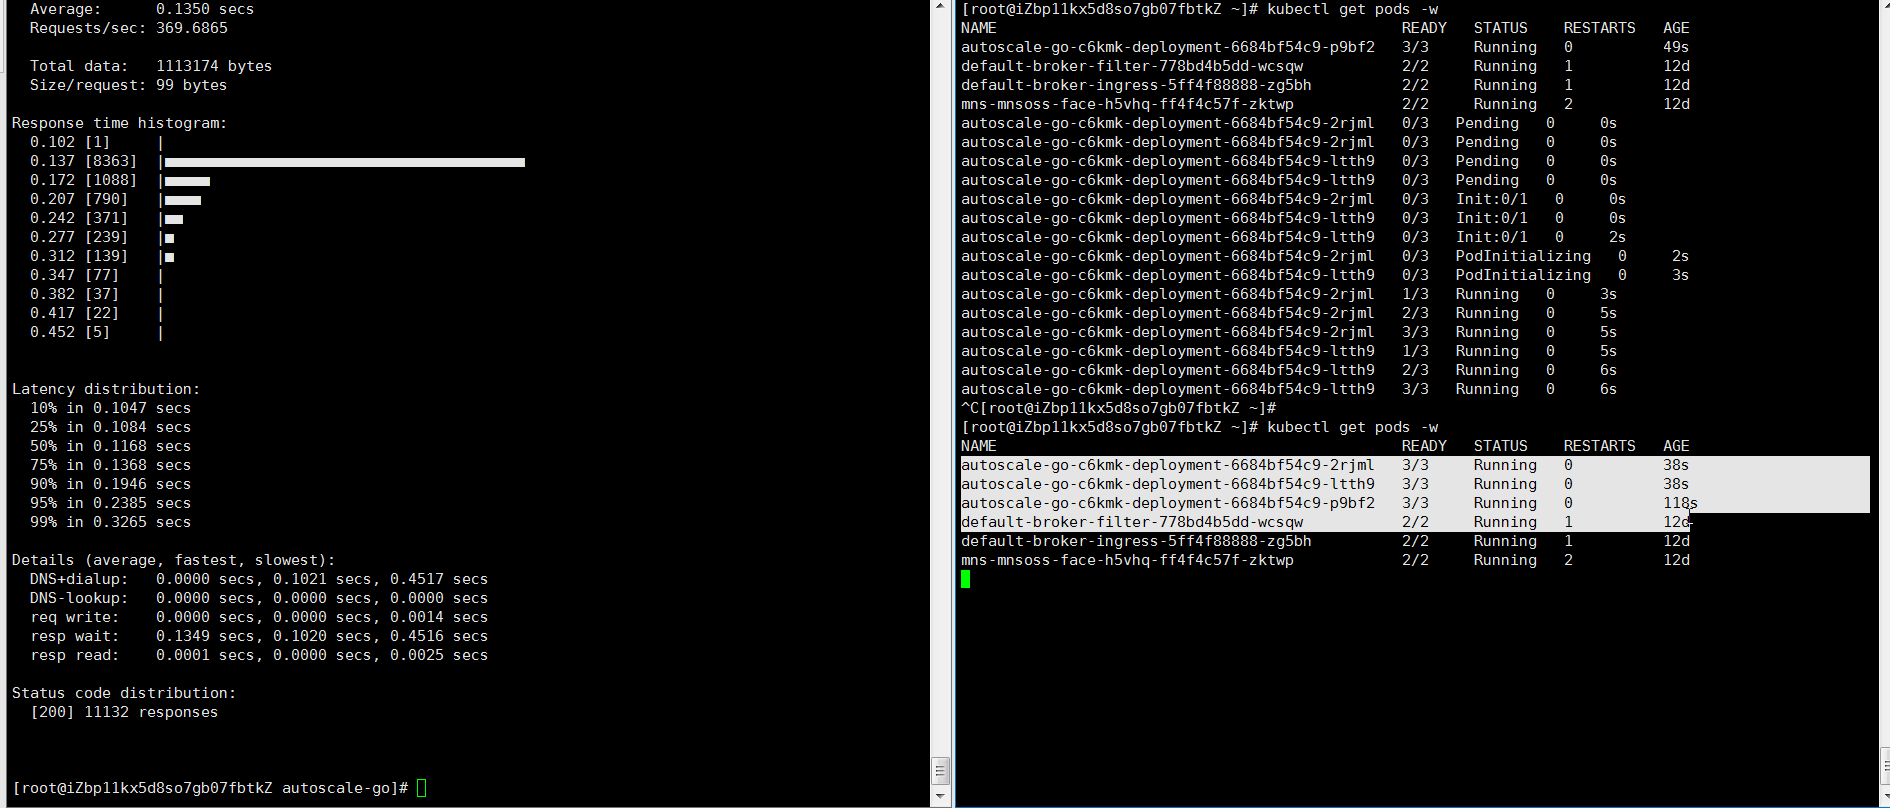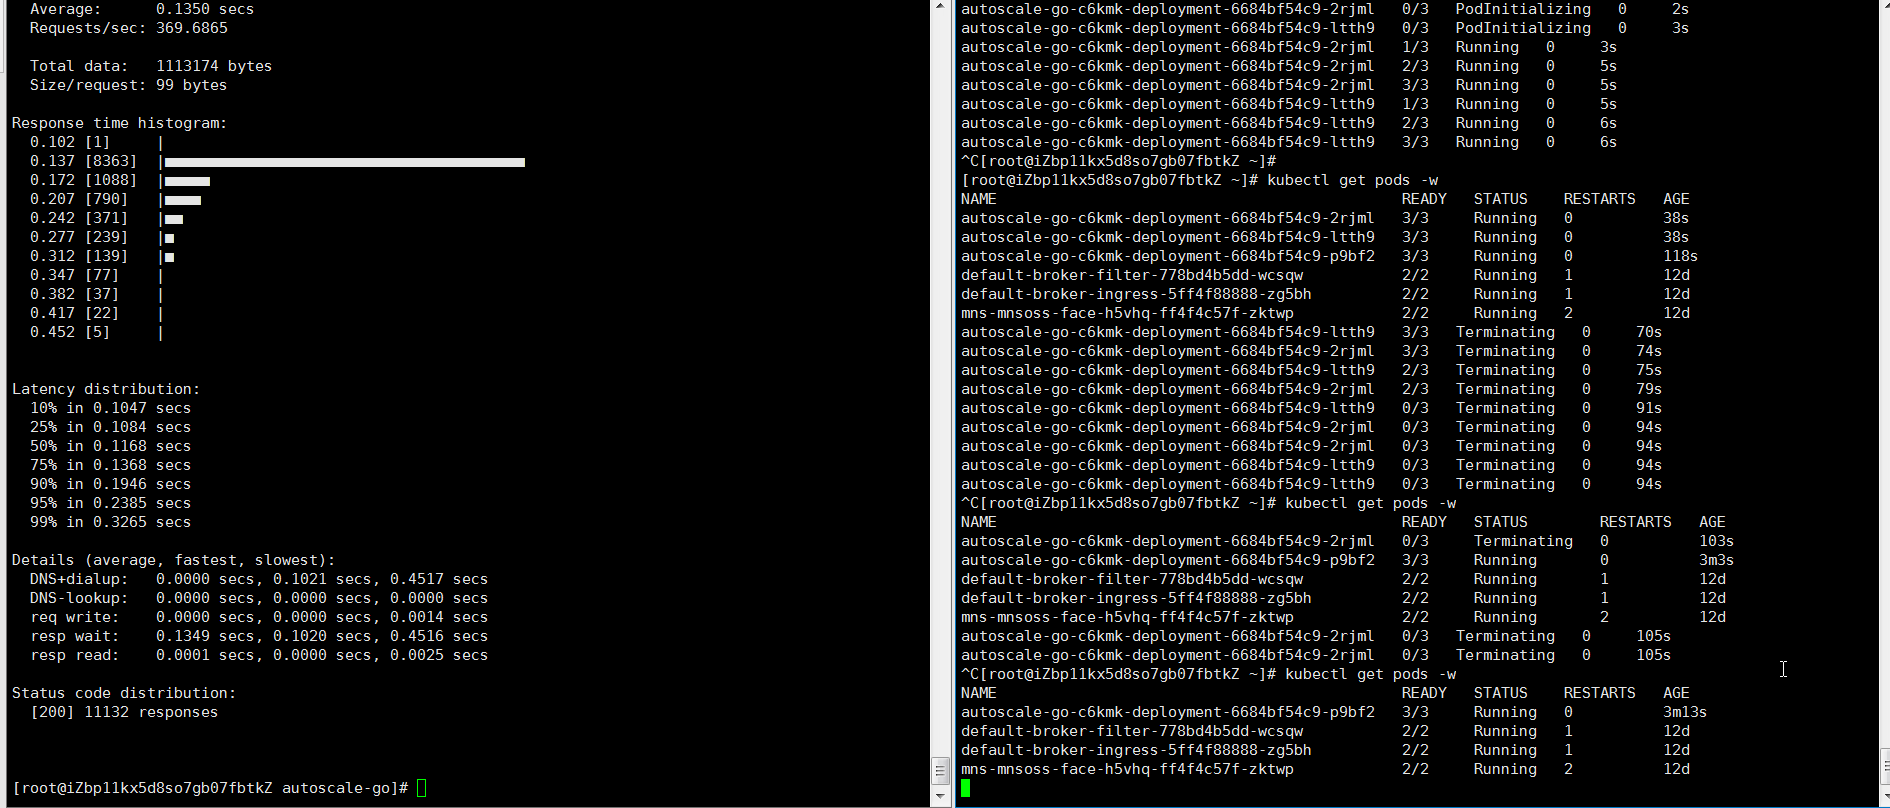
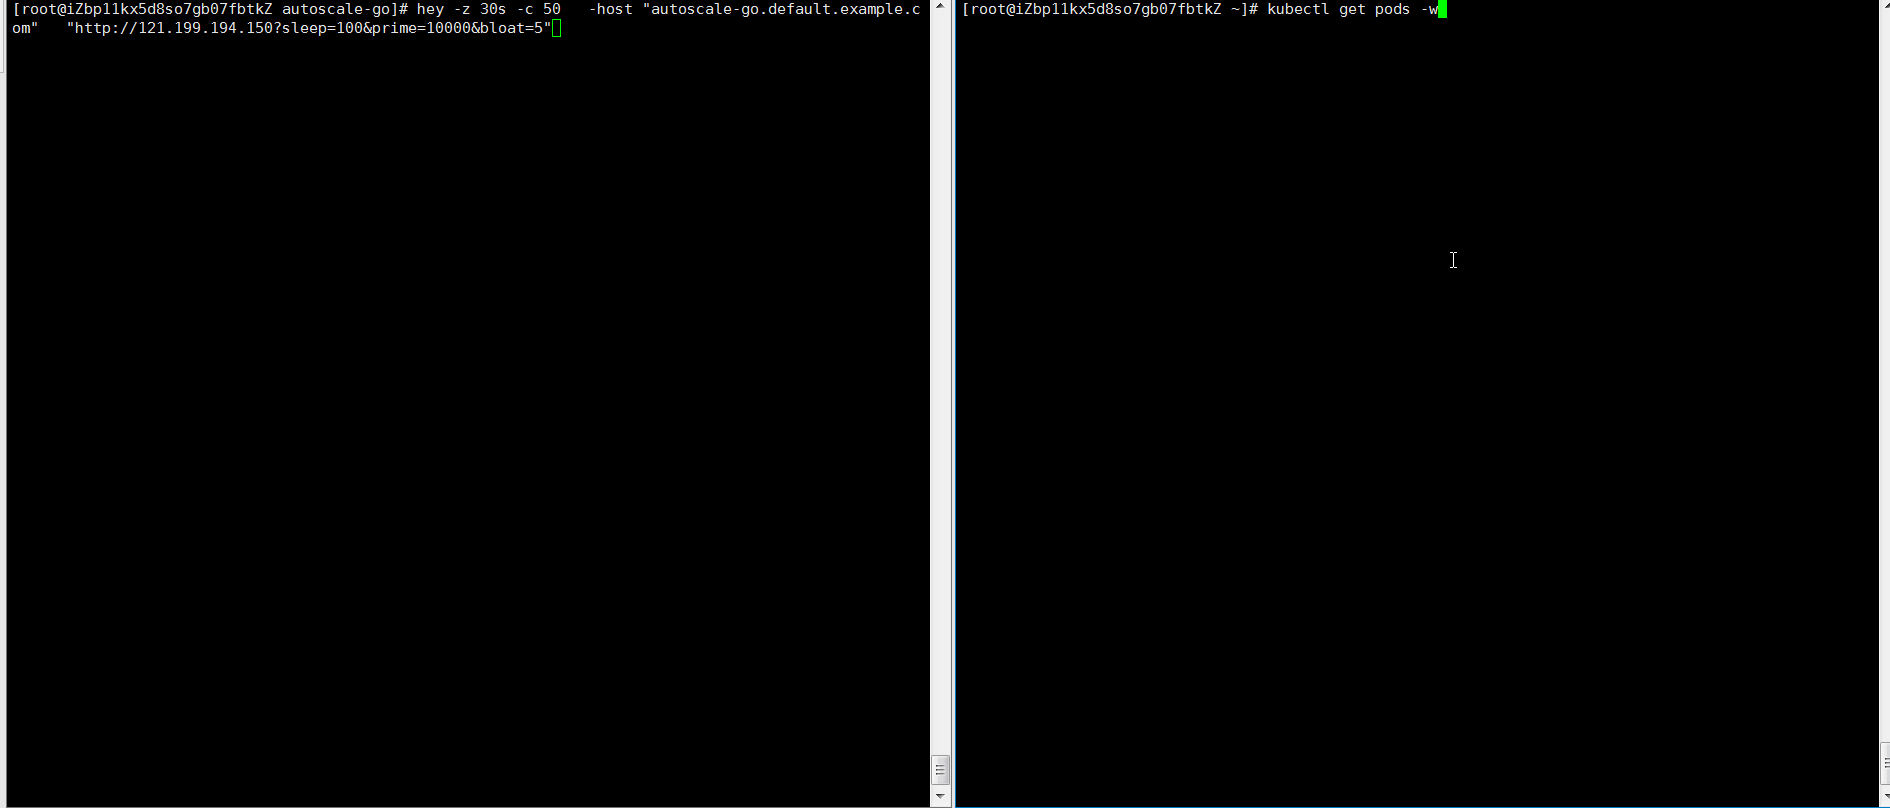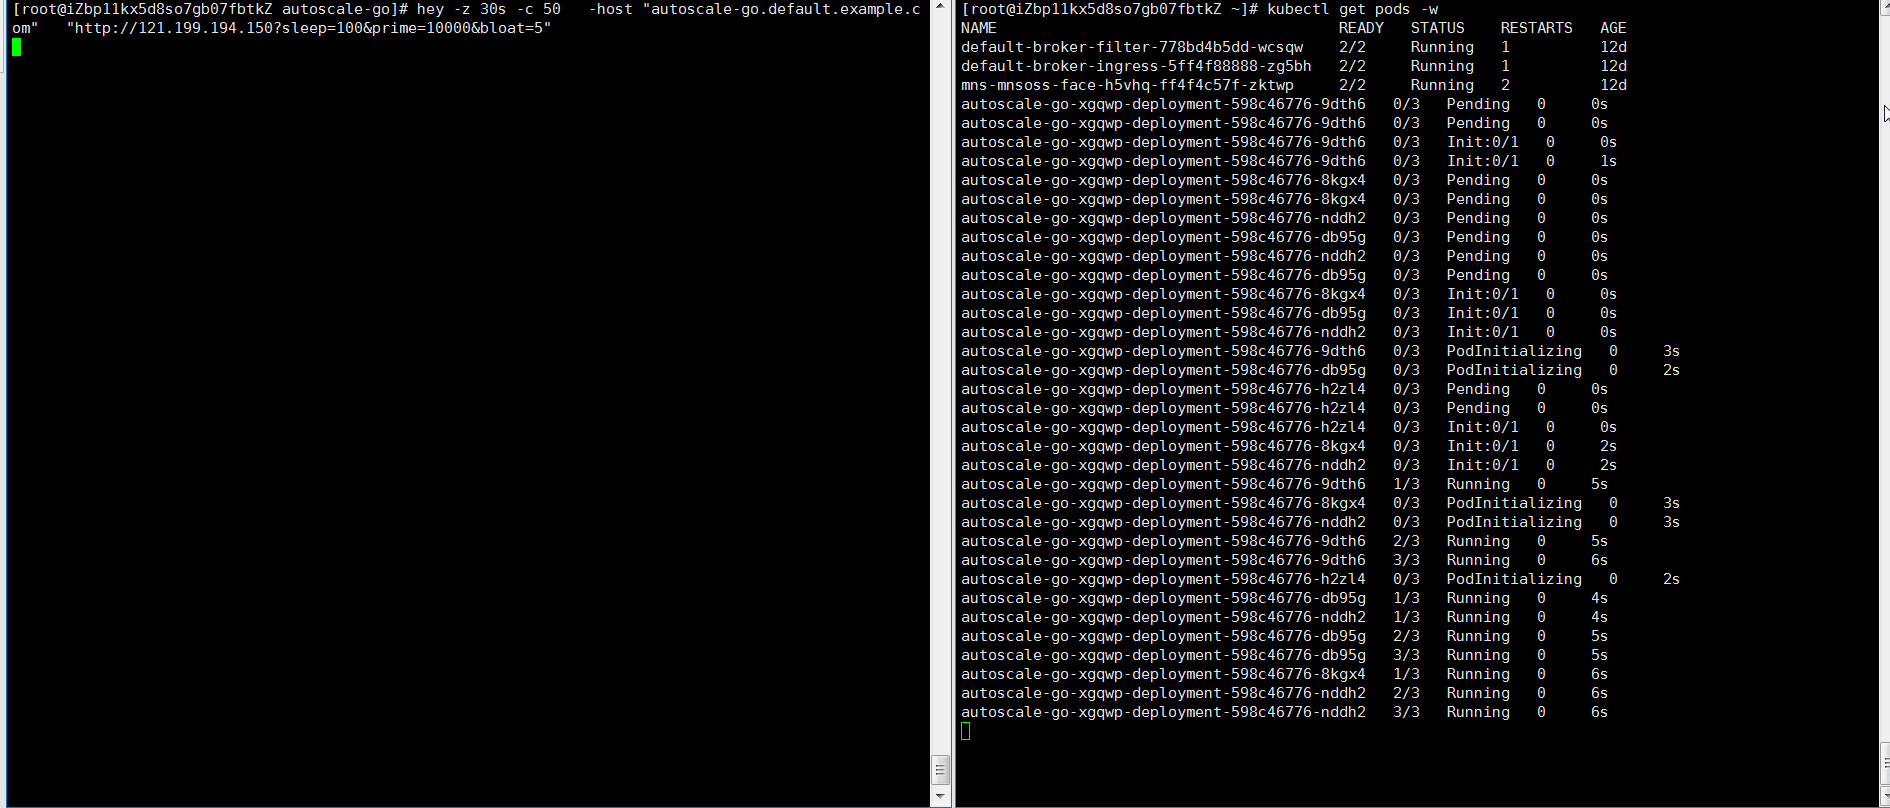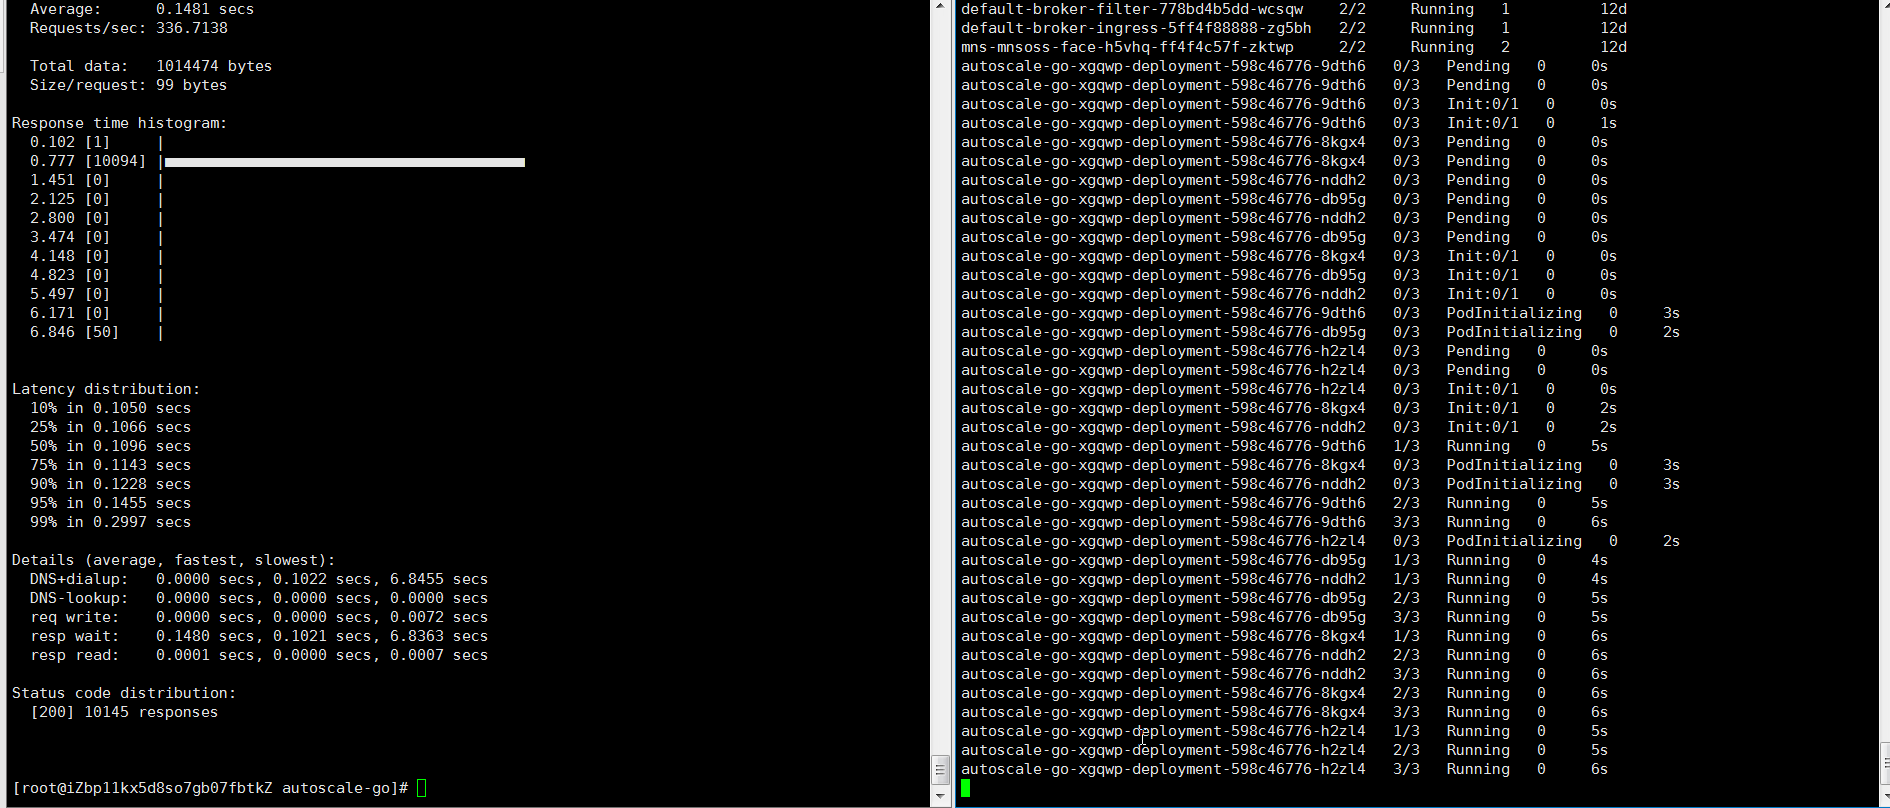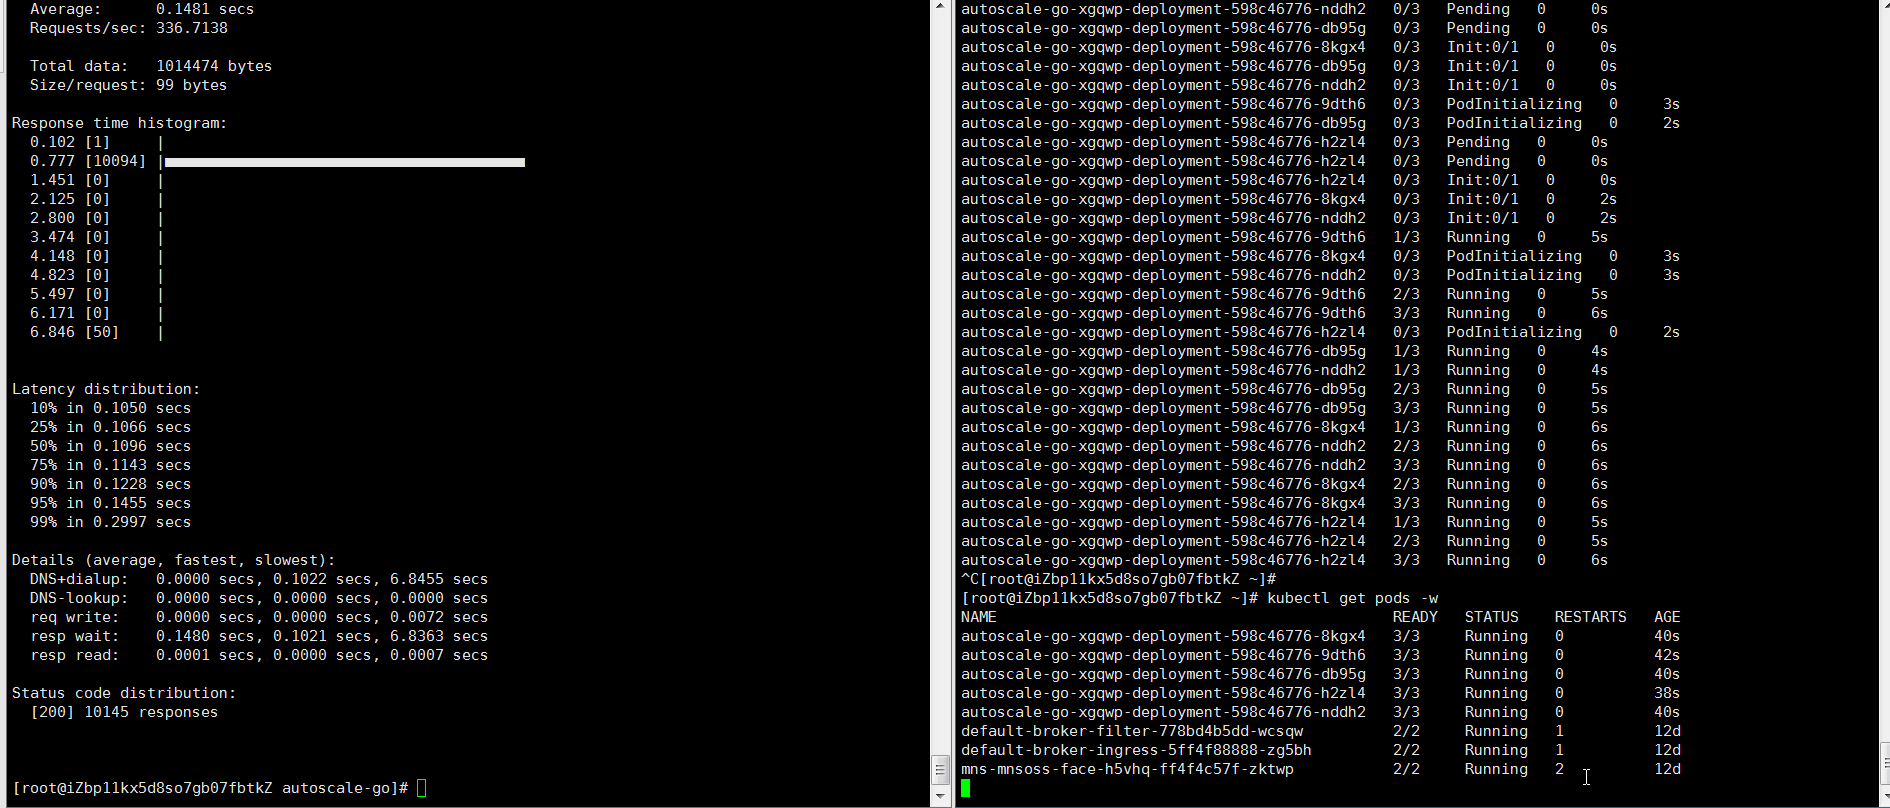
Salida esperada: KPA agrega 5 pods: 50 solicitudes concurrentes ÷ objetivo de 10 = 5 pods.
Ejemplo 2: Escalar con límites
Agregue min-scale: 1 y max-scale: 3 para mantener un pod en ejecución y limitar el despliegue a tres pods.
Deploy Knative in an ACK cluster o an ACK Serverless cluster.
-
Cree el archivo
autoscale-go.yamlcon el siguiente contenido:apiVersion: serving.knative.dev/v1 kind: Service metadata: name: autoscale-go namespace: default spec: template: metadata: labels: app: autoscale-go annotations: autoscaling.knative.dev/target: "10" autoscaling.knative.dev/min-scale: "1" # Keep at least 1 pod running autoscaling.knative.dev/max-scale: "3" # Cap at 3 pods spec: containers: - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/autoscale-go:0.1 -
Aplique el manifiesto:
kubectl apply -f autoscale-go.yaml Obtenga la dirección de la puerta de enlace Ingress (Ejemplo 1, paso 4).
-
Envíe 50 solicitudes concurrentes durante 30 segundos:
hey -z 30s -c 50 \
  -host "autoscale-go.default.example.com" \
  "http://121.199.XXX.XXX"  # Replace with your Ingress gateway address
Salida esperada: KPA escala a 3 pods (máximo) durante la carga y luego vuelve a 1 pod (mínimo), sin inicios en frío en la siguiente solicitud.