Los límites de CPU impiden que los contenedores consuman más tiempo de cómputo del que tienen asignado. Sin embargo, el kernel de Linux aplica estos límites en ciclos de programación de 100 milisegundos, por lo que un contenedor puede agotar su cuota en un solo ciclo aunque su uso promedio durante el último segundo sea bajo. Esto provoca la limitación de CPU: los hilos se suspenden hasta el siguiente ciclo, lo que añade una latencia que no aparece en las métricas a nivel de segundo.
CPU Burst soluciona este problema al permitir que los contenedores acumulen cuota de CPU no utilizada y la consuman durante picos de demanda breves. ack-koordinator monitorea los eventos de limitación y ajusta dinámicamente los parámetros de cuota del cgroup, sin modificar el límite de CPU en la especificación del pod. Esto reduce la latencia de cola para cargas de trabajo sensibles a la latencia sin necesidad de aumentar los límites de CPU de forma generalizada.
Para aprovechar al máximo este tema, familiarícese con el programador CFS y las directivas de gestión de CPU del nodo.
Funcionamiento
La CPU es un recurso de tiempo compartido. El kernel utiliza el Completely Fair Scheduler (CFS) para asignar tiempo de CPU en ciclos de programación fijos. La duración del ciclo se controla mediante cpu.cfs_period_us (generalmente 100 ms). El tiempo de CPU que un contenedor puede usar por ciclo se controla mediante cpu.cfs_quota_us. Un contenedor con un límite de CPU de 4 obtiene 400 ms de tiempo de CPU por cada ciclo de 100 ms.
El problema es que el uso de CPU presenta picos a nivel de milisegundo, incluso cuando los promedios por segundo parecen bajos. La siguiente gráfica ilustra esto: la línea morada muestra el uso de CPU por segundo manteniéndose muy por debajo de 4 núcleos, mientras que la línea verde muestra que el uso a nivel de milisegundo supera los 4 núcleos en ciertos periodos. Cuando esos picos agotan la cuota CFS, el kernel limita el contenedor.
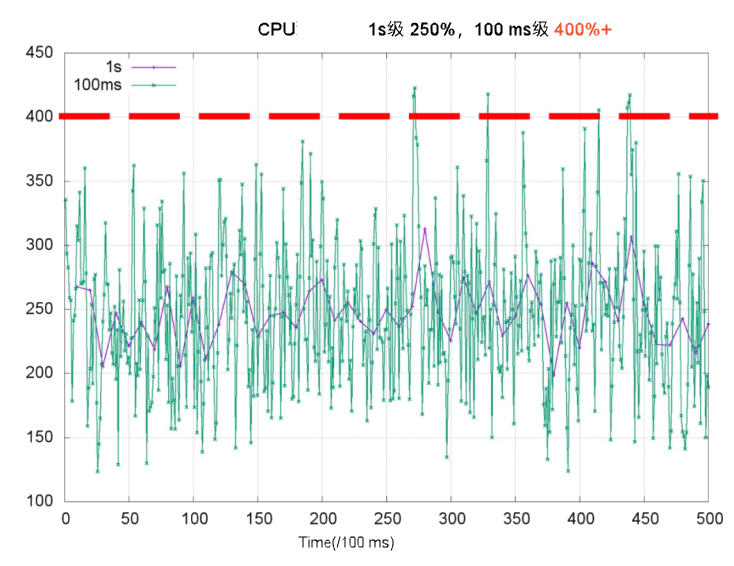
La limitación obliga a los hilos a esperar al siguiente ciclo de programación, lo que aumenta el tiempo de respuesta (RT) y causa latencia de cola larga. La siguiente tabla muestra cómo se manifiesta esto en la práctica para un contenedor de servicio web con un límite de CPU de 2 en un nodo de 4 núcleos.
<table> <thead> <tr> <td><p>Incluso cuando el uso general de CPU durante el último segundo es bajo, la limitación obliga al Hilo 2 a esperar al siguiente ciclo de programación para terminar de procesar la solicitud 2. Esto aumenta el RT de la solicitud y es una causa común de RT de cola larga.<img></p></td> <td><p>Tras habilitar CPU Burst, el contenedor acumula tiempo de CPU no utilizado y lo aprovecha durante los picos de demanda. Esto mejora el rendimiento y reduce la latencia.<img></p><p></p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <tbody></tbody> </table>
Cuando la demanda supera lo que la cuota acumulada puede cubrir, como ocurre ante un aumento repentino de tráfico, ack-koordinator resuelve el cuello de botella de CPU en segundos y mantiene la carga total del nodo dentro de límites seguros.
ack-koordinator solo ajusta el parámetro cfs quota en el cgroup del nodo. No modifica el campo de límite de CPU en la especificación del pod.
Casos de uso
Limitación a pesar de una utilización promedio baja. El uso de CPU se mantiene por debajo del límite la mayor parte del tiempo, pero los picos breves dentro de los ciclos de programación siguen desencadenando la limitación. CPU Burst permite que el contenedor consuma la cuota acumulada durante esos picos, lo que reduce la limitación y mejora la calidad del servicio.
Inicio lento debido a una inicialización intensiva en CPU. El contenedor requiere mucha CPU durante el arranque y la carga, y luego se estabiliza en un estado estacionario más bajo. CPU Burst permite que el contenedor use tiempo extra de CPU durante el inicio sin necesidad de configurar un límite de CPU permanentemente alto.
Facturación
ack-koordinator es gratuito para instalar y usar. Pueden aplicarse cargos adicionales en los siguientes dos casos:
Recursos de nodos worker: ack-koordinator es un componente no gestionado. Tras la instalación, se ejecuta en sus nodos worker y consume sus recursos. Configure las solicitudes de recursos para cada módulo durante la instalación.
Métricas de Prometheus: ack-koordinator expone métricas de perfilado de recursos y programación en formato Prometheus. Si habilita la opción Enable Prometheus monitoring metrics for ACK-Koordinator y utiliza Alibaba Cloud Prometheus, estas métricas cuentan como métricas personalizadas y generan cargos. Revise los precios de instancias de Prometheus antes de habilitar esta función y utilice consultas de uso para monitorear el consumo.
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
Un clúster administrado ACK edición Pro que ejecute Kubernetes 1.18 o posterior. Consulte Create an ACK managed cluster y Manually upgrade a cluster.
ack-koordinator versión 0.8.0 o posterior instalado en el clúster. Consulte ack-koordinator.
Utilice Alibaba Cloud Linux como sistema operativo del nodo. Su compatibilidad con CPU Burst a nivel de kernel proporciona un control de cuota más detallado. Consulte Do I need to use Alibaba Cloud Linux to enable the CPU Burst policy?.
Habilitar CPU Burst
CPU Burst se puede habilitar en tres ámbitos. La configuración en un ámbito más específico tiene prioridad: las anotaciones del pod anulan los ConfigMaps a nivel de namespace, y estos anulan el ConfigMap a nivel de clúster.
|
Ámbito |
Método |
Prioridad |
|
Pod individual |
Anotación de pod |
Más alta |
|
Namespace |
ConfigMap |
Media |
|
Todo el clúster |
ConfigMap |
Más baja |
Habilitar para un pod específico
Agregue la anotación bajo metadata en el YAML del pod. Para un Deployment u otra carga de trabajo, establezca la anotación en template.metadata en su lugar.
annotations:
  # Enable CPU Burst for this pod.
  koordinator.sh/cpuBurst: '{"policy": "auto"}'
  # Disable CPU Burst for this pod.
  koordinator.sh/cpuBurst: '{"policy": "none"}'
Habilitar para todo el clúster
-
Cree el archivo
configmap.yamlcon el siguiente contenido.apiVersion: v1 data: cpu-burst-config: '{"clusterStrategy": {"policy": "auto"}}' #cpu-burst-config: '{"clusterStrategy": {"policy": "cpuBurstOnly"}}' #cpu-burst-config: '{"clusterStrategy": {"policy": "none"}}' kind: ConfigMap metadata: name: ack-slo-config namespace: kube-system -
Aplique el ConfigMap. Utilice PATCH si
ack-slo-configya existe en el namespacekube-systempara evitar sobrescribir otras configuraciones.Si el ConfigMap existe: ``
bash kubectl patch cm -n kube-system ack-slo-config --patch "$(cat configmap.yaml)"``Si no existe: ``
bash kubectl apply -f configmap.yaml``
Habilitar para un namespace específico
-
Cree el archivo
configmap.yamlcon el siguiente contenido.apiVersion: v1 kind: ConfigMap metadata: name: ack-slo-pod-config namespace: koordinator-system # Create this namespace manually before first use. data: # Enable or disable CPU Burst for selected namespaces. cpu-burst: | { "enabledNamespaces": ["allowed-ns"], "disabledNamespaces": ["blocked-ns"] } # Enables CPU Burst for all pods in the allowed-ns namespace. Policy is auto. # Disables CPU Burst for all pods in the blocked-ns namespace. Policy is none. -
Aplique el ConfigMap. Utilice PATCH si
ack-slo-pod-configya existe en el namespacekoordinator-systempara evitar sobrescribir otras configuraciones.Si el ConfigMap existe: ``
bash kubectl patch cm -n koordinator-system ack-slo-pod-config --patch "$(cat configmap.yaml)"``Si no existe: ``
bash kubectl apply -f configmap.yaml``
Verificar con una prueba de carga
Este ejemplo utiliza un pod de Apache HTTP Server para demostrar que CPU Burst reduce la latencia de acceso.
-
Cree el archivo
apache-demo.yamlcon el siguiente contenido. La anotación habilita CPU Burst para este pod.apiVersion: v1 kind: Pod metadata: name: apache-demo annotations: koordinator.sh/cpuBurst: '{"policy": "auto"}' # Enable CPU Burst. spec: containers: - command: - httpd - -D - FOREGROUND image: registry.cn-zhangjiakou.aliyuncs.com/acs/apache-2-4-51-for-slo-test:v0.1 imagePullPolicy: Always name: apache resources: limits: cpu: "4" memory: 10Gi requests: cpu: "4" memory: 10Gi nodeName: $nodeName # Replace with the actual node name. hostNetwork: False restartPolicy: Never schedulerName: default-scheduler -
Despliegue el Apache HTTP Server.
kubectl apply -f apache-demo.yaml -
Ejecute una prueba de carga con wrk2. Reemplace
$target_ip_addresscon la dirección IP del pod de Apache.# Download and extract the open-source wrk2 tool. See https://github.com/giltene/wrk2. # The Apache image has Gzip compression enabled to simulate server-side request processing. # Adjust QPS pressure by changing the -R parameter. ./wrk -H "Accept-Encoding: deflate, gzip" -t 2 -c 12 -d 120 --latency --timeout 2s -R 24 http://$target_ip_address:8010/static/file.1m.test
Resultados
Las siguientes tablas comparan el tiempo de respuesta p99, la tasa de limitación de CPU y la utilización promedio de CPU del pod, con y sin CPU Burst, tanto en Alibaba Cloud Linux como en CentOS.
Todo deshabilitado: Directiva CPU Burst establecida en
none.Todo habilitado: Directiva CPU Burst establecida en
auto.
Los valores a continuación son teóricos. Los resultados reales dependen de su entorno.
<table> <thead> <tr> <td><p><b>Alibaba Cloud Linux</b></p></td> <td><p><b>Todo deshabilitado</b></p></td> <td><p><b>Todo habilitado</b></p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody> <tr> <td><p>RT-p99 de apache</p></td> <td><p>107.37 ms</p></td> <td><p>67.18 ms (-37.4%)</p></td> </tr> <tr> <td><p>Tasa de limitación de CPU</p></td> <td><p>33.3%</p></td> <td><p>0%</p></td> </tr> <tr> <td><p>Utilización promedio de CPU del pod</p></td> <td><p>31.8%</p></td> <td><p>32.6%</p></td> </tr> </tbody> </table><table> <thead> <tr> <td><p><b>CentOS</b></p></td> <td><p><b>Todo deshabilitado</b></p></td> <td><p><b>Todo habilitado</b></p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody> <tr> <td><p>RT-p99 de apache</p></td> <td><p>111.69 ms</p></td> <td><p>71.30 ms (-36.2%)</p></td> </tr> <tr> <td><p>Tasa de limitación de CPU</p></td> <td><p>33%</p></td> <td><p>0%</p></td> </tr> <tr> <td><p>Utilización promedio de CPU del pod</p></td> <td><p>32.5%</p></td> <td><p>33.8%</p></td> </tr> </tbody> </table>
Habilitar CPU Burst reduce el tiempo de respuesta p99 en aproximadamente un 37% y lleva la tasa de limitación de CPU al 0%, con un cambio insignificante en la utilización promedio de CPU.
Configuración avanzada
Configure los parámetros avanzados en una anotación de pod o en un ConfigMap. Las anotaciones de pod tienen prioridad, seguidas por los ConfigMaps a nivel de namespace y finalmente el ConfigMap a nivel de clúster.
# Example ConfigMap ack-slo-config.
data:
  cpu-burst-config: |
    {
      "clusterStrategy": {
        "policy": "auto",
        "cpuBurstPercent": 1000,
        "cfsQuotaBurstPercent": 300,
        "sharePoolThresholdPercent": 50,
        "cfsQuotaBurstPeriodSeconds": -1
      }
    }

# Example pod annotation.
koordinator.sh/cpuBurst: '{"policy": "auto", "cpuBurstPercent": 1000, "cfsQuotaBurstPercent": 300, "cfsQuotaBurstPeriodSeconds": -1}'Las columnas Annotation y ConfigMap indican si cada parámetro admite configuración mediante anotación de pod o ConfigMap.  significa compatible.
 significa no compatible.
<table> <thead> <tr> <td><p><b>Parámetro</b></p></td> <td><p><b>Tipo</b></p></td> <td><p><b>Descripción</b></p></td> <td><p><b>Annotation</b></p></td> <td><p><b>ConfigMap</b></p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody> <tr> <td><p><code>policy</code></p></td> <td><p>string</p></td> <td> <ul> <li><p><code>none</code> (predeterminado): Deshabilita CPU Burst. Todos los parámetros relacionados se restablecen a sus valores iniciales.</p></li> <li><p><code>cpuBurstOnly</code>: Habilita únicamente la elasticidad de CPU Burst a nivel de kernel de Alibaba Cloud Linux.</p></li> <li><p><code>cfsQuotaBurstOnly</code>: Habilita únicamente la elasticidad de cuota CFS. Funciona con todas las versiones del kernel.</p></li> <li><p><code>auto</code>: Habilita automáticamente ambas elasticidades: las funciones del kernel de Alibaba Cloud Linux y la elasticidad de cuota CFS.</p></li> </ul></td> <td><p><img></p></td> <td><p><img></p></td> </tr> <tr> <td><p><code>cpuBurstPercent</code></p></td> <td><p>int</p></td> <td><p>Predeterminado: <code>1000</code>. Unidad: porcentaje.</p><p>Para la elasticidad de CPU Burst a nivel de kernel de Alibaba Cloud Linux, este valor define cuánto amplifica CPU Burst más allá del límite de CPU. Se asigna al parámetro de cgroup <code>cpu.cfs_burst_us</code>. Para más detalles, consulte <a href="https://www.alibabacloud.com/help/en/document_detail/306980.html#task-2108025">Habilitar CPU Burst mediante la interfaz cgroup v1</a>.</p><p>Por ejemplo, con la configuración predeterminada, <code>CPU Limit = 1</code> establece <code>cpu.cfs_quota_us</code> en 100,000. Entonces <code>cpu.cfs_burst_us</code> pasa a ser 1,000,000, un aumento de 10 veces.</p></td> <td><p><img></p></td> <td><p><img></p></td> </tr> <tr> <td><p><code>cfsQuotaBurstPercent</code></p></td> <td><p>int</p></td> <td><p>Predeterminado: <code>300</code>. Unidad: porcentaje.</p><p>Cuando la elasticidad de cuota CFS está habilitada, este valor establece el aumento máximo permitido para el parámetro de cgroup <code>cpu.cfs_quota_us</code>. El valor predeterminado es 3 veces.</p></td> <td><p><img></p></td> <td><p><img></p></td> </tr> <tr> <td><p><code>cfsQuotaBurstPeriodSeconds</code></p></td> <td><p>int</p></td> <td><p>Predeterminado: <code>-1</code>. Unidad: segundos. -1 significa ilimitado.</p><p>Cuando la elasticidad de cuota CFS está habilitada, este valor define durante cuánto tiempo un pod puede consumir CPU con la cuota aumentada (<code>cfsQuotaBurstPercent</code>). Después de este periodo, el valor <code>cpu.cfs_quota_us</code> del pod se restablece a su valor original. Otros pods no se ven afectados.</p></td> <td><p><img></p></td> <td><p><img></p></td> </tr> <tr> <td><p><code>sharePoolThresholdPercent</code></p></td> <td><p>int</p></td> <td><p>Predeterminado: <code>50</code>. Unidad: porcentaje.</p><p>Cuando la elasticidad de cuota CFS está habilitada, este valor establece el umbral seguro de uso de CPU para el nodo. Si el uso supera este umbral, todos los pods con <code>cpu.cfs_quota_us</code> aumentado se restablecen a sus valores originales.</p></td> <td><p><img></p></td> <td><p><img></p></td> </tr> </tbody> </table>
Cuando
policyse establece encfsQuotaBurstOnlyoauto,cpu.cfs_quota_uscambia dinámicamente según los eventos de limitación.Durante las pruebas de estrés, monitoree el uso de CPU del pod o establezca
policyencpuBurstOnlyononepara deshabilitar el ajuste automático de la cuota CFS. Esto mantiene la elasticidad estable en producción.
Preguntas frecuentes
Usé CPU Burst con el protocolo anterior de ack-slo-manager. ¿Sigue funcionando tras actualizar a ack-koordinator?
Sí. La clave de anotación anterior era alibabacloud.com/cpuBurst. ack-koordinator es totalmente compatible con este protocolo heredado, por lo que las actualizaciones son transparentes.
El periodo de compatibilidad de ack-koordinator para la versión anterior del protocolo finalizó el 30 de julio de 2023. Actualice los parámetros de recursos de la versión anterior del protocolo a la versión más reciente.
ack-koordinator es compatible con las siguientes versiones del protocolo.
<table> <thead> <tr> <td><p><span>Versión de</span> <b>ack-koordinator</b></p></td> <td><p><b>Protocolo alibabacloud.com</b></p></td> <td><p><b>Protocolo koordinator.sh</b></p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody> <tr> <td><p>≥0.2.0</p></td> <td><p>Compatible</p></td> <td><p>No compatible</p></td> </tr> <tr> <td><p>≥0.8.0</p></td> <td><p>Compatible</p></td> <td><p>Compatible</p></td> </tr> </tbody> </table>
¿Por qué sigue ocurriendo la limitación de CPU tras habilitar CPU Burst?
La causa más común es un error de sintaxis en la configuración que impide que la directiva surta efecto. Compruebe su anotación o ConfigMap comparándolos con los ejemplos en Advanced configuration.
Si la configuración es válida, la limitación aún puede ocurrir cuando la demanda de CPU alcanza el techo definido por cfsQuotaBurstPercent. Ajuste sus valores de solicitud y límite de CPU para que se adapten mejor a las necesidades reales de la carga de trabajo.
Hay otros dos factores a considerar:
cpu.cfs_quota_usse actualiza solo después de que ack-koordinator detecta un evento de limitación, por lo que hay un pequeño retraso. En cambio,cpu.cfs_burst_usse aplica inmediatamente y responde más rápido. Para obtener mejores resultados, utilice Alibaba Cloud Linux.Cuando la utilización de CPU en todo el nodo supera
sharePoolThresholdPercent, ack-koordinator restablececpu.cfs_quota_uspara todos los pods a fin de evitar que un solo pod cause interferencias. EstablezcasharePoolThresholdPercenten un valor que refleje los patrones reales de carga de su nodo.
¿Necesito usar Alibaba Cloud Linux para habilitar la directiva CPU Burst?
CPU Burst funciona en todos los kernels de Alibaba Cloud Linux y CentOS. Se recomienda Alibaba Cloud Linux: su compatibilidad con cpu.cfs_burst_us a nivel de kernel permite que ack-koordinator proporcione una elasticidad de CPU más detallada que el simple ajuste de cuota CFS. Para más detalles, consulte Enable CPU Burst using the cgroup v1 interface.
Tras habilitar CPU Burst, ¿por qué mi aplicación reporta diferentes conteos de hilos?
ack-koordinator ajusta dinámicamente cpu.cfs_quota_us (la cuota de tiempo de CPU del contenedor para cada ciclo de programación) en respuesta a los cambios de carga. Muchas aplicaciones, incluidas las que usan Runtime.getRuntime().availableProcessors() de Java, leen cpu.cfs_quota_us para calcular los núcleos de CPU disponibles. Cuando la cuota cambia, el conteo de núcleos reportado también cambia, lo que provoca fluctuaciones en los tamaños de los pools de hilos y otros parámetros dependientes de la cuota.
Solucione esto haciendo que su aplicación lea el valor fijo de limits.cpu en la especificación del pod.
-
Inyecte
limits.cpucomo variable de entorno medianteresourceFieldRef.env: - name: CPU_LIMIT valueFrom: resourceFieldRef: resource: limits.cpu Actualice la lógica de inicio de su aplicación para que lea
CPU_LIMITal calcular y establecer el tamaño del pool de hilos. Esto mantiene estables los conteos de hilos independientemente de cómo ack-koordinator ajuste la cuota CFS.