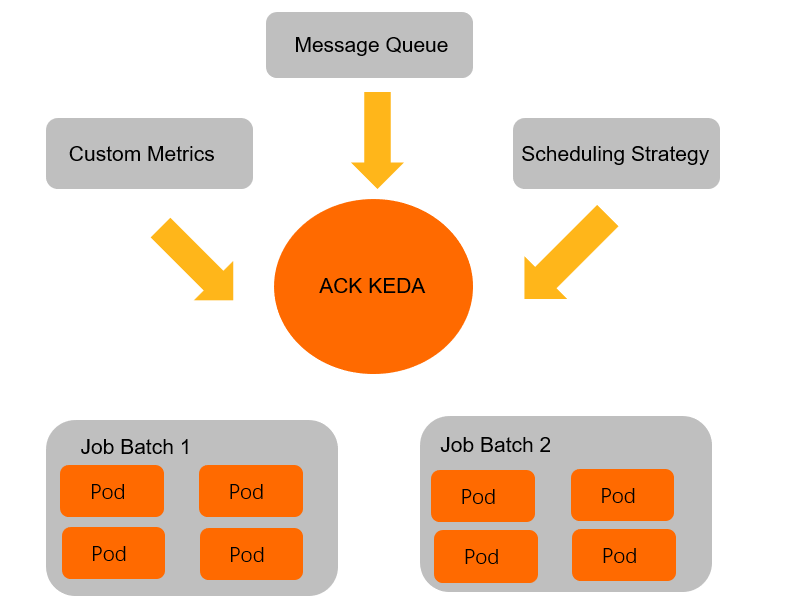
En cargas de trabajo basadas en eventos, como tareas por lotes y datos en streaming, el autoescalado horizontal de pods basado en CPU y memoria puede tener una respuesta demasiado lenta. ack-keda supervisa la acumulación de eventos en orígenes como colas de mensajes y bases de datos, crea réplicas de Jobs o Deployments en segundos y reduce la escala a cero cuando finalizan las tareas. Esto permite una programación eficiente en tiempo real y optimiza los costos.
Funcionamiento
ack-keda es una versión mejorada de KEDA (Kubernetes-based Event-driven Autoscaling) integrada con ACK. Introduce un Scaler que conecta los orígenes de eventos con las aplicaciones.

Supervisión del origen de eventos: El
Scalerse conecta a un origen de eventos externo, como MongoDB, y consulta periódicamente una métrica; por ejemplo, el recuento de documentos que cumplen ciertas condiciones.-
Control del escalado de la aplicación:
Cuando el
Scalerdetecta una acumulación de eventos (por ejemplo, datos sin procesar), ack-keda escala la carga de trabajo asociada a unScaledJoboScaledObject. Para ello, crea un Job o añade réplicas al Deployment.Si el
Scalerno detecta acumulaciones, ack-keda reduce la escala de la carga de trabajo. En el caso de los Jobs, elimina los recursos completados para evitar el desperdicio de capacidad y la acumulación de metadatos.
Capacidades principales:
Amplia compatibilidad con orígenes de eventos: Admite orígenes de datos como Apache Kafka, MySQL, PostgreSQL, RabbitMQ y MongoDB. Consulte RabbitMQ Queue.
Control flexible de la concurrencia: Utilice
maxReplicaCountpara limitar las tareas simultáneas y proteger los sistemas posteriores ante picos de tráfico.Limpieza automática de metadatos: Una vez finalizada una tarea,
ScaledJobelimina los Jobs y pods completados. Esto reduce la presión sobre el servidor de API al evitar la acumulación de metadatos.
Diferencias entre ScaledJob y ScaledObject
Utilice ScaledJob cuando cada evento corresponda a una tarea discreta y de larga duración que se ejecuta hasta completarse en su propio pod. ack-keda programa un Job por evento: lo inicializa, procesa el evento y lo finaliza. Este aislamiento evita que las tareas lentas bloqueen a otras y permite un control preciso de la concurrencia mediante maxReplicaCount.
Utilice ScaledObject cuando los eventos impulsen un rendimiento continuo y su carga de trabajo se gestione mejor mediante un pool de réplicas de Deployment de larga duración.
El siguiente tutorial utiliza ScaledJob para la transcodificación de video. Cuando se inserta un registro con "state":"waiting" en MongoDB, ack-keda crea un Job para procesar la tarea y establece el registro en "state":"finished" al finalizar. Los Jobs terminados se limpian automáticamente.
Requisitos previos
Asegúrese de cumplir con lo siguiente:
Un clúster de ACK en funcionamiento
kubectlconfigurado para conectarse al clústerPermisos suficientes para crear namespaces y desplegar charts de Helm
Paso 1: Desplegar ack-keda
En la página ACK Clusters, haga clic en el nombre de su clúster. En el panel de navegación izquierdo, seleccione Applications > Helm.
Haga clic en Create. Busque y seleccione ack-keda, elija la última versión del chart y complete la instalación.
-
Compruebe que ack-keda se esté ejecutando:
kubectl get pods -n kedaTodos los pods deben estar en estado
Runningantes de continuar.
Paso 2: Desplegar el ejemplo de autoescalado basado en eventos con MongoDB
Crear los namespaces del ejemplo
Este ejemplo utiliza el namespace mongodb para la base de datos y mongodb-test para las configuraciones de autoescalado.
kubectl create ns mongodb
kubectl create ns mongodb-test
Desplegar MongoDB
Si ya cuenta con un servicio de MongoDB, omita este paso.
-
Cree el archivo
mongoDB.yaml.ImportanteEste servicio de MongoDB es solo para fines de demostración y no cuenta con alta disponibilidad. No lo utilice en entornos de producción.
apiVersion: apps/v1 kind: Deployment metadata: name: mongodb namespace: mongodb spec: replicas: 1 selector: matchLabels: name: mongodb template: metadata: labels: name: mongodb spec: containers: - name: mongodb image: registry-cn-shanghai.ack.aliyuncs.com/acs/mongo:v5.0.0 imagePullPolicy: IfNotPresent ports: - containerPort: 27017 name: mongodb protocol: TCP --- kind: Service apiVersion: v1 metadata: name: mongodb-svc namespace: mongodb spec: type: ClusterIP ports: - name: mongodb port: 27017 targetPort: 27017 protocol: TCP selector: name: mongodb -
Despliegue MongoDB.
kubectl apply -f mongoDB.yaml
Inicializar la base de datos MongoDB
-
Obtenga el nombre del pod de MongoDB.
MONGO_POD_NAME=$(kubectl get pods -n mongodb -l name=mongodb -o jsonpath='{.items[0].metadata.name}') echo "MongoDB pod name: $MONGO_POD_NAME" -
En la base de datos
test, cree el usuariotest_usery la coleccióntest_collection.# Create user kubectl exec -n mongodb ${MONGO_POD_NAME} -- mongo --eval 'db.createUser({ user:"test_user",pwd:"test_password",roles:[{ role:"readWrite", db: "test"}]})' # Authenticate user kubectl exec -n mongodb ${MONGO_POD_NAME} -- mongo --eval 'db.auth("test_user","test_password")' # Create collection kubectl exec -n mongodb ${MONGO_POD_NAME} -- mongo test --eval 'db.createCollection("test_collection")'
Configurar TriggerAuthentication y ScaledJob
ack-keda utiliza TriggerAuthentication para gestionar de forma segura las credenciales del origen de eventos. ScaledJob define las reglas de escalado, los intervalos de sondeo y la plantilla del Job.
El siguiente archivo combina los tres recursos: Secret, TriggerAuthentication y ScaledJob.
-
Cree el archivo
keda-mongodb.yaml. La referenciasecretTargetRefenTriggerAuthenticationlee la cadena de conexión del Secret para la autenticación en MongoDB. LaqueryenScaledJobactiva la creación de Jobs cuando los documentos entest_collectioncoinciden con{"type":"mp4","state":"waiting"}.apiVersion: v1 kind: Secret metadata: name: mongodb-secret namespace: mongodb-test type: Opaque data: # Base64-encoded value of: # mongodb://test_user:test_password@mongodb-svc.mongodb.svc.cluster.local:27017/test connect: bW9uZ29kYjovL3Rlc3RfdXNlcjp0ZXN0X3Bhc3N3b3JkQG1vbmdvZGItc3ZjLm1vbmdvZGIuc3ZjLmNsdXN0ZXIubG9jYWw6MjcwMTcvdGVzdA== --- apiVersion: keda.sh/v1alpha1 kind: TriggerAuthentication metadata: name: mongodb-trigger namespace: mongodb-test spec: secretTargetRef: - parameter: connectionString name: mongodb-secret key: connect --- apiVersion: keda.sh/v1alpha1 kind: ScaledJob metadata: name: mongodb-job namespace: mongodb-test spec: jobTargetRef: template: spec: containers: - name: mongo-update image: registry-cn-shanghai.ack.aliyuncs.com/acs/mongo-update:v6 args: - --dataBase=test - --collection=test_collection - --operation=updateMany - --update={"$set":{"state":"finished"}} env: - name: MONGODB_CONNECTION_STRING value: mongodb://test_user:test_password@mongodb-svc.mongodb.svc.cluster.local:27017/test imagePullPolicy: IfNotPresent restartPolicy: Never backoffLimit: 1 pollingInterval: 15 # Check MongoDB every 15 seconds maxReplicaCount: 5 # Run at most 5 concurrent Jobs successfulJobsHistoryLimit: 0 # Delete completed Jobs immediately failedJobsHistoryLimit: 10 # Keep the last 10 failed Jobs for debugging triggers: - type: mongodb metadata: dbName: test collection: test_collection query: '{"type":"mp4","state":"waiting"}' # Launch a Job for each matching document queryValue: "1" authenticationRef: name: mongodb-trigger -
Despliegue la configuración.
kubectl apply -f keda-mongodb.yaml
Paso 3: Simular eventos y comprobar el autoescalado
-
Inserte cinco registros de transcodificación pendientes en MongoDB.
MONGO_POD_NAME=$(kubectl get pods -n mongodb -l name=mongodb -o jsonpath='{.items[0].metadata.name}') # Insert 5 pending transcoding records kubectl exec -n mongodb ${MONGO_POD_NAME} -- mongo test --eval 'db.test_collection.insert([ {"type":"mp4","state":"waiting","createTimeStamp":"1610352740","fileName":"My Love"}, {"type":"mp4","state":"waiting","createTimeStamp":"1610350740","fileName":"Harker"}, {"type":"mp4","state":"waiting","createTimeStamp":"1610152940","fileName":"The World"}, {"type":"mp4","state":"waiting","createTimeStamp":"1610390740","fileName":"Mother"}, {"type":"mp4","state":"waiting","createTimeStamp":"1610344740","fileName":"Jagger"} ])' -
Supervise los recursos Job en el namespace
mongodb-test.watch kubectl get job -n mongodb-testEn un intervalo de sondeo (15 segundos), se crean cinco Jobs que se limpian tras completarse:
NAME STATUS COMPLETIONS DURATION AGE mongodb-job-4wxgx Complete 1/1 3s 10s mongodb-job-9bs8r Complete 1/1 3s 10s mongodb-job-p6pnb Complete 1/1 3s 10s mongodb-job-pshkv Complete 1/1 4s 10s mongodb-job-t6fs8 Complete 1/1 4s 10s -
Confirme que todos los registros estén marcados como finalizados.
MONGO_POD_NAME=$(kubectl get pods -n mongodb -l name=mongodb -o jsonpath='{.items[0].metadata.name}')
kubectl exec -n mongodb ${MONGO_POD_NAME} -- mongo test --eval 'db.test_collection.find({"type":"mp4"}).pretty()'
Todos los registros cambian de
waitingafinished, lo que confirma que cada Job procesó su tarea correctamente.