โดย Farruh
ชุดข้อมูลคือหัวใจสำคัญของปัญญาประดิษฐ์ โดยเฉพาะอย่างยิ่งในการฝึกโมเดลภาษาขนาดใหญ่ (Large Language Model หรือ LLM) ที่เป็นตัวขับเคลื่อนทุกสิ่งอย่างตั้งแต่แชทบอทไปจนถึงเครื่องมือสร้างเนื้อหา ชุดข้อมูลเหล่านี้ประกอบเป็นรากฐานที่โมเดล AI ใช้เรียนรู้และพัฒนาขีดความสามารถของโมเดล อย่างไรก็ตาม ขณะที่มีความต้องการที่จะใช้ระบบ AI ขั้นสูงยิ่งขึ้นมากขึ้นเรื่อยๆ ความจำเป็นที่จะต้องมีชุดข้อมูลคุณภาพสูง หลากหลาย และครอบคลุมจึงเพิ่มขึ้นเช่นกัน บทความนี้จะเจาะลึกเกี่ยวกับประวัติการใช้ชุดข้อมูล ประเภทของข้อมูลที่จำเป็นในระยะต่างๆ ของการฝึก LLM และความท้าทายที่พบในการจัดหาและการใช้ชุดข้อมูลเหล่านี้
ในยุคแรกเริ่มในการศึกษาวิจัยด้าน AI ชุดข้อมูลผ่านการคัดสรรอย่างพิถีพิถันจากแหล่งที่มาต่างๆ เช่น สารานุกรม บทสำเนาของรัฐสภา บันทึกการโทรศัพท์ และการพยากรณ์อากาศ ชุดข้อมูลแต่ละชุดผ่านการปรับให้เหมาะกับงานที่เฉพาะเจาะจงเพื่อรับรองความเกี่ยวข้องและคุณภาพ อย่างไรก็ตาม เมื่อ Transformer ถือกำเนิดขึ้นมาในปี 2017 ซึ่งเป็นสถาปัตยกรรมนิวรัลเน็ตเวิร์กอันสำคัญยิ่งต่อโมเดลภาษาขนาดใหญ่ จุดมุ่งเน้นจึงเบนไปยังปริมาณโดยสมบูรณ์ จึงทำให้เกิดการเปลี่ยนแปลงครั้งสำคัญในแนวทางการศึกษาวิจัยด้าน AI นักวิจัยตระหนักว่าประสิทธิภาพของ LLM ดีขึ้นอย่างมีนัยสำคัญเมื่อใช้โมเดลและชุดข้อมูลขนาดใหญ่ขึ้น ซึ่งนำไปสู่การดึงข้อมูลโดยไม่เลือกเฟ้นจากอินเทอร์เน็ต
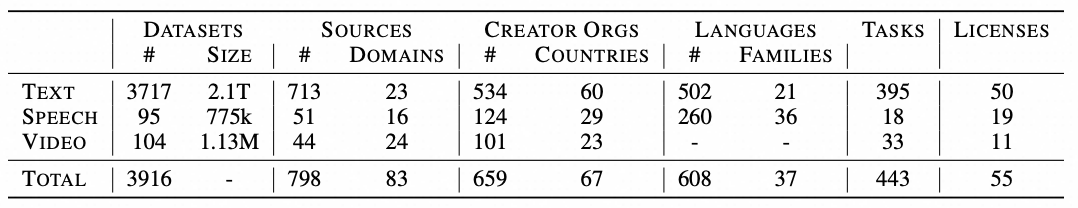
ภายในปี 2018 อินเทอร์เน็ตได้กลายเป็นแหล่งที่มาหลักของข้อมูลทุกประเภท รวมถึงเสียง รูปภาพ และวิดีโอ แนวโน้มยังคงเป็นเช่นนี้มาอย่างต่อเนื่อง จึงก่อให้เกิดความไม่สอดคล้องกันในปริมาณมากระหว่างข้อมูลที่ได้มาจากอินเทอร์เน็ตและชุดข้อมูลที่คัดสรรด้วยตนเอง ความต้องการที่จะขยับขยายการใช้งานยังนำไปสู่การใช้ข้อมูลสังเคราะห์อย่างแพร่หลาย ซึ่งเป็นข้อมูลที่สร้างโดยอัลกอรึทึมมากกว่าการรวบรวมมาจากการโต้ตอบใช้ชีวิตจริง
การฝึกล่วงหน้าเป็นระยะแรกเริ่มที่โมเดลได้รับข้อมูลรูปแบบข้อความในปริมาณมหาศาลเพื่อเรียนรู้รูปแบบและโครงสร้างภาษาทั่วไป ในระยะนี้ โมเดลจำเป็นต้องมีสิ่งต่อไปนี้
อย่างไรก็ตาม ข้อควรพิจารณาด้านจริยธรรมถือกำเนิดขึ้นเมื่อใช้สื่อที่มีลิขสิทธิ์โดยไม่ได้รับอนุญาต
การฝึกล่วงหน้าอย่างต่อเนื่องเป็นการอัปเดตโมเดลโดยใช้ข้อมูลใหม่ๆ เพื่อให้โมเดลเป็นปัจจุบันและปรับปรุงฐานความรู้ของโมเดล ระยะนี้จำเป็นต้องใช้สิ่งต่อไปนี้
การปรับละเอียดจะปรับโมเดลที่ผ่านการฝึกอบรมล่วงหน้าให้เหมาะกับงานหรือขอบเขตหัวข้อที่เฉพาะเจาะจง โดยทั่วไปจะใช้ชุดข้อมูลที่มีขนาดเล็กกว่า มุ่งเป้าเจาะจงมากกว่า รวมทั้งมีการกำกับประเภทและผ่านการคัดสรรอย่างละเอียดถี่ถ้วนมากกว่า ตัวอย่างเช่น
ด้านล่างนี้เป็นตัวอย่างของชุดข้อมูลและวิธีที่ใช้ในกระบวนการนี้
เมื่อรวมชุดข้อมูลที่คัดสรรมากับวิธีการขั้นสูงอย่าง PEFT นักวิจัยและนักพัฒนาจึงสามารถปรับ LLM ให้เหมาะกับการใช้งานเฉพาะด้านในขณะที่ยังคงจัดการกับข้อจำกัดด้านทรัพยากรและความท้าทายด้านการปรับขนาดได้
การเรียนรู้เสริมจากข้อเสนอแนะของมนุษย์ (RLHF) เป็นการฝึกโมเดลเพื่อให้สอดคล้องกับความต้องการของมนุษย์ได้ดีขึ้น ระยะนี้จำเป็นต้องใช้สิ่งต่อไปนี้
ด้านล่างนี้เป็นตัวอย่างของชุดข้อมูลและวิธีการที่สำคัญต่อ RLHF
ชุดข้อมูลความต้องการ: RLHF จะเริ่มต้นจากการรวบรวมข้อมูลความต้องการที่มีการกำกับประเภทโดยมนุษย์ โดยที่มีมนุษย์จัดลำดับหรือให้คะแนนเอาต์พุตของโมเดล ตัวอย่างเช่น การทดลองด้าน RLHF แรกๆ ของ OpenAI ใช้ชุดข้อมูลที่ผู้จัดทำข้อมูลประกอบเปรียบเทียบการตอบกลับที่โมเดลสร้างขึ้นหลายรายการต่อพรอมต์เดียวกัน โดยกำกับประเภทว่ารายการใดเป็นประโยชน์ ตรงตามความจริง หรือสอดคล้องกับแนวทางด้านจริยธรรมมากกว่า ชุดข้อมูลเหล่านี้มักมีตัวอย่างที่แตกต่างเพียงเล็กน้อย เช่น การจำแนกความแตกต่างระหว่างคำตอบที่เป็นข้อเท็จจริงและคำตอบที่เอนเอียงในหัวข้อที่ละเอียดอ่อนอย่างการเมืองหรือการดูแลสุขภาพ
เมื่อใช้ชุดข้อมูลความต้องการ การจำลองโมเดลรางวัล และการให้ข้อเสนอแนะซ้ำๆ โดยมนุษย์ร่วมกัน RLHF จะรับรองให้แน่ใจได้ว่า LLM จะพัฒนาจากการเป็นตัวสร้างข้อความทั่วไปเป็นระบบที่มุ่งเน้นให้ความสำคัญด้านความปลอดภัย ความเกี่ยวข้อง และความสอดคล้องกับความต้องการของมนุษย์
ปัญหาเร่งด่วนข้อหนึ่งในปัจจุบันคือการใช้ข้อมูลข้อความที่มีพร้อมให้ใช้งานจนหมดสิ้น โดยมีการรายงานว่าบริษัทเทคโนโลยียักษ์ใหญ่รายต่างๆ ได้จัดทำดัชนีข้อมูลข้อความที่เข้าถึงได้จากเว็บแบบเปิดและดาร์กเว็บจนหมดแล้ว รวมถึงหนังสือที่ละเมิดลิขสิทธิ์ คำบรรยายภาพยนตร์ ข้อความส่วนตัว และโพสต์บนโซเชียลมีเดีย เมื่อมีแหล่งข้อมูลใหม่ๆ ให้ใช้งานน้อยลง อุตสาหกรรมนี้จึงประสบกับอุปสรรคในการพัฒนาให้ก้าวหน้าต่อไป
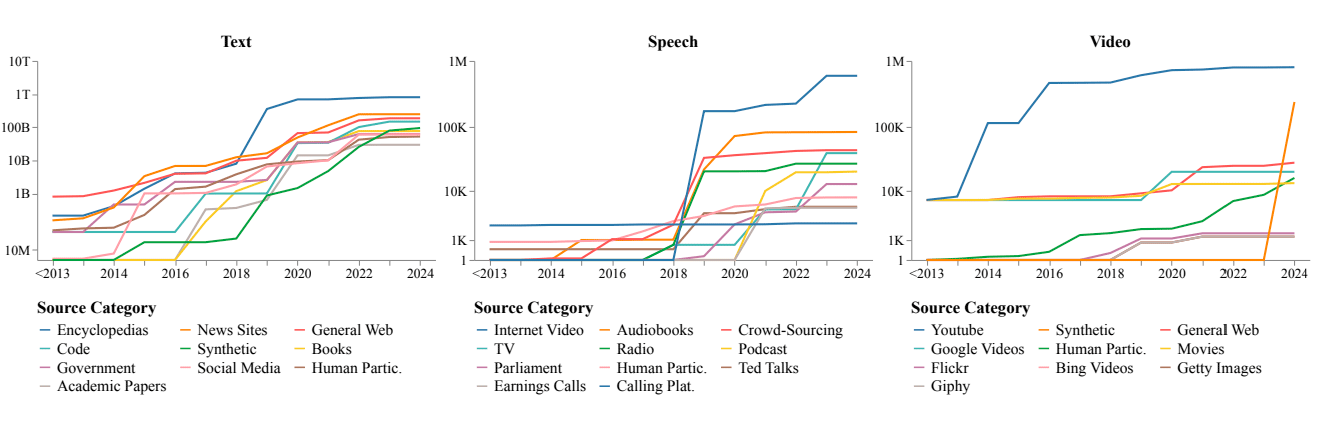
ปริมาณข้อมูลที่สะสม (ในระดับอัลกอริทึมสำหรับข้อความ, ในหลักชั่วโมงสำหรับเสียงพูด/วิดีโอ) จากหมวดหมู่แหล่งที่มาแต่ละรายการในทุกรูปแบบข้อมูล หมวดหมู่แหล่งที่มาในคำอธิบายสัญลักษณ์จะเรียงลำดับตามปริมาณจากมากไปหาน้อย
ชุดข้อมูลส่วนใหญ่มาจากยุโรปและอเมริกาเหนือ ด้วยเหตุนี้จึงสะท้อนมุมมองโลกทัศน์ที่มุ่งเน้นตามค่านิยมตะวันตก ชุดข้อมูลที่ผ่านการวิเคราะห์ไม่ถึง 4% มาจากแอฟริกา ซึ่งเป็นการเน้นย้ำถึงการขาดดุลยภาพทางวัฒนธรรมอย่างมาก ความเอนเอียงเช่นนี้อาจนำไปสู่ความรู้ความเข้าใจที่บิดเบือนและยิ่งก่อให้เกิดการเหมารวม โดยเฉพาะอย่างยิ่งในโมเดลที่รองรับข้อมูลหลายรูปแบบที่สร้างรูปภาพและวิดีโอ
องค์กรขนาดใหญ่เป็นเจ้าของและควบคุมชุดข้อมูลที่มีอิทธิพล แพลตฟอร์มต่างๆ เช่น YouTube มีข้อมูลวิดีโอกว่า 70% ที่ถูกนำไปใช้ในการฝึก AI ซึ่งเป็นการรวมอำนาจมหาศาลไว้ในการควบคุมขององค์กรเพียงไม่กี่องค์กร การรวมศูนย์อำนาจเช่นนี้ขัดขวางนวัตกรรมและก่อให้เกิดอุปสรรคสำหรับบริษัทรายเล็กๆ ที่ไม่สามารถเข้าถึงแหล่งข้อมูลเหล่านี้ได้
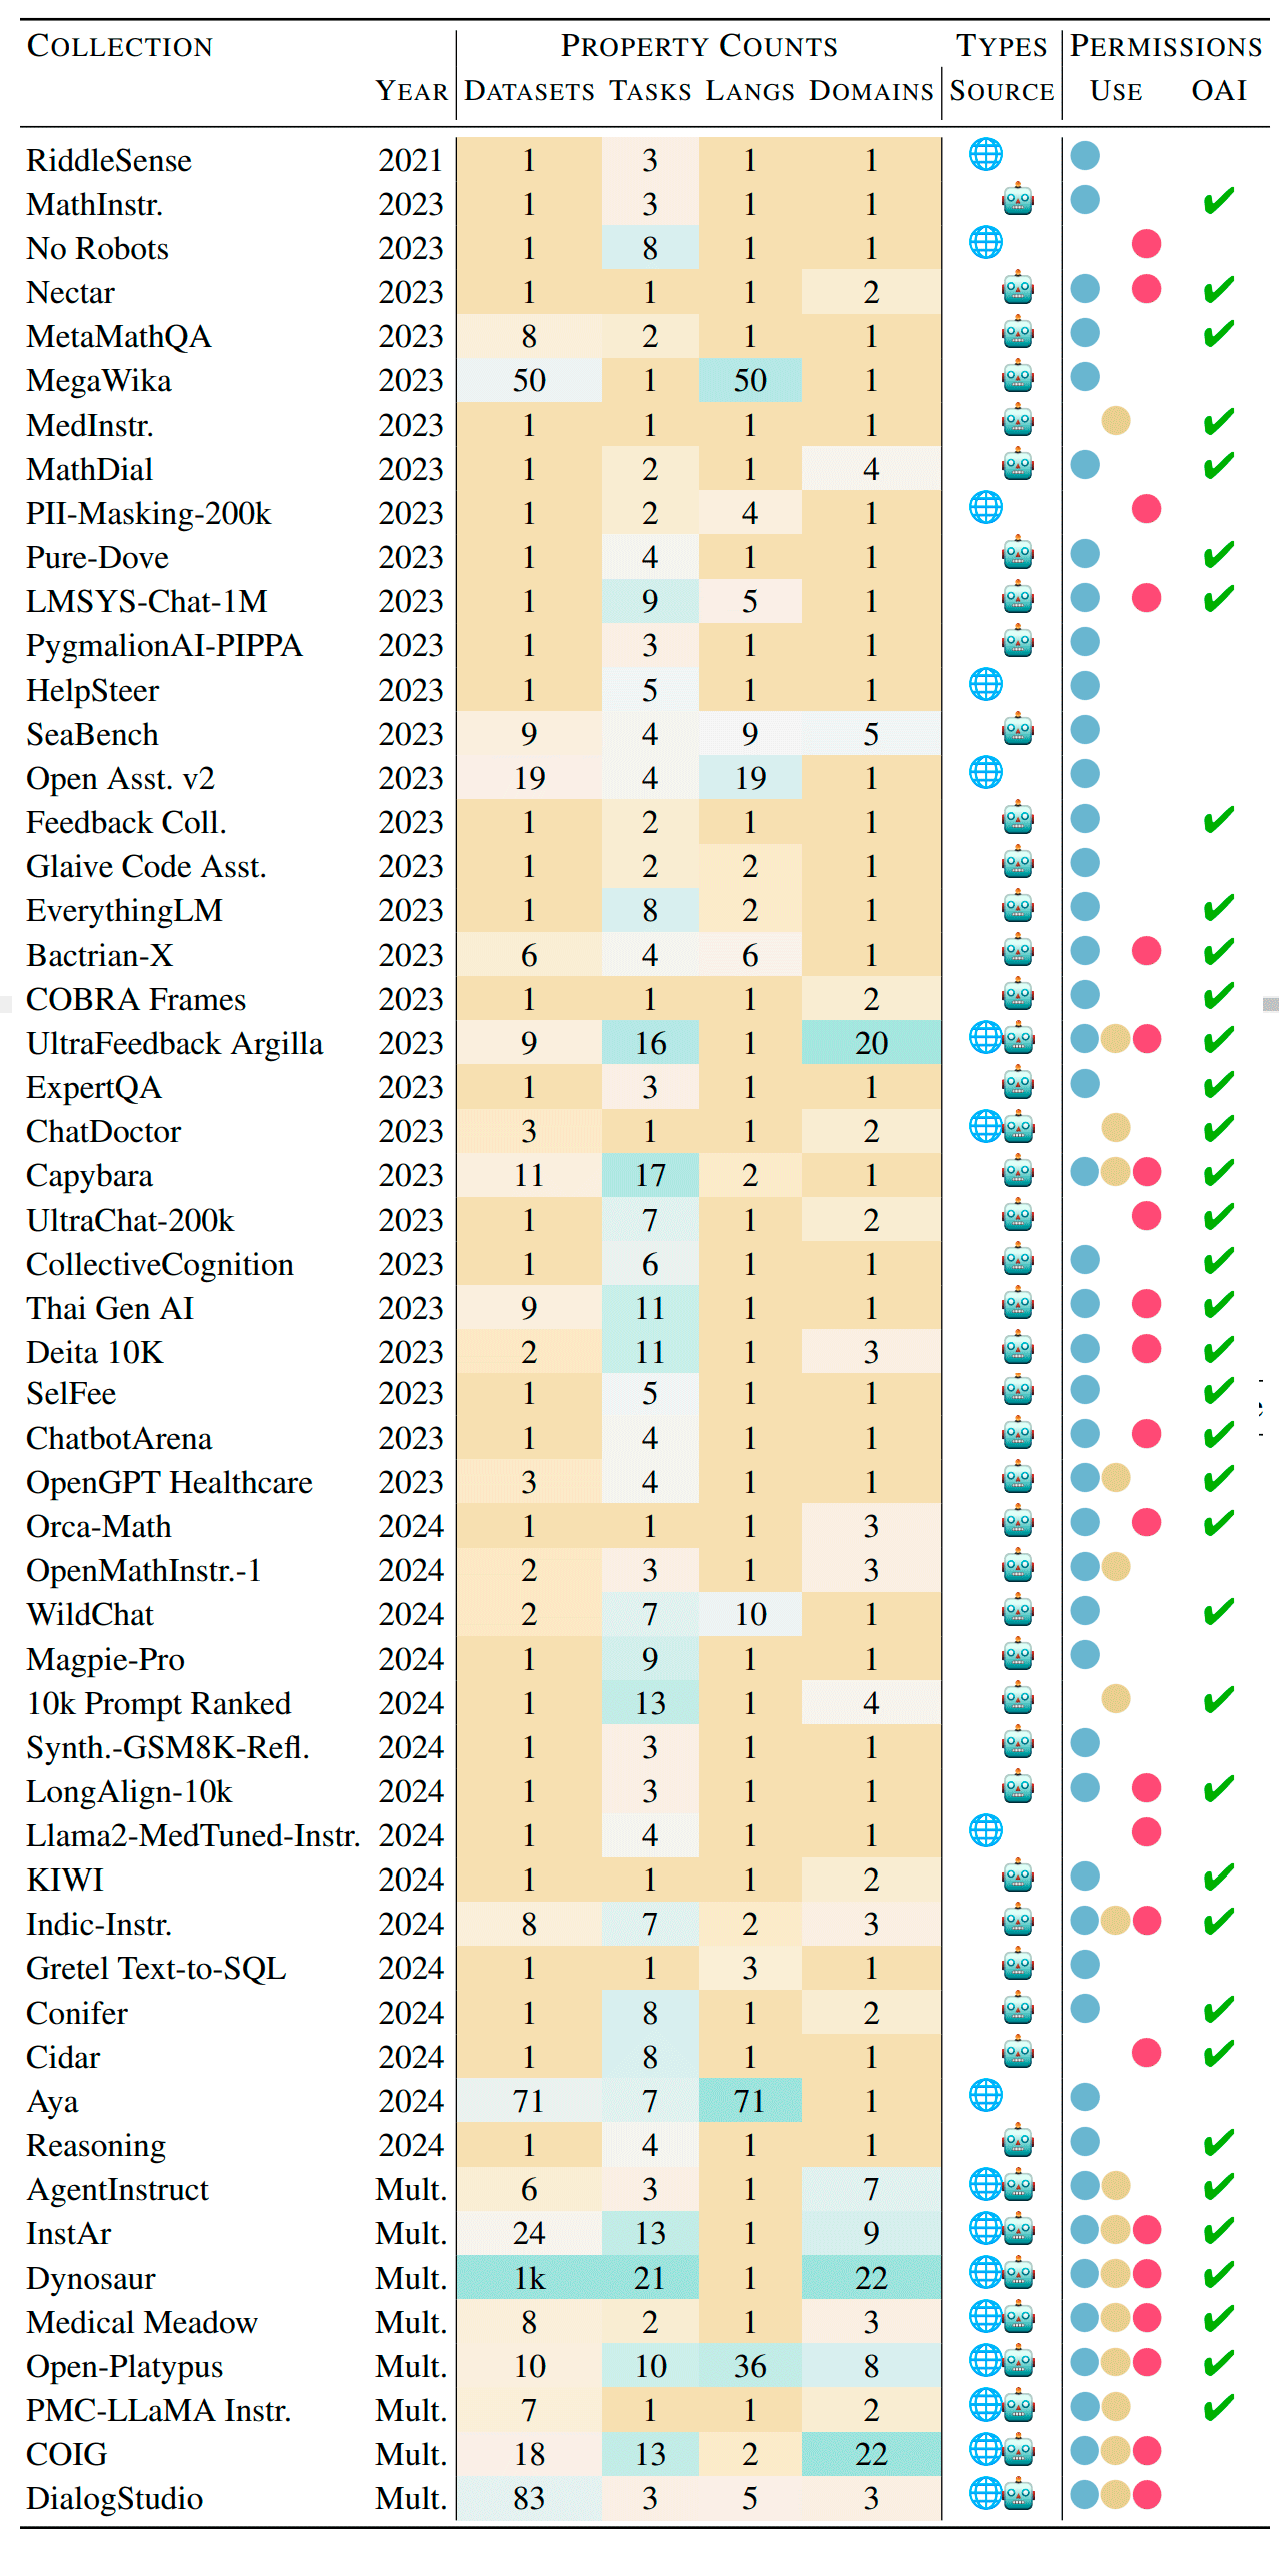
ตารางต่อไปนี้แสดงแหล่งที่มาในการรวบรวมข้อความ คุณสมบัติต่างๆ รวมถึงจำนวนชุดข้อมูล งาน ภาษา และขอบเขตหัวข้อของข้อความ คอลัมน์แหล่งที่มาระบุเนื้อหาในการรวบรวมนี้ ได้แก่ ข้อความที่สร้างโดยมนุษย์บนเว็บ เอาต์พุตของโมเดลภาษา หรือทั้งสองอย่าง คอลัมน์สุดท้ายระบุสถานะสิทธิ์ใช้งานของการรวบรวมนี้ โดยสีน้ำเงินคือการใช้งานเชิงพาณิชย์ สีแดงคือการใช้งานที่ไม่ใช่เชิงพาณิชย์และการศึกษาวิจัยทางวิชาการ และสีเหลืองคือสิทธิ์ใช้งานที่ไม่ชัดเจน สุดท้าย คอลัมน์ OAI ระบุการรวบรวมที่ประกอบด้วยการสร้างของโมเดล OpenAI ชุดข้อมูลแสดงตามลำดับเพื่อเน้นให้เห็นแนวโน้มตามเวลาที่ผ่านไป โดยมีแหล่งที่มาจากที่นี่
การรวบรวมข้อมูลข้อความ
การรวบรวมข้อมูลวิดีโอ
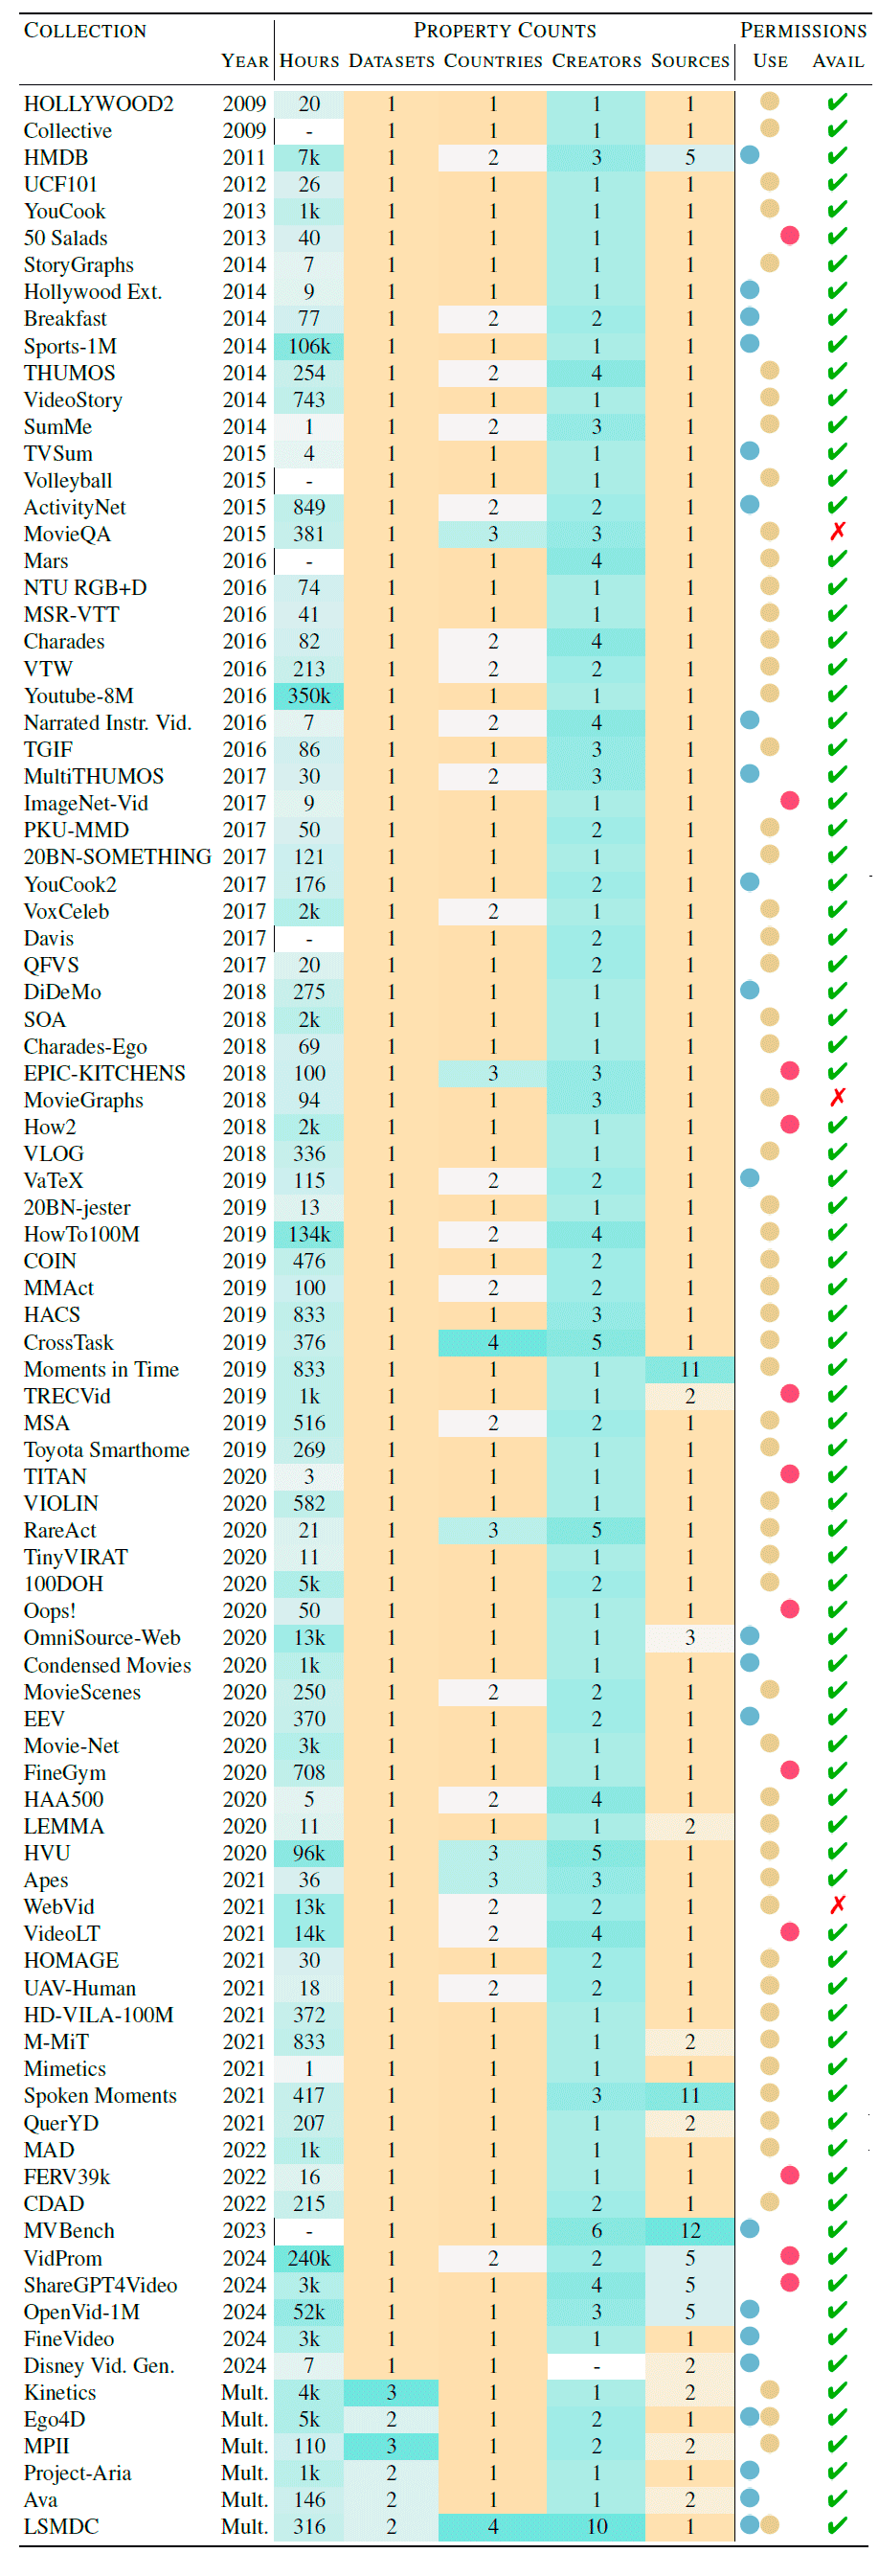
การรวบรวมข้อมูลเสียง
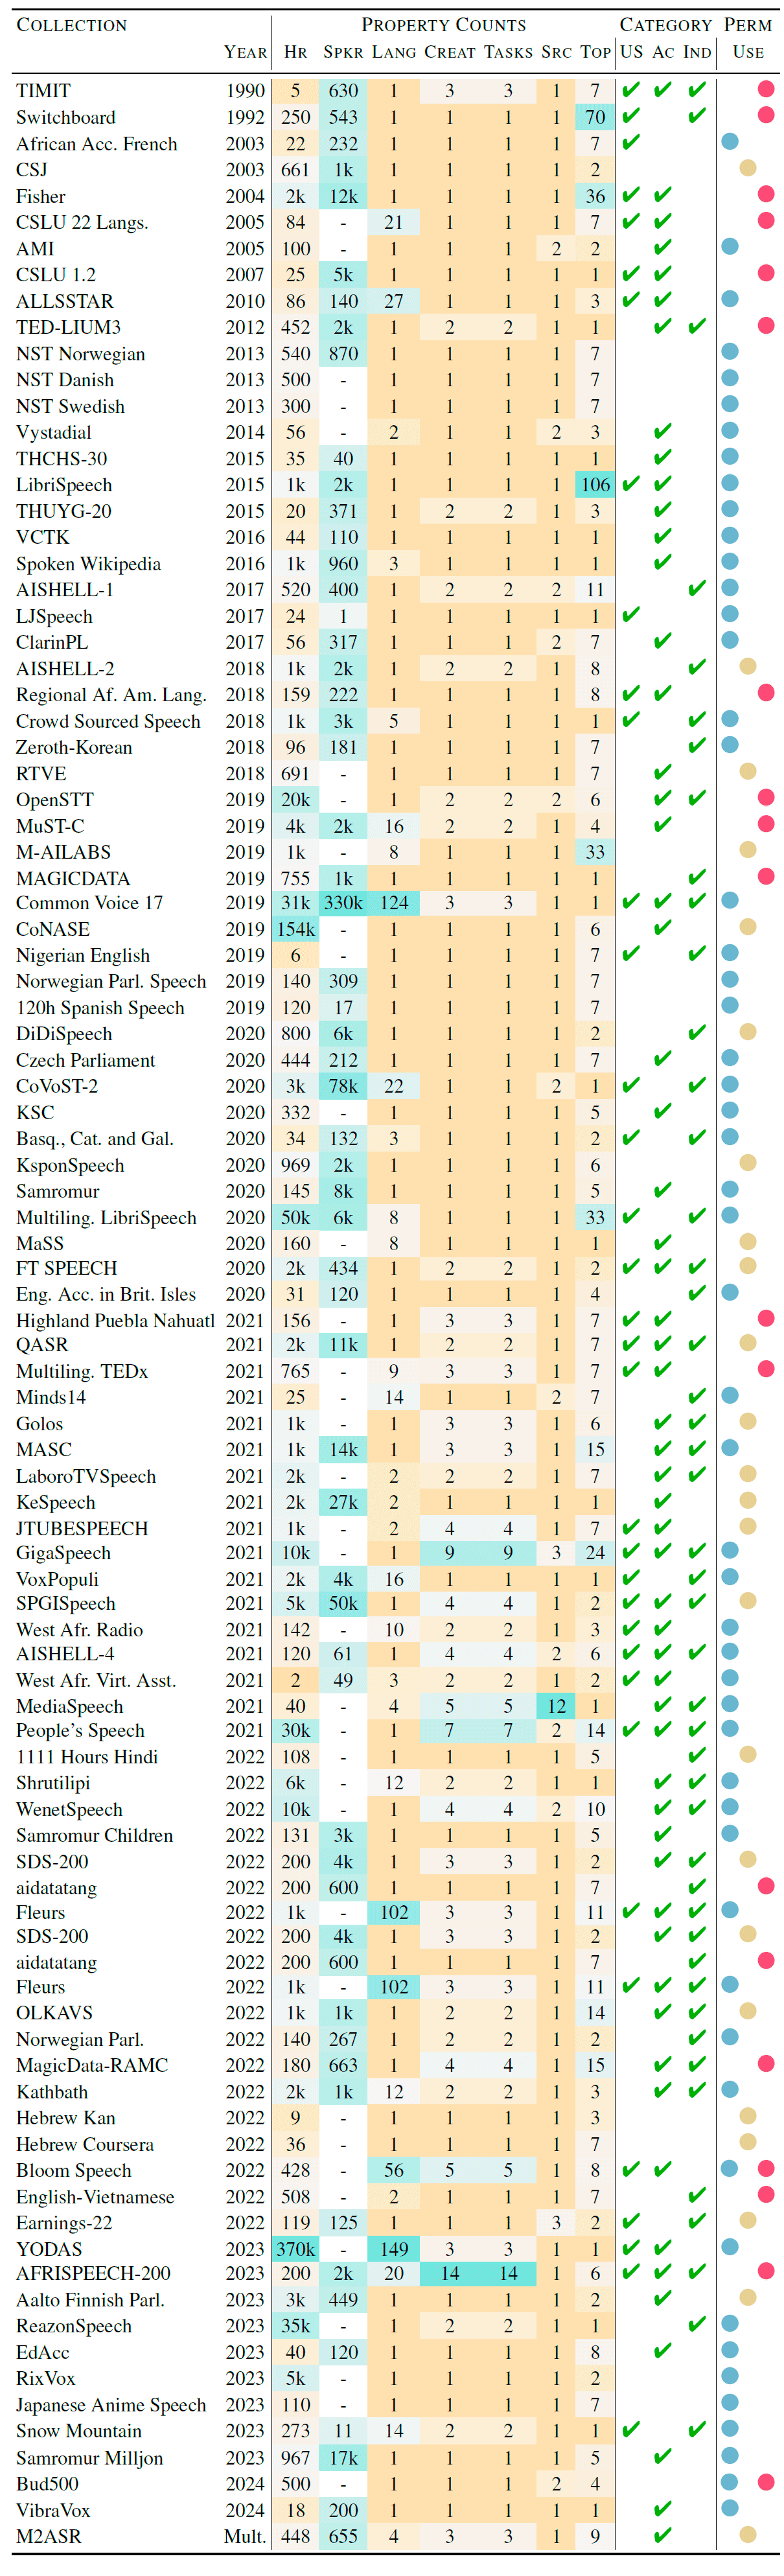
แม้จะเห็นได้ชัดว่าข้อมูลที่เข้าถึงได้โดยง่ายถูกใช้งานไปจนหมดแล้ว แต่ก็ยังคงมีแหล่งข้อมูลหลายแหล่งที่ยังไม่มีการใช้งานมาก่อน
LLM ขั้นสูงสามารถช่วยจัดโครงสร้างและนำชุดข้อมูลที่ซ่อนอยู่เหล่านี้ไปใช้ฝึกในอนาคตได้
การเรียนรู้โดยแยกหรือ Federated Learning ช่วยให้โมเดลสามารถดำเนินการฝึกด้วยข้อมูลที่ละเอียดอ่อนโดยที่ไม่ต้องถ่ายโอนข้อมูลออกนอกสภาพแวดล้อมที่ปลอดภัย วิธีนี้เหมาะสำหรับอุตสาหกรรมที่ต้องจัดการกับข้อมูลที่เป็นความลับ เช่น การดูแลสุขภาพ การเงิน และโทรคมนาคม เมื่อจัดเก็บข้อมูลไว้เฉพาะที่ การเรียนรู้โดยไม่รวมศูนย์จึงให้ความเป็นส่วนตัวขณะที่ยังคงเอื้อให้สามารถพัฒนาโมเดลร่วมกันได้
การสร้างข้อมูลสังเคราะห์และการเสริมข้อมูลเปิดโอกาสให้สามารถขยายการฝึกชุดข้อมูลได้
ขณะที่แวดวง AI พัฒนาก้าวหน้าไปอย่างต่อเนื่อง ชุดข้อมูลก็ยังคงมีบทบาทที่สำคัญอย่างยิ่ง แม้ว่าการไม่เหลือข้อมูลให้ใช้งานจะเป็นความท้าทายอย่างหนึ่ง แต่นักวิจัยและผู้ที่สนใจด้าน AI อย่างเราก็จำเป็นต้องตระหนักและรับผิดชอบด้านการแก้ไขปัญหาต่างๆ เช่น การขาดดุลยภาพทางวัฒนธรรมและการรวมศูนย์ วิธีการแก้ปัญหาใหม่ๆ เช่น การใช้แหล่งข้อมูลที่ไม่มีการใช้งานมาก่อน การเรียนรู้โดยแยก และการสร้างข้อมูลสังเคราะห์จะเปิดโอกาสให้ก้าวต่อไปข้างหน้าได้ เมื่อใช้กลยุทธ์เหล่านี้ร่วมกัน เราจะสามารถดำเนินการพัฒนาที่มีความยุติธรรมและความหลากหลาย ซึ่งจะเป็นการเปิดโอกาสให้มีระบบปัญญาประดิษฐ์ที่ซับซ้อนและไม่แบ่งแยกมากยิ่งขึ้น
บทความนี้แปลจากภาษาอังกฤษ ดูบทความต้นฉบับได้ที่นี่

144 posts | 4 followers
FollowRegional Content Hub - December 22, 2025
Regional Content Hub - July 7, 2025
Regional Content Hub - April 7, 2024
Regional Content Hub - May 7, 2024
Regional Content Hub - April 22, 2024
Regional Content Hub - July 1, 2024
144 posts | 4 followers
Follow Qwen
Full-range, open-source, multimodal, and multi-functional
Learn More Alibaba Cloud for Generative AI
Accelerate innovation with generative AI to create new business success
Learn More Alibaba Cloud Model Studio
A one-stop generative AI platform to build intelligent applications that understand your business, based on Qwen model series such as Qwen-Max and other popular models
Learn More QwenWork
 is dedicated to helping employees strengthen their professional competitiveness in the AI era and to enabling enterprises to improve organizational effectiveness.
Learn MoreMore Posts by Regional Content Hub

