雲原生資料湖架構核心組成部分
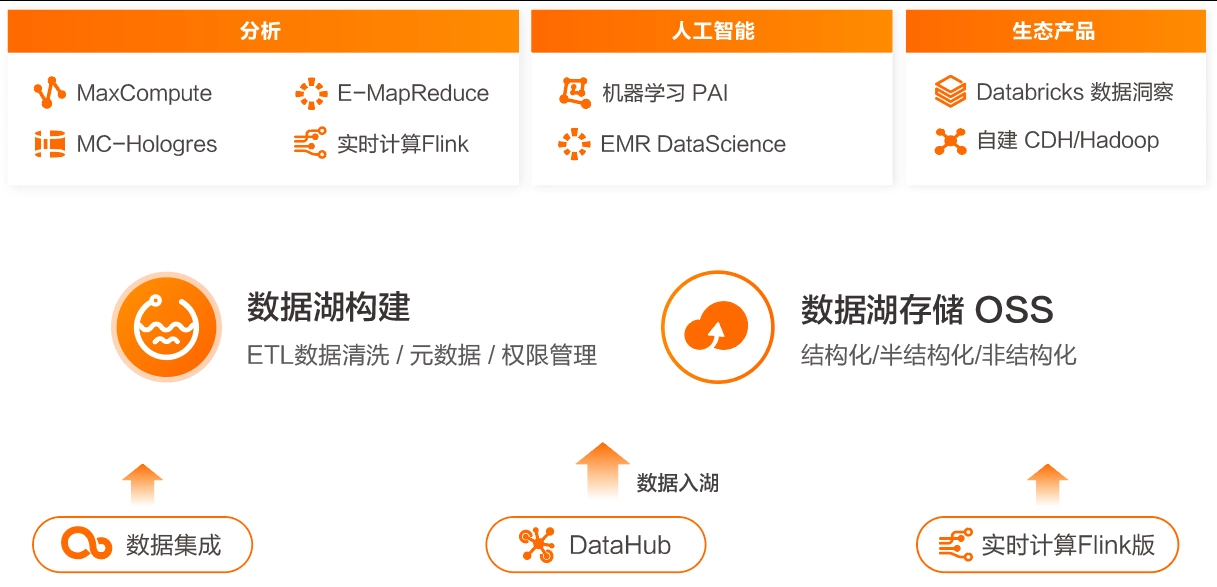
資料湖是一個可儲存任意規模結構化和非結構化資料,支援巨量資料和AI計算的集中式存放庫。作為雲原生資料湖架構核心組成部分,資料湖構建(Data Lake Formation,DLF)可以協助您簡單快速地構建雲原生資料湖解決方案,提供湖上中繼資料統一管理、企業級許可權控制,並無縫對接多種計算引擎。
• 資料易採集 體系化的資料擷取能力,海量的儲存服務,支援結構化/半結構化/非結構化資料來源
• 架構更靈活 計算儲存分離,資源規劃和架構更靈活,減少成本浪費,提升效率,應對業務的快速變化
• 資料易管理 統一儲存,冷熱分層生命週期管理,解決資料分散在各個叢集,資料拷貝等營運困擾
• 價值易提取 通過資料湖對接多種計算分析平台,打破資料孤島,洞察業務價值
產品特性
-
![]()
資料入湖
支援多種資料類型和入湖渠道
支援資料統一清洗 -
![]()
中繼資料服務
智能中繼資料識別服務
統一收集避免分散管理 -
![]()
許可權管理
企業級資料許可權管理
使用者可以針對庫、表、欄位分別設定許可權 -
![]()
多引擎對接
支援上遊多種計算引擎
輕鬆構建全鏈路資料湖服務 -
![]()
生態開放
相容Hive Metastore
提供多語言Open API,易整合 -
![]()
資料加速
專屬JindoFS資料加速功能
提供高效能資料湖分析加速能力
應用情境
應用情境
 典型情境
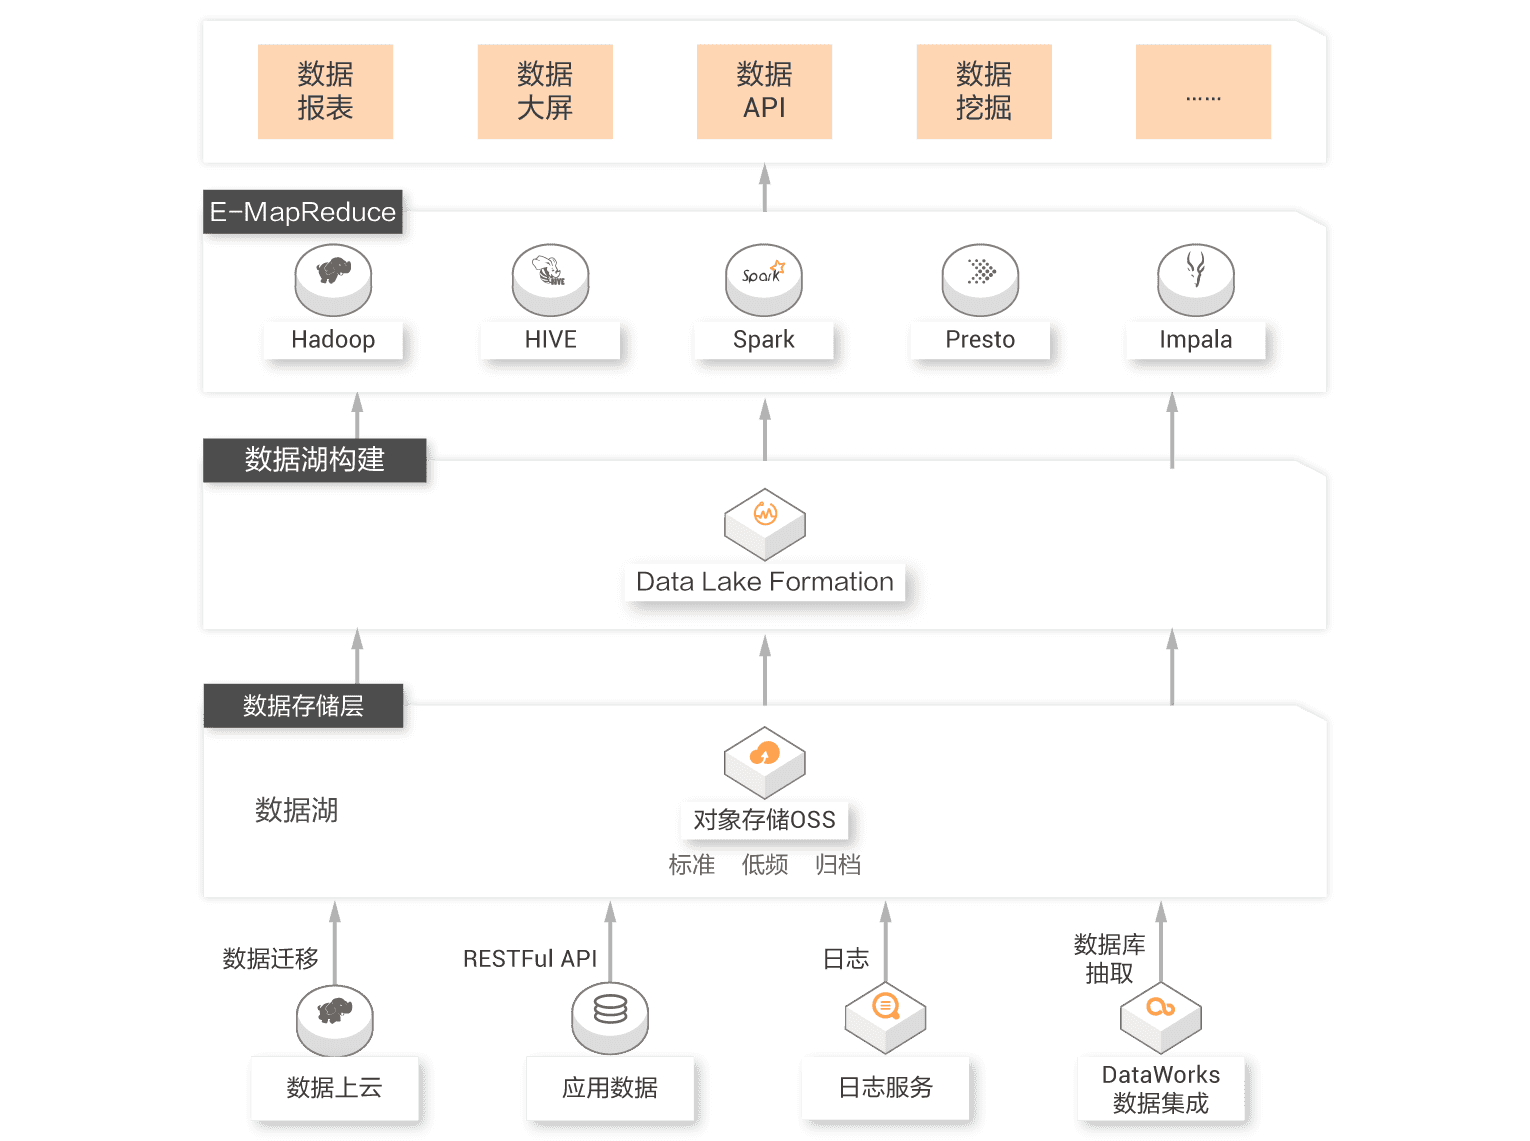
基於阿里雲開源巨量資料生態系統(E-MapReduce,Realtime ComputeFlink,DLA等產品)來構建資料處理分析平台;
資料量飛速膨脹導致儲存資源與計算資源擴容速度不匹配,需進行成本最佳化;
統一管理不同儲存中的中繼資料:巨量資料生態的豐富,使用者的資料來源廣泛,中繼資料分散較難管理。
方案價值
-
中繼資料管理
資料湖構建支援自動採集發現多引擎中繼資料,可做到統一管理,避免資料孤島生態優勢
阿里雲巨量資料團隊提供專家級服務支援
應用情境
典型情境
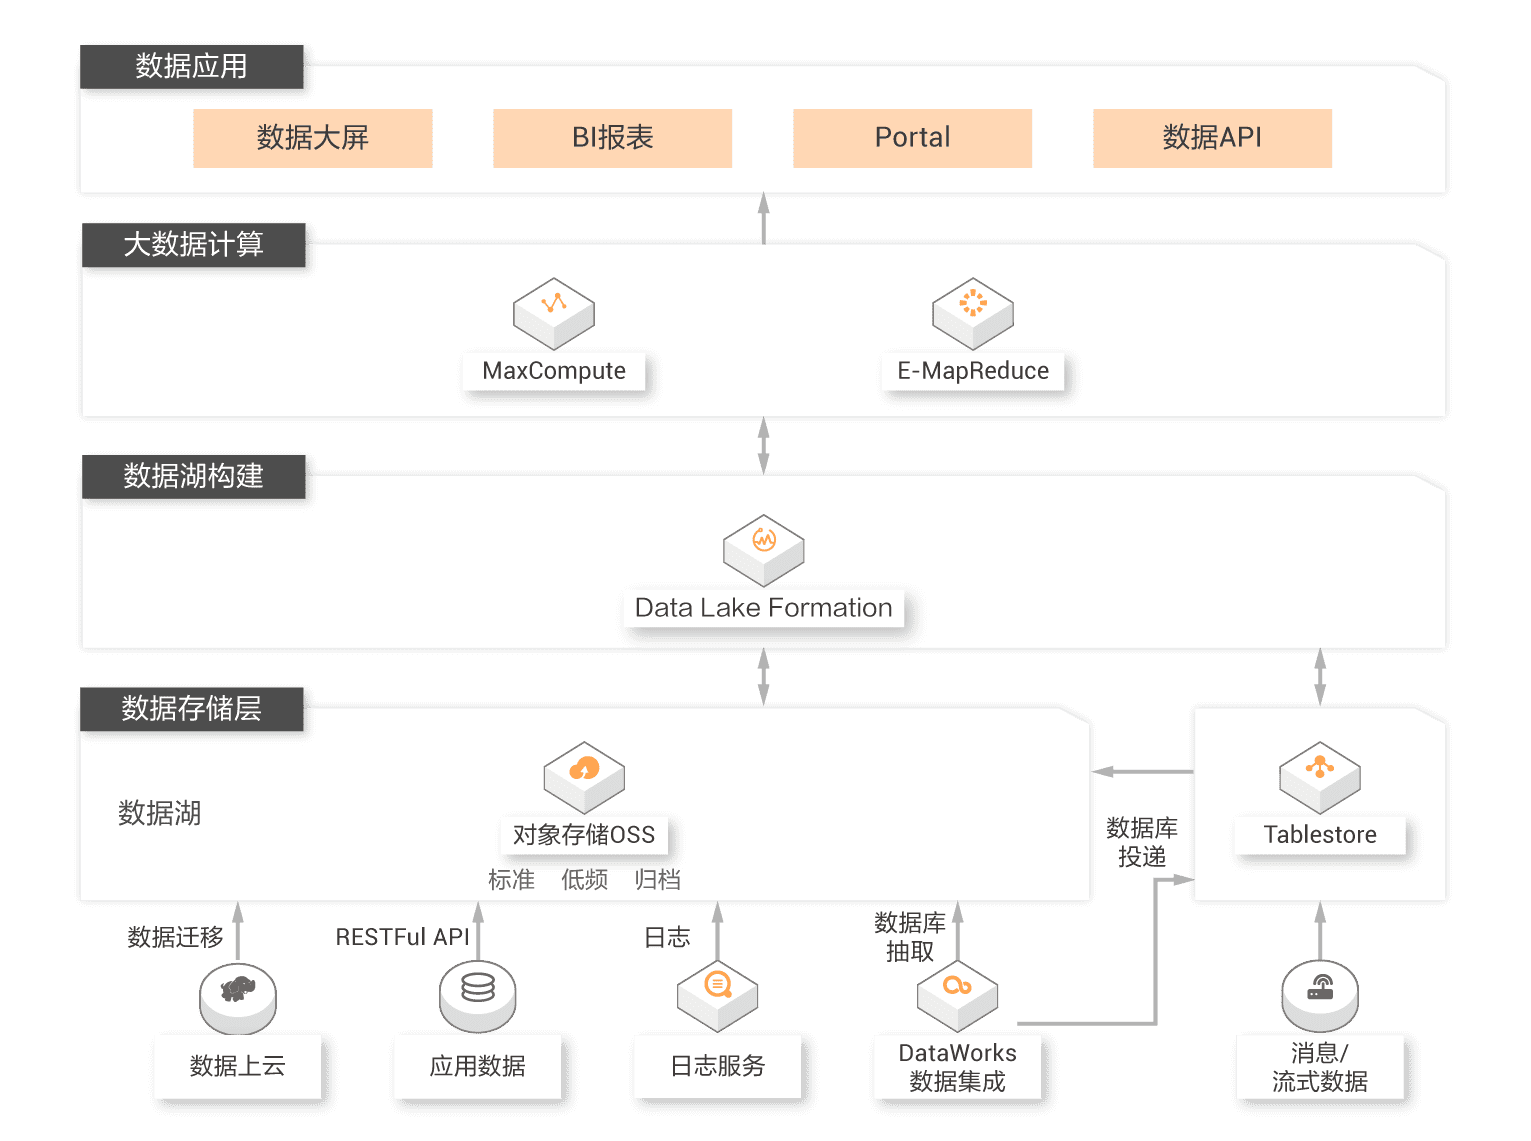
資料倉儲和資料湖,是巨量資料架構的兩種設計取向。
優點:
資料湖優先:通過開放底層檔案儲存體,給資料入湖帶來最大的靈活性;
資料倉儲優先:更加關注資料使用效率、大規模下的資料管理、安全/合規等企業級成長性需求。
隨著使用者業務的逐漸清晰與沉澱,使用者面臨著資料湖和資料倉儲架構的融合,依託於阿里雲資料倉儲(MaxCompute、Hologres、ADB等產品)和資料湖構建產品,協助使用者打造湖倉一體的資料系統,讓資料和計算在湖和倉之間自由流動,從而構建一個完整的有機的巨量資料技術生態體系。
方案價值
-
免營運
資料湖構建產品提供使用者全託管服務,僅需簡單點擊操作,就可以協助使用者快速搭建起雲上的資料湖系統安全有保證
統一許可權管理體系,可做到對資料庫、表、列的許可權控制。
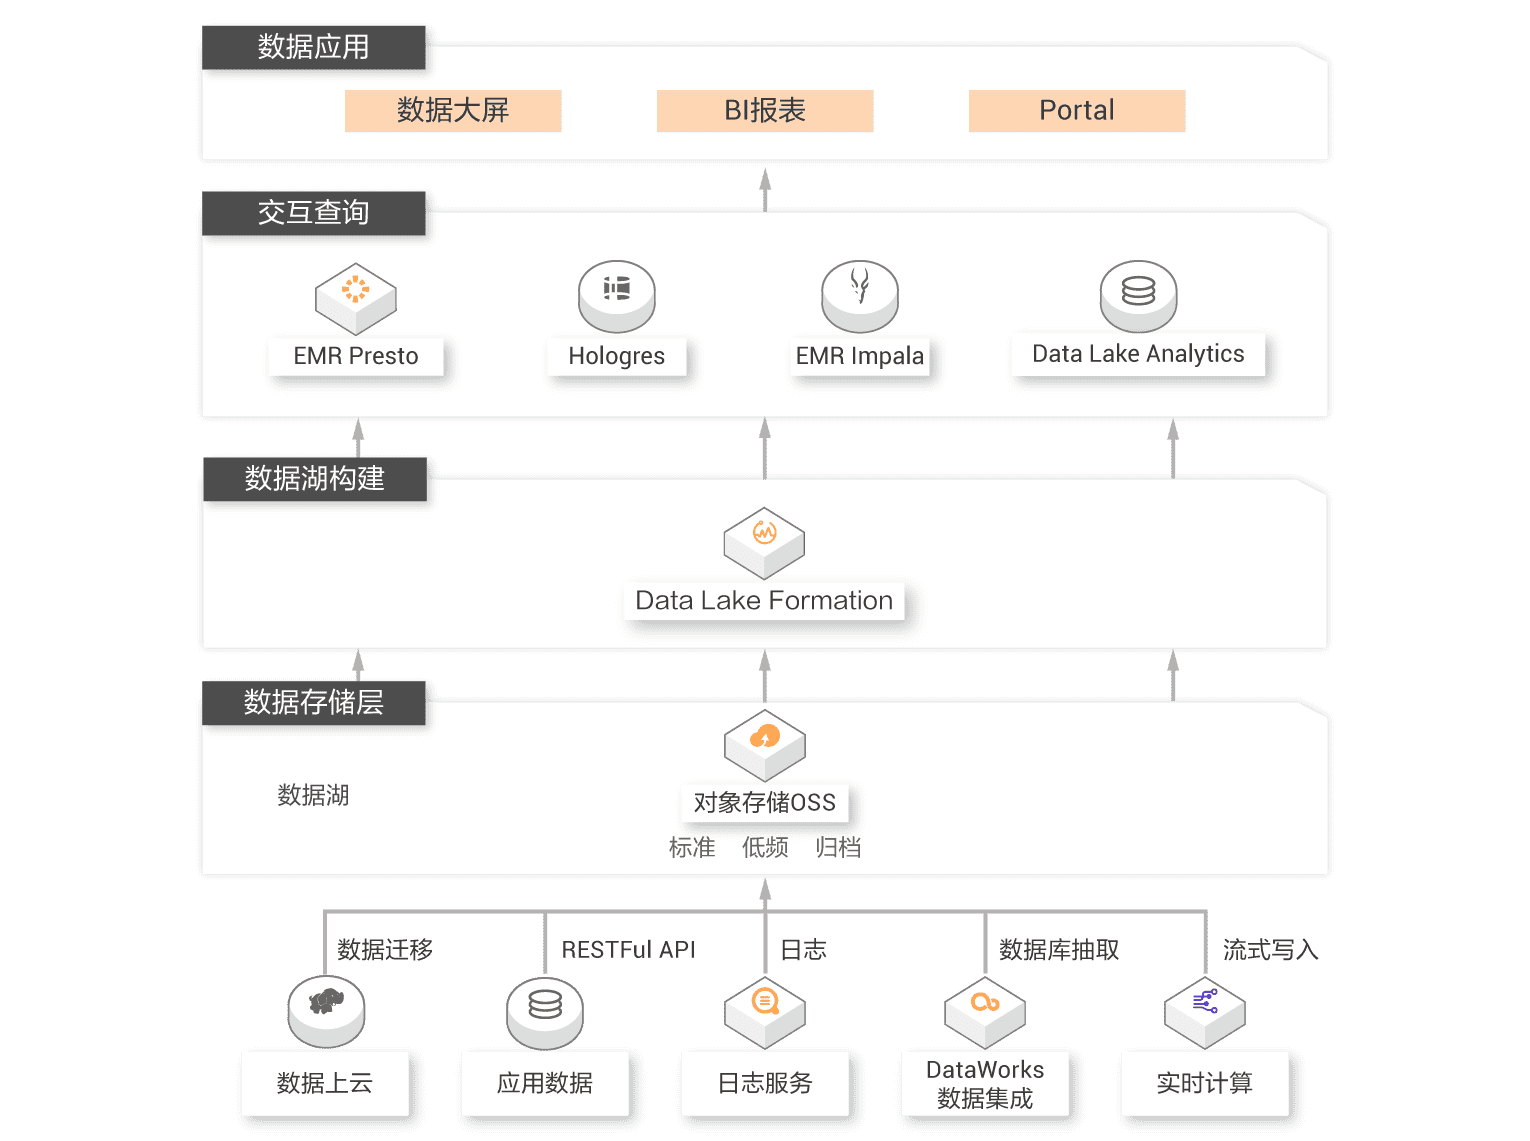
應用情境
典型情境
期望實現:
對儲存在OSS中的大量不同類型資料進行各種多種維度分析查詢,如即時資料分析、OLAP查詢,並將對應的結果反饋到業務系統中;
在資料查詢時能夠直接便捷對接雲上多種計算引擎,不需要提取全部資料到查詢系統。
方案價值
-
即時資料入湖
提供資料即時入湖能力,提供業務時效性中繼資料自動探索
資料湖構建可以自動對資料進行抓取、編排和準備,以進行分析,避免複雜手動操作
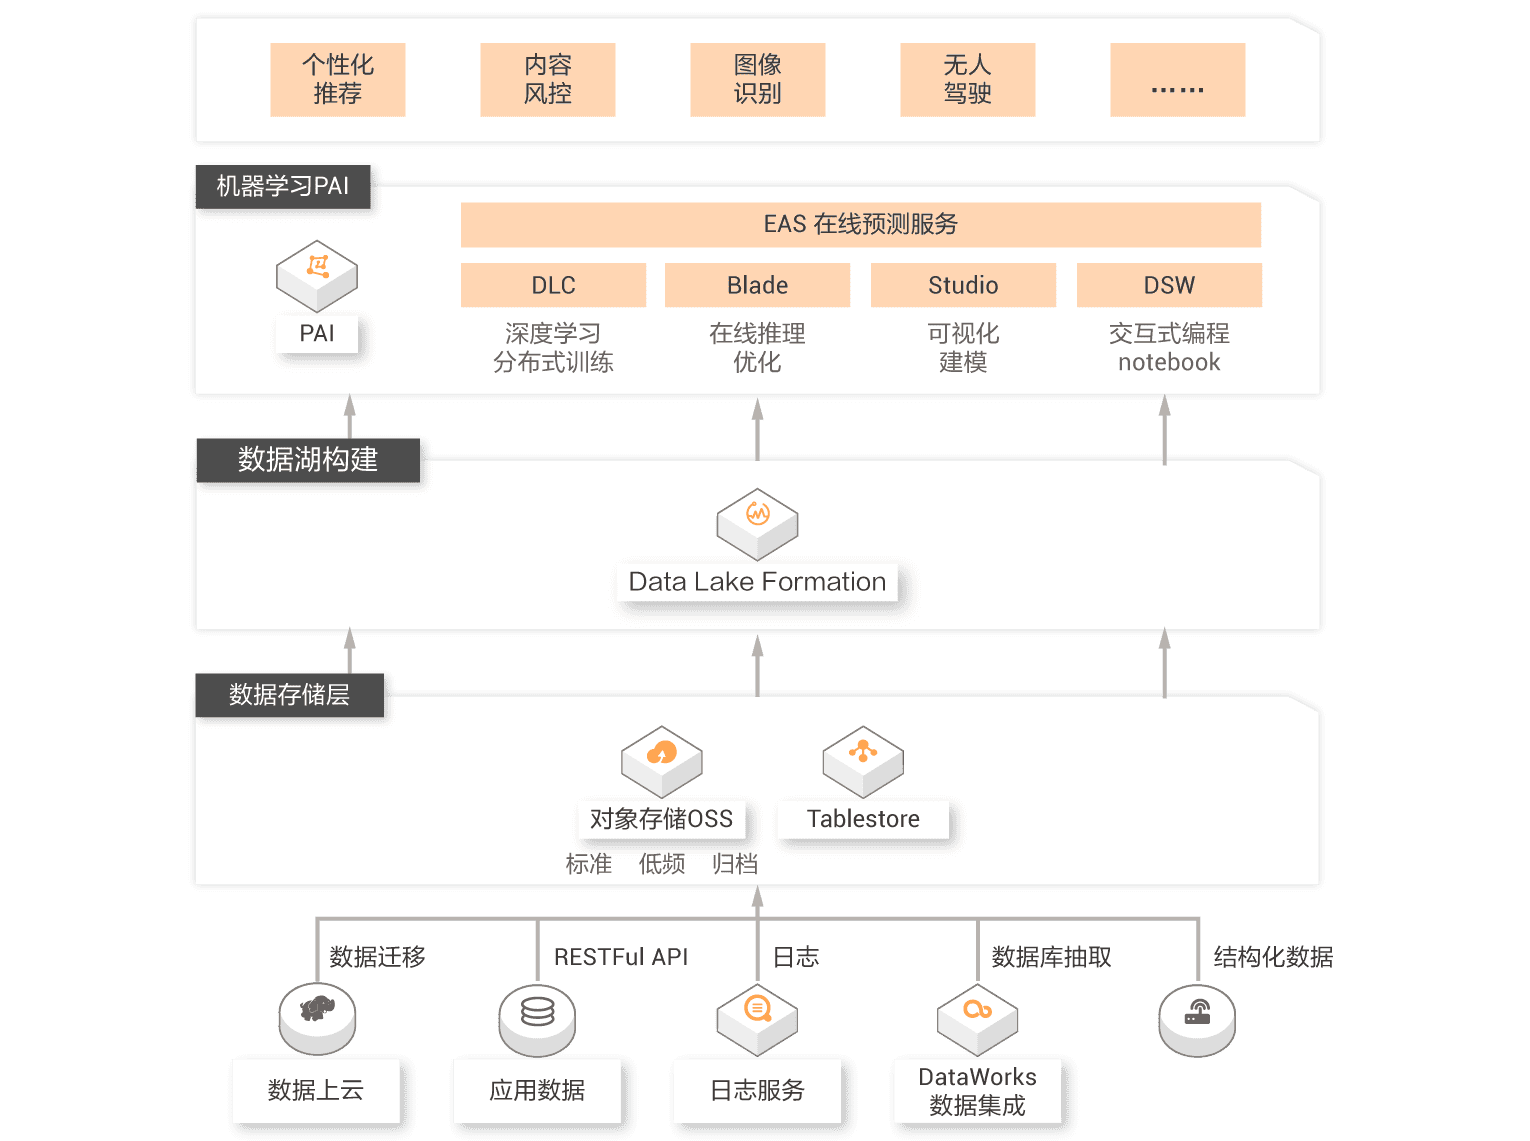
應用情境
典型情境
在經典機器學習情境和深度學習情境下利用資料湖服務使用者;
在機器學習情境下,使用者面臨資料量大,模型訓練慢,演算法效果差的問題,需要資料湖具備能夠對接成熟的Machine Learning Platform for AI的能力,同時動態調整對GPU資源的使用,節約成本。
方案價值
-
易用性強
資料湖構建無縫對接阿里雲Machine Learning Platform for AI,同時提供多種Open API,方便使用者整合資料正常化
資料湖構建支援使用者在入湖時對資料進行清洗處理、標準化,方便後續使用機器學習模型分析
行業應用情境
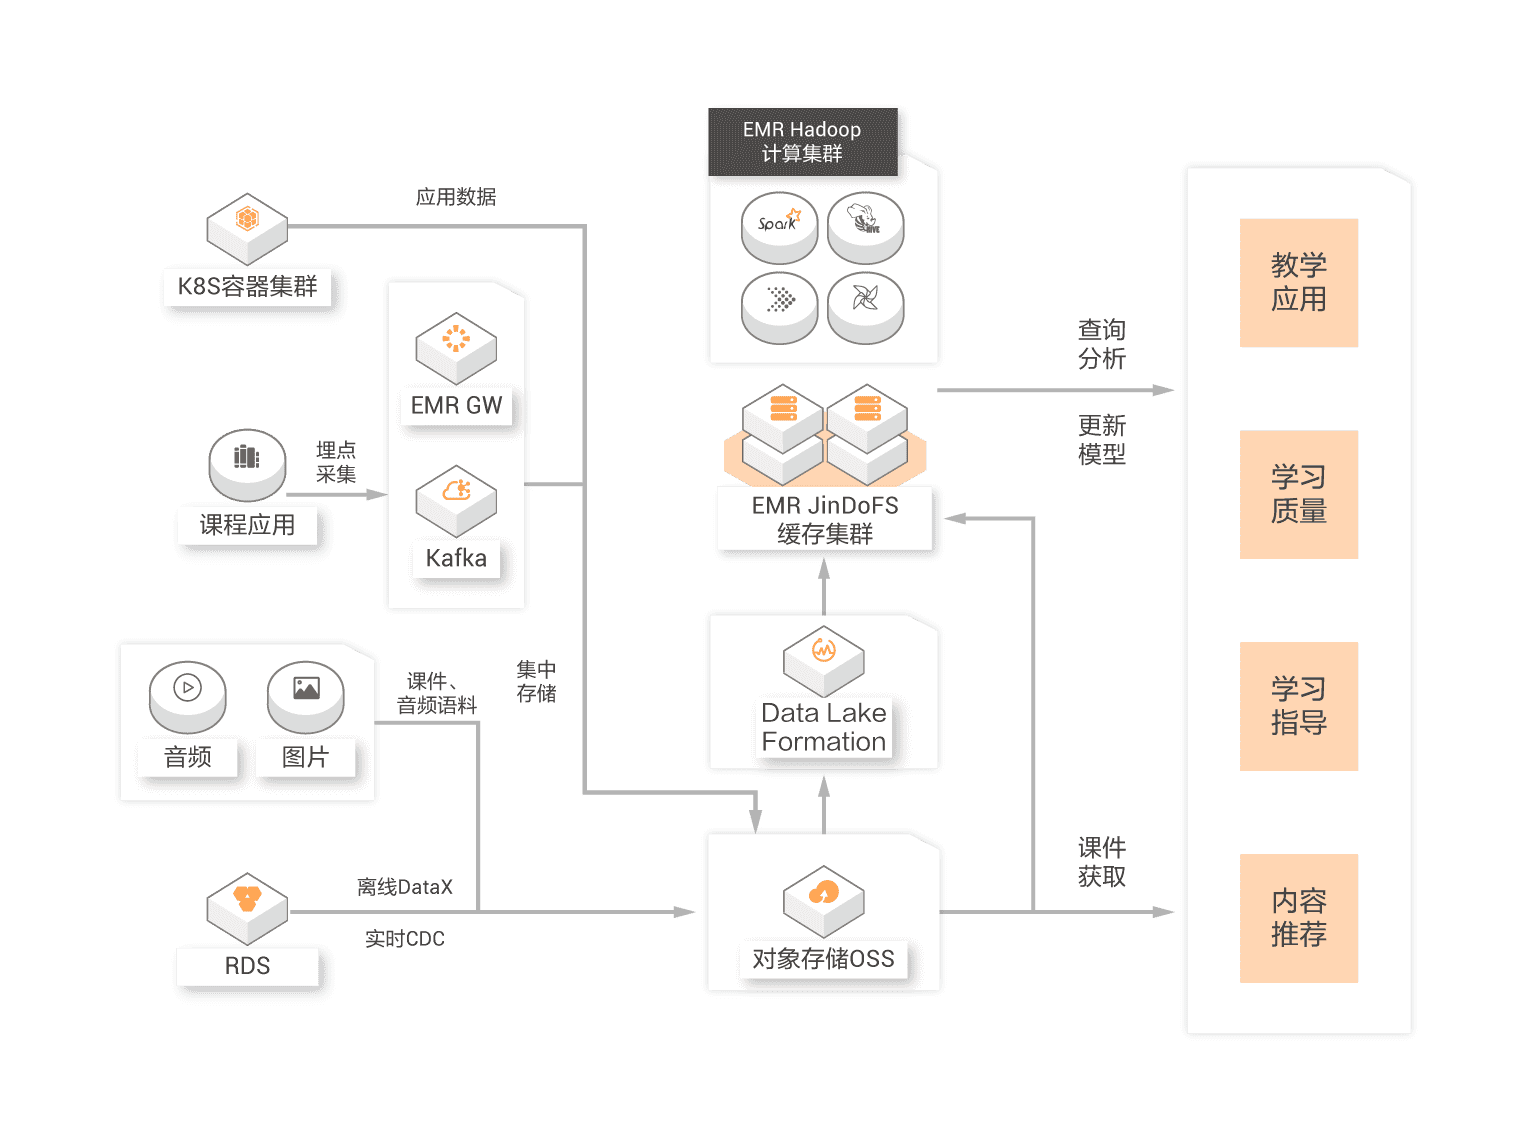
線上教育資料湖實踐
使用者數過億的某線上教育平台客戶需求
集中儲存並統一管理課件素材、應用日誌、學習採樣等資料
對不同類型資料提供課件播放、離線分析、機器學習,實現線上教育不同情境的應用客戶價值
資料湖構建完美適配資料存放區OSS,同時對接大量計算引擎,滿足使用者不同的分析需求
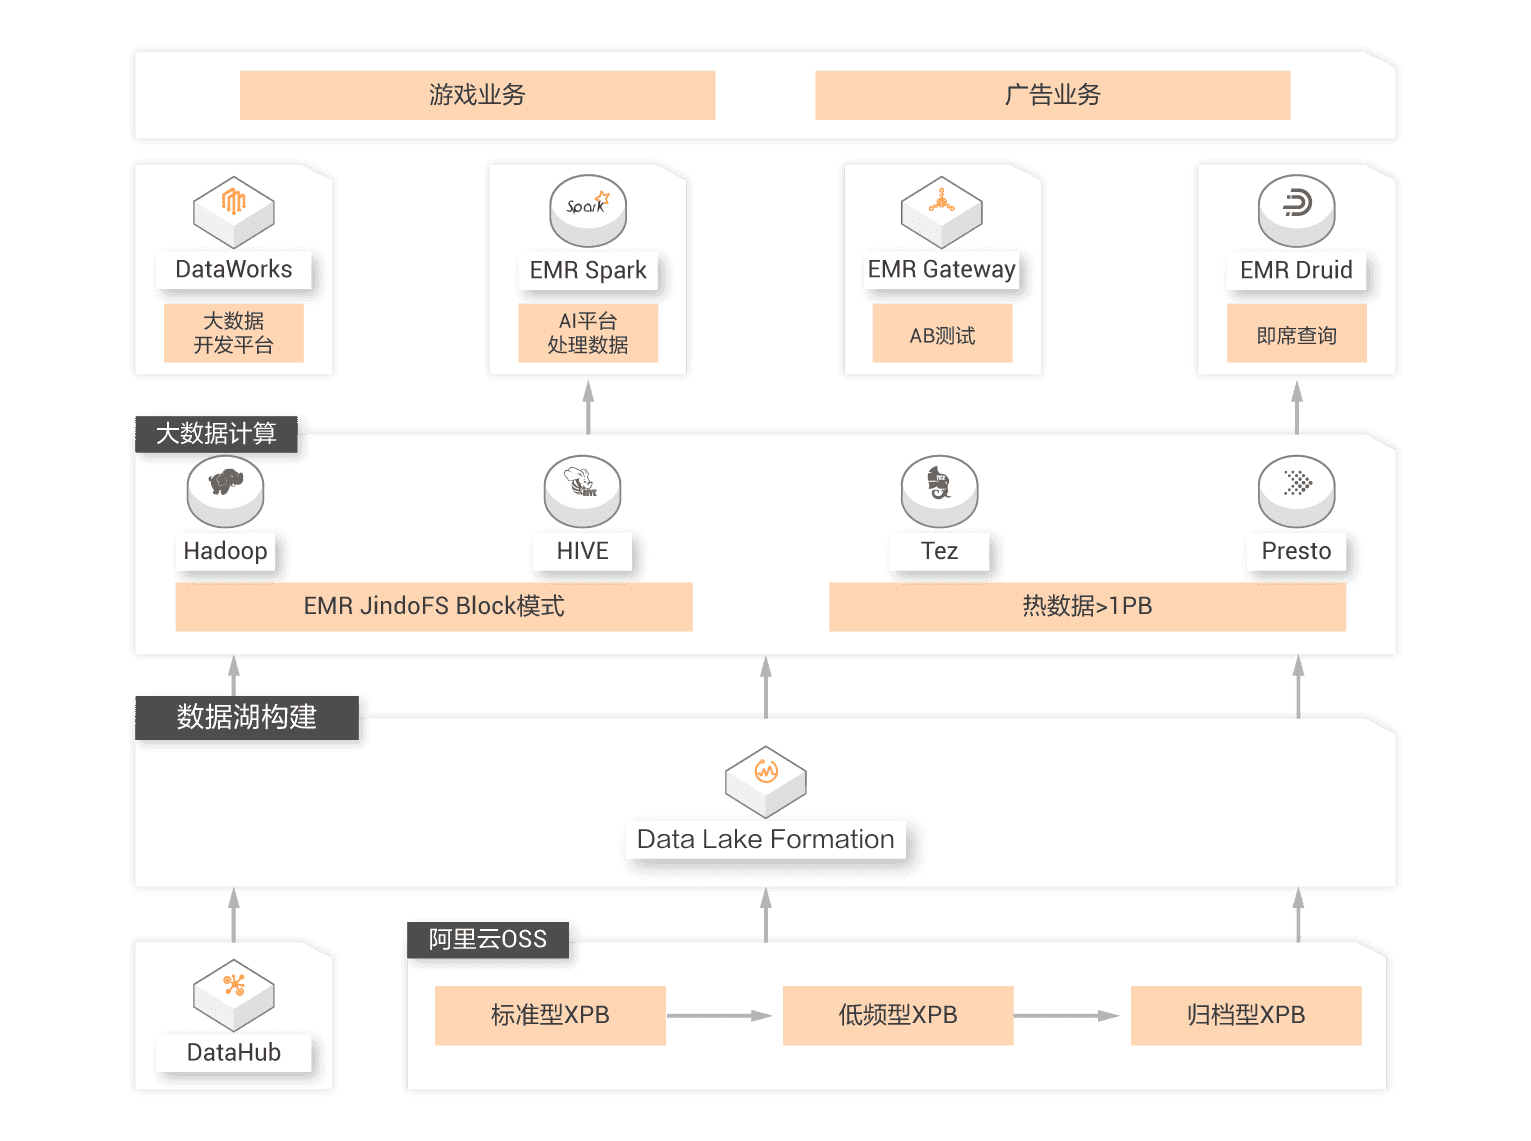
線上遊戲資料湖實踐
亞洲領先的某互動娛樂公司客戶需求
通過資料分析,及時調整遊戲關卡難度,掉寶率,資源產出率,保證使用者的遊戲體驗、提高使用者留存率
提升雲上資源的靈活擴充和升級能力,解決傳統的巨量資料叢集計算和儲存資源緊綁定的問題,提供使用者更多彈效能力客戶價值
資料湖構建協助使用者快速搭建雲上資料湖服務,解決儲存計算資源問題,同時對接Realtime Compute分析引擎,可以協助使用者即時調整業務
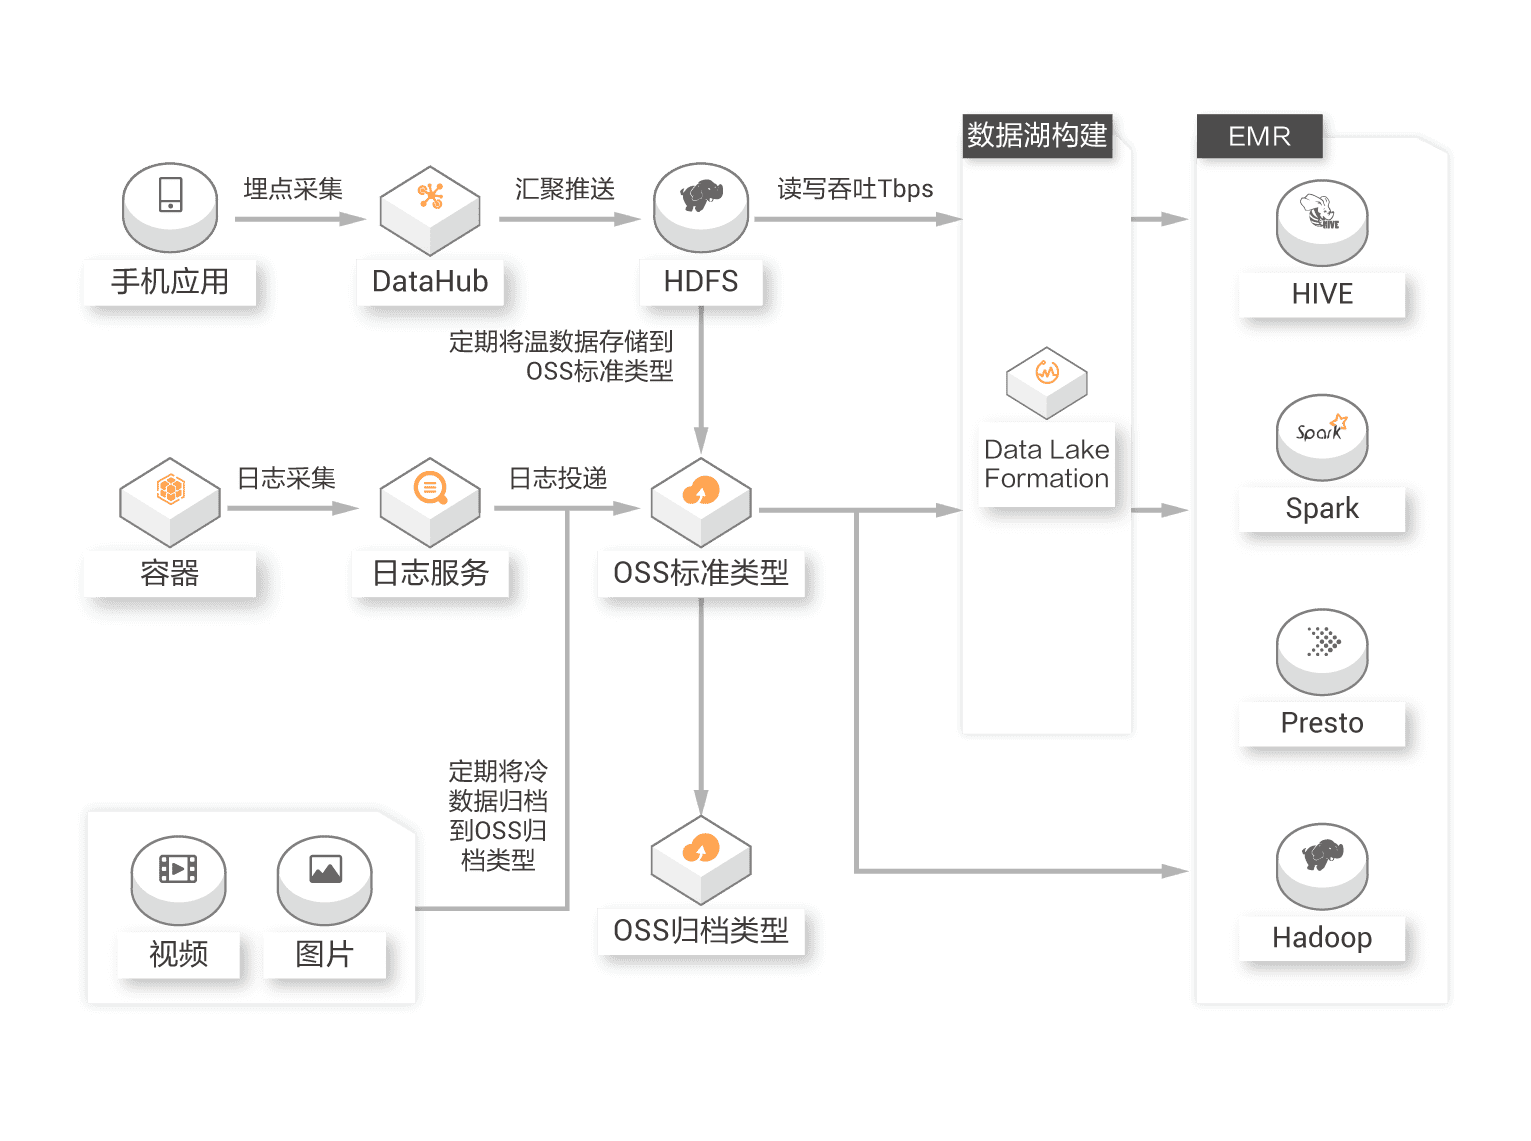
互娛新媒體資料湖實踐
月活使用者數破億的某互連網新媒體平台客戶需求
統一管理多個儲存系統的中繼資料,提供資料的共用分析能力,服務業務發展客戶價值
利用資料湖構建將分散的中繼資料統一集中管理,特有的發現能力可以從使用者資料庫和Object Storage Service中收集並按目錄分類資料