
Ringkasan
Pengembangan teknologi machine learning untuk layanan AI bergantung pada data, algoritma, dan daya komputasi. Solusi Alibaba Cloud AI Acceleration menggunakan dataset dan akselerator GPU terdepan untuk mengoordinasikan aplikasi yang intensif data, mengoptimalkan utilisasi instans GPU, serta mempercepat tugas pelatihan dan inference model AI. Anda juga dapat menggunakan platform pelatihan AI Cloud-native yang dapat dikustomisasi dari Alibaba Cloud untuk menyesuaikan dengan kebutuhan bisnis dan meningkatkan efisiensi infrastruktur AI serta O&M harian.
Unduh WhitepaperSorotan Solusi
-
Akselerasi Atomik Hemat Biaya
Percepat pelatihan dan inference model AI dengan Akselerator GPU tercepat, AIACC, berdasarkan Stanford DAWN Deep Learning Benchmark untuk mempercepat model pelatihan AI hingga 70% dan inference 2-3 kali lipat serta mengurangi biaya.
-
Penggunaan GPU yang Sangat Efisien
Tingkatkan tingkat utilisasi semua GPU di cluster dengan penjadwalan cluster GPU yang membagikan resource dari GPU yang sama, dan hilangkan interferensi antaraplikasi dengan mekanisme isolasi GPU.
-

Akselerator Dataset yang Diakui CNCF
Atasi latensi akses tinggi, akses paralel kompleks dari berbagai sumber data, dan isolasi data yang lemah selama pelatihan AI dengan Fluid, Orkestrator dan Akselerator Dataset Terdistribusi untuk aplikasi intensif data.
-
Platform Pelatihan AI yang Dapat Dikustomisasi
Bangun dan kustomisasi platform pelatihan AI cloud-native Anda dengan konsol untuk development dan O&M menggunakan Alibaba Cloud-Native AI Suite guna meningkatkan efisiensi rekayasa AI di semua tahap deep learning.
Cara Kerja
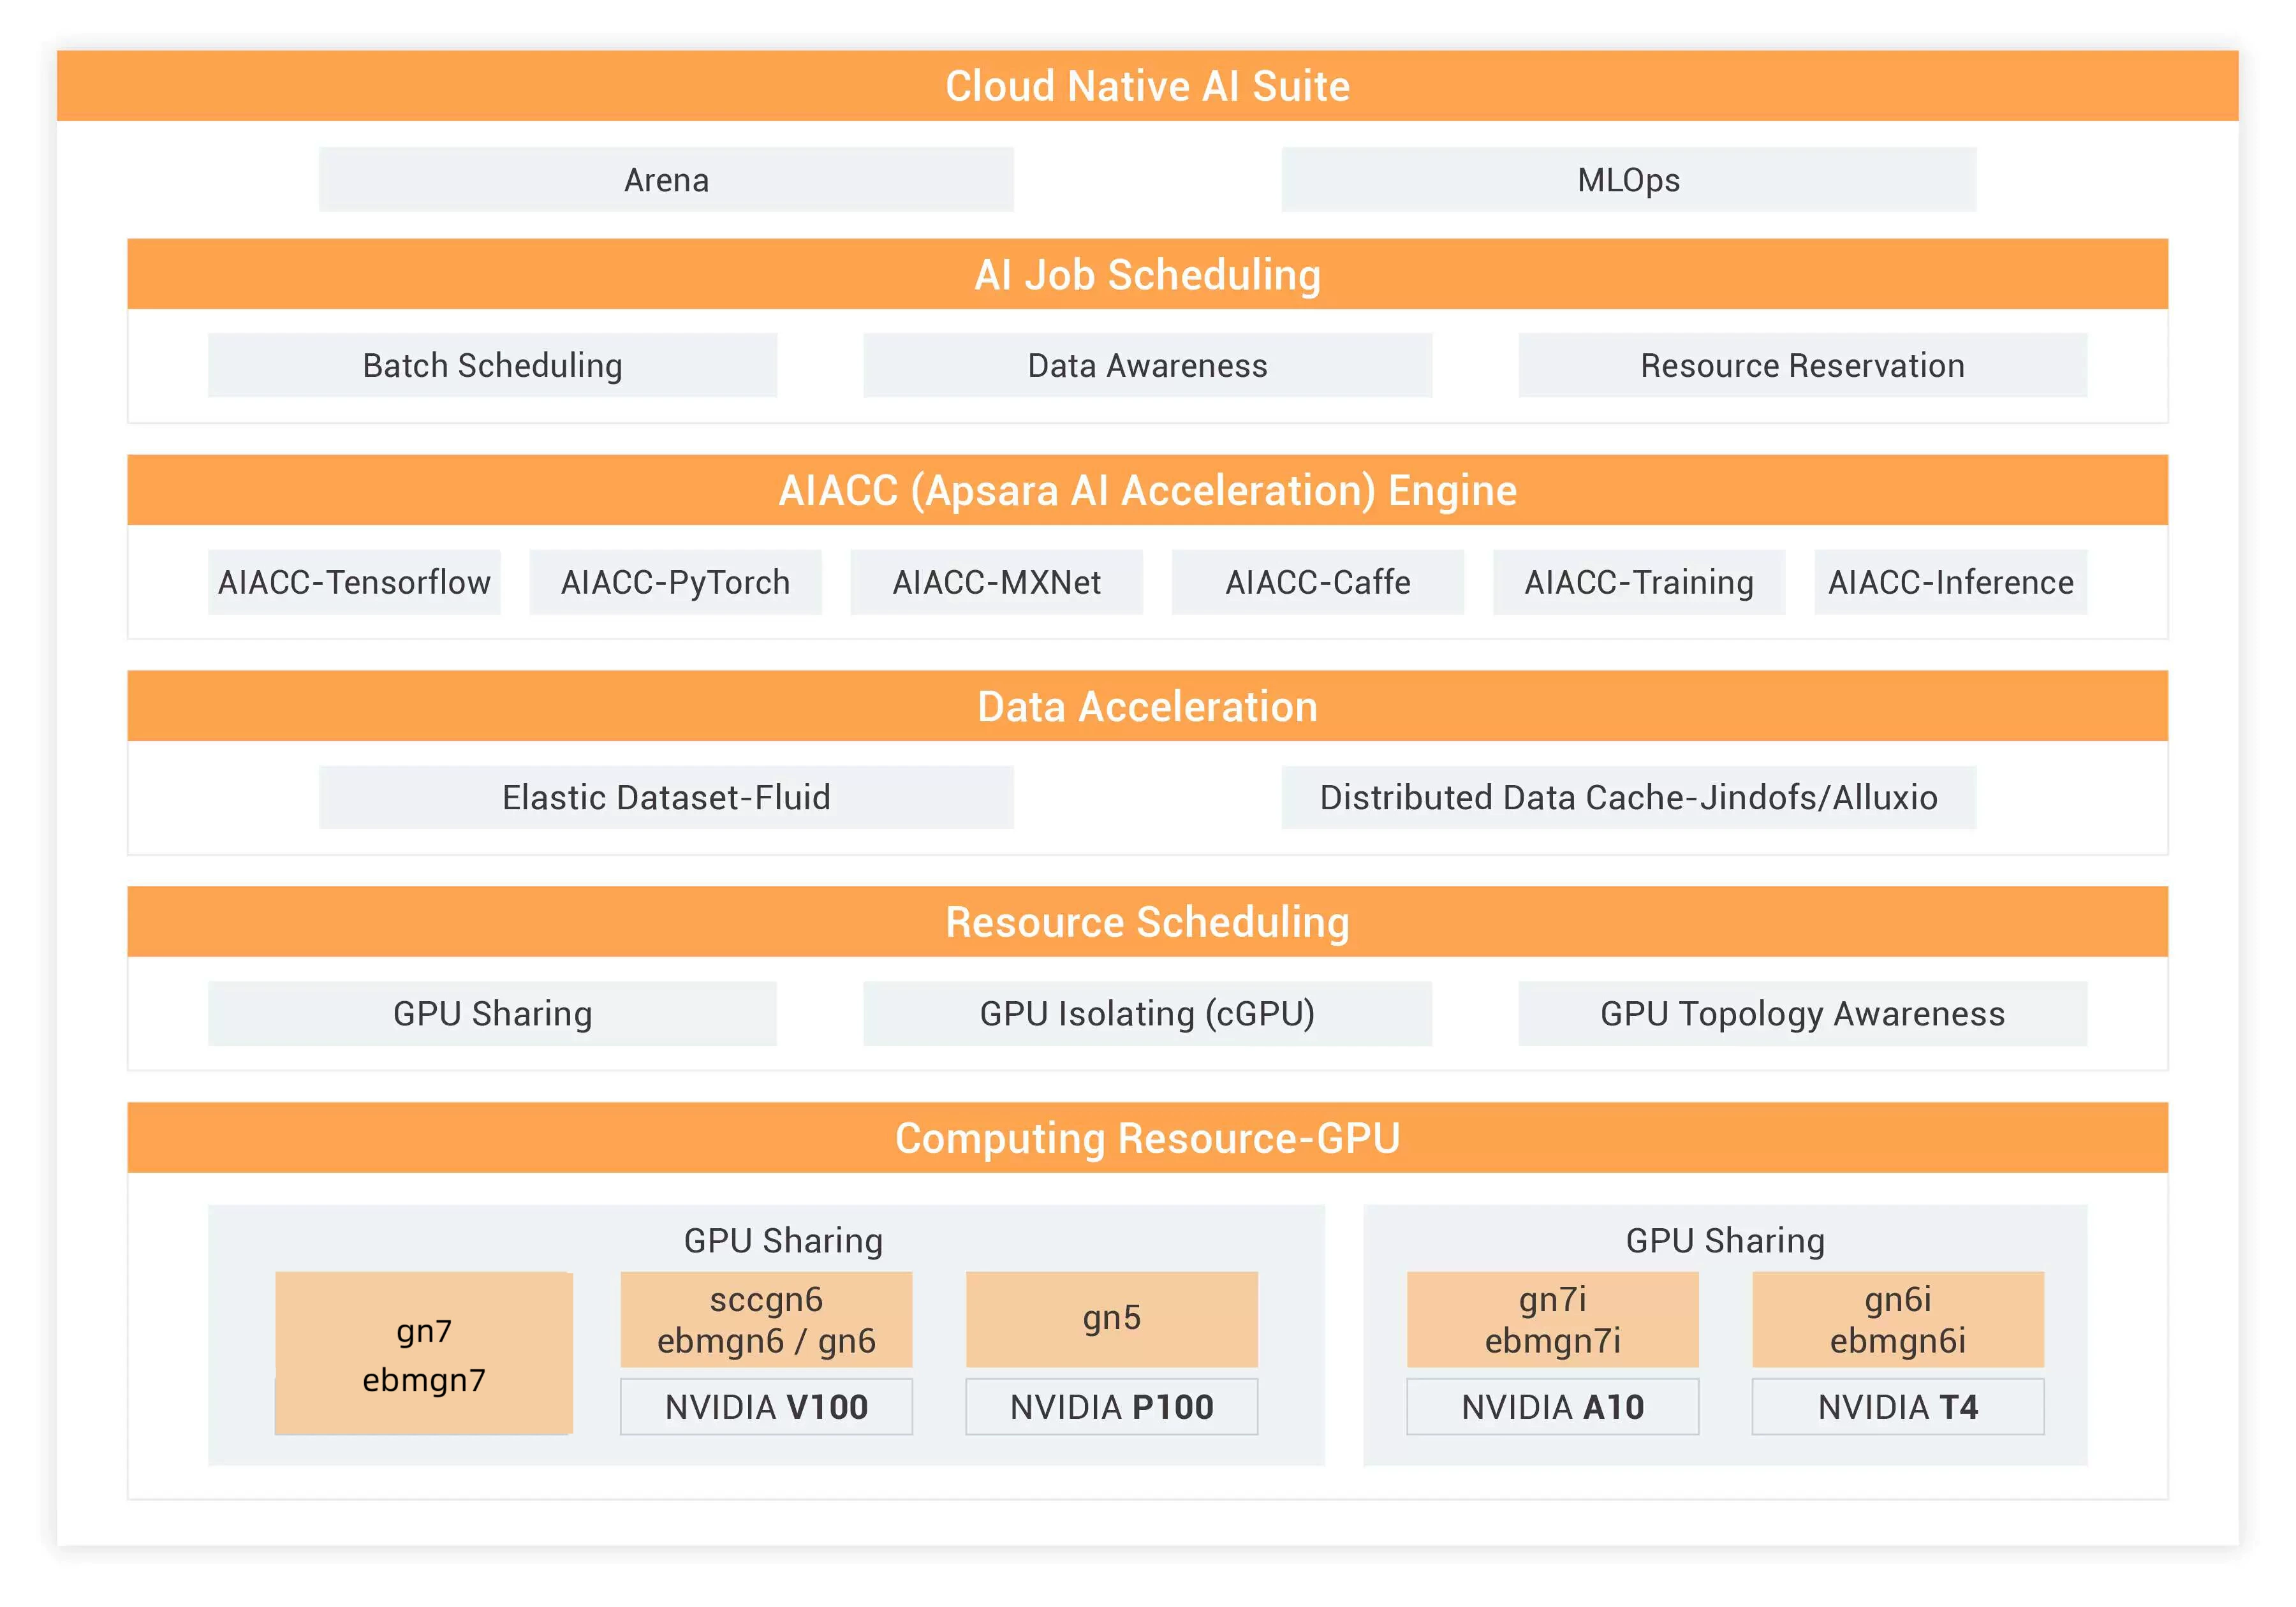
Solusi Alibaba AI Acceleration mencakup lapisan Cloud-Native AI Suite, lapisan AI Job Scheduling, lapisan AI Data Acceleration, lapisan AI Computing Acceleration Engine, lapisan Resource Scheduling, dan lapisan Computing Resource. Setiap lapisan menawarkan solusi akselerasi spesifik berdasarkan karakteristik aplikasi AI di berbagai skenario.
Cloud-Native AI Suite: Sederhanakan operasi dengan layanan dan komponen yang mendasarinya, pantau utilisasi resource GPU, serta kumpulkan dan analisis log job AI. Anda dapat menggunakan command line untuk mengirimkan job AI dan memeriksa jadwal pelatihan model.
AI Job Scheduling: Jadwalkan job AI untuk mempercepat pelatihan model, meningkatkan utilisasi GPU, dan menghemat biaya.
AIACC: Gunakan framework deep learning seperti TensorFlow, PyTorch, MXNet, dan Caffe untuk mengkategorikan gambar dan mencapai pengenalan gambar, prediksi Click-Through Rate, Natural Language Processing, pengenalan suara, pengenalan wajah, dll.
Data Acceleration: Adopsi arsitektur dengan resource penyimpanan dan komputasi yang terpisah, di mana data disimpan di perangkat berbeda dari on-premises dan pelatihan model dijalankan di Alibaba Cloud. Data disimpan dalam file kecil dan di-warm up sebelum pelatihan model untuk meningkatkan efisiensi transmisi dan pelatihan.
Resource Scheduling: Tingkatkan utilisasi GPU dan hemat biaya dengan membagikan resource GPU ke beberapa job AI serta menjalankan satu job AI pada beberapa GPU untuk pelatihan model terdistribusi.
Computing Resources-GPU: Kelola dan jadwalkan memori GPU serta daya komputasi sebagai container dengan cGPU untuk mempercepat pelatihan dan inference AI.
Utilisasi GPU Tinggi dengan cGPU
Maksimalkan efisiensi utilisasi GPU dan hemat biaya dengan mengelola dan menjadwalkan memori GPU serta daya komputasi sebagai container
SelengkapnyaKasus Penggunaan

Pengenalan Gambar
Pelatihan distribusi MXNet + SyncBN. Performa meningkat 50%.

NLP
Pelatihan distribusi pemrosesan bahasa alami. Performa meningkat 6 kali lipat.

Pengenalan Suara
Ubah suara menjadi teks. Teks dikirim ke siswa dan ditampilkan di layar saat siswa berbicara.

CTR (Click-Through Rate)
Pelatihan distribusi. Performa meningkat 6,6 kali lipat.
Penawaran Spesial
Elastic GPU Service
Kemampuan komputasi paralel yang kuat berbasis teknologi GPU
DISKON 15%
• Deep Learning
• Pemrosesan Video
• Komputasi Ilmiah
Penyimpanan File NAS
Penyimpanan terpasang jaringan yang sederhana, berskala, sesuai permintaan, dan andal untuk digunakan dengan instans ECS, HPC, dan Container Service.
DISKON 25%
• pay-as-you-go
• Sistem file NAS Kapasitas
• Sistem file NAS Performa
Container Registry
Platform kelas enterprise yang menyediakan manajemen aman dan distribusi image container secara efisien
• ACR EE Advanced Edition
• Keamanan Tingkat Enterprise
• Distribusi Global yang Dipercepat
Platform for AI
Platform End-to-end untuk data mining dan analisis
• Antarmuka Visual
• 100+ Komponen Algoritma
• Kemampuan Komputasi yang Kuat
Keamanan dan Kepatuhan
-
 CSA STAR
-
 ISO 27001
-
 Laporan SOC2 Tipe II
-
 C5
-
 MLPS 2.0
-
 MTCS
Kisah Sukses Pelanggan
"Sina Weibo terus menghemat biaya dengan menggunakan Function Compute untuk memproses file gambar. Kami tidak perlu lagi menyediakan banyak resource mesin idle untuk menangani lonjakan traffic pada jam sibuk. Engineer kami tidak perlu membuang waktu untuk manajemen infrastruktur, seperti memantau status server. Sebaliknya, mereka dapat fokus bekerja dengan tim produk kami untuk meningkatkan nilai bisnis."
Sina Weibo adalah platform media sosial yang bertujuan membantu pengguna membangun koneksi yang lebih baik. Platform ini menyediakan cara sederhana dan belum pernah ada sebelumnya bagi pengguna untuk membuat postingan secara real time. Pengguna dapat berinteraksi satu sama lain dan terhubung dengan orang-orang di seluruh dunia melalui konten yang viral namun informatif.
Resource Terkait
Whitepaper
Whitepaper Akselerasi AI
Whitepaper ini merupakan panduan lengkap mengenai mekanisme lapisan infrastruktur AI dan cara mendukung akselerasi AI.
Pelajari Selengkapnya >Praktik Terbaik
cGPU (GPU Sharing) untuk AI Inference
Dokumen ini memperkenalkan proses untuk men-deploy komponen cGPU di lingkungan ACK.
Pelajari Selengkapnya >Praktik Terbaik
Demo Akselerasi AI - AIACC + ACK (TensorFlow)
Demo ini membantu Anda melatih data ImageNet dengan TensorFlow 2.4 menggunakan AIACC, sebuah AI acceleration engine yang berjalan di ACK (K8s), untuk mempercepat pelatihan AI Anda.
Pelajari Selengkapnya >Praktik Terbaik
Demo Akselerasi AI - AIACC (TensorFlow)
Solusi ini membantu Anda melatih ImageNet dengan TensorFlow 2.4 menggunakan AIACC, sebuah AI Acceleration Engine, untuk mempercepat pelatihan AI Anda.
Pelajari Selengkapnya >Praktik Terbaik
Demo Akselerasi AI - AIACC + ACK (PyTorch)
Solusi ini membantu Anda melatih data ImageNet dengan PyTorch 1.9 menggunakan AIACC, sebuah AI Acceleration Engine yang berjalan di ACK (K8s), untuk mempercepat pelatihan AI Anda.
Pelajari Selengkapnya >Kursus Online
Mempercepat Tugas Deep Learning dengan AIACC
Demo ini menunjukkan bagaimana peningkatan 18%-74% dapat dicapai tanpa mengubah kode TensorFlow yang ada, serta mendemonstrasikan kekuatan AIACC menggunakan dataset digit tulisan tangan MNIST standar dan sampel rontgen dada COVID-19.
Pelajari Selengkapnya >