
Komponen Utama dari Framework Data Lake Cloud-Native
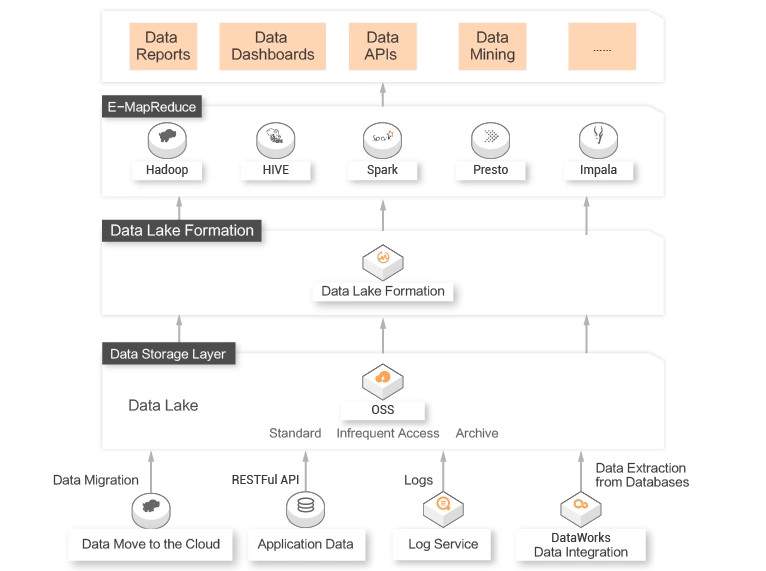
Data lake adalah repositori terpusat yang digunakan untuk data besar dan Komputasi AI. Ini mengizinkan Anda untuk menyimpan data terstruktur dan data tidak terstruktur pada skala apa pun. Pembentukan Danau Data (DLF) adalah Komponen utama dari framework data lake cloud-native. DLF menyediakan cara mudah untuk buat data lake cloud-native. Ini berintegrasi secara mulus dengan berbagai Mesin komputasi dan mengizinkan Anda untuk manage metadata di data lake secara terpusat dan mengontrol izin kelas perusahaan.
• Pengumpulan data yang mudah: secara sistematis mengumpulkan data terstruktur, semi-terstruktur, dan data tidak terstruktur dan mendukung penyimpanan data masif.
• Arsitektur fleksibel: menggunakan arsitektur yang memisahkan komputasi dari storage. Anda dapat merencanakan resource sesuai permintaan dengan biaya rendah. Ini meningkatkan efisiensi Pemrosesan data untuk memenuhi kebutuhan bisnis yang berubah dengan cepat.
• Manajemen data yang mudah: menggunakan penyimpanan data terpadu, menyimpan data dingin dan panas secara terpisah, dan men-manage lifecycle data. Ini menyelesaikan berbagai masalah O&M, seperti kegagalan untuk men-copy data di seluruh kluster.
• Ekstraksi nilai yang mudah: terhubung ke berbagai tipe platform komputasi dan analitik data. Ini menyelesaikan masalah silodata dan memberikan wawasan tentang nilai bisnis.
Fitur
-
![]()
Ingesti Data
Berbagai Tipe data dan channel Ingesti Data
Mengizinkan Anda untuk membersihkan data secara terpusat. -
![]()
Layanan Metadata
Penemuan metadata cerdas
Mengumpulkan metadata dari Sumber data yang berbeda untuk memfasilitasi management terpusat. -
![]()
Pengelolaan izin
Pengelolaan izin data kelas perusahaan
Mengizinkan Anda untuk menetapkan izin pada database, tabel, dan field. -
![]()
Akses Multi-engine
Akses ke berbagai Mesin komputasi upstream
Membantu Anda men-deploy solusi data lake end-to-end. -
![]()
Ekosistem Terbuka
Kompatibel dengan metastore Hive
Menyediakan API dalam berbagai bahasa pemrograman untuk integrasi yang mudah. -
![]()
Akselerasi Data
Akselerasi data berbasis JindoFS
Mengakselerasi analitik data lake dengan kinerja tinggi.
Skenario
Skenario
 Skenario umum
Sebuah platform Pemrosesan data dan analitik perlu di-buat di atas layanan dalam ekosistem data besar Alibaba Cloud, seperti E-MapReduce, Realtime Compute for Apache Flink, dan Data Lake Analytics (DLA).
Scale-out storage dan resource komputasi tidak mengimbangi peningkatan volume data. Oleh karena itu, optimalisasi biaya diperlukan.
Metadata dari sistem storage yang berbeda sulit untuk di-manage.
Manfaat
-
Management metadata
DLF dapat secara otomatis menemukan dan mengumpulkan metadata dari berbagai engine dan men-manage metadata secara terpusat untuk menyelesaikan masalah silodata.Layanan profesional
Tim data besar Alibaba Cloud memberi Anda layanan tingkat ahli.
Skenario
Skenario umum
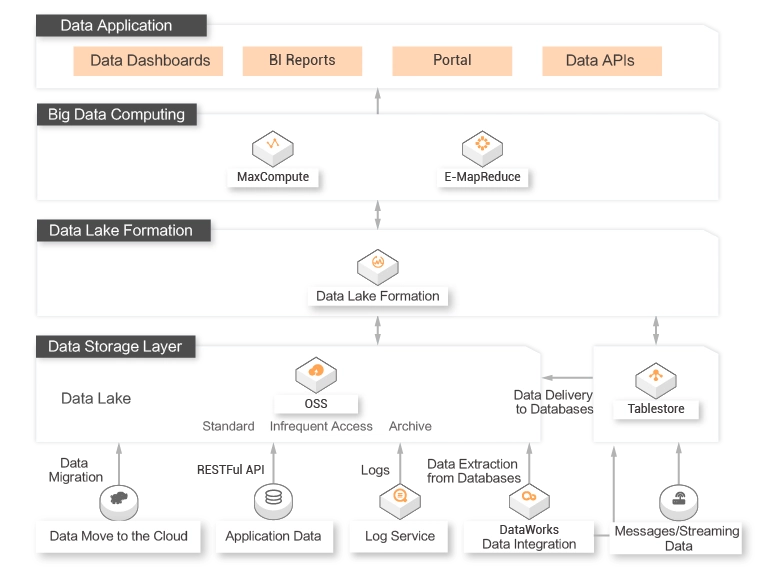
Dalam sebagian besar kasus, arsitektur data lake atau arsitektur gudang data digunakan dalam skenario data besar.
Keuntungan:
Jika arsitektur data lake digunakan, sistem penyimpanan file yang mendasarinya dibuka untuk membuat Ingesti Data menjadi fleksibel.
Jika arsitektur gudang data digunakan, persyaratan kelas perusahaan untuk efisiensi Pemrosesan data, manajemen data berskala besar, keamanan, dan kepatuhan dapat terpenuhi.
Data lake perlu diintegrasikan dengan gudang data untuk mengimbangi perkembangan bisnis. DLF dan gudang data Alibaba Cloud, seperti MaxCompute, Gudang Data Real-time, dan AnalitikDB untuk MySQL, membantu Anda buat danau data terpadu. Danau data terpadu secara dinamis men-transfer data dan resource komputasi di seluruh data lake dan gudang data. Dengan cara ini, ekosistem data besar yang lengkap di-buat.
Manfaat
-
Nol O&M
DLF menyediakan layanan yang di-manage sepenuhnya. Ini mengizinkan Anda untuk buat data lake di cloud dengan beberapa klik.Keamanan tinggi
DLF menggunakan sistem Pengelolaan izin terpadu untuk mengontrol izin pada database, tabel, dan kolom.
Skenario
Skenario umum
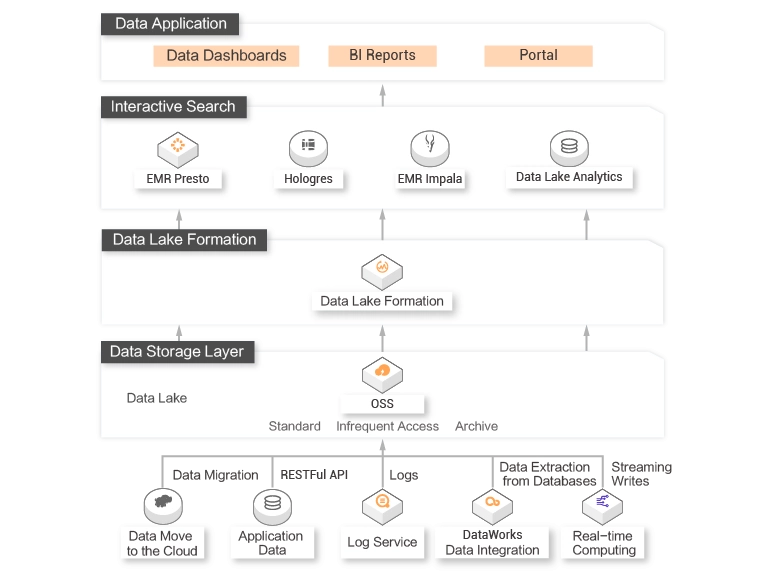
Sejumlah besar tipe data OSS yang berbeda perlu di-kueri dan dianalisis dalam berbagai dimensi, sebagai contoh, analisis real-time, kueri OLAP, dan output hasil ke sistem bisnis.
Saat Anda men-kueri data, data lake dapat mengakses berbagai Mesin komputasi di cloud. Anda tidak perlu men-transfer semua data ke sistem kueri.
Manfaat
-
Ingesti Data real-time
DLF meng-ingest data ke dalam data lake secara real time untuk pastikan Ketepatan waktu bisnis.Penemuan metadata Otomatis
DLF dapat secara otomatis menangkap, mengorkestrasi, dan menyiapkan data untuk analitik. Operasi manual yang kompleks tidak diperlukan.
Skenario
Skenario umum
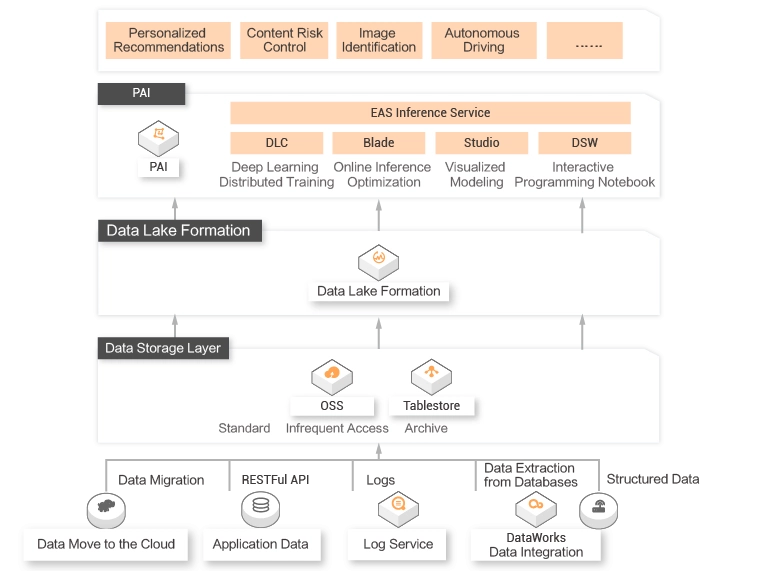
Data lake diperlukan untuk pengguna dalam skenario pembelajaran mesin dan pembelajaran mendalam.
Dalam skenario pembelajaran mesin, Anda mungkin menghadapi masalah, seperti sejumlah besar data, Pelatihan model yang lambat, dan kinerja algoritma yang buruk. Data lake harus dapat terhubung ke platform pembelajaran mesin yang matang dan menyesuaikan resource GPU secara dinamis untuk mengurangi biaya.
Manfaat
-
Mudah digunakan
DLF berintegrasi secara mulus dengan Platform Pembelajaran Mesin untuk AI (PAI) dan menyediakan berbagai API untuk integrasi.Pembersihan data terpadu
DLF mengizinkan Anda untuk membersihkan dan me-Normalisasi data sebelum data di-ingest ke dalam data lake. Hal ini membantu Anda melakukan operasi analitik berikutnya dengan menggunakan PAI.
Skenario Industri
Pendidikan Online
Platform Pendidikan Online dengan Lebih Dari 100 Juta PenggunaKebutuhan pelanggan
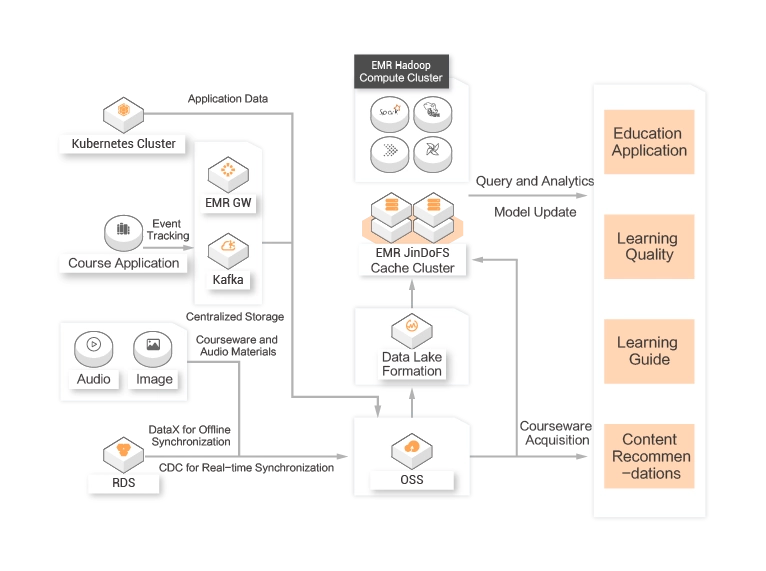
Data, seperti materi kursus, log aplikasi, dan sampel studi, perlu disimpan dan di-manage secara terpusat.
Pemutaran materi kursus, analitik offline, dan pembelajaran mesin perlu diimplementasikan untuk berbagai tipe data dalam skenario pendidikan online yang berbeda.Nilai pelanggan
DLF dapat terhubung ke OSS dan sejumlah besar Mesin komputasi untuk memenuhi persyaratan analitik yang berbeda.
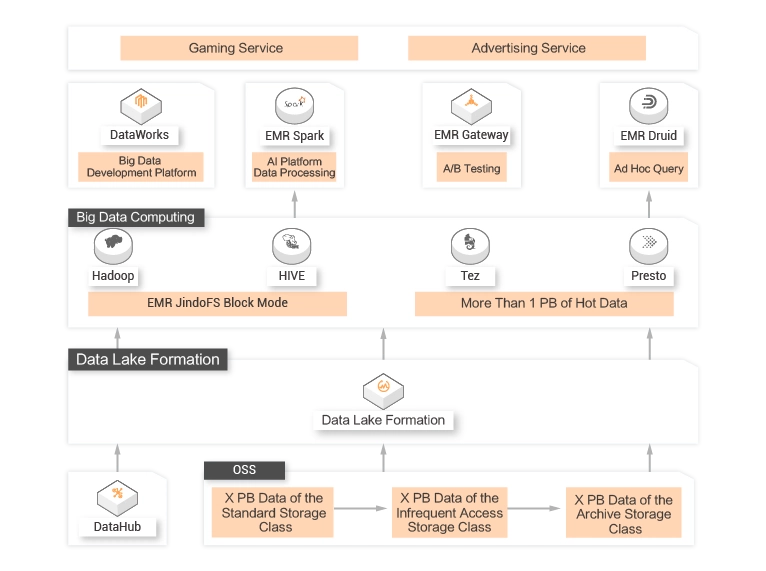
Game Online
Perusahaan Hiburan Interaktif Terkemuka di AsiaKebutuhan pelanggan
Data perlu dianalisis untuk menyesuaikan kesulitan game, mengurangi laju drop item, dan meningkatkan laju produksi resource. Hal ini membantu meningkatkan pengalaman bermain game dan meningkatkan laju retensi pemain.
Resource cloud perlu diskalakan secara dinamis dan di-upgrade. Sebuah arsitektur yang memisahkan komputasi dari storage diperlukan untuk memastikan elastisitas resource.Nilai pelanggan
DLF membantu Anda buat data lake di cloud yang memisahkan storage dari komputasi. Selain itu, DLF dapat dihubungkan dengan Mesin komputasi dan analitik real-time. Hal ini membantu Anda menyesuaikan bisnis secara real time.
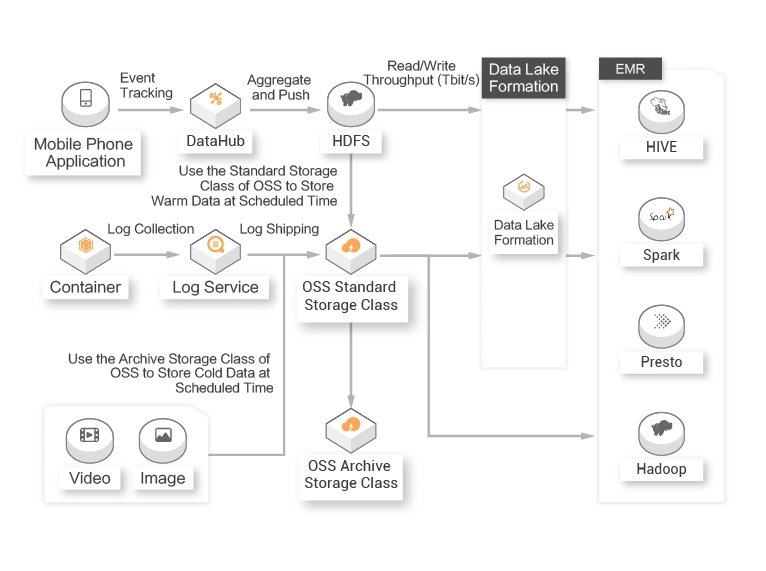
Media Baru Hiburan Interaktif
Platform Media Baru Internet dengan Lebih Dari 100 Juta Pengguna Aktif Per BulanKebutuhan pelanggan
Metadata dari berbagai sistem storage perlu di-manage secara terpusat. Berbagi data dan analitik diperlukan untuk pengembangan bisnis.Nilai pelanggan
DLF mengizinkan Anda untuk manage metadata dari sistem storage yang berbeda secara terpusat. Layanan penemuan metadata DLF dapat mengumpulkan dan mengkatalogkan data dari database Anda dan bucket Object Storage Service (OSS).
Produk dan Layanan Terkait
E-MapReduce
Layanan pemrosesan data besar
MaxCompute
Pergudangan data berskala besar
Gudang Data Real-time
Analitik real-time yang kompatibel dengan PostgreSQL

