Mixtral-8x7B是Mistral AI开源的稀疏专家混合(MoE)大语言模型,在多项基准测试上表现优于GPT-3.5。通过PAI Model Gallery,您可以快速完成Mixtral-8x7B的微调和部署。
模型介绍
Mixtral-8x7B是基于编码器(Decoder-Only)架构的稀疏专家混合网络(Sparse Mixture-of-Experts,SMoE)开源大语言模型,使用Apache 2.0协议发布。它的独特之处在于对于每个Token,路由器网络选择八组专家网络中的两组进行处理,将两组专家的输出累加组合,因此虽然Mixtral-8x7B拥有总共47B的参数,但每个Token实际上只使用13B的活跃参数,推理速度与参数规模为13B的模型相当。
Mixtral-8x7B支持多种语言,包括法语、德语、西班牙语、意大利语和英语,支持的上下文长度为32 K 的Token,并且在所有的评估的基准测试中均达到或优于LLaMA2-70B和 GPT-3.5,特别是在数学、代码生成和多语言基准测试中,Mixtral大大优于LLaMA2-70B。
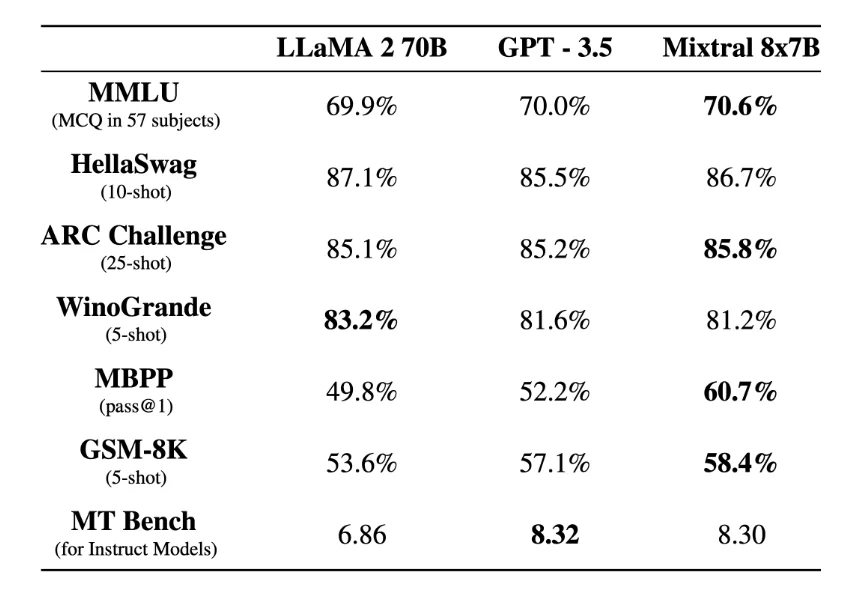
图源:https://arxiv.org/abs/2401.04088
Mistral AI同时发布了指令微调版本 Mixtral-8x7B-Instruct-v0.1,通过监督微调和直接偏好优化(DPO)提升指令遵循能力,对话能力领先其他开源指令微调模型。
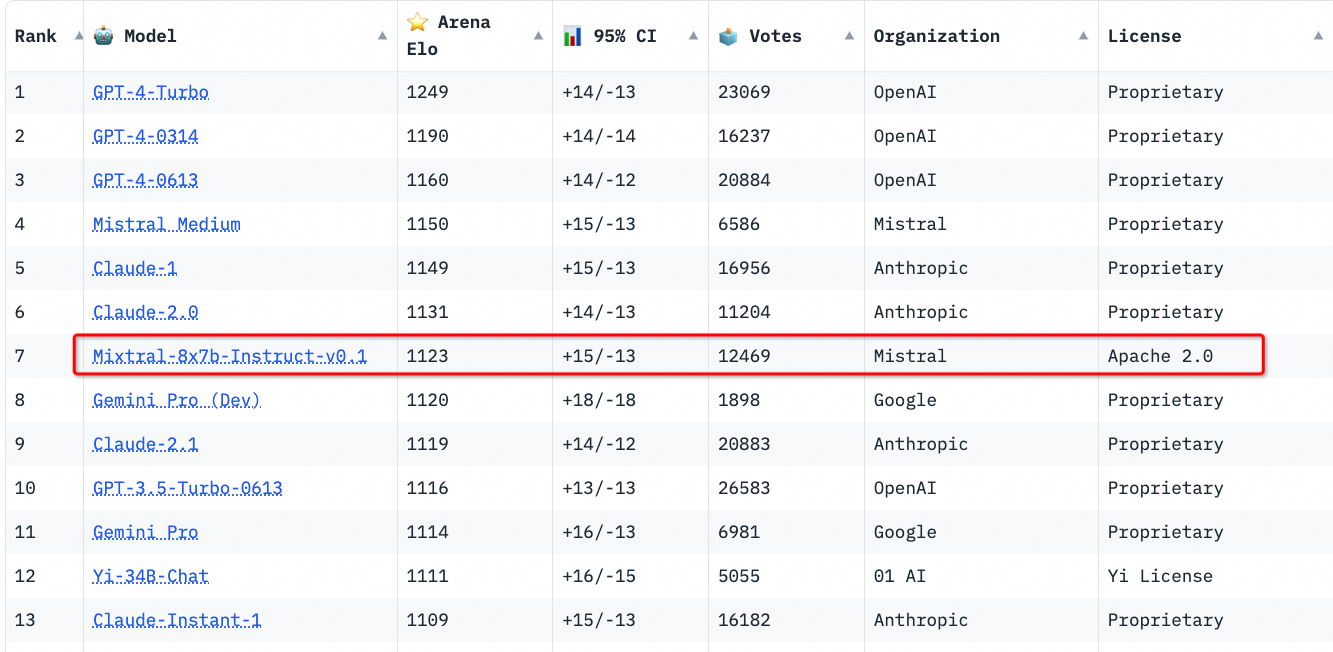
图源:https://huggingface.co/spaces/lmsys/chatbot-arena-leaderboard
前提条件
已开通灵骏智算资源,详情请参见新建资源组并购买灵骏智算资源。
运行环境要求
由于模型本身较大,本示例目前仅支持在华北6(乌兰察布)使用PAI灵骏集群环境运行。
资源配置要求:GPU 推荐使用GU108(80 GB显存),推理需要2卡及以上资源,LoRA微调需要4卡及以上资源。
通过PAI控制台使用模型
模型部署和调用
进入Model Gallery页面。
登录PAI控制台。
选择目标地域为华北6(乌兰察布)。
在左侧导航栏单击工作空间列表,在工作空间列表页面中单击待操作的工作空间名称,进入对应工作空间内。
在左侧导航栏单击快速开始 > Model Gallery,进入Model Gallery页面。
在Model Gallery页面右侧的模型列表中,单击Mixtral-8x7B-Instruct-v0.1模型卡片,进入模型详情页面。
单击右上角部署,配置灵骏计算资源,单击部署,即可将模型部署到EAS推理服务平台。
当前模型需要使用灵骏智算资源部署,请确保资源配额(Quota)中至少有2张GU108 GPU卡。
在部署配置面板中,资源组种类选择灵骏智算资源,并设置实例数为1、CPU为40、内存(MB)为256000,然后单击部署。
调用推理服务。
通过HTTP API调用
推理服务支持OpenAI API风格调用。在服务详情页获取访问地址(Endpoint)和访问凭证(Token),使用CURL调用示例如下:
# 请注意替换为使用服务的Endpoint和Token
export API_ENDPOINT="<ENDPOINT>"
export API_TOKEN="<TOKEN>"
# 查看模型list
curl $API_ENDPOINT/v1/models \
	-H "Content-Type: application/json" \
	-H "Authorization: Bearer $API_TOKEN"
# 调用通用的文本生成API
curl $API_ENDPOINT/v1/completions \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer $API_TOKEN" \
    -d '{
			"model": "Mixtral-8x7B-Instruct-v0.1",
			"prompt": "San Francisco is a",
			"max_tokens": 256,
			"temperature": 0
	}'
curl $API_ENDPOINT/v1/chat/completions \
    -H "Authorization: Bearer $API_TOKEN" \
    -H "Content-Type: application/json" \
    -d '{
			"model": "Mixtral-8x7B-Instruct-v0.1",
      "messages": [
          {"role": "user", "content": "介绍一下上海的历史"}
        ]
      }'
通过SDK调用
通过OpenAI的SDK进行调用时,首先需要安装SDK:
# 安装服务调用SDK
python -m pip install openai
通过SDK调用推理服务的示例代码如下:
import openai
# 请使用服务详情页获取的访问地址(ENDPOINT)和访问凭证(TOKEN)替换以下代码的配置。
openai.api_key = "<TOKEN>"
openai.base_url = "<ENDPOINT>" + "/v1"
# 调用对话API
completion = openai.chat.completions.create(
    model="Mixtral-8x7B-Instruct-v0.1",
    temperature=0.0,
    top_p=0.8,
    frequency_penalty=0.0,
    messages=[{"role": "user", "content": "请介绍下你自己。"}],
    # stream=True,
)
# 打印输出内容
print(completion.choices[0].message.content)
模型微调训练
PAI-Model Gallery为Mixtral-8x7B-Instruct-v0.1配置了微调算法,开箱即用,无需额外配置。
训练算法支持使用JSON格式输入,每条数据由问题、答案组成,分别用"instruction"、"output"字段表示,例如:
[
    {
        "instruction": "Write a poem on a topic 'On a Political Prisoner': \n",
        "output": "She that but little patience knew,\r\nFrom childhood on, had now so much\r\nA grey gull lost its fear and flew\r\nDown to her cell and there alit,\r\nAnd there endured her fingers' touch\r\nAnd from her fingers ate its bit.\r\nDid she in touching that lone wing."
    },
    {
        "instruction": "Write a poem on a topic 'To His Love': ",
        "output": "He's gone, and all our plans\r\n   Are useless indeed.\r\nWe'll walk no more on Cotswold\r\n   Where the sheep feed\r\n   Quietly and take no heed.\r\n His body that was so quick\r\n   Is not as you\r\nKnew it, on Severn river\r\n   Under the blue\r\n   Driving our small boat through."
    }
]在模型详情页单击右上角训练。关键配置如下:
数据集配置:准备好数据后,上传到OSS Bucket中,或指定NAS/CPFS存储上的数据集。也可以使用PAI预置的公共数据集直接测试。
计算资源配置:算法需要使用4张GU108(80 GB显存)的GPU资源,请确保选择使用的资源配额内有充足的计算资源。
超参数配置:支持的超参如下,可按需调整,或使用默认值。
超参数
类型
默认值
是否必须
描述
learning_rate
float
5e-5
是
学习率,用于控制模型权重,调整幅度。
num_train_epochs
int
1
是
训练数据集被重复使用的次数。
per_device_train_batch_size
int
1
是
每个GPU在一次训练迭代中处理的样本数量。较大的批次大小可以提高效率,也会增加显存的需求。
seq_length
int
128
是
序列长度,指模型在一次训练中处理的输入数据的长度。
lora_dim
int
16
否
LoRA维度,当lora_dim>0时,使用LoRA/QLoRA轻量化训练。
lora_alpha
int
32
否
LoRA权重,当lora_dim>0时,使用LoRA/QLoRA轻量化训练,该参数生效。
load_in_4bit
bool
true
否
模型是否以4 bit加载。
当lora_dim>0、load_in_4bit为true且load_in_8bit为false时,使用4 bit QLoRA轻量化训练。
load_in_8bit
bool
false
否
模型是否以8 bit加载。
当lora_dim>0、load_in_4bit为false且load_in_8bit为true时,使用8 bit QLoRA轻量化训练。
gradient_accumulation_steps
int
8
否
梯度累积步骤数。
apply_chat_template
bool
true
否
算法是否为训练数据加上模型默认的chat template,示例:
问题:
<|begin_of_text|><|start_header_id|>user<|end_header_id|>\n\n + instruction + <|eot_id|>答案:
<|start_header_id|>assistant<|end_header_id|>\n\n + output + <|eot_id|>
单击训练,PAI-Model Gallery自动跳转到模型训练页面,开始训练,您可以查看训练任务状态和训练日志。
单击右上角Tensorboard,您也可以一键打开TensorBoard查看模型的收敛情况。
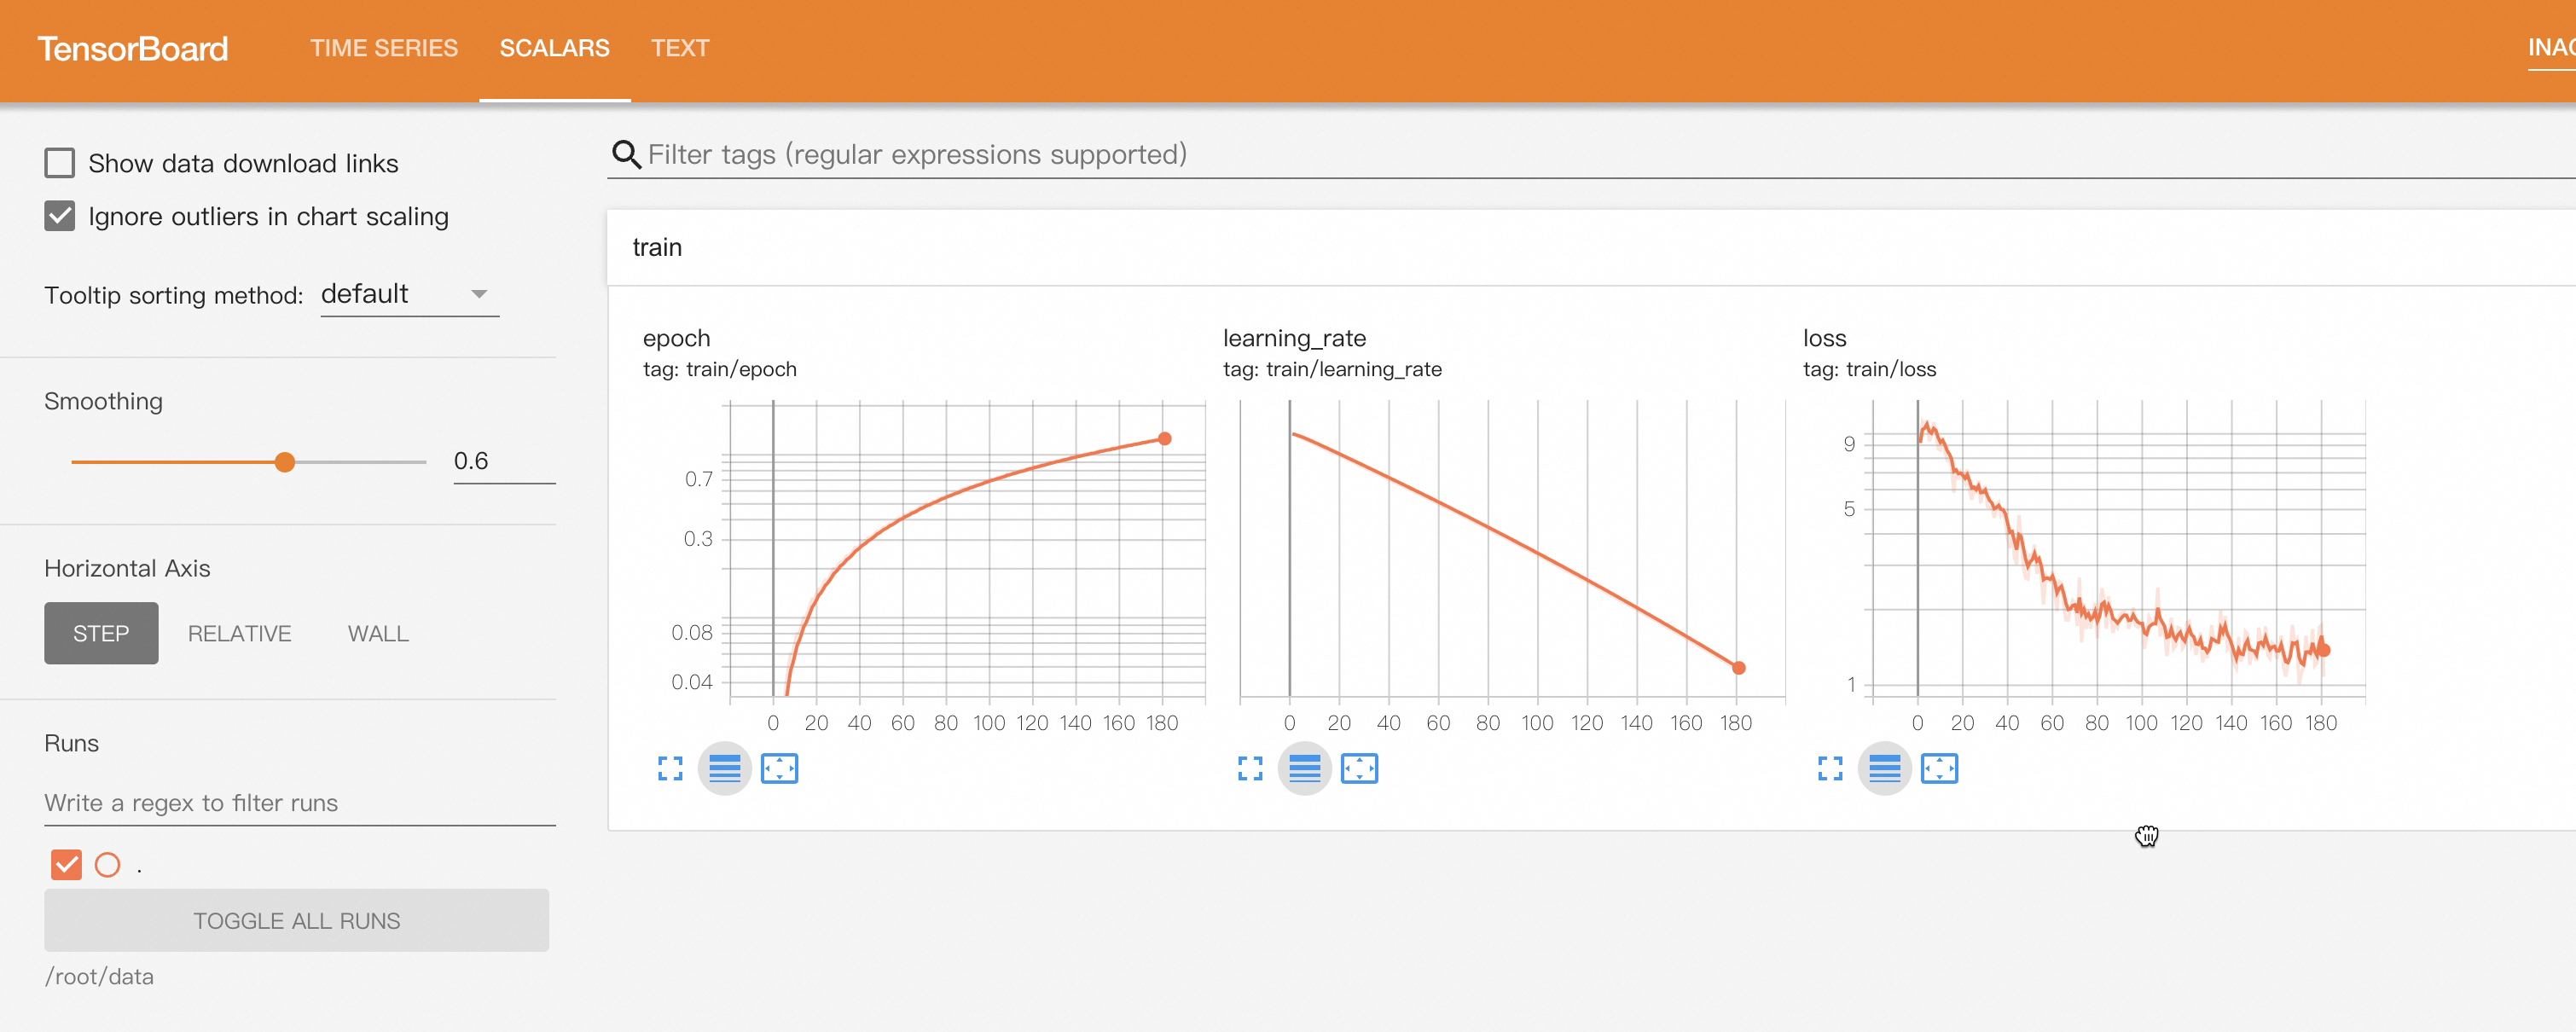
训练好的模型会自动注册到AI资产-模型管理中,您可以查看或部署对应的模型,详情请参见注册及管理模型。
通过PAI Python SDK使用模型
PAI-Model Gallery提供的预训练模型支持通过PAI Python SDK调用。首先安装并配置SDK,在命令行执行以下代码:
# 安装PAI Python SDK
python -m pip install alipai --upgrade
# 交互式的配置访问凭证、PAI工作空间等信息
python -m pai.toolkit.config
如何获取SDK配置所需的访问凭证(AccessKey)、PAI工作空间等信息请参考安装和配置。
模型部署和调用
提供资源信息和服务名称,即可将Mixtral模型部署到PAI-EAS推理平台。
from pai.session import get_default_session
from pai.model import RegisteredModel
from pai.common.utils import random_str
from pai.predictor import Predictor
session = get_default_session()
# 获取PAI QuickStart 提供的模型
m = RegisteredModel(
    model_name="Mixtral-8x7B-Instruct-v0.1",
    model_provider="pai",
)
# 查看模型默认的部署配置
print(m.inference_spec)
# 部署推理服务
# 需提供使用灵骏资源配额ID(QuotaId),要求至少 >= 2张GU108(80G显存)GPU卡的计算资源.
predictor = m.deploy(
    service_name="mixtral_8_7b_{}".format(random_str(6)),
    options={
        # 资源配额ID
        "metadata.quota_id": "<LingJunResourceQuotaId>",
        "metadata.quota_type": "Lingjun",
        "metadata.workspace_id": session.workspace_id,
    }
)
# 获取推理服务的Endpoint和Token
endpoint = predictor.internet_endpoint
token = predictor.access_token
推理服务的调用请参见上述调用推理服务,或是直接使用PAI Python SDK进行调用。
from pai.predictor import Predictor
p = Predictor("<MixtralServiceName>")
res = p.raw_predict(
    path="/v1/chat/completions",
    method="POST",
    data={
        "model": "Mixtral-8x7B-Instruct-v0.1",
        "messages": [
            {"role": "user", "content": "介绍一下上海的历史"}
        ]
    }
)
print(res.json())
当测试完成,需要删除服务释放资源,您可以通过控制台或SDK完成。
# 删除服务
predictor.delete_service()
模型的微调训练
通过SDK获取预训练模型后,可查看模型配置的微调算法,包括超参配置和输入输出数据。
from pai.model import RegisteredModel
# 获取PAI QuickStart 提供的 Mixtral-8x7B-Instruct-v0.1 模型
m = RegisteredModel(
    model_name="Mixtral-8x7B-Instruct-v0.1",
    model_provider="pai",
)
# 获取模型配置的微调算法
est = m.get_estimator()
# 查看算法支持的超参,以及算法输入输出信息
print(est.hyperparameter_definitions)
print(est.input_channel_definitions)
Mixtral-8x7B-Instruct-v0.1的微调算法仅支持灵骏智算资源。在PAI控制台查看资源配额ID,设置训练任务的资源信息。提交前根据算法支持的超参,配置合适的训练超参。
# 配置训练作业使用的灵骏资源配额ID
est.resource_id = "<LingjunResourceQuotaId>"
# 配置训练作业超参
hps = {
    "learning_rate": 1e-5,
    "per_device_train_batch_size": 2,
}
est.set_hyperparameters(**hps)
微调算法支持3个输入,分别为:
model:预训练模型Mixtral-8x7B-Instruct-v0.1。train:微调使用的训练数据集。validation:微调使用的验证数据集。
数据集的格式请参见上述模型微调训练,您可以通过ossutils、控制台操作等方式上传数据到OSS Bucket,也可以使用SDK提供的方法上传到您配置的OSS Bucket。
from pai.common.oss_utils import upload
# 查看模型微调算法的使用的输入信息
# 获取算法的输入数据,包括模型和供测试的公共读数据集.
training_inputs = m.get_estimator_inputs()
print(training_inputs)
# {
#     "model": "oss://pai-quickstart-cn-wulanchabu.oss-cn-wulanchabu-internal.aliyuncs.com/huggingface/models/Mixtral-8x7B-Instruct-v0.1/main/",
#     "train": "oss://pai-quickstart-cn-wulanchabu.oss-cn-wulanchabu-internal.aliyuncs.com/huggingface/datasets/llm_instruct/en_poetry_train_mixtral.json",
#     "validation": "oss://pai-quickstart-cn-wulanchabu.oss-cn-wulanchabu-internal.aliyuncs.com/huggingface/datasets/llm_instruct/en_poetry_test_mixtral.json",
# }
# 上传用户数据,请注意替换一下的本地文件路径和上传的OSS Bucket路径.
train_data_uri = upload("/path/to/local/train.json", "path/of/train/data")
validation_data_uri = upload("/path/to/local/validation.json", "path/of/validation/data")
# 替换使用开发者的训练数据
# training_inputs["train"] = train_data_uri
# training_inputs["validation"] = validation_data_uri
按上述格式准备数据,将train和validation输入替换为自己的数据集,即可提交微调训练作业。通过SDK打印的链接,可在PAI控制台查看训练状态和日志,也可通过TensorBoard查看训练进度和模型收敛情况。
from pai.common.oss_utils import download
# 提交训练作业,同时打印训练作业链接
est.fit(
    inputs=training_inputs,
    wait=False,
)
# 打开TensorBoard查看训练进度
est.tensorboard()
# 等待训练任务结束
est.wait()
# 查看保存在OSS Bucket上的模型路径
print(est.model_data())
# 用户可以通过ossutils,或是SDK提供的便利方法下载相应的模型到本地
download(est.model_data())
更多关于如何通过SDK使用PAI-Model Gallery提供的预训练模型,请参见使用预训练模型 — PAI Python SDK。