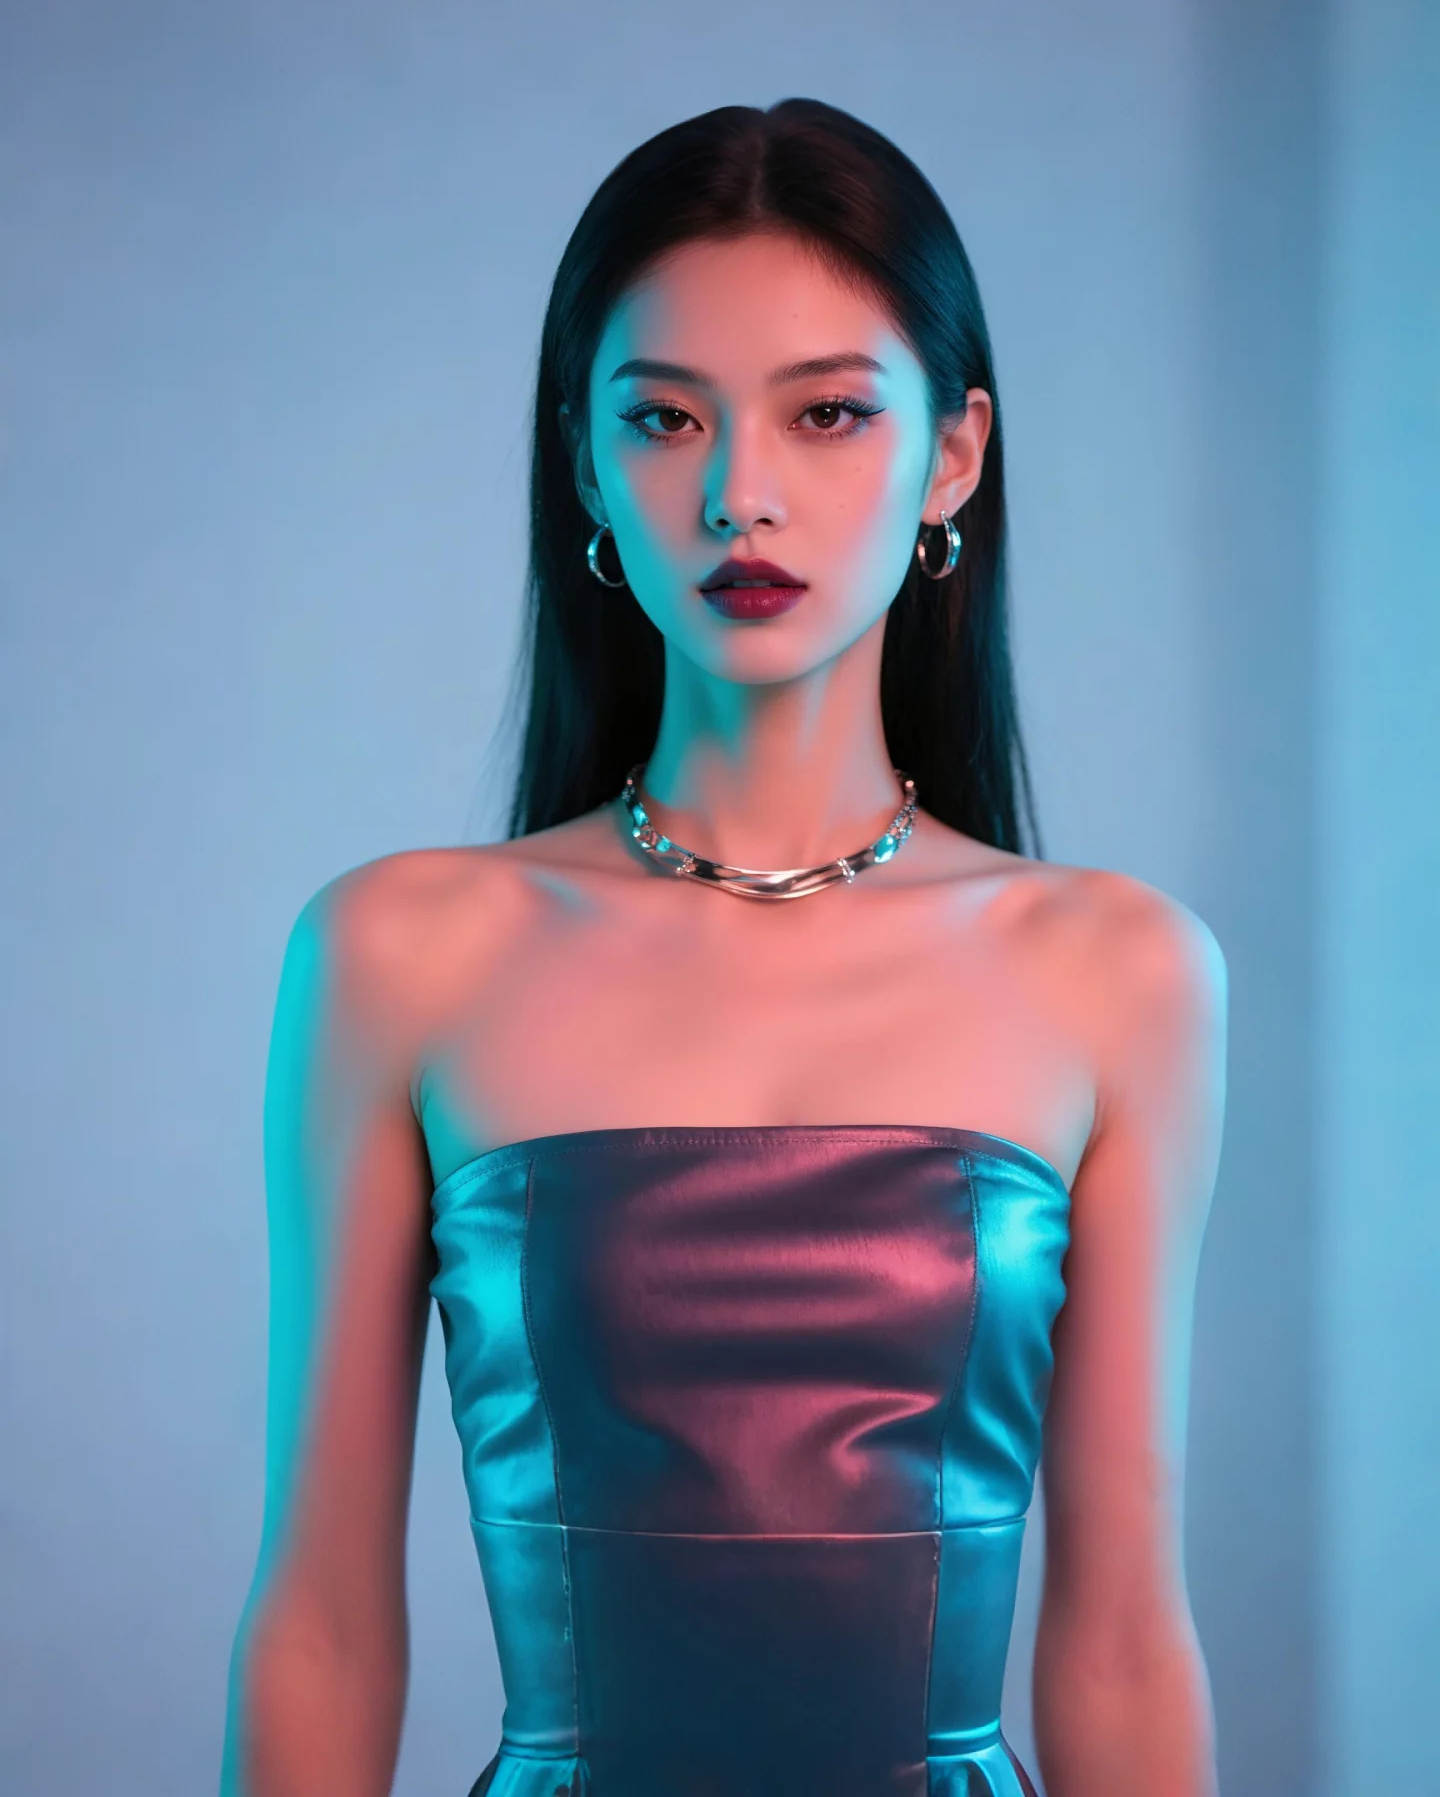
数字人wan2.2-s2v模型支持基于 单张图片和音频 ,生成动作自然的说话、唱歌或表演视频,不限制形象画幅,支持 肖像、全身或半身 的人物图像。
重要本文档仅适用于华北2(北京)地域。如需使用模型,需使用华北2(北京)地域的API Key。
模型概览
效果示例
| 输入示例 | 输出视频 |
|---|---|
 输入音频 |
生成数字人视频的流程为:
- 步骤1:调用 wan2.2-s2v-detect 接口,传入图片URL,确认图片合规。
- 步骤2:若检测通过,调用 wan2.2-s2v 异步接口,传入图片URL和音频URL,提交视频生成任务,并轮询获取结果。
快速开始
前提条件
在调用前,您需要开通模型服务并获取API Key,再配置API Key到环境变量。
示例代码
本文的示例图片已通过图像检测,以下展示视频生成的示例代码。
说明HTTP 请求分两步:先创建任务,再获取结果。
步骤1:创建任务获取任务ID
该请求会返回一个task_id用于查询结果。
curl 'https://dashscope.aliyuncs.com/api/v1/services/aigc/image2video/video-synthesis' \
 --header 'X-DashScope-Async: enable' \
 --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
 --header 'Content-Type: application/json' \
 --data '{
     "model": "wan2.2-s2v",
     "input": {
            "image_url": "https://img.alicdn.com/imgextra/i3/O1CN011FObkp1T7Ttowoq4F_!!6000000002335-0-tps-1440-1797.jpg",
            "audio_url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20250825/iaqpio/input_audio.MP3"
        },
        "parameters": {
            "style": "speech"
        }
    }'
步骤2:根据任务ID查询结果
请将86ecf553-d340-4e21-xxxxxxxxx替换为真实的task_id。
各地域的API Key不同。获取与配置 API Key。
若使用华北2(北京)地域的模型,需将base_url替换为https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api/v1/tasks/86ecf553-d340-4e21-xxxxxxxxx,其中{WorkspaceId}需替换为真实的业务空间ID。
curl -X GET https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/tasks/86ecf553-d340-4e21-xxxxxxxxx \
--header "Authorization: Bearer $DASHSCOPE_API_KEY"
task_id查询有效期为24小时,过期将无法查询,接口将返回任务状态为UNKNOWN。
下一步
根据您的具体需求,查阅API文档开始您的开发工作: