Bu konuda, Spark ile birden çok kaynaktan veri okuma ve bu verileri Hologres'e yazma işlemlerinin nasıl yapılacağı açıklanmaktadır.
Arka plan bilgileri
Spark, büyük miktardaki veriyi merkezi olarak işleyen bir analiz motorudur. Hologres, Apache Spark ve E-MapReduce (EMR) Spark ile entegre çalışır; böylece veri ambarlarınızı verimli şekilde oluşturabilirsiniz. Hologres, verileri toplu iş modunda Hologres'e yazmanızı sağlayan Spark bağlayıcısını sunar. Spark ile dosyalar, Hive tabloları, MySQL tabloları ve PostgreSQL tabloları gibi çeşitli kaynaklardan veri okuyabilirsiniz.
Hologres, PostgreSQL ile uyumludur. Spark kullanarak PostgreSQL üzerinden Hologres verilerini okuyabilirsiniz. Ardından verileri çıkarabilir, dönüştürebilir ve yükleyebilir (ETL); işlenen verileri tekrar Hologres'e veya başka hedeflere yazabilirsiniz.
Ön koşullar
Hologres örneğinizin sürümü V0.9 veya üzeri olmalıdır. Hologres konsolundaki örnek ayrıntıları sayfasından Hologres örneğinizin sürümünü görüntüleyebilirsiniz. Hologres örneğinizin sürümü V0.9'dan önceyse, Hologres konsolunda Hologres örneğinizi manuel olarak yükseltin veya teknik destek için Hologres DingTalk grubuna katılın. Hologres konsolunda Hologres örneğinizi manuel olarak nasıl yükselteceğiniz hakkında daha fazla bilgi için bkz. Örnek yükseltmeleri. Teknik destek alma hakkında daha fazla bilgi için bkz. Hologres için çevrimiçi destek alın.
Hologres tarafından desteklenen bir sürümde Spark ortamı yüklü olmalıdır. Bu sayede Spark ortamında
spark-shellkomutunu çalıştırabilirsiniz.
Bağlantıların kullanımı
Veri okumak veya yazmak için Hologres Spark bağlayıcısını kullandığınızda Java Database Connectivity (JDBC) bağlantıları devreye girer. Kullanılacak bağlantı sayısı aşağıdaki öğelerden etkilenir:
Paralel Spark görevlerinin sayısı: Bir iş çalışırken bu sayıyı Spark kullanıcı arayüzünde görebilirsiniz.
Veri yazma modu: Spark bağlayıcısını sabit kopyalama modunda veri yazmak için kullanırsanız her paralel görev bir JDBC bağlantısı kullanır. INSERT ifadesiyle veri yazarsanız her paralel görevin kullandığı JDBC bağlantısı sayısı write_thread_size değerine eşittir. Veri okuma için kullanılan her paralel görev bir JDBC bağlantısı kullanır.
Diğerleri: Bir iş başladığında şema bilgilerinin alınması gerekebilir. Bu durumda kısa süreliğine bir JDBC bağlantısı kullanılabilir.
Bir iş tarafından kullanılan toplam JDBC bağlantısı sayısını aşağıdaki formüllerle hesaplayabilirsiniz:
Sabit kopyalama modu:
Parallelism × 1 + 1INSERT ifadesi:
Parallelism × write_thread_size + 1
Spark görevlerinin paralellik derecesi, manuel parametre ayarlarından ve Hadoop'un dosya engelleme politikasından etkilenir.
(Önerilen) Verileri Hologres'e yazmak için Spark bağlayıcısını kullanma
Verileri Hologres'e yazmak için Hologres'in yerleşik Spark bağlayıcısını kullanmanızı öneririz. Spark bağlayıcısı, Holo Client ile birlikte çalışır. Diğer veri yazma yöntemlerine kıyasla Spark bağlayıcısı daha iyi yazma performansı sunar. Spark bağlayıcısıyla veri yazmak için aşağıdaki adımları uygulayın. Örnek kod hakkında daha fazla bilgi için bu konudaki Spark bağlayıcısını kullanarak Hologres'e veri yazma örneği bölümüne bakın.
Hazırlıklar
-
JAR paketini edinin.
Spark bağlayıcısı Spark 2 ve Spark 3 için mevcuttur. Spark bağlayıcısını kullanarak Hologres'e veri yazarken Spark bağlayıcısının bir JAR paketine başvurmanız gerekir. İlgili JAR paketi Maven merkezi deposunda zaten yayımlanmıştır. Yapılandırmak için aşağıdaki pom.xml dosyasına bakabilirsiniz.
Notİlgili bağlayıcılar ayrıca açık kaynaklıdır. Daha fazla bilgi için alibabacloud-hologres-connectors sayfasını ziyaret edin.
<dependency>
    <groupId>com.alibaba.hologres</groupId>
    <artifactId>hologres-connector-spark-3.x</artifactId>
    <version>1.4.0</version>
    <classifier>jar-with-dependencies</classifier>
</dependency>
Hologres tarafından sağlanan JAR paketlerini indirmek için aşağıdaki bağlantılara tıklayabilirsiniz:
-
JAR paketini kullanın.
Spark'ı başlatmak ve bağlayıcıyı yüklemek için aşağıdaki komutu çalıştırın:
spark-shell --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jarPySpark'ı başlatmak ve bağlayıcıyı yüklemek için aşağıdaki komutu da çalıştırabilirsiniz:
pyspark --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar
Spark bağlayıcısını kullanarak Hologres'e veri yazma örneği
Aşağıdaki örnekte, Spark bağlayıcısı kullanılarak Hologres'e nasıl veri yazıldığı gösterilmektedir.
-
Hologres'te bir tablo oluşturun.
Veri yazmak istediğiniz tabloyu oluşturmak için Hologres'te aşağıdaki SQL ifadesini yürütün:
CREATE TABLE tb008 ( id BIGINT primary key, counts INT, name TEXT, price NUMERIC(38, 18), out_of_stock BOOL, weight DOUBLE PRECISION, thick FLOAT, time TIMESTAMPTZ, dt DATE, by bytea, inta int4[], longa int8[], floata float4[], doublea float8[], boola boolean[], stringa text[] ); -
Spark'ta verileri hazırlayın ve verileri Hologres'e yazın.
-
Spark bağlayıcısını etkinleştirmek için CLI'da aşağıdaki komutu çalıştırın:
spark-shell --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar -
Örnek verileri yüklemek için spark-shell içinde
load spark-test.scalakomutunu çalıştırın.spark-test.scala dosyası aşağıdaki verileri içerir:
import java.sql.{Timestamp, Date}
import org.apache.spark.sql.types._
import org.apache.spark.sql.Row

val byteArray = Array(1.toByte, 2.toByte, 3.toByte, 'b'.toByte, 'a'.toByte)
val intArray = Array(1, 2, 3)
val longArray = Array(1L, 2L, 3L)
val floatArray = Array(1.2F, 2.44F, 3.77F)
val doubleArray = Array(1.222, 2.333, 3.444)
val booleanArray = Array(true, false, false)
val stringArray = Array("abcd", "bcde", "defg")

val data = Seq(
  Row(-7L, 100, "phone1", BigDecimal(1234.567891234), false, 199.35, 6.7F, Timestamp.valueOf("2021-01-01 00:00:00"), Date.valueOf("2021-01-01"), byteArray, intArray, longArray, floatArray, doubleArray, booleanArray, stringArray),
  Row(6L, -10, "phone2", BigDecimal(1234.56), true, 188.45, 7.8F, Timestamp.valueOf("2021-01-01 00:00:00"), Date.valueOf("1970-01-01"), byteArray, intArray, longArray, floatArray, doubleArray, booleanArray, stringArray),
  Row(1L, 10, "phone3\"", BigDecimal(1234.56), true, 111.45, null, Timestamp.valueOf("2020-02-29 00:12:33"), Date.valueOf("2020-07-23"), byteArray, intArray, longArray, floatArray, doubleArray, booleanArray, stringArray)
)

val schema = StructType(Array(
  StructField("id", LongType),
  StructField("counts", IntegerType),
  StructField("name", StringType, false), // The value false indicates that the value of this field cannot be null in the table.
  StructField("price", DecimalType(38, 12)),
  StructField("out_of_stock", BooleanType),
  StructField("weight", DoubleType),
  StructField("thick", FloatType),
  StructField("time", TimestampType),
  StructField("dt", DateType),
  StructField("by", BinaryType),
  StructField("inta", ArrayType(IntegerType)),
  StructField("longa", ArrayType(LongType)),
  StructField("floata", ArrayType(FloatType)),
  StructField("doublea", ArrayType(DoubleType)),
  StructField("boola", ArrayType(BooleanType)),
  StructField("stringa", ArrayType(StringType))
))

val df = spark.createDataFrame(
  spark.sparkContext.parallelize(data),
  schema
)
df.show()

// Configure the following parameters to write the sample data to Hologres.
df.write.format("hologres") // Set the value to hologres.
  .option("username", "your_username") // The AccessKey ID of your Alibaba Cloud account.
  .option("password", "your_password") // The AccessKey secret of your Alibaba Cloud account.
  .option("endpoint", "Ip:Port") // The IP address and port number of your Hologres instance.
  .option("database", "test_database") // The name of the Hologres database. The name is test_database in this example.
  .option("table", "tb008") // The name of the Hologres table to which you want to write data. The table name is tb008 in this example.
  .option("write_batch_size", 512) // The maximum number of write requests allowed in a batch. For more information, see the parameter description in the "Use Spark to write data to Hologres in real time" section.
  .option("input_data_schema_ddl", df.schema.toDDL) // The data definition language (DDL) statement for DataFrame. This parameter is required only for Spark 3.X.
  .mode(SaveMode.Append) // The save mode of the Spark DataFrameWriter interface. The value must be Append. This parameter differs from the WRITE_MODE parameter. The value OverWrite is supported for hologres-connector 1.3.3 and later. If you set this parameter to OverWrite, data in the source table is cleared. Proceed with cautions when you use this value.
  .save()
-
-
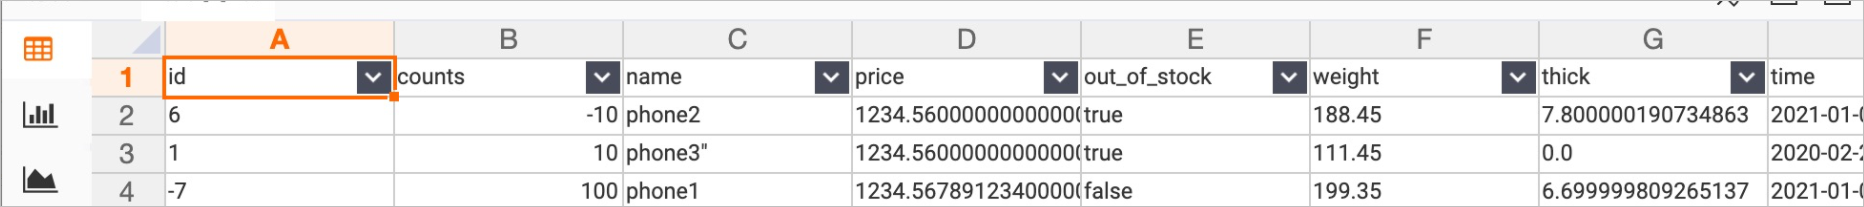
Hedef tablodaki verileri sorgulayın.
Yazılan verileri kontrol etmek için Hologres konsolunda hedef tablodaki verileri sorgulayabilirsiniz. Aşağıdaki figür bir örneği göstermektedir.
PySpark bağlayıcısını kullanarak Hologres'e veri yazma örneği
-
PySpark'ı başlatın ve PySpark bağlayıcısını yükleyin.
pyspark --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar -
Meta verileri kullanarak bir DataFrame nesnesi oluşturun ve bağlayıcıyı çağırarak verileri Hologres'e yazın. İşlem, Spark bağlayıcısını kullandığınız duruma benzerdir.
data = [[1, "Elia"], [2, "Teo"], [3, "Fang"]]
df = spark.createDataFrame(data, schema="id LONG, name STRING")
df.show()

df2.write.format("hologres").option(
  "username", "your_username").option(
  "password", "your_password").option(
  "endpoint", "hologres_endpoint").option(
  "database", "test_database").option(
  "table", "tb008").save()
Hologres'e veri yazmak için bağlayıcı yüklerken Spark SQL kullanma
Bu modu yalnızca Spark 3 için olan Spark bağlayıcısı destekler.
-
Spark SQL'i başlatın ve Spark bağlayıcısını yükleyin.
spark-sql --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar -
Bir CSV görünümü ve bir Hologres görünümü oluşturmak ve bunlara veri yazmak için aşağıdaki Spark SQL DDL ifadelerini yürütün:
CREATE TEMPORARY VIEW csvTable (
  c_custkey bigint,
  c_name string,
  c_address string,
  c_nationkey int,
  c_phone string,
  c_acctbal decimal(15, 2),
  c_mktsegment string,
  c_comment string)
USING csv OPTIONS (
  path "resources/customer1.tbl", sep "|"
);

CREATE TEMPORARY VIEW hologresTable (
  c_custkey bigint,
  c_name string,
  c_address string,
  c_nationkey int,
  c_phone string,
  c_acctbal decimal(15, 2),
  c_mktsegment string,
  c_comment string)
USING hologres OPTIONS (
  jdbcurl "jdbc:postgresql://hologres_endpoint/test_database",
  username "your_username",
  password "your_password",
  table "customer_holo_table",
  copy_write_mode "true",
  bulk_load "true",
  copy_write_format "text"
);

-- You cannot write data to specific columns of Hologres views that are created by using SQL statements. For example, you cannot execute the insert into hologresTable(c_custkey) select c_custkey from csvTable statement. When you write data, you must write data to all columns that are declared in the DDL statement. If you want to write data to specific columns, you can declare only these columns when you create the table.
INSERT INTO hologresTable SELECT * FROM csvTable;
Belirli bir kaynaktan veri okuyup verileri Hologres'e yazmak için Spark kullanma
-
Belirli bir kaynaktan veri okuyun.
Spark'ı farklı kaynak türlerinden veri okumak için kullanabilirsiniz. Aşağıdaki örneklerde, Hologres'ten veya başka bir kaynaktan nasıl veri okunacağı gösterilmektedir:
-
Hologres'ten veri okuma
Hologres, PostgreSQL ile uyumludur. Spark'ı kullanarak PostgreSQL JDBC sürücüsü temelinde Hologres verilerini okuyabilirsiniz. Aşağıdaki örnek kod yalnızca referans amaçlıdır.
NotHologres verilerini okumadan önce resmi web sitesinden PostgreSQL JDBC JAR paketini indirin. Bu örnekte
postgresql-42.2.18kullanılmıştır. Ardından PostgreSQL JDBC JAR paketini yüklemek için spark-shell içinde./bin/spark-shell --jars /path/to/postgresql-42.2.18.jarkomutunu çalıştırın. PostgreSQL JDBC JAR paketini, Hologres Spark bağlayıcısının JAR paketiyle birlikte de yükleyebilirsiniz.// Read from some table, for example: tb008 val readDf = spark.read .format("jdbc") // Read Hologres data based on the PostgreSQL JDBC driver. .option("driver","org.postgresql.Driver") .option("url", "jdbc:postgresql://Ip:Por/test_database") .option("dbtable", "tb008") .option("user", "your_username") .option("password", "your_password") .load()Spark bağlayıcısı V1.3.2 ve sonraki sürümleri, Hologres'ten veri okumanıza ve paralel veri okuma performansını optimize etmenize olanak tanır. PostgreSQL JDBC sürücüsüne kıyasla Spark bağlayıcısı, veri okuma paralelliğini yapılandırmanıza ve paralel veri okumayı uygulamak için Hologres'te veri parçalamayı desteklemenize imkan verir. Bu durum performansı önemli ölçüde artırır. Örnek kod:
val spark = SparkSession .builder .appName("ReadFromHologres") .master("local[*]") .getOrCreate() spark.sparkContext.setLogLevel("WARN") import spark.implicits._ val schema = StructType(Array( StructField("id", LongType), StructField("counts", IntegerType), StructField("name", StringType, false), StructField("price", DecimalType(38, 12)), StructField("out_of_stock", BooleanType) )) val readDf = spark.read .format("hologres") .schema(schema) // Optional. If you do not specify a schema, all fields in the Hologres table are read by default. .option("username", "your_username") .option("password", "your_password") .option("jdbcurl", "jdbc:postgresql://hologres_endpoint/test_db") .option("table", "tb008") .option("scan_parallelism", "10") // The default parallelism for reading data from Hologres. The maximum value is the shard count of the Hologres table. .load() -
Parquet dosyası gibi başka bir kaynaktan veri okuma
Spark'ı Parquet dosyası veya Hive tablosu gibi diğer kaynak türlerinden veri okumak için kullanabilirsiniz. Aşağıdaki örnek, örnek kodu sağlar:
import org.apache.spark.{SparkConf, SparkContext}
import org.apache.spark.sql.hive.HiveContext

val sparkConf = new SparkConf()
val sc = new SparkContext(sparkConf)
val hiveContext = new HiveContext(sc)

// Read from some table, for example: phone
val readDf = hiveContext.sql("select * from hive_database.phone")
-
-
Verileri Hologres'e yazın.
import com.alibaba.hologres.spark2.sink.SourceProvider

-- Write to hologres table
df.write
  .format("hologres")
  .option(SourceProvider.USERNAME, "your_username")
  .option(SourceProvider.PASSWORD, "your_password")
  .option(SourceProvider.ENDPOINT, "Ip:Port")
  .option(SourceProvider.DATABASE, "test_database")
  .option(SourceProvider.TABLE, table)
  .option(SourceProvider.WRITE_BATCH_SIZE, 512) -- The maximum number of requests allowed in a batch.
  .option(SourceProvider.INPUT_DATA_SCHEMA_DDL, df.schema.toDDL) -- This parameter is required only for Spark 3.X.
  .mode(SaveMode.Append) // This parameter is required only for Spark 3.X.
  .save()
Gerçek zamanlı olarak Hologres'e veri yazmak için Spark kullanma
-
Hologres'te veri yazmak istediğiniz tabloyu oluşturmak için aşağıdaki ifadeyi yürütün:
CREATE TABLE test_table_stream ( value text, count bigint ); -
Yerel makinenizden veri okuyun. Kelime sıklığı istatistiklerini toplayın ve istatistikleri gerçek zamanlı olarak Hologres'e yazın. Aşağıdaki örnek, örnek kodu sağlar:
-
Kod
val spark = SparkSession .builder .appName("StreamToHologres") .master("local[*]") .getOrCreate() spark.sparkContext.setLogLevel("WARN") import spark.implicits._ val lines = spark.readStream .format("socket") .option("host", "localhost") .option("port", 9999) .load() -- Split the lines into words val words = lines.as[String].flatMap(_.split(" ")) -- Generate running word count val wordCounts = words.groupBy("value").count() wordCounts.writeStream .outputMode(OutputMode.Complete()) .format("hologres") .option(SourceProvider.USERNAME, "your_username") .option(SourceProvider.PASSWORD, "your_password") .option(SourceProvider.JDBCURL, "jdbc:postgresql://Ip:Port/dbname") .option(SourceProvider.TABLE, "test_table_stream") .option("batchsize", 1) .option("isolationLevel", "NONE") .option("checkpointLocation", checkpointLocation) .start() .awaitTermination() -
Parametreler
Parametre
Varsayılan değer
Gerekli
Açıklama
username
Varsayılan değer yok
Evet
Alibaba Cloud hesabınızın AccessKey ID'si. AccessKey ID'yi Güvenlik Yönetimi sayfasından alabilirsiniz.
Sızma riskini azaltmaya yardımcı olması için ortam değişkenlerini yapılandırmanızı ve AccessKey ID ile AccessKey gizli anahtarını ortam değişkenlerinden almanızı öneririz.
password
Varsayılan değer yok
Evet
Alibaba Cloud hesabınızın AccessKey gizli anahtarı. AccessKey gizli anahtarını Güvenlik Yönetimi sayfasından alabilirsiniz.
Sızma riskini azaltmaya yardımcı olması için ortam değişkenlerini yapılandırmanızı ve AccessKey ID ile AccessKey gizli anahtarını ortam değişkenlerinden almanızı öneririz.
table
Varsayılan değer yok
Evet
Veri yazmak istediğiniz Hologres tablosunun adı.
endpoint
Varsayılan değer yok
Bu parametreyi veya JDBCURL parametresini yapılandırın.
Hologres örneğinizin uç noktası.
Hologres örneğinizin uç noktasını Hologres konsolundaki örnek ayrıntıları sayfasının Network Information bölümünden alabilirsiniz.
database
Varsayılan değer yok
Bu parametreyi veya JDBCURL parametresini yapılandırın.
Hedef tablonun bulunduğu Hologres veritabanının adı.
jdbcurl
Varsayılan değer yok
Yalnızca bu parametreyi veya ENDPOINT ve DATABASE parametrelerini yapılandırın.
Hologres örneğinizin JDBC URL'si.
copy_write_mode
true
Hayır
Verilerin sabit kopyalama modunda yazılıp yazılmayacağını belirtir. Sabit kopyalama, Hologres V1.3'te desteklenen yeni bir özelliktir. Sabit kopyalama modunda veriler toplu işler halinde değil, akış modunda yazılır. Bu nedenle, sabit kopyalama modunda veri yazma işlemi daha yüksek aktarım hızı ve daha düşük veri gecikmesi süresi sağlar ve INSERT ifadesini kullanarak veri yazmaya kıyasla daha az istemci bellek kaynağı tüketir.
NotSabit kopyalama modunu kullanmak istiyorsanız bağlayıcı sürümünün V1.3.0 veya üzeri, Hologres altyapı sürümünün ise V1.3.34 veya üzeri olması gerekir.
copy_write_format
false
Hayır
Kirli verilerin kontrol edilip edilmeyeceğini belirtir. Bu parametre yalnızca COPY_WRITE_MODE true olarak ayarlandığında etkili olur. Bu parametreyi true olarak ayarlarsanız ve kirli veri oluşursa sistem yazılamayan satırı bulabilir.
NotKirli veri kontrolü yazma performansını olumsuz etkiler. Bu parametreyi yalnızca sorun giderme sürecinde true olarak ayarlamanızı öneririz.
bulk_load
true
Hayır
Verilerin Hologres'e toplu kopyalama modunda yazılıp yazılmayacağını belirtir. Sabit kopyalama modunda veriler akış modunda yazılır.
NotHologres V2.1'de birincil anahtarı olmayan tablolara veri yazma performansı optimize edilmiştir. Hologres V2.1'de birincil anahtarı olmayan bir tabloya toplu modda veri yazma işlemi tablo kilidi değil satır kilidi alır. Bu sayede toplu moddaki veri yazma işlemleri, sabit planlar kullanılarak gerçekleştirilen işlemlerle paralel olarak yürütülebilir. Bu durum veri işleme verimliliğini ve paralelliği artırmaya yardımcı olur.
Bağlayıcı sürümü V1.4.0 veya üzeriyse Hologres altyapı sürümünün V2.1.0 veya üzeri olması gerekir.
max_cell_buffer_size
20971520 (20 MB)
Hayır
COPY_WRITE_MODE true olarak ayarlandığında bir alanın maksimum uzunluğu.
copy_write_dirty_data_check
false
Hayır
Kirli verilerin kontrol edilip edilmeyeceğini belirtir. Bu parametreyi true olarak ayarlarsanız ve kirli veri oluşursa sistem yazılamayan satırı bulabilir. Kirli veri kontrolü yazma performansını olumsuz etkiler. Bu parametreyi yalnızca sorun giderme sürecinde true olarak ayarlamanızı öneririz.
NotBu parametre yalnızca COPY_WRITE_MODE true olarak ayarlandığında etkili olur.
copy_write_direct_connect
Doğrudan bağlantılara izin veren senaryolar için true
Hayır
Bu parametre yalnızca COPY_WRITE_MODE true olarak ayarlandığında etkili olur. Kopyalama modunda yazılabilecek veri miktarı VPC uç noktasının aktarım hızına göre belirlenir. Sistem, kopyalama modunda veri yazılırken ortamın Hologres FE düğümüne doğrudan bağlanıp bağlanamayacağını kontrol eder. Ortam Hologres FE düğümüne doğrudan bağlanabiliyorsa varsayılan olarak doğrudan bağlantılar kullanılır. Bu parametre false olarak ayarlanırsa doğrudan bağlantılar kullanılmaz.
input_data_schema_ddl
Varsayılan değer yok
Bu parametre Spark 3.X için gereklidir. Parametre değerini
<your_DataFrame>.schema.toDDLbiçiminde yapılandırın.Spark'ta DataFrame için DDL ifadesi.
write_mode
INSERT_OR_REPLACE
Hayır
Birincil anahtar çakışmalarını işlemek için kullanılan ilke. Bu parametre, hedef tabloda birincil anahtar varsa gereklidir. Geçerli değerler:
INSERT_OR_IGNORE: Birincil anahtar çakışması oluşursa yazmak istediğiniz verileri atar.
INSERT_OR_UPDATE: Birincil anahtar çakışması oluşursa hedef tablodaki ilgili sütunları günceller.
INSERT_OR_REPLACE: Birincil anahtar çakışması oluşursa hedef tablodaki tüm sütunları günceller.
write_batch_size
512
Hayır
Bir iş parçacığında veri yazmak için bir toplu işte izin verilen maksimum istek sayısı. write_mode parametresine göre çakışmalar işlendikten sonra PUT isteklerinin toplam sayısı write_batch_size parametresiyle belirtilen üst sınıra ulaşırsa veriler toplu olarak gönderilir.
write_batch_byte_size
2 MB
Hayır
Bir iş parçacığında veri yazmak için bir toplu işte izin verilen maksimum bayt sayısı. WRITE_MODE parametresine göre çakışmalar işlendikten sonra PUT isteklerinin toplam bayt sayısı WRITE_BATCH_BYTE_SIZE parametresiyle belirtilen üst sınıra ulaşırsa veriler toplu olarak gönderilir.
write_max_interval_ms
10000 ms
Hayır
Verilerin toplu olarak gönderildiği aralık.
write_fail_strategy
TYR_ONE_BY_ONE
Hayır
Gönderim hatalarını işlemek için kullanılan ilke. Bir toplu iş gönderilemezse Holo Client, toplu işteki veri girişlerini belirtilen sırayla tek tek gönderir. Bir veri girişi gönderilemezse Holo Client, veri girişi bilgilerini içeren bir hata mesajı döndürür.
write_thread_size
1
Hayır
Veri yazmak için kullanılan paralel iş parçacığı sayısı. Her iş parçacığı bir bağlantı kullanır.
Bir Spark işi tarafından kullanılan toplam bağlantı sayısı Spark paralelliğine göre değişir. Toplam bağlantı sayısı aşağıdaki formülle hesaplanabilir:
Toplam bağlantı sayısı = spark.default.parallelism değeri × WRITE_THREAD_SIZE değeri.dynamic_partition
false
Hayır
Veriler bölümleri olmayan bir üst tabloya yazıldığında otomatik olarak bölüm oluşturulup oluşturulmayacağını belirtir. Geçerli değerler: true ve false. true: Veriler bölümleri olmayan bir üst tabloya yazıldığında otomatik olarak bir bölüm oluşturulur.
retry_count
3
Hayır
Bir bağlantı hatası oluştuğunda veri yazma ve sorgulama için izin verilen maksimum yeniden deneme sayısı.
retry_sleep_init_ms
1000 ms
Hayır
Bir isteğin yeniden denemeleri için harcanan süre aşağıdaki formülle hesaplanır: retry_sleep_init_ms + retry_count × retry_sleep_step_ms.
retry_sleep_step_ms
10*1000 ms
Hayır
Bir isteğin yeniden denemeleri için harcanan süre aşağıdaki formülle hesaplanır: retry_sleep_init_ms + retry_count × retry_sleep_step_ms.
connection_max_idle_ms
60000 ms
Hayır
Veri okuma ve yazma için kullanılan bağlantıların boşta kalma zaman aşımı süresi. Bir bağlantı belirtilen boşta kalma zaman aşımı süresinden daha uzun süre boşta kalırsa Holo Client bağlantıyı otomatik olarak serbest bırakır.
fixed_connection_mode
false
Hayır
Sabit bağlantıların kullanılıp kullanılmayacağını belirtir. Sabit kopyalama dışındaki modlarda (örneğin INSERT modu) veri yazma ve nokta sorguları bağlantı kullanmaz.
NotSabit bağlantı özelliği beta sürümündedir ve yalnızca bağlayıcı sürümü V1.2.0 veya üzeri ve Hologres altyapı sürümü V1.3.0 veya üzeri olduğunda kullanılabilir.
scan_batch_size
256
Hayır
Hologres'ten veri okurken her seferinde taranan satır sayısı.
scan_timeout_seconds
60
Hayır
Hologres'ten veri okurken tarama işleminin zaman aşımı süresi. Birim: saniye.
scan_parallelism
10
Hayır
Hologres'ten veri okumak için kullanılan parça sayısı. Maksimum değer, Hologres tablosunun parça sayısıdır. İş çalışma zamanında parçalar, veri okumak için Spark görevlerine atanır.
-
Veri türü eşlemeleri
Aşağıdaki tabloda Spark ve Hologres arasındaki veri türü eşlemeleri açıklanmaktadır.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|