知識庫用於為大模型補充私人資料和最新資訊。基於 RAG(檢索增強產生)技術,大模型在產生回答前會先從知識庫中檢索相關內容,從而提升回答的準確性。
重要
-
控制台訪問限制:僅面向2025年4月21日前,在新加坡地區建立過阿里雲百鍊應用的使用者開放应用开发頁簽的存取權限。
此頁簽包含以下功能:應用(智能體應用(Agent 1.0)、工作流程應用)、組件(Prompt工程、外掛程式)、資料(知識庫、應用資料)。目前均為預覽功能,請謹慎用於生產環境。
-
API調用限制:僅面向2025年4月21日前,在新加坡地區建立過阿里雲百鍊應用的使用者開放應用資料、知識庫及Prompt工程功能的介面的調用許可權。
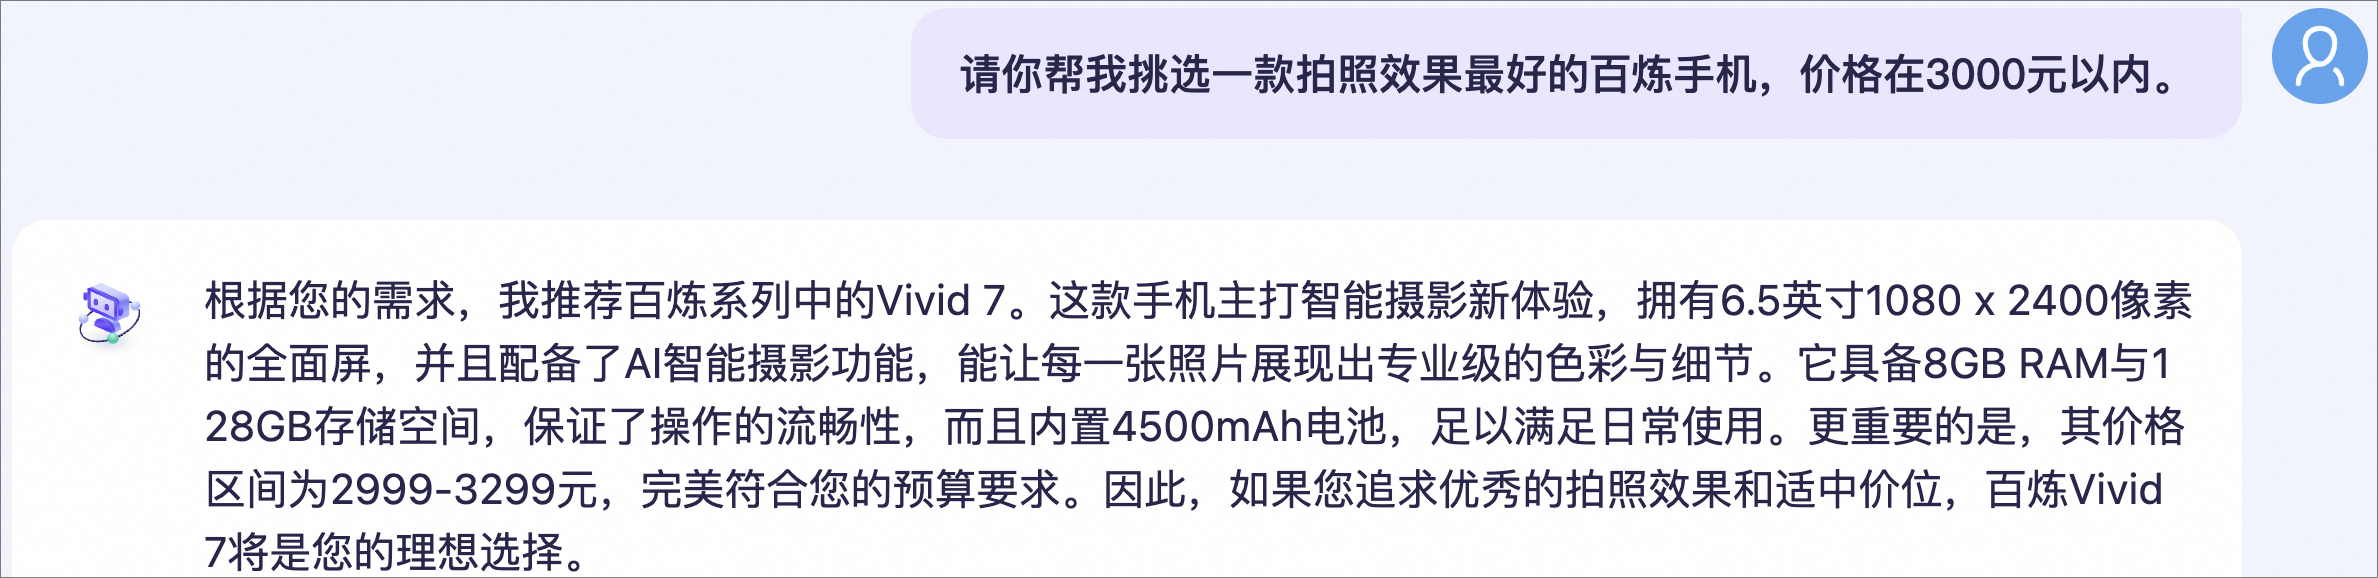
無專屬知識庫的應用 無專屬知識庫時,大模型無法準確回答特定領域的問題。 例如,使用者在對話介面中發送"請你幫我挑選一款拍照效果最好的百鍊手機,價格在 3000 元以內",AI 助手因缺乏相關知識庫而無法給出準確的產品推薦。 | 有專屬知識庫的應用 引入專屬知識庫後,大模型可準確回答特定領域的問題。
|
支援的模型
以下模型支援使用知識庫。配置千問使用知識庫教程
- 千問-Max/Plus/Turbo
- 千問VL-Max/Plus
- 千問-開源版(Qwen2.5等)
上述列表隨時可能更新。請以在 應用管理 頁面建立應用時實際可選的模型為準。
快速開始
本節介紹如何無需編寫代碼,快速構建一個能夠回答特定領域問題(以"阿里雲百鍊手機"為例)的大模型問答應用。
1. 構建知識庫
- 進入知識庫頁面,點擊创建知识库。填寫知识库名称和知识库描述,其餘設定保持預設,點擊下一步。
- 選擇配置類目,上傳阿里雲百鍊系列手機產品介紹.docx檔案。點擊下一步,然後點擊完成。
2. 整合到業務應用
知識庫建立後,可將其關聯至同一業務空間下的阿里雲百鍊應用或外部應用,以處理檢索請求。
整合到智能體應用
-
進入應用管理頁面,找到目標智能體應用,點擊卡片上的配置,並為應用選擇模型。
-
點擊頁面上文檔知識庫右側的 + 按鈕,添加上一步建立的知識庫。相似性閾值和權重可保持預設。
(可選)相似性閾值:篩選檢索結果
知識庫採用語義檢索,可在私人資料或檔案中找出與查詢意圖相關、但關鍵詞可能完全不同的文本。
例如,使用者查詢:
哪款阿里雲手機適合拍照?實際答案(千問Vivid 7...)中並不包含查詢中的任何關鍵詞。
下表中的關鍵詞相似性基於 Jaccard 計算,語義相似性基於
text-embedding-v4模型計算的 Cosine相似性 。召迴文本
關鍵詞相似性
語義相似性
千問Vivid 7:智能攝影新體驗
0
0.43
阿里雲百鍊Ace Ultra:遊戲玩家之選
0.17
0.32
阿里雲百鍊Flex Fold+:摺疊屏新紀元
0.25
0.24
相似性閾值:僅語義相似性高於此閾值的文本才會被召回。閾值設定過高會導致相關文本被過濾丟棄。
(可選)權重:幹預多知識庫召回順序
當智能體應用同時關聯多個知識庫時,可按資訊源的重要程度為各知識庫分配權重。多路召回時,若多個知識庫召回的文本切片相似性相同,系統將優先返回權重更高的知識庫中的文本切片。
- 關鍵限制:權重僅在同類型知識庫之間生效。例如,文檔搜尋類知識庫的權重不影響資料查詢類知識庫的召回順序,反之亦然。
- 工作原理:系統先計算使用者問題與各知識庫內容的相關度,篩選出最相關的文本切片,再將相似性分數與對應知識庫的權重相乘,經加權重排後輸出給大模型參考(加權得分越高,被採納的可能性越大)。
-
在頁面右側的輸入框中輸入問題,大模型將基於所構建的知識庫進行回答。
例如:"請幫我挑選一款拍照效果最好的阿里雲百鍊手機,價格在3000元以內。"
分批建置原則:當需要智能體應用基於知識庫批量產生大量內容(如題目、摘要)時,一次性請求可能因單次回複的輸出長度受限而導致實際產生數量不足。建議將請求拆分為多批,每批約 30 條,通過多輪對話逐步完成。例如先發送"請根據知識庫內容產生第 1-30 題",該批產生完成後再發送"請繼續產生第 31-60 題"。實測參考:一次性請求 100 題實際僅產生約 24 題;改為每批 30 題、共 3 批後,每批均完整產生 30 題,合計 90 題。實際可產生數量隨所選模型與內容長度變化,請以實際測試結果為準。
整合到工作流程應用
-
進入應用管理頁面,找到目標工作流程應用,點擊卡片上的配置。將知識庫節點拖入畫布,串連在开始節點之後。
-
配置知識庫節點:
-
輸入:在變數名
content右側的值下拉式清單中,選擇内置变量query。下拉式清單為樹形結構,需展開"內建變數"分組後選擇 query。 -
選擇知識庫:知識庫節點支援以下兩種選擇方式。
- 選擇固定知識庫:從下拉式功能表中選擇上一步建立的知識庫。適用於每次調用同一知識庫的情境。
- 動態引入:配置
CodeList變數,根據上遊節點的輸出動態指定知識庫。適用於需根據不同輸入檢索不同知識庫的情境。
-
設定 TopK(可選):決定返回給下遊節點(通常為大模型節點)的知識片段數量。
增大該值通常能提升大模型回答的準確性,但會相應增加大模型的輸入 Token 消耗。
-
-
將大模型節點拖入畫布,串連在知識庫節點之後、結束節點之前。
-
配置大模型節點:
-
在模型配置列表中,為節點選擇模型。
-
在提示词中,輸入指示大模型使用知識庫的提示詞。輸入"/"可插入
result變數(表示知識庫檢索返回的結果)。例如,輸入提示詞標題
# 知識庫,本文為請記住以下材料{知識庫1/result},他們可能對回答問題有協助。
-
-
配置結束節點:輸入
/,選擇大模型1result,輸出大模型返回的結果。 -
點擊頁面右上方的测试,在頁面右側的輸入框中輸入問題,大模型將基於所構建的知識庫進行回答。
例如:"請幫我挑選一款拍照效果最好的阿里雲百鍊手機,價格在3000元以內。"
整合到外部應用
除在阿里雲百鍊內構建應用外,也可通過阿里雲百鍊SDK調用知識庫的檢索能力,為外部 AI 應用提供檢索服務。
具體整合步驟,請參見知識庫API指南。
3. 最佳化知識庫效果(可選)
若問答過程中出現知識召回不完整或內容不準確的情況,請參見知識庫效果最佳化。
操作指南
知識庫ID: 即每個知識庫卡片上
ID欄位的值,用於API調用等情境。
建立知識庫
點擊创建知识库後,按三步完成建立:填寫基礎資訊並選擇知識庫類型、配置資料來源、設定索引參數。
-
在知識庫頁面,點擊创建知识库。
-
填寫基礎資訊
根據應用情境選擇合適的知识库类型(單一知識庫不支援同時選擇多個類型)。選擇文檔搜尋類型後,還需選擇使用情境(基礎文檔問答):
- 基礎文檔問答:適用於純文字文檔的語義檢索。
建立後,知識庫類型不可更改。
-
文檔搜尋(檢索情境)
-
適用情境:
- 適用於企業內部文檔、產品手冊等非結構化資料(即未按預定義表結構組織的資料,包含文本、表格和圖片)的檢索。
- 若檔案包含圖片,且需阿里雲百鍊應用在回答中返回,請選擇文檔搜尋。
-
資料來源:支援本地上傳檔案或從阿里雲Object Storage Service匯入。
建立說明(文檔搜尋)
-
選擇資料:為知識庫指定資料來源(檔案或內容)。資料來源內容將匯入知識庫,用於後續檢索。支援本地上傳和雲端匯入(選擇現有類目或檔案)兩種方式。
-
本地上傳:直接從本地電腦上傳檔案。展開下方摺疊面板瞭解如何選擇解析方式。
解析方式(自訂設定)說明
請根據實際需求配置解析策略,如不確定建議保持預設設定。
- 电子文档解析:不支援解析檔案中的插圖與圖表。解析速度最快,10~20 頁純文字文檔通常在數秒至 1 分鐘內完成。
- 文檔智能解析:對檔案中的插圖進行文本識別與提取,產生文本摘要。摘要將與其他非圖片內容一同切分並向量化,參與知識庫檢索。解析速度較快,10~20 頁含插圖文檔通常需要 1~5 分鐘。
- 大模型文檔解析:使用千問VL模型的智能體應用支援對檔案中插圖和圖表內容進行提問。如需識別和理解檔案中的插圖與圖表,請選擇大模型文档解析。因需調用大模型進行深度理解,10~20 頁含圖表文檔通常需要 2~10 分鐘。
- Qwen VL解析:專用於圖片檔案。可指定千問VL模型並傳入 Prompt,以指導對圖片版面及元素的識別與提取。單張圖片通常在數秒至 1 分鐘內完成解析。
-
雲端匯入:從Object Storage Service匯入已有檔案。
-
-
索引配置:定義匯入資料的處理和儲存方式,直接影響檢索效果。
以下配置項中,僅"向量儲存"選用 ADB-PG 時可能產生費用,其餘配置均免費。
Meta資訊抽取
metadata(中繼資料)是與非結構化資料關聯的一組附加屬性,以 key-value 索引值對的形式整合到文本切片中。
- 作用:中繼資料為文本切片提供重要的上下文資訊,可顯著提升知識庫檢索的準確性。例如,知識庫中包含上千個以產品名稱命名的產品介紹檔案。檢索"A產品的功能概述"時,若所有檔案本文都含有"功能概述"但均未提及"A產品",知識庫可能召回大量無關文本切片。將產品名稱作為中繼資料附加到所有文本切片後,知識庫可精準過濾出與"A產品"相關且包含"功能概述"的切片,從而提高檢索準確性,同時降低模型輸入Token消耗。
- 用法:通過API調用應用時,可在請求參數
metadata_filter中指定metadata。應用檢索知識庫時,將先根據metadata篩選相關檔案。 - 注意:知識庫一旦建立,無法再配置metadata抽取。
如何配置metadata
開啟Meta資訊抽取,然後單擊设置為該知識庫中的所有檔案附加統一或個人化的中繼資料。切分時,每個檔案的中繼資料將整合到各自的文本切片中。
建立Meta資訊模板說明
取值方法說明:-
常量:為知識庫中的所有檔案附加固定屬性。
如上方樣本所示,若知識庫中所有檔案的作者相同,可統一設定欄位名為
author的常量。 -
變數:為知識庫中的每個檔案附加可變屬性。目前支援
file_name和cat_name。選擇file_name時,阿里雲百鍊將檔案名稱附加到其中繼資料中,如上方樣本所示。選擇cat_name時,阿里雲百鍊將檔案所在類目的名稱附加到檔案中繼資料中。 -
大模型:系統依據設定的實體描述規則,對知識庫中每個檔案的常值內容進行匹配,自動識別並提取相關資訊,將其作為屬性附加到檔案中繼資料中。
如上方樣本的meta資訊模板所示,如需提取每個檔案中所有出現過的年份資訊作為檔案屬性,可設定名為
date的大模型欄位,實體描述配置如下:在實體描述輸入框中填寫
日期資訊,只提取年份,然後單擊確定。 -
正則:系統依據設定的Regex,對知識庫中每個檔案的常值內容進行匹配,提取符合該運算式的內容,並將其作為屬性添加到檔案中繼資料中。
如上方樣本的meta資訊模板所示,如需提取每個檔案中所有出現過的參考資料(假設規律為:以"《"開頭、以"》"結尾),可設定名為
reference的正則欄位,Regex配置如下:Regex的值設定為
《.*?》。 -
關鍵詞搜尋:系統在每個檔案中尋找預設的關鍵詞,並將匹配到的關鍵詞作為屬性添加至檔案中繼資料中。
例如,在上述樣本的meta資訊模板中,預設的關鍵詞為:
融資,租賃,產業,汽車,鋼鐵,綠色,環保,資本,排放。由於該檔案中僅出現了"融資、產業、綠色、資本"這四個關鍵詞,系統只提取了這四個關鍵詞作為該檔案
keywords屬性的值。
是否參與檢索:開啟後,中繼資料欄位和值將與文本切片內容一同參與知識庫檢索;關閉時,僅文本切片內容參與檢索,中繼資料欄位和值不參與。
是否參與模型回複:開啟後,中繼資料欄位和值將與文本切片內容一同參與大模型的回答產生;關閉時,僅文本切片內容參與大模型回答產生,中繼資料欄位和值不參與。
Excel檔案表頭拼裝
開啟後,知識庫將所有XLSX、XLS格式檔案的首行資料視為表頭,並自動拼接到每個文本切片(資料行)中,避免大模型將表頭誤識別為普通資料行。
生效範圍:僅對知識庫中 XLSX、XLS 格式的表格檔案生效,並以檔案首行作為表頭;對 PDF、Word、Markdown 等非表格格式檔案不生效。該設定在建立知識庫(文檔切分)時生效,且與切分策略一樣,在知識庫建立後不可再修改。
處理邏輯:知識庫對錶格檔案按資料行進行切分,即首行(表頭)以外的每一行資料產生一個獨立的文本切片。開啟本設定後,首行表頭會自動拼接到每一個資料行切片中,使切片同時攜帶列名(表頭)與該行資料,大模型即可結合列名準確理解每個欄位的含義;表頭行本身不再作為普通資料行單獨處理,從而避免檢索與問答時的語義混淆。
若知識庫中包含其他格式的檔案(如PDF),或表格檔案本身不含表頭,則無需開啟該設定。
切片方式
選擇智能切分(推薦)。
作用: 知識庫將檔案切分為文本切片,並通過向量模型轉換為向量。文本切片和向量以索引值對的形式存入向量資料庫。知識庫建立後,可查看或編輯每個文本切片的具體內容(文字和圖片)。
切片標題:每個文本切片除本文內容外還帶有一個標題,展示在切片列表中,可用於標識切片並參與檢索。切片標題由知識庫在文檔智能解析階段依據識別到的標題層級自動產生,分為短標題(
title,切片所屬的最近一級標題)和層級標題(hier_title,自最進階標題到當前標題的完整路徑,各級以|>串連,例如一級標題|>二級標題)。因此文檔的標題結構越清晰(如 PDF、Word、Markdown 等含規範章區段標頭的文檔),產生的切片標題越完整;對於按資料行切分、通常不含文本標題層級的表格類檔案(如 Excel),切片標題取決於解析時能否識別到標題層級,未識別到時可能為空白。切片標題也支援在切片管理中手動編輯。注意: 知識庫一旦建立, 無法再更改文檔切分chunk 。不合適的切分策略可能會降低檢索和召回效果。
多輪對話改寫
開啟該功能後,系統將調用專用輕量級模型,結合對話歷史將使用者當前問題改寫為獨立的、上下文完整的新查詢,再用於知識庫檢索。
向量模型
向量模型用於將原始輸入Prompt和知識文本轉化為數值向量,以便計算語義相似性。預設的官方向量(text-embedding-v2)除支援中英雙語外,還支援多種語言,並對向量結果進行歸一化處理(暫不支援更改)。
知識庫使用的向量維度(無法修改):
- 官方向量(text-embedding-v2):1,536維
- qwen3 多模態向量(qwen3-vl-embedding):使用情境選擇「視覺理解」時自動啟用,支援對圖片和富文字文件進行視覺理解後產生向量
排序模型
排序模型位於知識庫外部,對向量檢索初步召回的候選切片進行二次排序,並返回相似性分數最高的前K個文本切片。qwen3-rerank(hybrid)官方排序(推薦)綜合考量語義相關性與文本匹配特徵(如BM25得分),能更好地處理需要精確關鍵詞命中的查詢;若只需語義排序,請選擇qwen3-rerank。
排序模型模式在建立知識庫時,可以在「排序模型模式」配置項中選擇以下三種模式之一:
- 問答模式(預設):根據查詢與候選切片的"問答匹配度"評分,適合使用者提出完整問題、期望從切片中找到答案的情境。
- 相似模式:根據查詢與候選切片的"語義相似性"評分,適合查詢與切片表述風格相近的情境。
- 自訂進階模式:填寫一段不超過 200 個字元的自然語言指令來幹預重排序過程,適合有特殊排序需求的情境。
警告排序模型模式僅在建立知識庫時可選,建立完成後無法修改。配置前請確認以下限制:
- 知識庫類型限制:僅適用於文檔搜尋類、資料查詢類、音視頻搜尋類知識庫。圖片問答類知識庫不支援。
- 使用情境限制:僅基礎文檔問答使用情境支援。視覺理解(富文字文件)和極速問答不支援。
相似性閾值
該閾值表示允許召回的文本切片的最低相似性分數,用於篩選排序模型返回的結果,只有分數超過此閾值的文本切片才會被召回。
說明此處設定的是知識庫的預設相似性閾值。將知識庫關聯到具體阿里雲百鍊應用時,還可為該應用單獨設定閾值(將覆蓋知識庫的預設相似性閾值)。
降低此閾值預期會召回更多文本切片,但可能召回相關度較低的內容;提高此閾值會減少召回的文本切片數量,若設定過高,將導致知識庫丟棄相關切片。
可通過點擊測試對相似性閾值進行調優,以平衡召回率與精確率。
最大召回數量
假設阿里雲百鍊應用關聯了A1、A2和A3三個知識庫,系統從這些庫中檢索與輸入相關的切片,再通過排序模型重排序,選出最相關的前K條加入大模型的輸入Token供回答參考。此K值即最大召回數量(上限為20),決定了排序模型提供給大模型參考的文本切片數量。
增大該值可提高大模型的回答準確性,但會相應增加大模型輸入Token消耗。
向量儲存
選擇向量資料庫儲存文本向量。内置的向量資料庫可滿足知識庫的準系統需求。如需管理、審計或監控資料庫等進階功能,建議選擇ADB-PG(AnalyticDB for PostgreSQL)。
購買ADB-PG執行個體時請開啟 向量引擎最佳化 ,否則阿里雲百鍊將無法使用此執行個體。
建立說明(視覺理解)
選擇視覺理解(富文字文件)使用情境後,知識庫將使用多模態向量模型對文檔進行視覺級理解,保留原始版面布局資訊,而非採用傳統的文本切片方式。
檔案格式限制
在選擇資料頁簽的檔案上傳地區,滑鼠懸浮查看格式要求查看。
索引配置差異
視覺理解情境下的索引配置與基礎文檔問答不同:
- 向量模型:自動選擇 qwen3 多模態向量(qwen3-vl-embedding),建立後不可更改。
- 多輪對話改寫:可配置開啟或關閉。
- 相似性閾值:預設 0.20。
- 最終召回最大數量:預設 5。
- 切片方式:視覺理解不使用傳統文本切片(智能切分/自訂切分等),而是基於視覺索引對文檔整頁進行理解。
編輯限制
- Embedding 模型(qwen3 多模態向量)和向量儲存類型(內建)建立後不可更改。
- 知識庫規格變更每天僅支援一次。
-
-
適用情境:
-
資料查詢(Chatbot 或 NL2SQL 情境)
-
適用情境:
-
適合構建基於結構化資料(按預定義表結構組織的資料)的問答系統,例如 FAQ、商品資料、人員資訊查詢助手等。
-
若資料為完整的 FAQ 問答對,請選擇資料查詢。例如,Excel 檔案包含兩列,分別為
問題和答案。資料查詢類知識庫支援將問題列用於知識庫檢索,答案列用於大模型回答參考。文檔搜尋類知識庫無法實現此效果。
-
支援匯入單份xlsx、xls格式的文檔,檔案大小限制20MB以內。
-
-
資料來源接入:支援本地上傳 XLS 或 XLSX 檔案。
重要
image_url、video_url、audio_url為系統保留欄位名(用於儲存圖片、視頻、音頻等多媒體資源)。匯入的資料表(Excel 檔案)中請勿使用這三個名稱作為列名(表頭),否則會與系統保留欄位衝突,導致資料無法正常匯入、影響後續檢索與問答。如現有資料表已使用上述列名,請先重新命名對應列後再匯入。建立說明(資料查詢)
-
選擇資料:為知識庫指定資料來源(含檔案或內容)。資料來源內容將匯入知識庫,用於後續檢索。支援本地上傳、雲端匯入兩種方式。
說明知識庫建立後資料來源不可更改,且單個知識庫不支援同時使用多個資料來源。
- 本地上傳:從本機電腦上傳資料表(XLS 或 XLSX 格式,首行必須為表頭)。
- 雲端匯入(選擇資料表):選擇阿里雲百鍊的現有資料表。
-
索引配置:定義匯入資料的處理和儲存方式,直接影響檢索效果。
以下配置項中,僅"向量儲存"選用 ADB-PG 時可能產生費用,其餘配置均免費。
是否參與檢索/參與模型回複
-
是否参与检索:開啟後,知識庫將在該列資料中執行檢索。
-
是否参与模型回复:開啟後,該列的檢索結果將作為大模型產生回答的輸入資訊。樣本配置:對"姓名"、"性別"、"崗位"、"年齡"列開啟是否参与检索,僅對"姓名"和"崗位"列開啟是否参与模型回复後,知識庫將在所有列中執行檢索,但僅將"姓名"和"崗位"兩列的檢索結果提供給大模型作為回答依據。
由於"年齡"列未開啟參與模型回複,關聯該知識庫的大模型仍無法回答"張三的年齡"。
多輪對話改寫
開啟該功能後,系統將調用專用輕量級模型,結合對話歷史將使用者當前問題改寫為獨立的、上下文完整的新查詢,再用於知識庫檢索。
向量模型
向量模型用於將原始輸入Prompt和知識文本轉化為數值向量,以便計算語義相似性。預設的官方向量(text-embedding-v2)除支援中英雙語外,還支援多種語言,並對向量結果進行歸一化處理(暫不支援更改)。
知識庫使用的向量維度(無法修改):
- 官方向量(text-embedding-v2):1,536維
- qwen3 多模態向量(qwen3-vl-embedding):使用情境選擇「視覺理解」時自動啟用,支援對圖片和富文字文件進行視覺理解後產生向量
排序模型
排序模型位於知識庫外部,對向量檢索初步召回的候選切片進行二次排序,並返回相似性分數最高的前K個文本切片。qwen3-rerank(hybrid)官方排序(推薦)綜合考量語義相關性與文本匹配特徵(如BM25得分),能更好地處理需要精確關鍵詞命中的查詢;若只需語義排序,請選擇qwen3-rerank。
排序模型模式在建立知識庫時,可以在「排序模型模式」配置項中選擇以下三種模式之一:
- 問答模式(預設):根據查詢與候選切片的"問答匹配度"評分,適合使用者提出完整問題、期望從切片中找到答案的情境。
- 相似模式:根據查詢與候選切片的"語義相似性"評分,適合查詢與切片表述風格相近的情境。
- 自訂進階模式:填寫一段不超過 200 個字元的自然語言指令來幹預重排序過程,適合有特殊排序需求的情境。
警告排序模型模式僅在建立知識庫時可選,建立完成後無法修改。配置前請確認以下限制:
- 知識庫類型限制:僅適用於文檔搜尋類、資料查詢類、音視頻搜尋類知識庫。圖片問答類知識庫不支援。
- 使用情境限制:僅基礎文檔問答使用情境支援。視覺理解(富文字文件)和極速問答不支援。
相似性閾值
該閾值表示允許召回的文本切片的最低相似性分數,用於篩選排序模型返回的結果,只有分數超過此閾值的文本切片才會被召回。
說明此處設定的是知識庫的預設相似性閾值。將知識庫關聯到具體阿里雲百鍊應用時,還可為該應用單獨設定閾值(將覆蓋知識庫的預設相似性閾值)。
降低此閾值預期會召回更多文本切片,但可能召回相關度較低的內容;提高此閾值會減少召回的文本切片數量,若設定過高,將導致知識庫丟棄相關切片。
可通過點擊測試對相似性閾值進行調優,以平衡召回率與精確率。
最大召回數量
假設阿里雲百鍊應用關聯了A1、A2和A3三個知識庫,系統從這些庫中檢索與輸入相關的切片,再通過排序模型重排序,選出最相關的前K條加入大模型的輸入Token供回答參考。此K值即最大召回數量(上限為20),決定了排序模型提供給大模型參考的文本切片數量。
增大該值可提高大模型的回答準確性,但會相應增加大模型輸入Token消耗。
向量儲存
選擇向量資料庫儲存文本向量。内置的向量資料庫可滿足知識庫的準系統需求。如需管理、審計或監控資料庫等進階功能,建議選擇ADB-PG(AnalyticDB for PostgreSQL)。
購買ADB-PG執行個體時請開啟 向量引擎最佳化 ,否則阿里雲百鍊將無法使用此執行個體。
-
-
-
適用情境:
-
圖片問答(圖搜情境)
-
適用情境:
- 適合構建以圖搜圖、以圖搜"圖文"的多模態檢索應用,如商品導購助手、視覺問答助手等。
-
資料來源接入:支援本地上傳 XLS 或 XLSX 檔案。
XLS、XLSX 檔案 中需包含 公開可訪問 的圖片 URL,以便構建圖片索引。詳見下方建立說明。
建立說明(圖片問答)
-
選擇資料:為知識庫指定資料來源(含檔案或內容)。資料來源內容將匯入知識庫,用於後續檢索。支援本地上傳、雲端匯入(選擇資料連線器中已有資料表)兩種方式。
說明知識庫建立後資料來源不可更改,且單個知識庫不支援同時使用多個資料來源。
-
本地上傳:從本機電腦上傳資料表(XLS 或 XLSX 格式)。
說明
- 欄位要求:資料表中至少需包含一個類型為
image_url的欄位,用於產生圖片索引。 - 構建過程:知識庫將訪問
image_url欄位中的圖片 URL,提取視覺特徵並轉換為向量儲存。 - 檢索過程:知識庫將使用者上傳圖片產生的向量與已儲存的圖片向量進行相似性比對,返回最相關的記錄。
- 欄位要求:資料表中至少需包含一個類型為
-
雲端匯入(選擇資料表):選擇阿里雲百鍊應用資料中的現有資料表。
-
-
索引配置:定義匯入資料的處理和儲存方式,直接影響檢索效果。
以下配置項中,僅"向量儲存"選用 ADB-PG 時可能產生費用,其餘配置均免費。
是否參與檢索/參與模型回複
-
是否参与检索:開啟後,知識庫將在該列資料中執行檢索。
-
是否参与模型回复:開啟後,該列的檢索結果將作為大模型產生回答的輸入資訊。樣本配置:對"姓名"、"性別"、"崗位"、"年齡"列開啟是否参与检索,僅對"姓名"和"崗位"列開啟是否参与模型回复後,知識庫將在所有列中執行檢索,但僅將"姓名"和"崗位"兩列的檢索結果提供給大模型作為回答依據。
由於"年齡"列未開啟參與模型回複,關聯該知識庫的大模型仍無法回答"張三的年齡"。
多輪對話改寫
開啟該功能後,系統將調用專用輕量級模型,結合對話歷史將使用者當前問題改寫為獨立的、上下文完整的新查詢,再用於知識庫檢索。
向量模型
向量模型用於將原始輸入 Prompt、知識文本及圖片轉化為數值化向量,以便進行相似性比較。詳情請參見文本與多模態向量化。
- qwen2.5 多模態向量(qwen2.5-vl-embedding):將單模態或混合模態輸入表徵為統一向量,適用於跨模態檢索、圖搜等情境。例如,輸入一張襯衫圖片並附加文本"找相似風格但更顯年輕的款式",模型能將映像與文本指令融合為一個向量進行理解。
- 多模態向量 v1(multimodal-embedding-v1):為每個輸入部分(圖片、文字)分別產生獨立向量。
- qwen3 多模態向量(qwen3-vl-embedding):qwen2.5-vl-embedding 的升級版本,在圖文融合理解和跨模態檢索精度方面進一步提升。
排序模型
排序模型位於知識庫外部,對向量檢索初步召回的候選切片進行二次排序,並返回相似性分數最高的前K個文本切片。qwen3-rerank(hybrid)官方排序(推薦)綜合考量語義相關性與文本匹配特徵(如BM25得分),能更好地處理需要精確關鍵詞命中的查詢;若只需語義排序,請選擇qwen3-rerank。
排序模型模式在建立知識庫時,可以在「排序模型模式」配置項中選擇以下三種模式之一:
- 問答模式(預設):根據查詢與候選切片的"問答匹配度"評分,適合使用者提出完整問題、期望從切片中找到答案的情境。
- 相似模式:根據查詢與候選切片的"語義相似性"評分,適合查詢與切片表述風格相近的情境。
- 自訂進階模式:填寫一段不超過 200 個字元的自然語言指令來幹預重排序過程,適合有特殊排序需求的情境。
警告排序模型模式僅在建立知識庫時可選,建立完成後無法修改。配置前請確認以下限制:
- 知識庫類型限制:僅適用於文檔搜尋類、資料查詢類、音視頻搜尋類知識庫。圖片問答類知識庫不支援。
- 使用情境限制:僅基礎文檔問答使用情境支援。視覺理解(富文字文件)和極速問答不支援。
相似性閾值
該閾值表示允許召回的文本切片的最低相似性分數,用於篩選排序模型返回的結果,只有分數超過此閾值的文本切片才會被召回。
說明此處設定的是知識庫的預設相似性閾值。將知識庫關聯到具體阿里雲百鍊應用時,還可為該應用單獨設定閾值(將覆蓋知識庫的預設相似性閾值)。
降低此閾值預期會召回更多文本切片,但可能召回相關度較低的內容;提高此閾值會減少召回的文本切片數量,若設定過高,將導致知識庫丟棄相關切片。
可通過點擊測試對相似性閾值進行調優,以平衡召回率與精確率。
最大召回數量
假設阿里雲百鍊應用關聯了A1、A2和A3三個知識庫,系統從這些庫中檢索與輸入相關的切片,再通過排序模型重排序,選出最相關的前K條加入大模型的輸入Token供回答參考。此K值即最大召回數量(上限為20),決定了排序模型提供給大模型參考的文本切片數量。
增大該值可提高大模型的回答準確性,但會相應增加大模型輸入Token消耗。
向量儲存
選擇向量資料庫儲存文本向量。内置的向量資料庫可滿足知識庫的準系統需求。如需管理、審計或監控資料庫等進階功能,建議選擇ADB-PG(AnalyticDB for PostgreSQL)。
購買ADB-PG執行個體時請開啟 向量引擎最佳化 ,否則阿里雲百鍊將無法使用此執行個體。
-
-
-
適用情境:
使用情境可根據需求選擇基礎文檔問答。
在請求高峰時段,建立過程可能需要數小時(取決於資料量),請耐心等待。
更新知識庫
知識庫內容的任何變更均會即時同步到所有引用該知識庫的應用中。
文檔搜尋類知識庫
-
自動更新(推薦)
可通過整合Object Storage Service、Function Compute FC 以及阿里雲百鍊知識庫相關API實現。操作步驟如下:
-
手動更新
在知識庫頁面,找到目標知識庫,單擊卡片上的查看详情。
-
如何新增檔案:單擊上传数据,勾選資料連線器中的已有檔案。
-
如何刪除檔案:找到目標檔案後,單擊其右側的刪除。
-
如何修改檔案內容:當前不支援檔案的原地更新或覆蓋上傳。需先刪除知識庫中的舊版本檔案,再將修改後的新版本檔案重新匯入知識庫。
注意:保留舊版本檔案可能導致過時內容被檢索和召回。
-
資料查詢、圖片問答類知識庫
說明 :圖片問答類知識庫的詳情頁沒有直接的 上傳資料 按鈕,需通過 查看資料來源 連結跳轉到連接器詳情頁進行資料更新操作。
-
自動更新
不支援。
-
手動更新
當知識庫的資料來源為應用資料中的資料表時,只能手動更新,分為以下兩步。
-
步驟一:更新資料表
進入應用資料頁簽,在左側列表中選擇目標資料表,單擊上传数据。
-
如何插入新資料:匯入類型選擇增量上传。需上傳一個僅包含表頭和新增資料行的Excel檔案。
檔案表頭須與當前表結構一致。可使用頁面上的 下载模板 功能擷取標準表標頭檔,並在該檔案中直接填寫新資料。
-
如何刪除資料:匯入類型選擇覆盖上传。需上傳一個包含表頭及最新完整資料(已移除待刪除記錄)的Excel檔案。
如何擷取全量資料:單擊頁面上的
 下載XLSX格式資料。
-
如何修改資料:匯入類型選擇覆盖上传。需上傳一個包含表頭及最新完整資料(已包含相應修改)的Excel檔案。
-
-
步驟二:將變更同步至知識庫
返回知識庫列表,找到目標知識庫,單擊卡片上的查看详情。單擊資料表左上方的
 表徵圖,確認後即可將資料表的最新內容同步至知識庫。
每次更新後仍需手動重複以上步驟 。
-
步驟一:更新資料表
音視頻搜尋類知識庫
編輯知識庫
知識庫建立後,在編輯知識庫頁面僅支援修改知識庫名稱、知識庫描述和相似性閾值;知識庫規格(標準版/旗艦版)和旗艦版的RCU數量可通過下文變更配置調整,其餘配置均無法更改(如需更改,須刪除並重新建立知識庫)。編輯操作僅支援通過控制台進行,無對應API。
操作步驟:在知識庫頁面,找到目標知識庫,單擊卡片上的 ,再單擊编辑。注意:同一知識庫每個自然日最多允許變更配置1次,超出後操作將被靜默拒絕(無錯誤提示)。
刪除知識庫
警告刪除操作無法復原,請謹慎操作。
刪除知識庫前,建議先解除其與所有發行的阿里雲百鍊應用的關聯。
已關聯的未發布應用不影響刪除操作。
刪除知識庫步驟
變更配置
旗艦版提供RCU以保障高QPS下的檢索效能,並支援更大的儲存容量;標準版適合開發測試或低並發情境。
說明標準版與旗艦版支援互轉。旗艦版的RCU數量支援修改。
同一知識庫每個自然日最多允許變更配置1次。
RCU: RCU(Retrieval Compute Unit)是知識庫檢索並發能力的度量單位。1 RCU ≈ 支撐線上檢索最高50 QPS。RCU越大,可支撐的並發數越高。
-
注意:
-
如果知識庫(旗艦版)使用平台儲存,降級為標準版前,需將已用儲存空間降至80 GB以下。
可通過刪除知識庫內的檔案或資料來釋放儲存空間。
-
-
操作步驟:
-
在知識庫頁面,找到目標知識庫,單擊卡片上的
,再單擊編輯。 -
根據目前的版本,在彈出的視窗中選擇相應操作:
- 標準版:選擇升級。
- 旗艦版:選擇降級或變更RCU數量。
-
按照介面提示完成操作,單擊確定儲存後配置即時生效。
-
點擊測試
點擊測試用於驗證知識庫能否為AI應用提供準確的知識輸入。通過類比使用者提問,檢查知識庫的召回結果並調優相似性閾值。
點擊測試中的排序模型支援三種模式:問答模式(預設,適合使用者提問與文檔內容不完全符合的情境)、相似模式(適合查詢與文檔內容高度相似的情境)和自訂進階模式。不同模式下,同一查詢的排序得分可能存在顯著差異(例如,同一切片在問答模式下得分47%,在相似模式下可達69%)。
通過點擊測試,可以:
- 驗證知識庫能否為AI應用提供有效知識輸入
- 調優相似性閾值,平衡召回率與準確性
- 發現知識庫中的內容缺失或品質問題
情境樣本
- 情境1:客戶諮詢產品價格
測試輸入:"你們的阿里雲百鍊手機多少錢?"
期望結果:能夠召回包含價格資訊的相關文本切片。
- 情境2:技術問題排查
測試輸入:"裝置連不上WiFi怎麼辦?"
期望結果:能夠召回WiFi串連故障排除的相關文本切片。
- 情境3:視覺理解文檔檢索(視覺理解知識庫)
視覺理解知識庫支援純文字、純圖片和圖文組合三種查詢模式:
模式1(純文字):輸入"Object Storage Service",召迴文檔和圖片中的相關切片。
模式2(純圖片):上傳一張產品截圖,系統通過視覺理解匹配語義相近的切片。
模式3(圖+文字):同時上傳圖片並輸入標題文字,組合查詢可提升召回相似性。
- 情境4:極速問答(極速問答知識庫)
極速問答知識庫僅支援文字查詢(不支援圖片輸入),適合結構化文檔的快速檢索:
測試輸入:"千問Pro 8的價格是多少?"
期望結果:快速召回包含價格資訊的 FAQ 切片。
操作步驟
-
在知識庫頁面,找到目標知識庫,單擊卡片上的命中测试。
-
在測試介面輸入問題(建議收集使用者常見問題),觀察召回結果。
- 召回結果:即本次測試的命中結果(已按相似性降序排列),單擊任一切片即可查看其具體內容。
 表徵圖:若為圖片問答類知識庫,系統會先將輸入圖片轉為向量並檢索相關記錄,再將這些記錄與提問一起交由大模型產生回答;若為文檔搜尋、資料查詢類知識庫,上傳的圖片不參與檢索;若為使用情境選擇「視覺理解」的文檔搜尋類知識庫,上傳圖片同樣參與檢索,支援純文字、純圖片和圖文組合三種查詢模式,圖文組合查詢可提升召回相似性。
-
確認相關文本切片是否被正確召回。如未召回,需調整相似性閾值並重複上一步。
-
單擊查看历史召回记录,可對比不同閾值設定下的歷史召回效果。

配額與限制
-
關於知識庫支援的資料來源與容量等資訊,請參見知識庫配額與限制。
-
單個阿里雲百鍊應用可關聯的知識庫數量:
- 文檔搜尋類:最多5個
- 資料查詢類:最多5個
- 圖片問答類:最多1個
不同類型知識庫可同時關聯,總數最多為11個。
計費說明
知識庫功能本身免費,但調用引用了知識庫的阿里雲百鍊應用時,可能產生相應費用。
| 步驟 | 計費情況 | |
|---|---|---|
不收費。 | ||
調用阿里雲百鍊應用時,知識庫召回的文本切片會增加大模型輸入 Token 數量,從而可能增加模型推理(調用)費用。詳情請參見計費項目與定價。
| ||
不收費。 | ||
API參考
- 如需擷取最新完整的知識庫API列表及輸入輸出參數,請參見API 目錄(知識庫)。
- 如需瞭解相關API的具體用法和程式碼範例,請參見知識庫API指南。
常見問題
構建知識庫
Q: 資料連線器中已匯入知識庫的檔案/資料表能否刪除?
- 文檔搜尋類知識庫:可以刪除。資料連線器與知識庫中的檔案相互獨立,刪除資料連線器中的源檔案不影響已匯入知識庫的檔案。
- 資料查詢、圖片問答類知識庫:不可刪除,否則會導致資料同步、查看知識庫等功能異常。
Q: 調用知識庫相關API時返回錯誤碼 BailianIndexServiceNotOpen,應如何處理?
錯誤碼 BailianIndexServiceNotOpen 表示阿里雲百鍊知識庫服務尚未啟用。請登入百鍊控制台,進入資料 > 知識庫頁面,點擊立即開通按鈕啟用知識庫服務後重試。
處理圖片及多模態內容
Q: 檔案含插圖(需阿里雲百鍊應用在回答時返回),應如何處理?
使用文檔搜尋類知識庫
方式一(僅適用智能體應用)
-
在構建知識庫時,知識庫類型選擇文檔搜尋,使用情境選擇視覺理解(富文字文件)。
選擇視覺理解(富文字文件)回複後,知識庫將從檔案插圖中提取摘要,大模型根據摘要與問題的相關性自主決定是否插入圖片。
-
建立或編輯智能體應用時,選擇千問-Plus或千問-Plus-Latest模型(經測試,兩款模型效果最佳)。點擊文檔知識庫右側的+按鈕,添加上一步構建的知識庫。
-
實際問答效果:

方式二(適用智能體應用與工作流程應用)
-
將圖片上傳至公網可訪問位置並擷取完整 URL。推薦使用 OSS,具體操作請參見將圖片上傳至OSS並使用其檔案URL。
-
在檔案中插入完整 URL(不支援相對路徑)。不支援直接在文檔中內嵌圖片檔案(如通過複製粘貼或菜單插入本地圖片),必須使用公網可訪問的URL連結引用圖片。
若已按說明操作但圖片仍無法顯示,請檢查文本切片中的URL是否完整,確認是否存在多餘空格或特殊字元(可能被系統誤解析),如有問題可直接編輯修正。
檔案正確引用圖片樣本 提示詞模板樣本 實際問答效果 
# 知識庫
請記住以下材料,他們可能對回答問題有協助。
${documents}

# 要求
如果有圖片連結,則以markdown的格式完整顯示出來。
檔案錯誤引用圖片樣本 提示詞模板樣本 實際問答效果 
# 知識庫
請記住以下材料,他們可能對回答問題有協助。
${documents}

# 要求
如果有圖片,請展示圖片。
在對話測試介面中,輸入提示後,AI 回複僅返回純文字內容,未展示任何圖片。
解釋:直接在檔案中內嵌圖片時,阿里雲百鍊應用不會在回答中展示該圖片。
使用圖片問答類知識庫
-
將圖片上傳至公網可訪問位置並擷取完整 URL。推薦使用 OSS,具體操作請參見將圖片上傳至OSS並使用其檔案URL。
-
在表格頁簽中建立資料表,並添加 image_url 類型欄位用於儲存圖片的完整 URL。
說明
- image_url 欄位不支援儲存相對路徑。
- 單個 image_url 欄位不支援儲存多個圖片 URL。若單條記錄需關聯多張圖片,須為每張圖片分別建立獨立的
image_url欄位(如image_1、image_2等)。 - 資料表中每個 image_url 指向的圖片大小不得超過 3 MB,超出限制將導致知識庫建立失敗。
- 資料表建立後無法新增或修改 image_url 類型欄位,請在初次設計表結構時預留所有所需的圖片欄位。
欄位類型支援 string、double、long、datetime 和 image_url。配置完成後可在匯入資料地區上傳 xlsx 或 xls 格式檔案(不超過 20 MB)。
-
構建知識庫時,知識庫類型選擇圖片問答。
-
建立或編輯智能體應用時,點擊图片(圖片問答類知識庫)右側的+按鈕,添加上一步構建的知識庫,並將提示詞模板修改為:
# 知識庫
請記住以下材料,他們可能對回答問題有協助。
${documents}

# 要求
如果有圖片,請展示圖片。
-
在頁面右側的輸入框中發起提問。
例如:"簡單介紹百鍊X1手機。"
正確引用圖片樣本 提示詞模板樣本 使用者提示詞和阿里雲百鍊應用返回的結果 在百鍊平台知識庫資料預覽頁面,百鍊手機資料顯示匯入成功。結構化資料表格包含三列:型號(string)、說明(string)、圖片(image_url)。樣本資料行中,型號為百鍊 X1,說明欄位包含螢幕(6.7 英寸 1440x3200 像素 120Hz)、儲存(256GB+12GB RAM)、電池(5000mAh)、攝像(超感光四攝)及參考售價 4599-4999 等參數,圖片列為對應的圖片資源 URL。
# 知識庫
請記住以下材料,他們可能對回答問題有協助。
${documents}

# 要求
如果有圖片,請展示圖片。
許可權與安全
Q: 操作知識庫時,遇到報錯"缺少該模組的許可權",應如何處理?
Q: 知識庫是否私人?其他組織或使用者能否訪問?
知識庫僅限其所在業務空間內的成員訪問和操作,不對外公開。
Q: 阿里雲是否會使用我帳號下的知識庫回答其他使用者的問題?
阿里雲嚴格保護資料隱私,不會將您的知識庫用於回答其他使用者的問題或模型訓練。資料安全與隱私承諾詳見合規資質與隱私說明。
遷移與匯出
Q: 如何匯出知識庫到本地?
當前不支援一鍵匯出。您可調用ListChunks介面,編寫指令碼批量拉取文檔和切片資料作為替代方案。