MaxCompute(MaxCompute,原名ODPS)是一種快速、完全託管的EB級資料倉儲解決方案。通過Data Transmission Service,您可以將RDS MySQL的資料同步至MaxCompute,協助您快速搭建資料即時分析系統。
前提條件
您已完成以下操作:
注意事項
-
DTS在執行全量資料初始化時將佔用源庫和目標庫一定的讀寫資源,可能會導致資料庫的負載上升,在資料庫效能較差、規格較低或業務量較大的情況下(例如源庫有大量慢SQL、存在無主鍵表或目標庫存在死結等),可能會加重資料庫壓力,甚至導致資料庫服務不可用。因此您需要在執行資料同步前評估源庫和目標庫的效能,同時建議您在業務低峰期執行資料同步(例如源庫和目標庫的CPU負載在30%以下)。
-
僅支援表層級的資料同步。
-
資料同步期間,請勿對源庫的同步對象使用gh-ost或pt-online-schema-change等類似工具執行線上DDL變更,否則會導致同步失敗。
-
由於MaxCompute不支援主鍵約束,當DTS在同步資料時因網路等原因觸發重傳,可能會導致MaxCompute中出現重複記錄。
費用說明
| 同步類型 | 鏈路配置費用 |
| 庫表結構同步和全量資料同步 | 不收費。 |
| 增量資料同步 | 收費,詳情請參見計費概述。 |
源庫支援的執行個體類型
執行資料同步操作的MySQL資料庫支援以下執行個體類型:
-
ECS上的自建資料庫
-
通過專線、VPN網關或智能網關接入的自建資料庫
-
通過資料庫網關接入的自建資料庫
-
同一或不同阿里雲帳號下的RDS MySQL執行個體
本文以RDS執行個體為例介紹配置流程,當源庫為其他執行個體類型時,配置流程與該案例類似。
如果源庫為自建MySQL資料庫,您還需要執行相應的準備工作,詳情請參見準備工作概覽。
支援同步的SQL操作
-
DDL操作:ALTER TABLE、ADD COLUMN
-
DML操作:INSERT、UPDATE、DELETE
同步過程介紹
-
結構初始化。
DTS將源庫中待同步表的結構定義資訊同步至MaxCompute中,初始化時DTS會為表名增加_base尾碼。例如源表為customer,那麼MaxCompute中的表即為customer_base。
-
全量資料初始化。
DTS將源庫中待同步表的存量資料,全部同步至MaxCompute中的目標表名_base表中(例如從源庫的customer表同步至MaxCompute的customer_base表),作為後續增量同步處理資料的基準資料。
說明該表也被稱為全量基準表。
-
增量資料同步。
DTS在MaxCompute中建立一個增量日誌表,表名為同步的目標表名_log,例如customer_log,然後將源庫產生的增量資料即時同步到該表中。
說明關於增量日誌表結構的詳細資料,請參見增量日誌表結構定義說明。
操作步驟
為保障DTS同步帳號能夠授權成功,請使用主帳號完成下述操作步驟。
-
購買資料同步作業,詳情請參見購買流程。
說明購買時,選擇源執行個體為MySQL,目標執行個體為MaxCompute,並選擇同步拓撲為單向同步。
登入資料轉送控制台。
說明若資料轉送控制台自動跳轉至Data Management控制台,您可以在右下角的
 中單擊
 ,返回至舊版資料轉送控制台。
在左側導覽列,單擊資料同步。
在同步作業列表頁面頂部,選擇同步的目標執行個體所屬地區。
定位至已購買的資料同步執行個體,單擊配置同步鏈路。
-
配置同步通道的源執行個體及目標執行個體資訊。
類別
配置
說明
無
同步作業名稱
DTS會自動產生一個同步作業名稱,建議配置具有業務意義的名稱(無唯一性要求),便於後續識別。
源執行個體資訊
執行個體類型
選擇RDS執行個體。
執行個體地區
購買資料同步執行個體時選擇的源執行個體地區資訊,不可變更。
執行個體ID
選擇作為資料同步源的RDS執行個體ID。
資料庫帳號
填入源RDS的資料庫帳號。
說明當源RDS執行個體的資料庫類型為MySQL 5.5或MySQL 5.6時,無需配置資料庫帳號和資料庫密碼。
資料庫密碼
填入資料庫帳號對應的密碼。
串連方式
根據需求選擇非加密串連或SSL安全連線。如果設定為SSL安全連線,您需要提前開啟RDS執行個體的SSL加密功能,詳情請參見設定SSL加密設定SSL加密。
重要目前僅中國內地及中國香港地區支援設定串連方式。
目標執行個體資訊
執行個體類型
固定為MaxCompute,不可變更。
執行個體地區
購買資料同步執行個體時選擇的目標執行個體地區資訊,不可變更。
Project
填入MaxCompute執行個體的Project,您可以在MaxCompute工作空間列表頁面中查詢。
-
單擊頁面右下角的授權白名單並進入下一步。
如果源或目標資料庫是阿里雲資料庫執行個體(例如RDS MySQL、ApsaraDB for MongoDB等),DTS會自動將對應地區DTS服務的IP地址添加到阿里雲資料庫執行個體的白名單中;如果源或目標資料庫是ECS上的自建資料庫,DTS會自動將對應地區DTS服務的IP地址添加到ECS的安全規則中,您還需確保自建資料庫沒有限制ECS的訪問(若資料庫是叢集部署在多個ECS執行個體,您需要手動將DTS服務對應地區的IP地址添加到其餘每個ECS的安全規則中);如果源或目標資料庫是IDC自建資料庫或其他雲資料庫,則需要您手動添加對應地區DTS服務的IP地址,以允許來自DTS伺服器的訪問。DTS服務的IP地址,請參見DTS伺服器的IP位址區段。
警告DTS自動添加或您手動添加DTS服務的公網IP位址區段可能會存在安全風險,一旦使用本產品代表您已理解和確認其中可能存在的安全風險,並且需要您做好基本的安全防護,包括但不限於加強帳號密碼強度防範、限制各網段開放的連接埠號碼、內部各API使用鑒權方式通訊、定期檢查並限制不需要的網段,或者使用通過內網(專線/VPN網關/智能網關)的方式接入。
-
單擊頁面右下角的下一步,允許將MaxCompute中專案的下述許可權授予給DTS同步帳號,詳情
-
配置同步策略和同步對象。
配置
說明
增量日誌表分區定義
同步初始化
同步初始化類型細分為:結構初始化、全量資料初始化。
此處同時勾選結構初始化和全量資料初始化,DTS會在增量資料同步之前,將來源資料庫中待同步對象的結構和存量資料同步到目標資料庫。
目標已存在表的處理模式
-
預檢查並報錯攔截:檢查目標資料庫中是否有同名的表。如果目標資料庫中沒有同名的表,則通過該檢查專案;如果目標資料庫中有同名的表,則在預檢查階段提示錯誤,資料同步作業不會被啟動。
說明如果目標庫中同名的表不方便刪除或重新命名,您可以設定同步對象在目標執行個體中的名稱來避免表名衝突。
-
忽略報錯並繼續執行:跳過目標資料庫中是否有同名表的檢查項。
警告選擇為忽略報錯並繼續執行,可能導致資料不一致,給業務帶來風險,例如:
-
表結構一致的情況下,如果在目標庫遇到與源庫主鍵的值相同的記錄,在初始化階段會保留目標庫中的該條記錄;在增量同步處理階段則會覆蓋目標庫的該條記錄。
-
表結構不一致的情況下,可能會導致無法初始化資料、只能同步部分列的資料或同步失敗。
-
選擇同步對象
在源庫對象框中單擊待同步的表,然後單擊將其移動至已選擇對象框。
說明-
同步對象支援選擇的粒度僅為表,您可以從多個庫中選擇表作為同步對象。
-
預設情況下,同步對象的名稱保持不變。如果您需要在目標執行個體上名稱不同,那麼需要使用DTS提供的對象名映射功能,詳情請參見設定同步對象在目標執行個體中的名稱。
選擇附加列規則
DTS在將資料同步到MaxCompute時,會在同步的目標表中添加一些附加列。如果附加列和目標表中已有的列出現名稱衝突將會導致資料同步失敗。您需要根據業務需求選擇是否啟用新的附加列規則為是或否。
警告在選擇附加列規則前,您需要評估附加列和目標表中已有的列是否會出現名稱衝突,否則可能會導致任務失敗或資料丟失。關於附加列的規則和定義說明,請參見附加列名稱和定義說明。
映射名稱更改
如需更改同步對象在目標執行個體中的名稱,請使用對象名映射功能,詳情請參見庫表列映射。
源表DMS_ONLINE_DDL過程中是否複製暫存資料表到目標庫
如源庫使用Data Management(Data Management)執行Online DDL變更,您可以選擇是否同步Online DDL變更產生的暫存資料表資料。
-
是:同步Online DDL變更產生的暫存資料表資料。
說明Online DDL變更產生的暫存資料表資料過大,可能會導致同步任務延遲。
-
否:不同步Online DDL變更產生的暫存資料表資料,只同步源庫的原始DDL資料。
說明該方案會導致目標庫鎖表。
源、目標庫無法串連重試時間
當源、目標庫無法串連時,DTS預設重試720分鐘(即12小時),您也可以自訂重試時間。如果DTS在設定的時間內重新串連上源、目標庫,同步任務將自動回復。否則,同步任務將失敗。
說明由於串連重試期間,DTS將收取任務運行費用,建議您根據業務需要自訂重試時間,或者在源和目標庫執行個體釋放後儘快釋放DTS執行個體。
-
-
上述配置完成後,單擊頁面右下角的預檢查並啟動。
說明-
在同步作業正式啟動之前,會先進行預檢查。只有預檢查通過後,才能成功啟動同步作業。
-
如果預檢查失敗,單擊具體檢查項後的
 ,查看失敗詳情。
-
您可以根據提示修複後重新進行預檢查。
-
如無需修複警示檢測項,您也可以選擇確認屏蔽、忽略警示項並重新進行預檢查,跳過警示檢測項重新進行預檢查。
-
-
在預檢查對話方塊中顯示預檢查通過後,關閉預檢查對話方塊,同步作業將正式開始。
等待同步作業的鏈路初始化完成,直至處於同步中狀態。
您可以在資料同步頁面,查看資料同步作業的狀態。
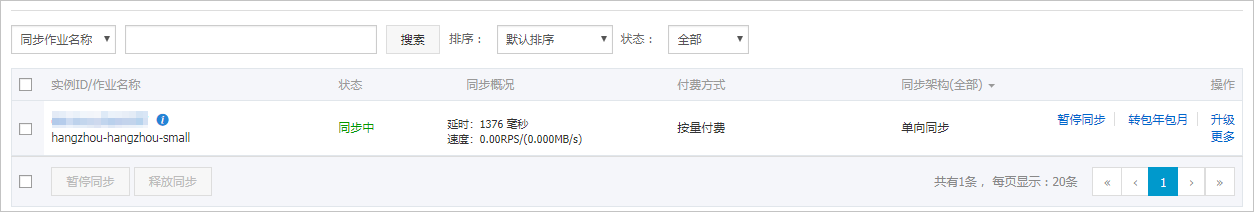
增量日誌表結構定義說明
你需要在MaxCompute中執行set odps.sql.allow.fullscan=true;,設定專案空間屬性,允許進行全表掃描。
DTS在將MySQL產生的增量資料同步至MaxCompute的增量日誌表時,除了儲存增量資料,還會儲存一些元資訊,樣本如下。
樣本中的modifytime_year、modifytime_month、modifytime_day、modifytime_hour、modifytime_minute為分區欄位,是在配置同步策略和同步對象步驟中指定的。
結構定義說明
|
欄位 |
說明 |
|
record_id |
增量日誌的記錄ID,為該日誌唯一標識。 說明
|
|
operation_flag |
操作類型,取值:
|
|
utc_timestamp |
操作時間戳記,即binlog的時間戳記(UTC 時間)。 |
|
before_flag |
所有列的值是否為更新前的值,取值:Y或N。 |
|
after_flag |
所有列的值是否為更新後的值,取值:Y或N。 |
關於before_flag和after_flag的補充說明
對於不同的操作類型,增量日誌中的before_flag和after_flag定義如下:
-
INSERT
當操作類型為INSERT時,所有列的值為新插入的記錄值,即為更新後的值,所以before_flag取值為N,after_flag取值為Y,樣本如下。
-
UPDATE
當操作類型為UPDATE時,DTS會將UPDATE操作拆為兩條增量日誌。這兩條增量日誌的record_id、operation_flag及utc_timestamp對應的值相同。
第一條增量日誌記錄了更新前的值,所以before_flag取值為Y,after_flag取值為N。第二條增量日誌記錄了更新後的值,所以before_flag取值為N,after_flag取值為Y,樣本如下。
-
DELETE
當操作類型為DELETE時,增量日誌中所有的列值為被刪除的值,即列值不變,所以before_flag取值為Y,after_flag取值為N,樣本如下。
全量資料合併樣本
執行資料同步的操作後,DTS會在MaxCompute中分別建立該表的全量基準表和增量日誌表。您可以通過MaxCompute的SQL命令,對這兩個表執行合併作業,得到某個時間點的全量資料。
本案例以customer表為例(表結構如下),介紹操作流程。
-
根據源庫中待同步表的結構,在MaxCompute中建立用於儲存合并結果的表。
例如,需要擷取customer表在
1565944878時間點的全量資料。為方便業務識別,建立如下資料表:CREATE TABLE `customer_1565944878` ( `id` bigint NULL, `register_time` datetime NULL, `address` string);說明-
您可以在MaxCompute的臨時查詢中,運行SQL命令。
-
關於MaxCompute支援的資料類型與相關說明,請參見資料類型。
-
-
在MaxCompute中執行如下SQL命令,合并全量基準表和增量日誌表,擷取該表在某一時間點的全量資料。
set odps.sql.allow.fullscan=true; insert overwrite table <result_storage_table> select <col1>, <col2>, <colN> from( select row_number() over(partition by t.<primary_key_column> order by record_id desc, after_flag desc) as row_number, record_id, operation_flag, after_flag, <col1>, <col2>, <colN> from( select incr.record_id, incr.operation_flag, incr.after_flag, incr.<col1>, incr.<col2>,incr.<colN> from <table_log> incr where utc_timestamp< <timestamp> union all select 0 as record_id, 'I' as operation_flag, 'Y' as after_flag, base.<col1>, base.<col2>,base.<colN> from <table_base> base) t) gt where row_number=1 and after_flag='Y'說明-
<result_storage_table>:儲存全量merge結果集的表名。
-
<col1>/<col2>/<colN>:同步表中的列名。
-
<primary_key_column>:同步表中的主鍵列名。
-
<table_log>:增量日誌表名。
-
<table_base>:全量基準表名。
-
<timestamp>:需要擷取全量資料的時間點。
合并資料表,擷取customer表在
1565944878時間點的全量資料,樣本如下:set odps.sql.allow.fullscan=true; insert overwrite table customer_1565944878 select id, register_time, address from( select row_number() over(partition by t.id order by record_id desc, after_flag desc) as row_number, record_id, operation_flag, after_flag, id, register_time, address from( select incr.record_id, incr.operation_flag, incr.after_flag, incr.id, incr.register_time, incr.address from customer_log incr where utc_timestamp< 1565944878 union all select 0 as record_id, 'I' as operation_flag, 'Y' as after_flag, base.id, base.register_time, base.address from customer_base base) t) gt where gt.row_number= 1 and gt.after_flag= 'Y'; -
-
上述命令執行完成後,可在customer_1565944878表中查詢合并後的資料。