A avaliação de grupo permite monitorar vários alvos com uma única regra de alerta ao agrupar os resultados de consulta e análise por um campo específico. O sistema de alertas avalia cada grupo em relação à condição de disparo de forma independente e gera um alerta separado. Assim, você gerencia alertas e eventos de cada grupo individualmente.
Após configure a avaliação de grupo, uma única avaliação pode gerar até 100 grupos de alerta. Se a quantidade ultrapassar 100, o system selecione aleatoriamente 100 deles e os envia para a política de alerta.
-
Selecione um campo que identifique exclusivamente a entidade monitorada e possua um número limitado de valores possíveis. Evite campos incapazes de distinguir as entidades, pois eles crie grupos excessivos. Cada grupo dispara um alerta separado, o que pode causar uma tempestade de alertas e fazer com que você perca notificações críticas.
Por exemplo, em logs do Nginx, utilize campos como host e method. Para logs de acesso do OSS, use o campo bucket. Não utilize campos como request_time ou body_size dos logs do Nginx, nem o campo err_cnt de logs de erro.
Exemplo 1: Monitoramento de grupo para dados de séries temporais
Suponha que você armazene dados de métricas de vários servidores em um único banco de dados de séries temporais e deseje que o Log service envie um alerta separado para cada servidor quando sua utilização de CPU (cpu_util) exceder 95%. Configure a avaliação de grupo durante a criação da regra de alerta.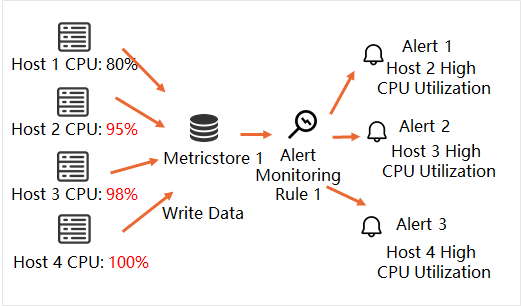
A configuração é a seguinte:
-
Consulta e estatísticas:
* | select promql_query_range('cpu_util') from metrics limit 1000Calcula a utilização da CPU.
-
Avaliação de grupo: Auto label
O Log service agrupa automaticamente os resultados de consulta e análise para dados de séries temporais.
-
Trigger Condition: Data Matching, value > 95, Severity: High
Dispara um alerta de alta severidade quando o value ultrapassa 95.
Add Annotation: Configure anotações, como título e descrição do alerta. Referencie variáveis de campo, como ${host}, nas anotações. Para mais informações, consulte Adicionar rótulos e anotações.
Defina o title como CPU utilization for host ${host} has spiked e o desc como CPU utilization for host ${host} has reached ${value}.
Exemplo 2: Monitoramento de grupo para logs
Suponha que você monitore logs de acesso do OSS e precise receber um alerta distinto para cada bucket que apresentar mais de 1.000 erros HTTP 500 por minuto. Configure a avaliação de grupo ao crie a regra de alerta.
A configuração é a seguinte:
-
Consulta e estatísticas:
http_status=500 | select bucket,count(1) as pv group by bucket having pv >1000 order by pv descIdentifica buckets com mais de 1.000 erros HTTP 500.
-
Avaliação de grupo: Custom label, bucket
Agrupa os resultados de consulta e análise por bucket.
-
Trigger Condition:
-
Condição 1: Data Matching, pv > 3000, Severity: High
Gera um alerta de alta severidade sempre que o valor de pv superar 3.000.
-
Condição 2: Data Exists, Severity: Medium
Aciona um alerta de severidade média caso a consulta e análise retornem qualquer resultado.
-
Add Annotation: Defina anotações, incluindo título e descrição do alerta. Referencie variáveis de campo como ${pv} nessas anotações. Para mais detalhes, consulte Adicionar rótulos e anotações.
Defina o title como ${bucket} bucket is experiencing 500 errors e o desc como Error count: ${pv}.